主流大模型都在做同一件事——下一个 token 预测(NTP)。但问题在于,模型隐藏层里其实早就“懂”了语义概念,这些概念只是训练的副产品;监督信号全压在单个 token 上,没人在意“一段话到底在讲什么概念”。于是模型只能靠海量 token 慢慢摸索,训练效率 天然受限。
针对这个问题,上海 AI Lab 和上海交大 LUMIA Lab 的 Intern-NCP 团队提出了 NCP-ArchPreview,一种把概念预测引入自回归训练的潜空间语言模型。它在 NTP 之外,增加一个“下一个概念预测”(NCP),直接预测横跨多个 token 的离散概念。
做法是:从模型自己的隐藏状态里用乘积量化建一个概念词表,用 Concept Module 预测“下一个概念”并反馈回 token 层,NTP 与 NCP 端到端一起训练。
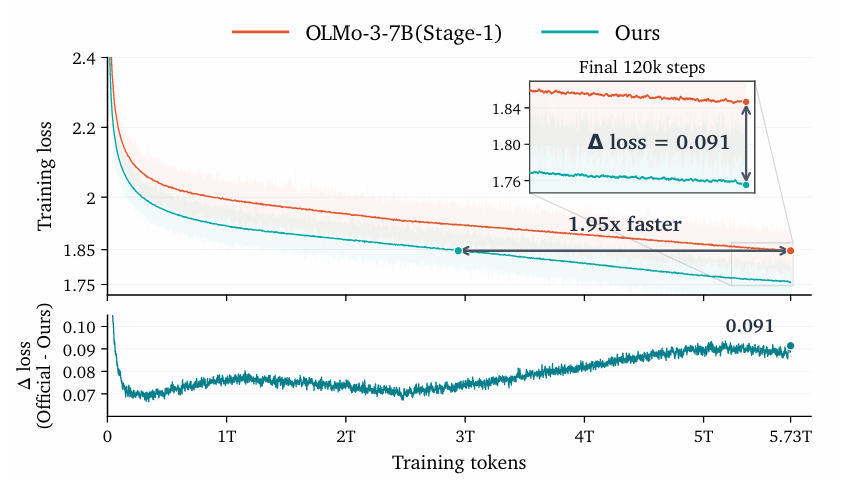
这个 8.9B 模型在 5.73T token 上训练,只用 51.3% 的 token 就追平 OLMo-3-7B 的最终 loss,收敛速度快 1.95 倍;预训练后下游综合指标高出 2.45 分,GSM8K 提升 5.99。
更妙的是,预训练学到的“概念空间”还能复用:只动 17M 参数就能做领域适配,喂给投机解码器还能让平均接受长度多出 4.17%。
- 论文题目:NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
01 把“概念”真正塞进模型骨架里
NCP-ArchPreview 不是给原模型打个小补丁,而是重新组织了一遍骨架。
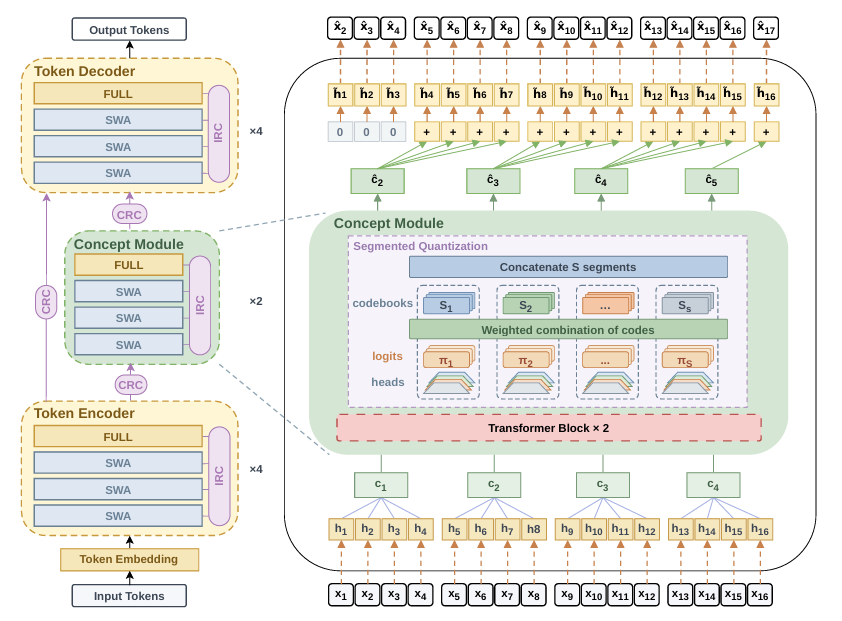
1. 编码器、概念模块、解码器
整个模型拆成三个模块:
- Token Encoder(16 层):先把输入 token 变成隐藏状态。
- Concept Module(8 层):把相邻 token 状态做平均池化,压成一个“概念”,再基于历史概念预测下一个概念。
- Token Decoder(16 层):把预测出的概念与 token 级表征融合,去预测下一个 token。
中间压缩比 k = 4,也就是每 4 个 token 压成 1 个概念,概念序列长度只有 token 序列的四分之一。概念模块的算力消耗也因此只有标准块的四分之一左右,这点在后面的成本核算中很关键。
2. 用乘积量化造一个“概念词表”
“概念”不能是任意向量,否则模型可以随便编,等于没有约束。团队借鉴了 向量量化(VQ)的思路,并且使用乘积量化:把一个概念向量切成 S 段,每段去对应一个只有 N 个条目的小码本,取最近的码字。
最后一步很巧妙:单个码本只有 128 个条目,但 S 个码本组合起来,能表达 128^S 种概念,用很小的码本撑起一个容量很大的离散概念空间。
3. 预测下一个概念:可微,但不离散
Concept Module 对每个分段预测一个码本条目上的概率分布,然后按概率把码本条目加权求和,得到可微的概念预测。
为什么不直接 argmax 取一个码字?因为那样会断掉梯度。加权组合让预测路径全程可微,又把它限制在学习到的码本线性组合里,NCP 目标因此是在一个“有规矩”的潜在空间里做监督,而不是去回归一个漫无目的的连续目标。
4. 把概念“喂”回 token 流
预测出的概念需要和 token 层对齐。做法朴素但讲究:每个概念先重复 k 次,再做因果偏移(causal shift),保证不会“偷看”未来,然后直接与 token 隐藏状态做逐元素残差相加。
每个预测出的概念,必须等到用来预测它的那些 token 状态都处理完之后,才被注入。信息不泄露,自回归的性质才保得住。
5. 层次化残差连接
Token Encoder、Concept Module、Token Decoder 处在不同深度、不同粒度上。为了让信息顺畅流动,团队引入了受 MUDDFormer 启发的层次化残差连接,分两类:
- 模块内残差(IRC):同一模块内,让某一层能按“数据相关”的权重,组合之前多个深度的表示。初始化时它退化为标准残差,训练中会慢慢学会“回头看”更早的层。
- 跨模块残差(CRC):在三个模块之间搬信息,具体有三条线:Encoder→Concept、Encoder→Decoder、Concept→Decoder。最后这条同样遵循因果偏移,不会暴露未来 token 信息。
6. NTP + NCP + VQ 一起优化
最终损失是三者的加权和:标准 NTP 损失提供密集监督,保证模型还是一个正常的语言模型;NCP 损失用 MSE 逼近“下一个概念”,目标用 stop-gradient 截断(只更新 Concept Module 和 Encoder,不反向修改码本);VQ 损失负责把码本条目拉向真实概念分布。
优化器使用 Muon(矩阵参数)搭配 AdamW(embedding、偏置等非矩阵参数),学习率 6e-5。
02 工程落地
除预训练效率外,NCP-ArchPreview 学到的离散概念空间在下游任务中也有实用价值,主要体现在三个方面。
1. 基于 VQ 的轻量领域适配
领域适配的标准做法,要么是更新全部 8.9B 参数的全量微调,要么是 LoRA。NCP-ArchPreview 提供第三种路径:仅更新 VQ 码本与概念预测头,共 17M 可训练参数,而且不引入新参数。
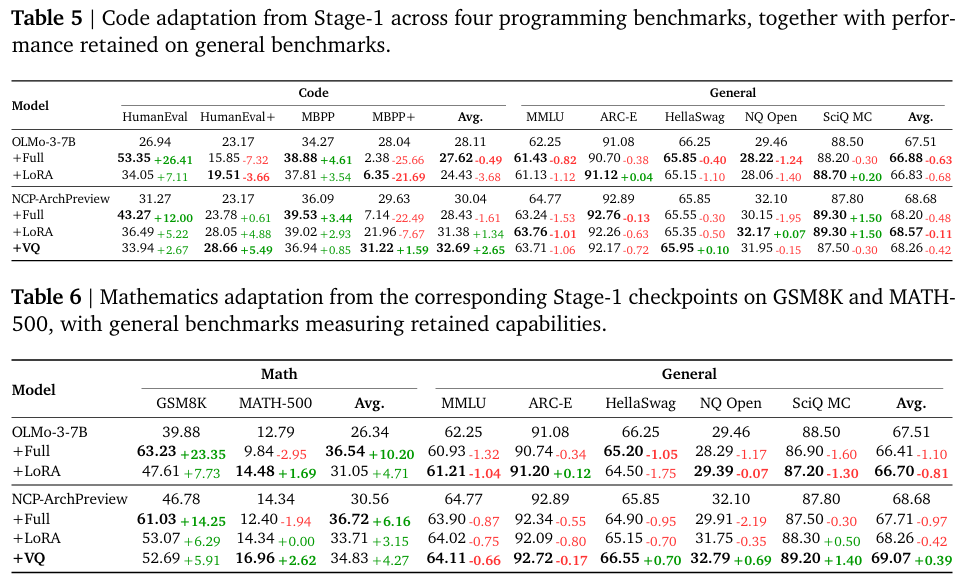
在代码、数学、知识三类任务的适配实验中,该方案表现如下:
- 代码:平均准确率从 30.04 升至 32.69(+2.65),为各变体最高,且是唯一在四个代码子任务上均实现正提升的方案。
- 数学:平均 +4.27,略低于全量微调的 +6.16,但通用能力仅下降 0.42,优于 LoRA(-0.68)和全量微调(-0.97)。
- 知识(TriviaQA):精确匹配 +9.19,通用指标基本不变(+0.03)。
由于仅训练 17M 参数,其训练吞吐是 LoRA 的 1.5 倍、全量微调的 2.0 倍,单卡显存占用只有 32.4%(LoRA 49.0%、全量 90.3%)。
2. 概念表征辅助块并行投机解码
块并行投机解码(block-parallel speculative drafting)希望单次前向就产出一整块 token,难点在于跨多个未来位置维持一致的预测轨迹。
NCP-ArchPreview 将目标模型最后一个完整 chunk 的概念表征,按层注入 draft 模型的各个候选位置(门控初始化为零)。这个操作只给 1.1B 的 draft 模型增加 0.04M 参数,且不增加目标模型的计算量。
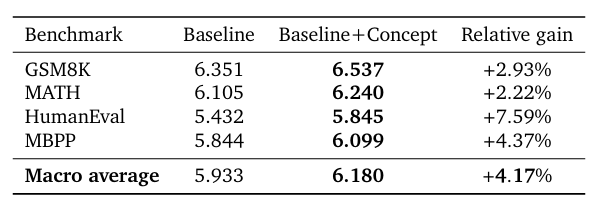
在 GSM8K、MATH、HumanEval、MBPP 上,平均接受长度(MAL)从 5.933 提升到 6.180(相对 +4.17%),其中 HumanEval 提升 7.59%。
3. 与多 token 预测(MTP)互补
在 OLMo-3-3B 骨架上的对照显示:NCP 单独使用就优于叠加 MTP 的残差基线,而 NCP 与 MTP 组合还能进一步降低损失。两者增益可叠加,互不冲突。
03 实验配置
骨干采用 OLMo-3-7B,沿用它的分阶段数据课程(Stage-1 用 Dolma 3 Mix,Stage-2 用 Dolma 3 Dolmino),评估也复用 OLMo-Core 的 30 个基准族(MMLU、GSM8K、MATH-500、HumanEval、MBPP、ARC、HellaSwag 等)。
NCP-ArchPreview 的具体配置为:hidden 4096、FFN 11008、32 头;32 个 token 级层均分进 16 层 Encoder 和 16 层 Decoder;Concept Module 8 层、chunk=4;VQ 含 32 个码本,每个 128 条目、维度 128;最大上下文 8192。最终约 8.94B 参数。
核心结果一:训练效率碾压
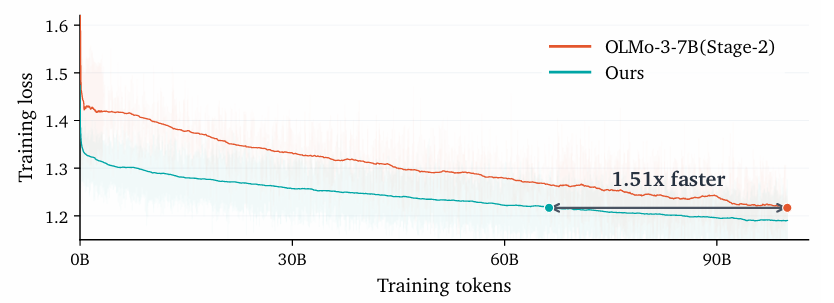
同样的数据,NCP-ArchPreview 的 loss 全程压在 OLMo-3-7B 下面。
Stage-1 阶段,它只消耗 51.3% 的训练 token,就追平 OLMo-3-7B 的最终 loss,相当于收敛快 1.95 倍;Stage-2 阶段用 66.2% 的 token 追平,快 1.51 倍。
核心结果二:下游能力更好
Stage-1 预训练后,下游综合指标比 OLMo-3-7B 高 2.45 分,数学、代码、常识推理提升尤其明显(GSM8K +5.99,MATH 类平均 +3.75)。
Stage-2 综合 +0.59 分。注意 Stage-2 只有约 10% 代码数据,整体更均衡,但代码这类小众领域反而被稀释了,这和训练数据分布直接相关。
核心结果三:增益来自架构,不是堆参数
这是最容易被质疑的点,团队做了对齐实验:
- 参数对齐基线(40 层标准块,约 8.9B)和算力对齐基线(34 层,约 85% 算力);
- 逐步加组件:Vanilla → +Concept Module → +残差 → +NCP。
结果显示,NCP-ArchPreview 远超算力和参数都对齐的基线,并且用 85% 的算力就逼近了那个 40 层的“大模型”。组件消融里,加 Concept Module、加残差、加 NCP 是逐级变好的,不是某一项单独起作用。
核心结果四:Scaling Law 上 1.74 倍算力效率
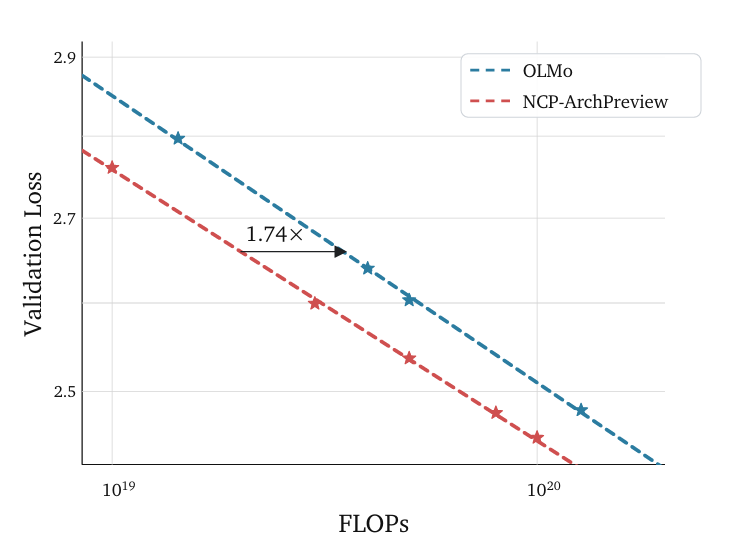
在多个算力预算下做 scaling law 搜索,NCP-ArchPreview 相比 OLMo-3 实现了 1.74 倍的算力效率提升——同样算力拿到更低的验证 loss。
04 总结
NCP-ArchPreview 把“概念预测”从训练的副产品,变成了显式、可扩展的预训练目标。
它在 8.9B 规模、5.73T token 上验证了潜在空间语言建模的可行性。前面的效率对比、架构消融与下游结果已经表明,这种联合 token 与概念的建模范式,相比单纯堆参数或算力,给出了更优的 Pareto 前沿。
长上下文训练尚未开展,训练 loss 到下游能力的转化在不同阶段、任务上并不稳定(Stage-2 提升已明显收窄)。后续更关键的课题包括 mid-training 配方、能力感知的数据筛选,以及把优化优势更稳定地翻译成真实能力。
 发表于 昨天 23:06
|
查看: 3|
回复: 0


