Z.ai 近日发布了一篇深度技术文章《Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure》,首次系统披露了 GLM-5.3-Flash 在国产芯片集群上构建推理基础设施的全过程。文章将这这项工作放在 Recursive Self-Improvement(递归自我改进,RSI)的框架下讨论,但并未宣称已经实现 RSI——原文明确写道:
We have not yet reached recursive self-improvement.
不过,一个很小的闭环确实已经出现:GLM 优化运行自己的系统,而这个系统又反过来服务 GLM。
据 Z.ai 介绍,从 GLM-5.3-Flash 首次在国产加速器上成功运行,到承载全部生产流量,整个过程只用了不到两周,端到端吞吐量提升了 3.2 倍。
智谱创始人唐杰也在 X 上证实了这一细节:这套推理基础设施的大量工作由一个 由 GLM-5.3 驱动的 Infra Agent 完成,它参与了算子开发、性能瓶颈诊断以及部署服务栈优化。
GLM-5.3-Flash 跑上 10 万+ 国产加速器
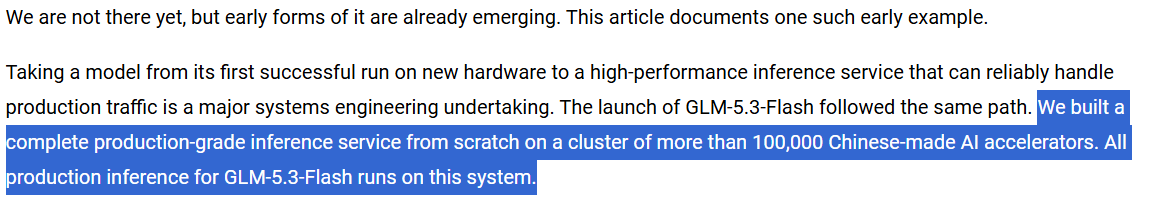
智谱为 GLM-5.3-Flash 搭建了一套完整的生产级推理服务,运行在超过 10 万张国产 AI 加速器组成的集群上,GLM-5.3-Flash 的全部生产推理流量都由这套系统承载。
在适配国产硬件的过程中,团队重新设计了一系列优化方案,包括用计算换带宽、用通信换设备内存,同时引入了 Tensor Parallelism、ReplaySSM、W8A8 量化、混合精度缓存和 EPD 解耦架构等技术。经过这一轮系统优化,端到端服务性能提升约 3 倍,硬件利用率和单 Token 成本也接近主流英伟达 GPU 的水平。
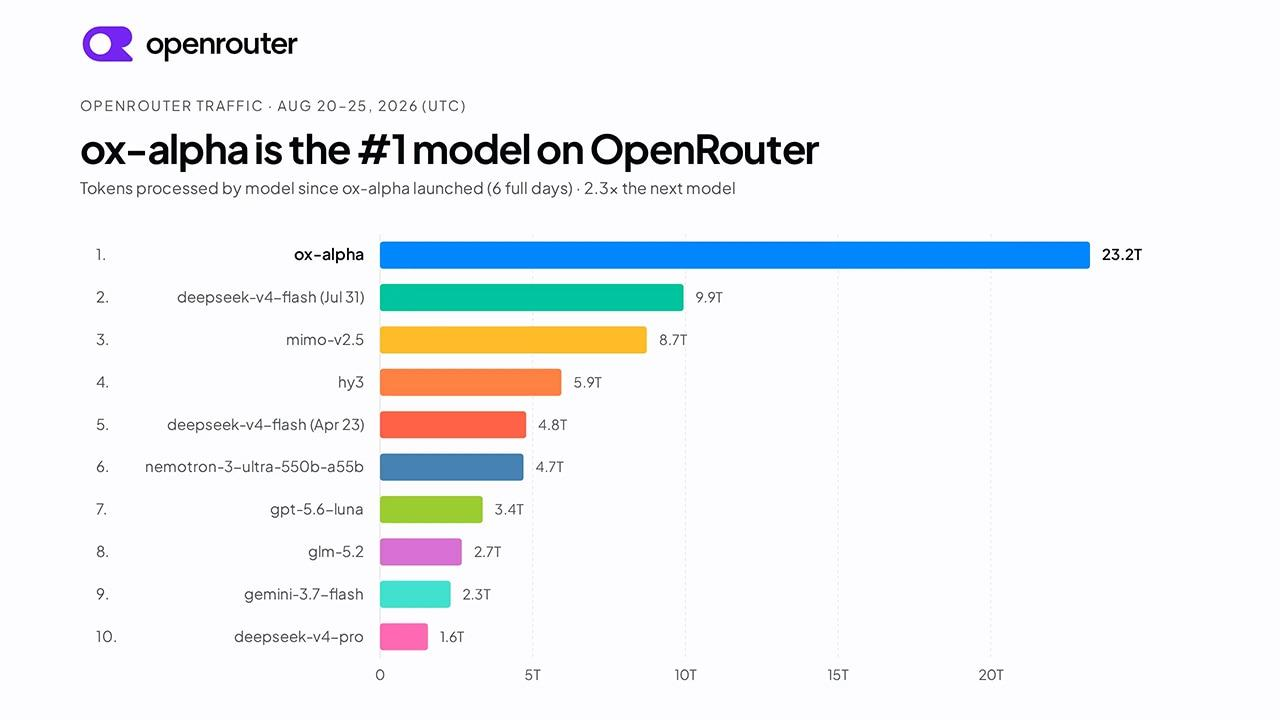
此前 GLM-5.3-Flash 还以匿名模型 “Ox-Alpha” 在 OpenCode 和 OpenRouter 上进行过灰度测试,上线后一周内迅速登上两个平台的使用量榜首。仅 OpenRouter 一个平台,8 月 20 日至 25 日就处理了 23.2 万亿 Token;结合 OpenCode 的数据,这 6 天累计处理 Token 超过 62 万亿。
一个由 GLM-5.3 驱动的 Infra Agent
如果只是工程师团队优化了一套推理系统,这篇文章或许不会和“递归自我改进”扯上太深的关系。关键变化在于,智谱把大量底层工作交给了一个由 GLM-5.3 驱动的 Infra Agent。
这个 Agent 并不只是负责写代码。实际工作流中,它需要阅读现有代码和 Kernel,分析运行结果,提出优化假设,再修改代码、运行实验,并根据反馈继续迭代。这和普通 Coding Agent 有一个明显区别:最终评价标准不只是“代码能不能跑”,而是修改之后整个推理系统到底有没有变快、有没有出错——而后者恰恰是基础设施优化中最难的一环。
唐杰在转发中提到,当 Agent 卡住时,很多时候并不是因为不会写代码,而是它不知道为什么性能变差。一次实验告诉它“吞吐量下降 20%”,这个结果只能证明哪里出了问题,却无法指出究竟是哪一层、哪个假设、还是哪个操作导致的问题。在强化学习的语境下,这就是典型的稀疏奖励(sparse reward)加信用分配(credit assignment)难题。如果每次端到端 Benchmark 都要跑几个小时,Agent 的试错速度会慢到不可接受。
智谱给出的解决方案,是把工程师平时靠经验完成的“隐性反馈”显式化,转变为 Agent 能够直接读取的 Dense Feedback(密集反馈)。
三层反馈机制与三个实战案例
智谱将反馈拆成了三层:
- 正确性反馈:计算结果对不对;
- 系统行为反馈:时间到底花在哪里;
- 性能反馈:哪种方案更快,以及在什么条件下更快。
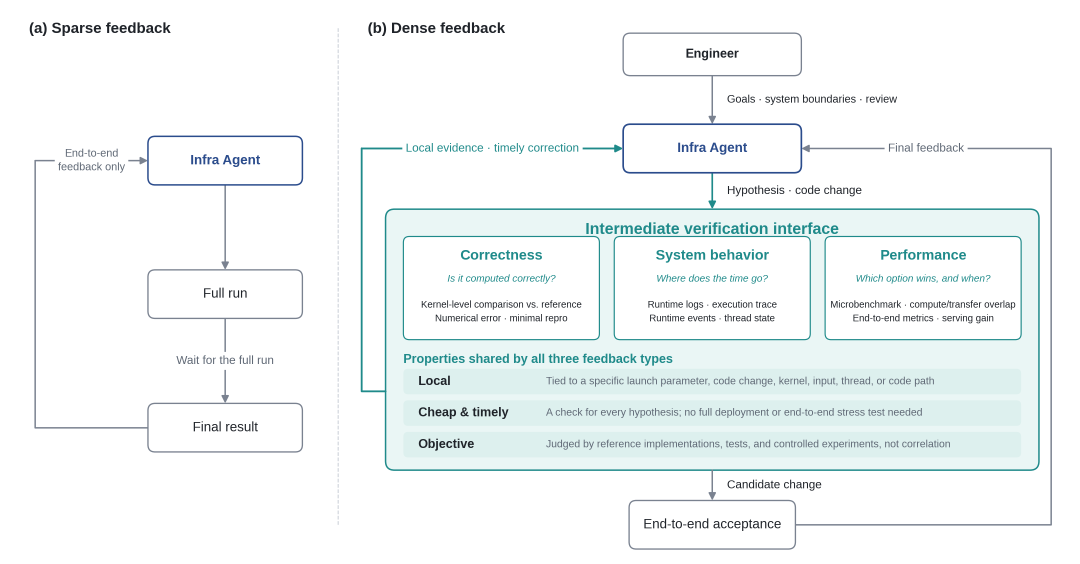
测试结果、运行日志、执行 Trace、Runtime 事件、Microbenchmark 和端到端指标,全部接入了 Agent 的工作流。Agent 拿到的就不再只是一个最终分数,而是一层层可以定位问题的反馈信号。智谱公开了三个具体案例。
案例一:KDA Context Parallelism 精度修复
在 Context Parallelism 和非 Context Parallelism 两种模式下,相同计算出现了结果差异。Agent 追踪状态传播和合并过程后发现,底层 tl.dot 即使输入是 FP32,也默认使用 TF32 计算,在超长上下文的连续状态合并过程中逐渐积累了误差。最终,工程师和 Agent 将两个相关操作显式设置为 input_precision="tf32x3",解决了数值精度问题,相关修复后来合并进了 Flash Linear Attention 的 PR #1180。
案例二:KV Transfer 性能差距排查
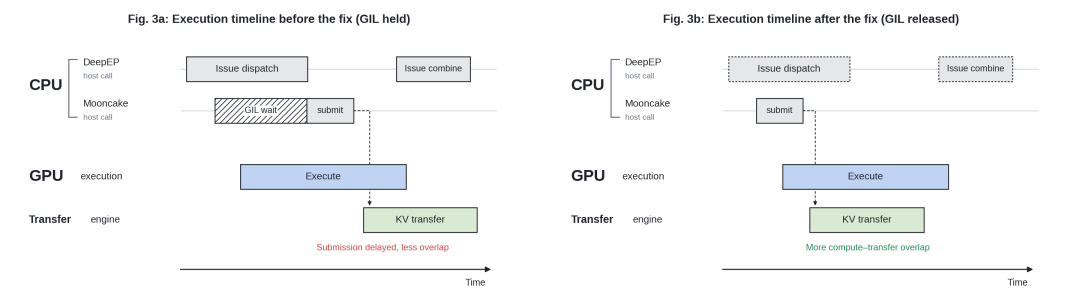
在部分场景下,Prefill + KV Transfer 相比单独 Prefill 存在超过 20% 的性能差距,而目标是控制在 5% 以内。Agent 通过时间线分析发现,Python 侧的 KV Transfer 并没有和 DeepEP 的 Dispatch、Combine 真正重叠执行。继续向下追踪后,问题定位到了 Python GIL:DeepEP 1.2.1 中部分节点内 Dispatch/Combine 操作没有显式释放 GIL,CPU 在等待 GPU Token 信息的同时,Mooncake Transfer 的 Python 线程也被阻塞。修改 C++ 执行区间释放 GIL 后,Prefill + KV Transfer 与 Prefill-only 之间的性能差距从 20% 以上降到了 1% 以内。
案例三:KDA Decode Kernel 优化
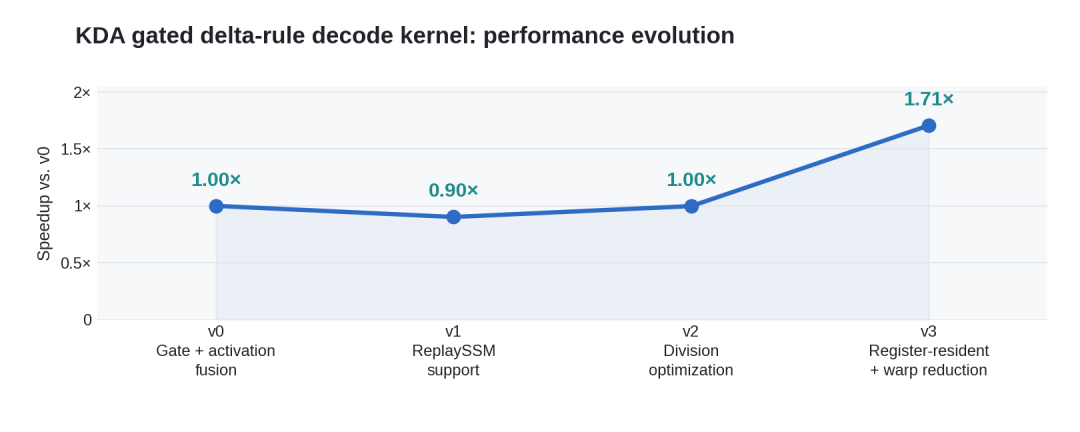
在 KDA Decode Kernel 的优化过程中,Agent 参考了 SGLang、Flash Linear Attention 和 DeepGEMM 中已有的 Kernel 实现,从中提炼出可复用的优化思路。有意思的是,其中一次优化最初反而让性能变差。Agent 继续分析后发现,原来的 V 维度切分导致 FP32 归一化和 Gate 计算被重复执行了 4 次。于是它重新调整 Tile 划分,将多个 Tile 合并到一个 Thread Block 中,让中间结果保存在寄存器里,同时通过 Warp 级 Reduction 消除重复计算。这种方案牺牲了一部分并行度,却大幅减少了重复计算量,最终该 KDA Decode Kernel 相较上一版本获得了 1.71 倍加速。
RSI 的最小循环已经出现
唐杰在文章中指出,基于真实基础设施任务构建的分层、可验证反馈环境,本身也可能成为训练下一代模型所需要的环境——代理完成的每一个任务,都可以成为下一代模型的训练场。
这也是他所看到的递归自我改进方向:模型优化系统,系统服务模型。目前这个循环距离完整的递归自我改进还很远——目标设定、反馈环境构建以及高风险变更的审查仍然由人类负责。但在 GLM-5.3-Flash 的这次实践中,一个最小的循环已经出现:模型参与优化推理基础设施,优化后的系统继续服务模型。
从首次跑上国产加速器,到不到两周后承担全部生产流量,再到端到端吞吐提升 3.2 倍,这个循环已经被放进了真实的工程环境中验证。模型开始参与优化自己的运行底座,这可能是比任何单点性能提升都更值得关注的信号。
 发表于 昨天 23:02
|
查看: 3|
回复: 0


