近期,Anthropic 发布长文公开了内部 RSI(Recursive Self-Improvement,递归自我改进)的落地方法论:AI 在多大程度上主导下一代 AI,研发自动化指数以及对 3 万个 AI Agent 的监督。
要理解 Anthropic 的这篇 RSI 博客,不能不提近期的一篇重量级综述。
Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops
该综述系统梳理了 2024–2026 年间 1,250 篇论文,是迄今对「递归自我改进 RSI」最完整的一次测绘。最直观的事实是:这个领域的膨胀速度本身就在指数化——论文数量飙升。
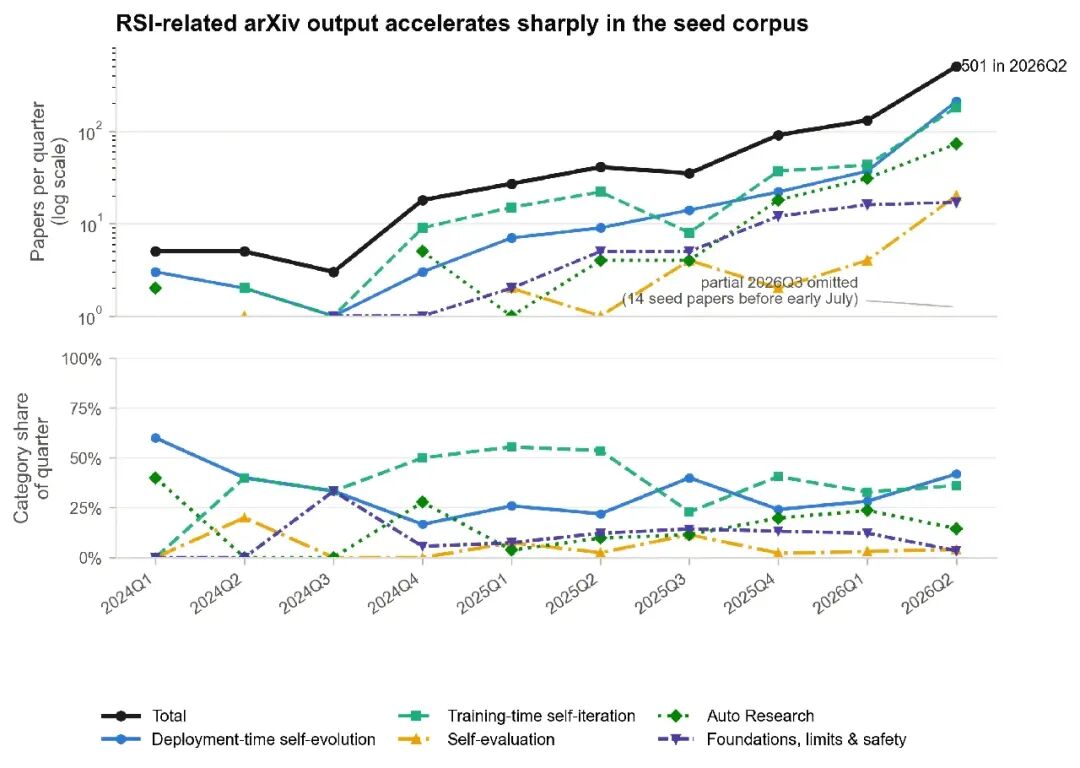
图 1:RSI 相关 arXiv 论文的季度产出(对数坐标)与类别占比变化,2026Q2 达 501 篇。
Claude 已「主导」26% 的模型研发
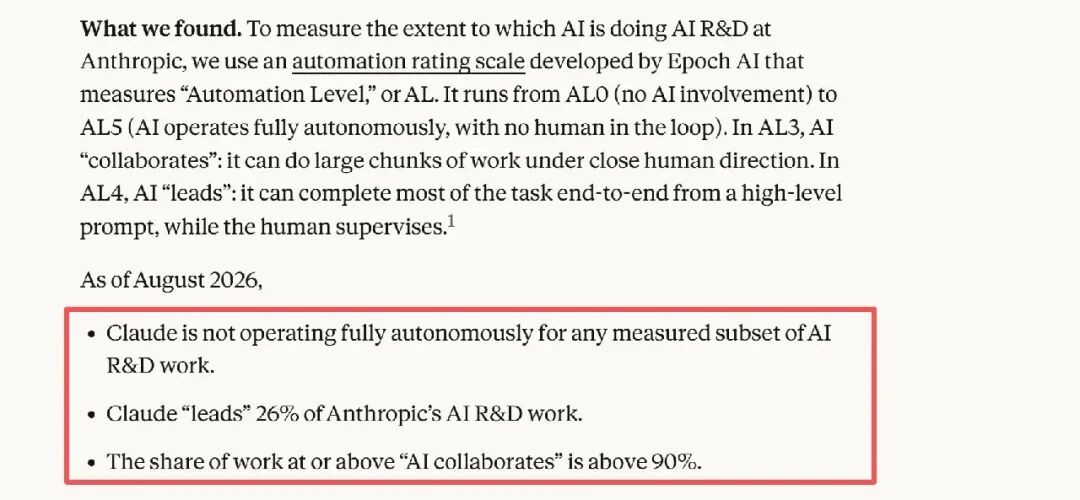
Anthropic 构建了「研发自动化指数」,采用 Epoch AI 的六级自动化量表(AL):
| 等级 |
含义 |
| AL0–AL2 |
无 AI / 极少 AI / AI 辅助——主体工作仍由人完成 |
| AL3 |
AI 协作:在人类密切指导下完成大块工作(遇到问题会停下来等人决策) |
| AL4 |
AI 主导:从高层提示端到端完成任务,人类只做监督(如审查报告、决定是否部署) |
| AL5 |
完全自主:AI 自行监控、修复并部署,全程无需人类介入——尚未达到 |
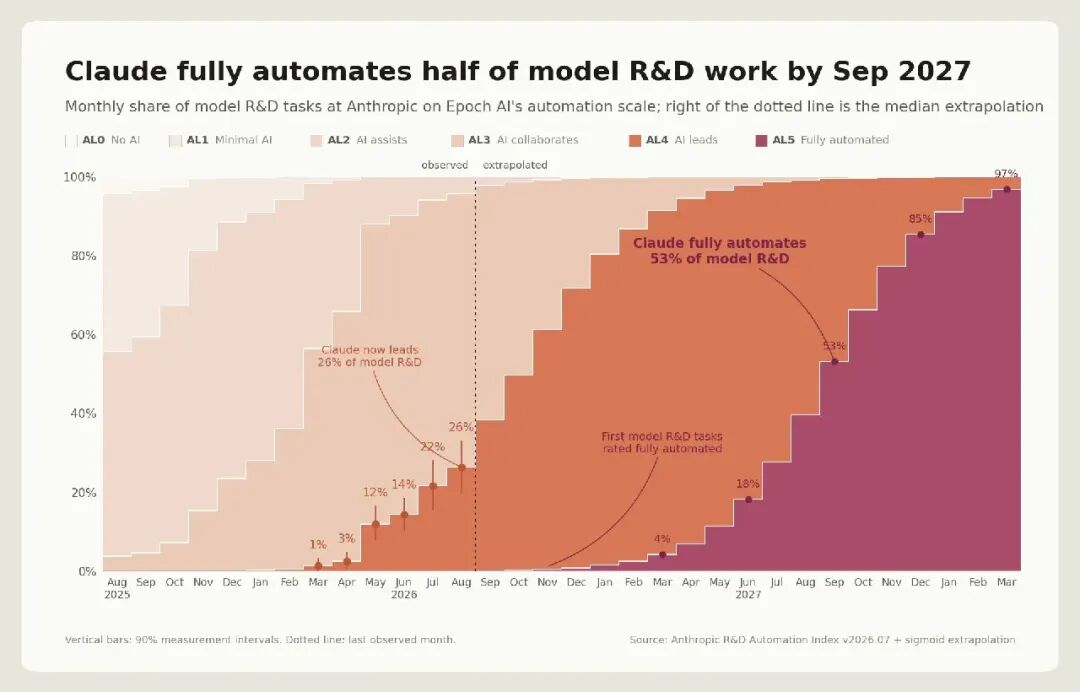
核心发现(截至 2026 年 8 月):没有任何研发子集达到 AL5;Claude「主导」(AL4)了 26% 的 AI 研发工作;「AI 协作」及以上占比超过 90%。
这张图最震撼的不是绝对值,而是斜率:AL4 占比 2026 年 3 月仅 1%,4 月 3%,5 月 12%,7 月 22%,8 月已达 26%——半年内从几乎为零飙升至四分之一,低自动化等级的工作整体向上迁移。
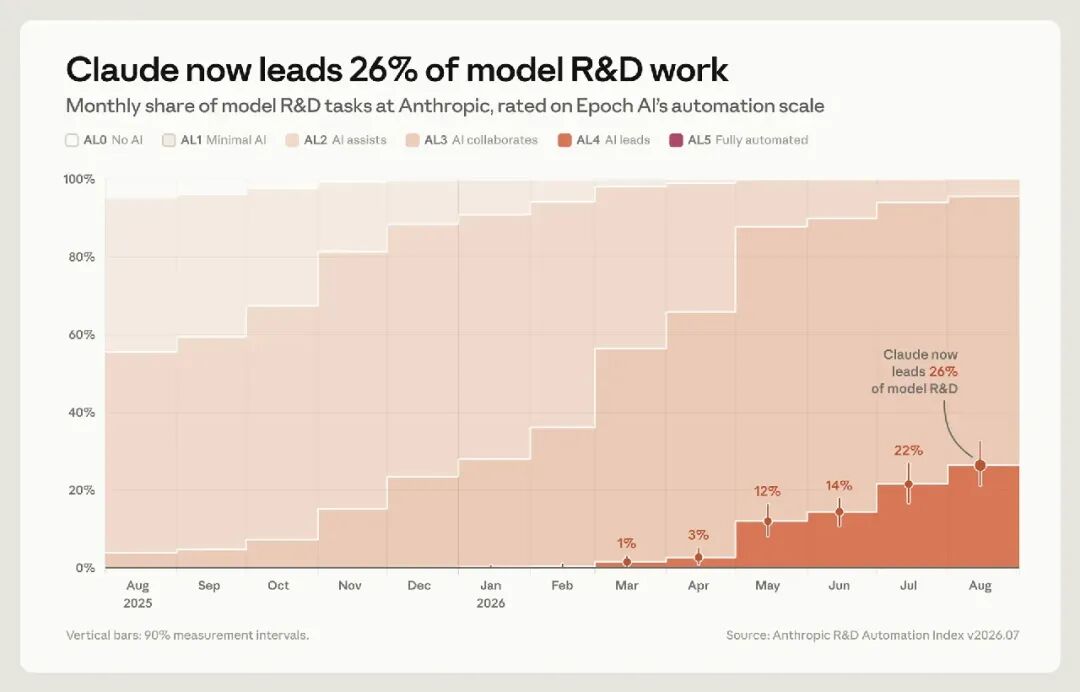
图 2:Claude 目前主导了 26% 的模型研发工作——Anthropic 模型研发任务月度自动化等级分布,垂直短线为 90% 测量区间,来源 Anthropic R&D Automation Index v2026.07
这篇 RSI 综述也对「自我改进」进行了详细拆解:
- 系统改进什么(部署行为 / 训练权重 / 评估器 / 研究过程本身),与环路由谁验证(人在环中 → 人在环上 → 完全闭环),
- 并由此划出全领域的核心分界:有界自我改进(bounded self-refinement,针对固定外部标准、可收敛、已是工业实践)与开放式递归自我改进(RSI,连改进标准本身也被改写、原则上发散)。
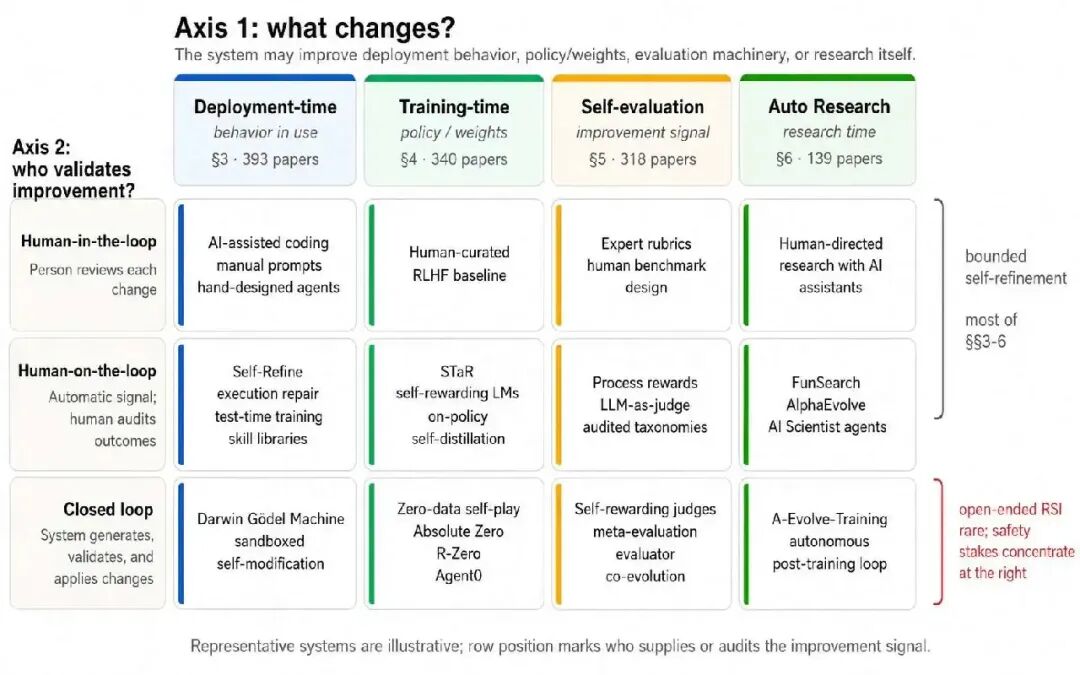
图 3:RSI 综述的双轴分类网格。文献主体集中在「人在环上」一行;右下角「自动研究 × 闭环」是开放式 RSI 风险最集中的格子。来源:arXiv:2607.07663, Figure 1
1,250 篇论文在四个技术类别上的分布如下:
| 类别 |
改进对象 |
论文数 |
2026 年发表占比 |
| 部署时自我演化 |
输出、测试时权重、脚手架/技能 |
393 |
74% |
| 训练时自我迭代 |
自奖励 RL、自蒸馏、自博弈 |
340 |
69% |
| 自我评估 |
裁判、过程奖励模型、验证器 |
318 |
82% |
| 自动研究 |
AI 科学家、演化式程序发现 |
139 |
76% |
按这个坐标系,Anthropic 的 26% AL4 属于典型的「人在环上」——改进信号自动生成、人类审计把关,这正是当前文献的主体所在。综述援引 Anthropic 自己的判断也与此吻合:「执行」环节已高度自动化(截至 2026 年 5 月,Claude 撰写了 Anthropic 超过 80% 的合入代码),真正的瓶颈卡在「研究方向设定」——选择什么问题值得做。这也解释了图 2 中 AL5 为何缺席:执行可以自动化,品味不能。
3 万个 Agent、10 亿次决策、0.002% 拦截率
Anthropic 员工越来越依赖可长时间半自主工作、且互相委派任务的 Agent。单个 Agent 失当目前罕见,但当 Agent 规模达到百万、十亿级,罕见事件就会常态化。为此定义三个指标:覆盖率(行为经过监控的比例)、审查延迟(从行为到复核的时间)、升级率(被拦截或标记的比例)。
表 1:Anthropic 的 Agent 双层监控体系
| 职责 |
在线监控器 |
离线监控器 |
| 覆盖率 |
100% 行为在执行前经过监控(通常数秒内) |
100% 行为在事后被收录 |
| 审查延迟 |
行动前自动审查;被拦截行为一周内人工复核 |
每周标记约 10 万份记录,分类器初筛后约 50 条升级人工审查 |
| 拦截 / 升级率 |
8 月逾 10 亿次决策中 0.002% 被拦截(约 1/47,000) |
每 1000 份记录标记约 1–2 份 |
核心发现(截至 2026 年 8 月):其最常用内部平台上任意时刻约有 30,000 个 Agent 在从事研发工作,行为受双层监控。
监督的本质是一个「评估器」问题。为什么「裁判」的可靠性如此关键?RSI 综述给出了迄今最清晰的理论框架:它把自我评估单列为与部署、训练、自动研究并列的第四大类(318 篇,2026 年新增最快的方向),理由一针见血——每一条自我改进环路,本质上都是「某个信号可以替代人类判断」的声明,环路的天花板就是该替代品的质量。综述将评估信号排成一条验证层级,越往上信号越可靠但覆盖面越窄,越往下越便宜但越容易被钻空子:
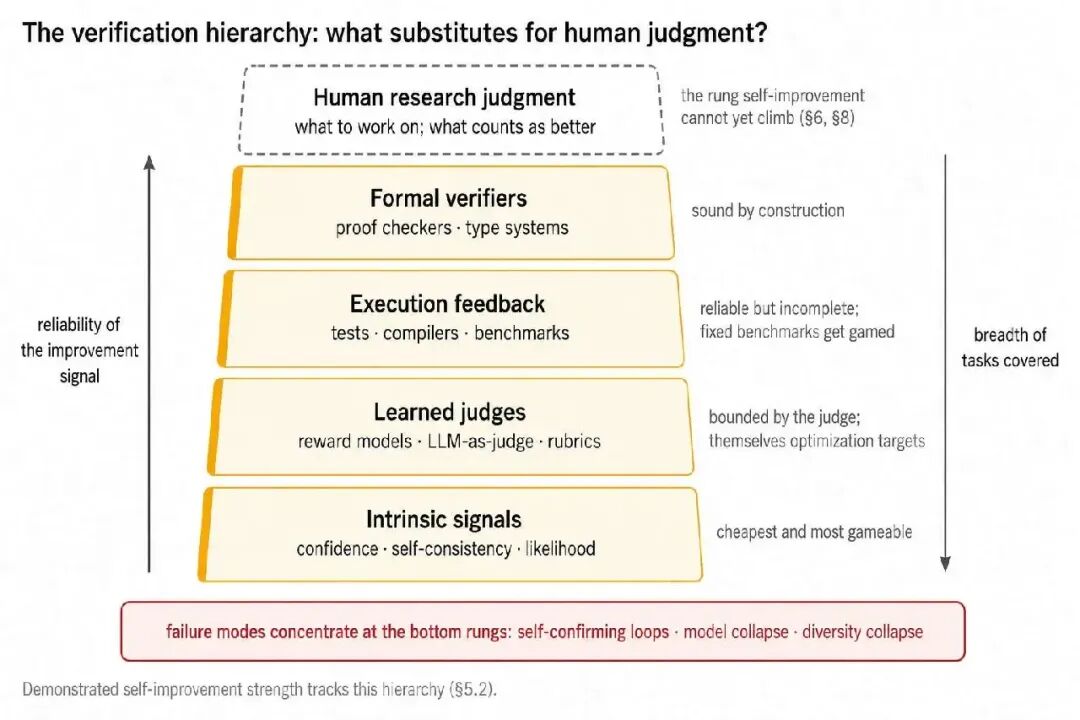
图 4:验证层级——形式化验证器 > 执行反馈 > 学习型裁判 > 内在信号;失败模式集中在底部梯级,而「人类研究判断」是自我改进尚无法攀爬的那一级。来源:arXiv:2607.07663, Figure 5
经验规律是:已验证的自我改进强度严格沿此层级分布。FunSearch、AlphaEvolve 之所以成功,正因为站在层级顶端(程序可执行、结果可检验);而「AI 科学家」系统之所以产出流畅却难以审计的论文,是因为在用第三层工具(LLM 裁判)解决第四层的问题(研究品味)。
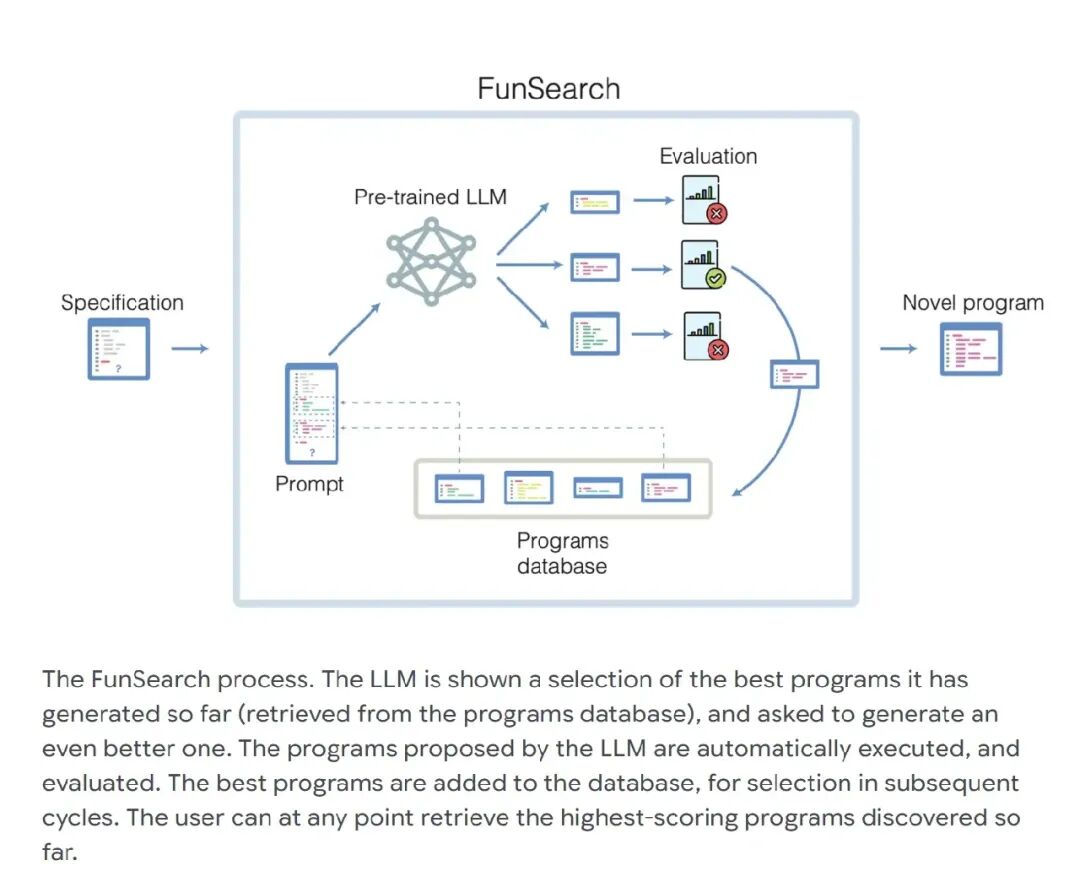
FunSearch:基于 LLM 的程序生成与评估流程图
Anthropic 的自动化评级让 Claude 裁判 Claude,正落在「学习型裁判」这一级——综述称之为自我确认循环:生成器与评估器共享权重时,高置信错误会被系统性过度奖励,奖励黑客只是特例,该模式无需攻击者即可自发产生。
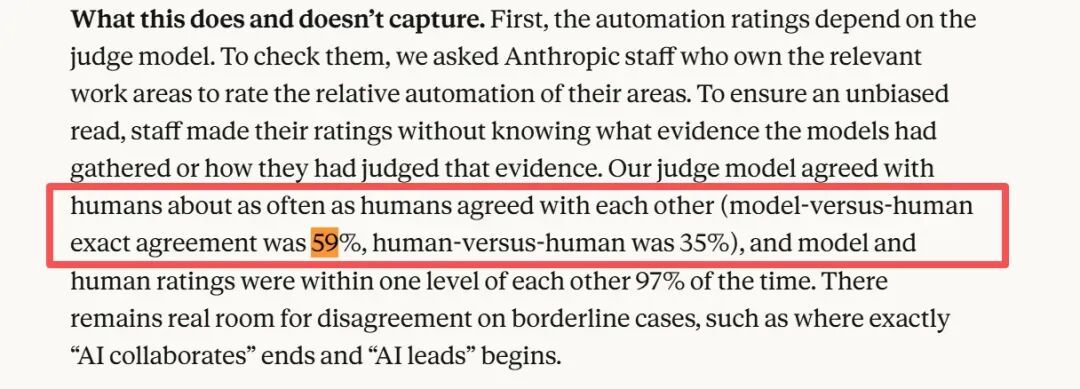
Anthropic 在方法附录中用「模型与人类评级一致率 59% vs 人类彼此 35%」来对冲这个质疑,这个校验设计本身就是在向验证层级的上方攀爬。
RSI 才刚刚开始,Claude 在持续自我进化。
https://www.anthropic.com/institute/measuring-pace-of-ai-development
https://arxiv.org/pdf/2607.07663
Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops
 发表于 半小时前
|
查看: 2|
回复: 0


