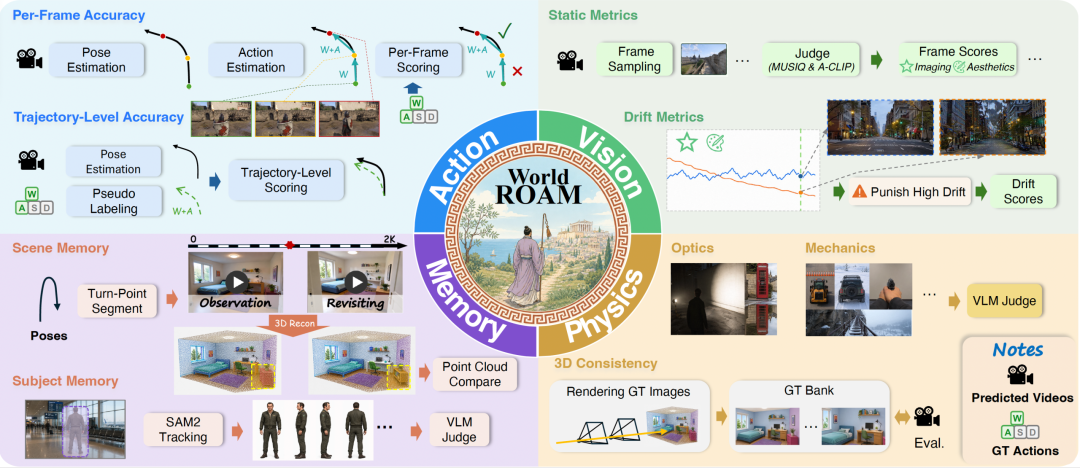
WorldRoamBench 全面评价长时交互四大维度
随着 Genie 3 的发布,可交互世界模型真正走到台前:用户不再只是观看生成视频,而是可以输入动作实时改变一个持续演化的世界。世界模型开始从「生成一段视频」走向「模拟一个可交互世界」,但能走进去,不等于经得起探索。模型能否持续响应控制、维持视觉与空间一致、遵守物理规律并记住来路,仍缺少系统评测。
然而,现有评测往往仍停留在 5~10 秒短片段的比较上,很难暴露分钟级长时交互过程中的问题。如下图所示,问题往往不会立即显现,而是在较长时间推理后逐渐暴露。
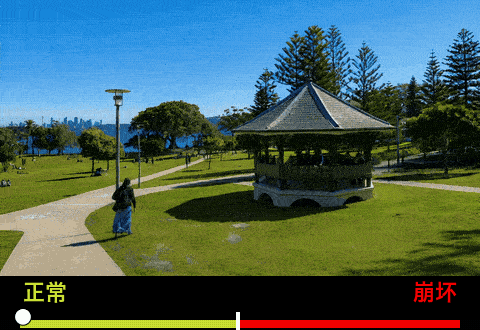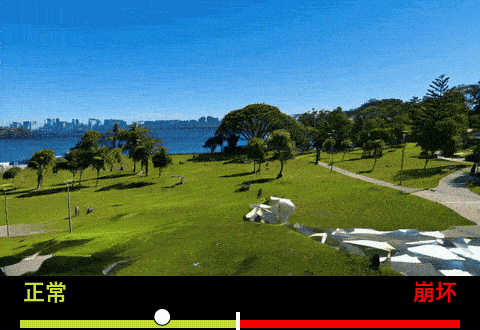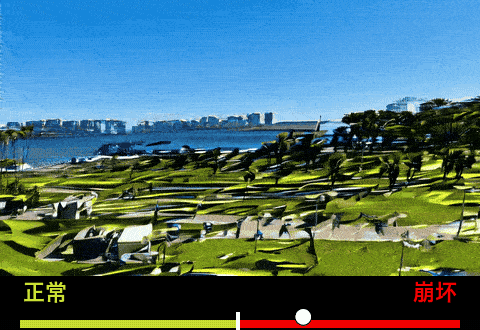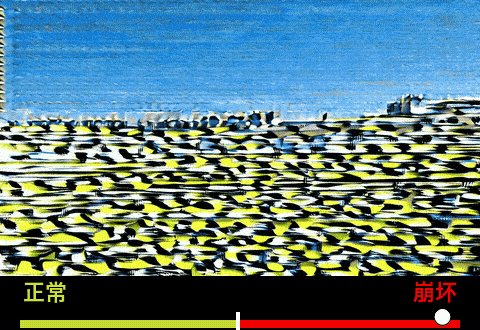
在 30 秒处开始画质崩坏视频,使用 6 倍加速展示
前不久,高德视觉技术中心联合南京大学、清华大学、北京大学推出 WorldRoamBench,以 1000+ 个长时漫游样例,从动作、视觉、物理和记忆四个维度系统评测 12 款主流的交互式世界模型,试图回答一个更逼近真实落地应用的问题:世界模型能否通过长时交互的终极考验——遵循用户动作和物理规律,保持视觉一致性与长期记忆。
核心破局:让世界模型评测真正走进长时交互
一段看似完整的漫游,背后可能藏着完全不同的问题:动作被漏掉、画面中途崩坏、物理规律失守,重访时场景变样。如果评测只给出一个总分,模型为什么失效依然是黑盒。WorldRoamBench 因此将长时交互拆成动作、视觉、物理和记忆四个能力维度开展评估。
1. 动作轨迹会「骗人」:走对了路,不代表每一步都听指挥
动作控制评测面临一个长期被忽视的问题:最终动作轨迹正确,并不意味着模型准确执行了用户的每一次操作。不同模型的动作幅度并不统一,而轨迹级指标又容易掩盖局部的延迟、误响应和方向错误。对于交互式世界模型,重要的不只是最后走到了哪里,更是每一次输入能否得到及时、准确、连续的反馈。
如下图所示,用户全程输入前进指令,画面却在中途多次出现反向后退。由于最终形成的整体轨迹与预期基本一致,这些局部的动作遵循错误很难被轨迹评测发现。
3 倍加速展示
2. 画面何时开始「漂」:追踪长时视觉稳定性
长时交互要求生成世界保持视觉稳定,但现有评测大多关注平均画质,或者只比较视频的开头和结尾画质差异,因此很容易忽略中途发生的视觉漂移。随着交互时间延长,误差可能不断累积,导致画面出现漂移、形变,甚至结构崩坏。即使画面随后恢复,这些问题也可能被平均分稀释,或在首尾帧画质对比中完全消失。但对用户来说,任何一次明显的视觉漂移,都足以打断沉浸感。
因此,长时视觉评测不仅要衡量总体画质,还要追踪生成过程中是否出现过视觉漂移。如下图所示,画面在中途发生明显漂移,随后又恢复正常。如果只比较首尾帧,这次漂移就会被完全掩盖。
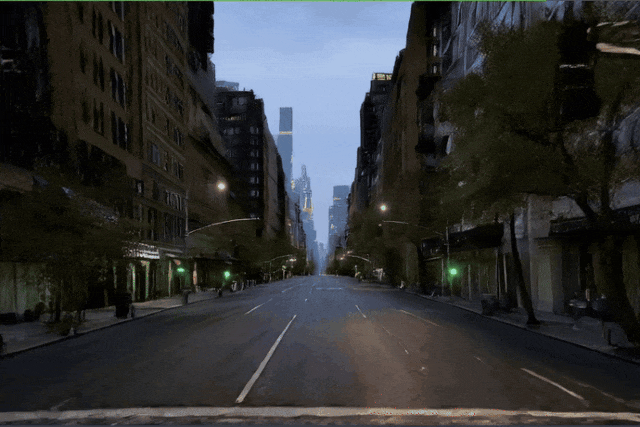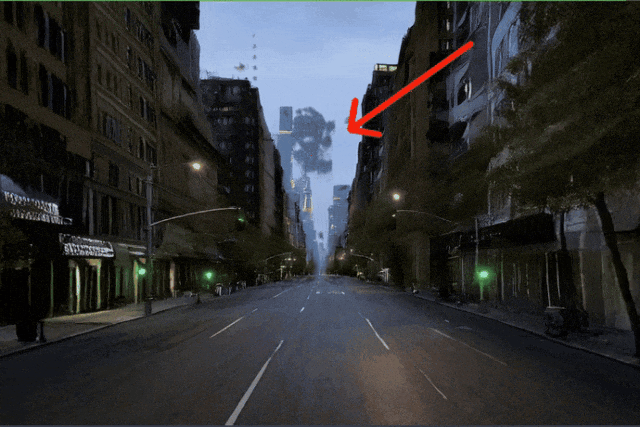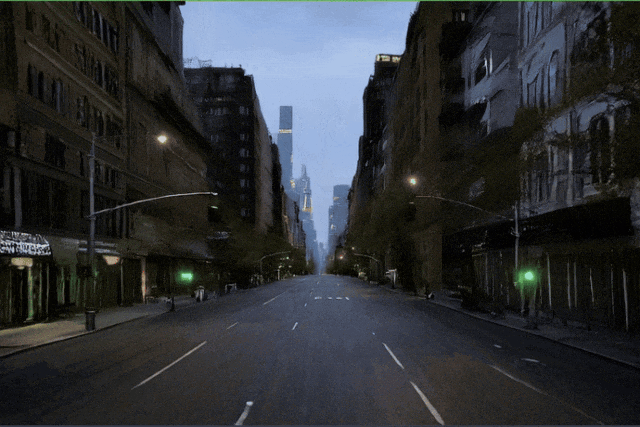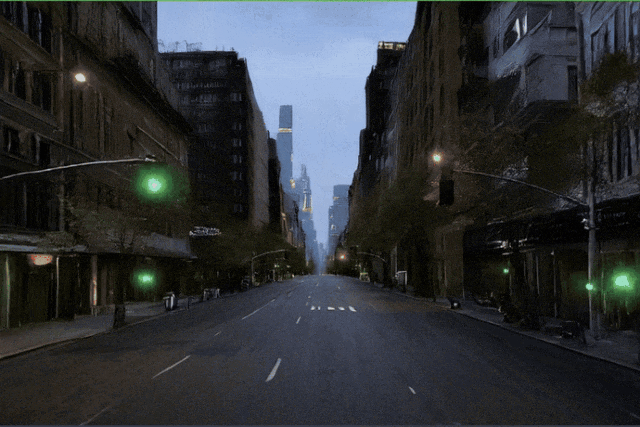
2 倍加速展示
3. 世界会「穿帮」:在交互中检验物理规律遵循
在长时交互中,生成的世界需要对每一次行动作出符合物理规律的反馈。但现有评测大多侧重于判断场景本身是否合理,较少考察交互发生后,生成世界的响应是否符合物理规律。
如下图所示,主体向前走到墙前,模型却没有停下,而是直接穿墙而过。只有真正触发碰撞,这类物理错误才会暴露。为此,WorldRoamBench 设计了一系列具体的交互测试,先确认待测交互确实发生,再判断世界作出的反应是否遵循物理规律。评测覆盖力学、光学和三维空间一致性等多个方面。
4. 「死亡旋转」之后,世界模型也会「失忆」
所谓「死亡旋转」,就是让模型先进行旋转,再沿相反方向返回,观察前后场景是否保持一致。现有记忆评测通常直接比较离开前和返回后的画面,但画面不同不一定是因为模型忘记了场景,也可能是主体没有准确回到原来的位置。
为此,WorldRoamBench 先排除复访位置偏差,再判断原有场景保留了多少、又出现了多少不存在的内容。如下图所示,主体返回后存在一定的位置偏差。评测时,不将这部分偏差造成的画面差异视为记忆错误,而只考察对应区域内的场景变化。结果显示,原本应当可见的白色房屋仍完全消失,说明模型未能保留此前生成的场景,表现出明显的「失忆」现象。
2 倍加速展示
测评实战:Genie 3 也「偏科」,可靠交互仍未到来
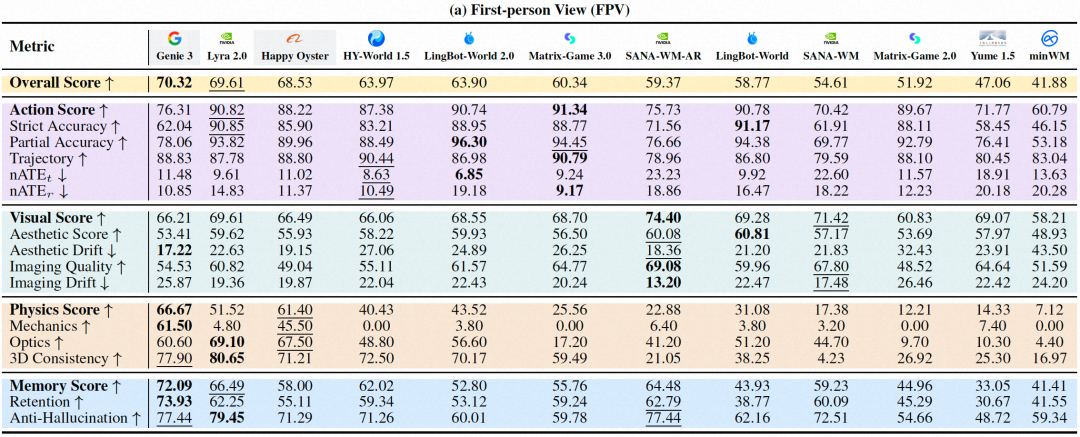
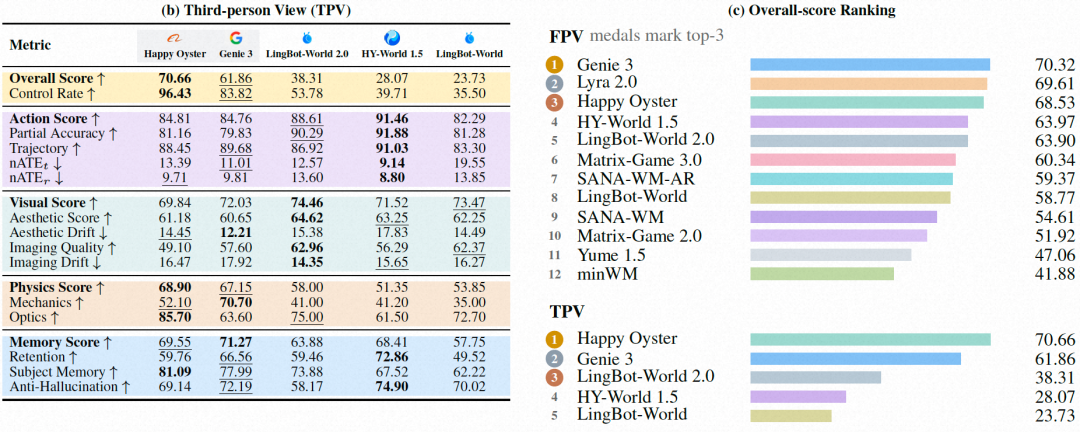
基于上述四维评测体系,在 1000+ 个开放世界长时样例统一测试 Genie 3、Happy Oyster、LingBot-World 等 12 款世界模型,覆盖第一、第三人称及自然、城市、室内等多类场景,并通过差异化任务设计减少动作、物理和记忆之间的相互干扰。
结果显示,没有任何一个模型能够成为「全能冠军」。从 WorldRoamBench 的榜单中看到,第一人称综合榜中,Genie 3、Lyra 2.0 和 Happy Oyster 分列前三;第三人称综合榜中,Happy Oyster 位列第一,Genie 3 紧随其后。
但综合排名掩盖不了分项短板,Genie 3 同样存在明显「偏科」:Genie 3 在第一人称场景中的记忆与物理表现均位居第一,但动作遵循和视觉质量仅分别排名第八和第九。
开源共建:让 Benchmark 与可交互世界模型一起进化
WorldRoamBench 榜单并不局限于当前评测的 12 款模型。据悉,WorldRoamBench 已开放评测入口,支持下载试题,并上传模型推理结果至官网进行模型评测。评测代码和执行脚本也将逐步开放。
WorldRoamBench 的提出,意味着可交互世界模型的竞争正进入新阶段:从短时动作遵循,走向长时交互下的综合稳定性。对于正在探索 AI 与 大模型 应用边界的团队来说,这类系统性评测基准的价值或许远超一个简单的排行榜单——它迫使我们重新审视「可用」二字的真实含义:模型能走进去,和模型能陪你走完,中间还隔着动作、视觉、物理、记忆四道关卡。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
 发表于 3 天前
|
查看: 0|
回复: 0


