最近,要说 AI 技术圈最亮眼的词,非 RSI(递归自我改进)莫属。
今天分享的 RSI-Anything,主打一个“万物皆可 RSI”。不管你是写代码修 bug、操作 GUI 界面,还是规划实验室流程、优化化学反应,同一套机制,都能跑通自我进化闭环。
01 框架:预演、学习、留用,三步一闭环
整条环路建在 JEPA-Anything 的预测底座上,转法分三步。
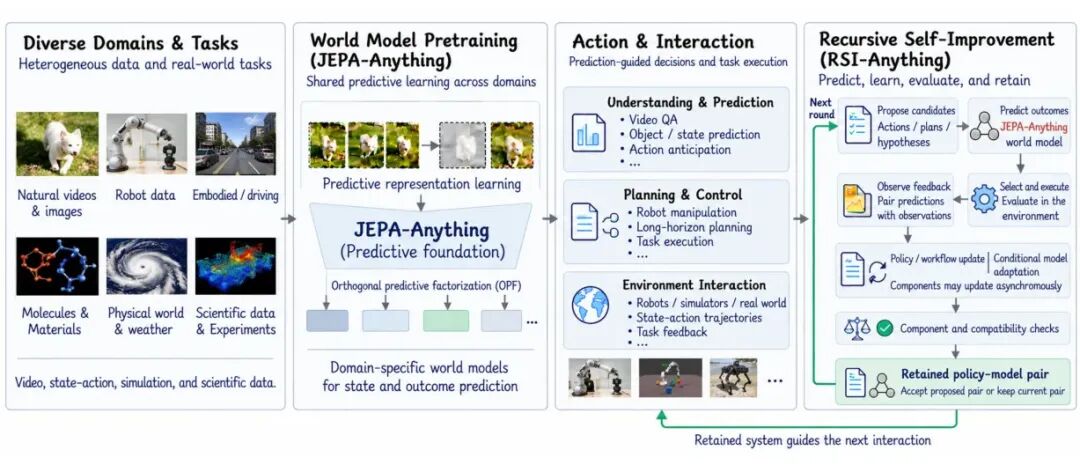
- 先预演。 策略提出候选动作,世界模型逐一预测后果,挑出最值得花反馈预算的那个去执行。
- 再学习。 真实观测回来,一边更新策略或工作流,一边检查预测器还靠不靠谱——不可靠才触发模型自适应,避免无谓开销。
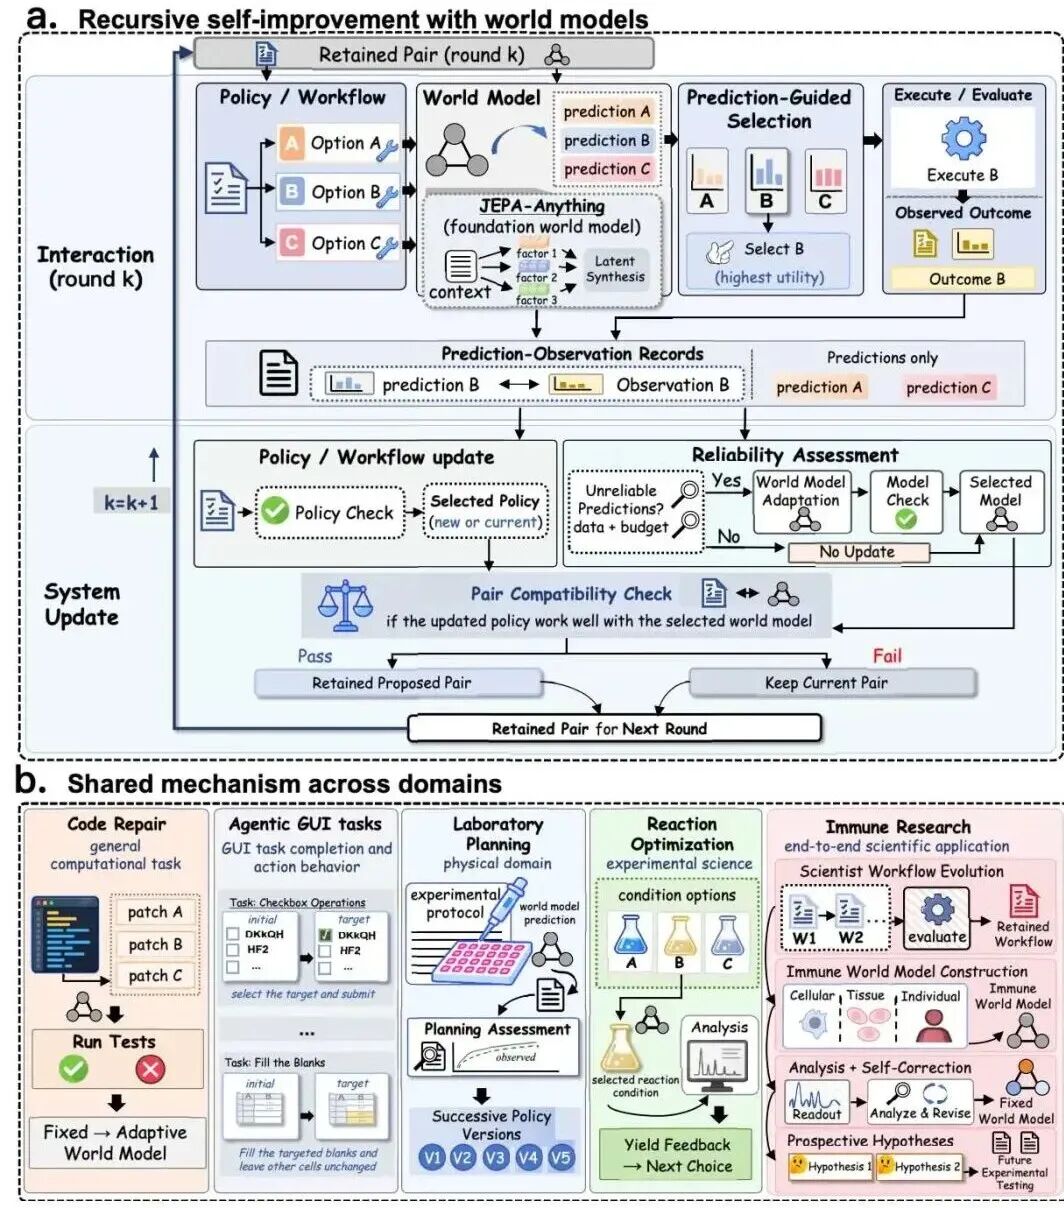
- 后留用。 组件检查与兼容性检查决定新的「策略—模型对」能否留下,留存的版本塑造下一轮的候选与学习数据。
02 修代码:选 patch 的眼光,是练出来的
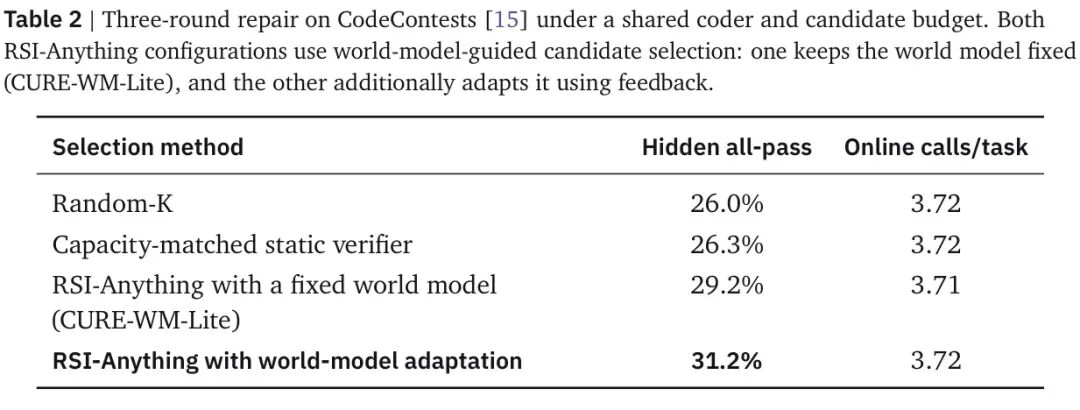
固定同一个 coder,每轮生成四个修复候选,只能真跑一个。选哪个?世界模型说了算。
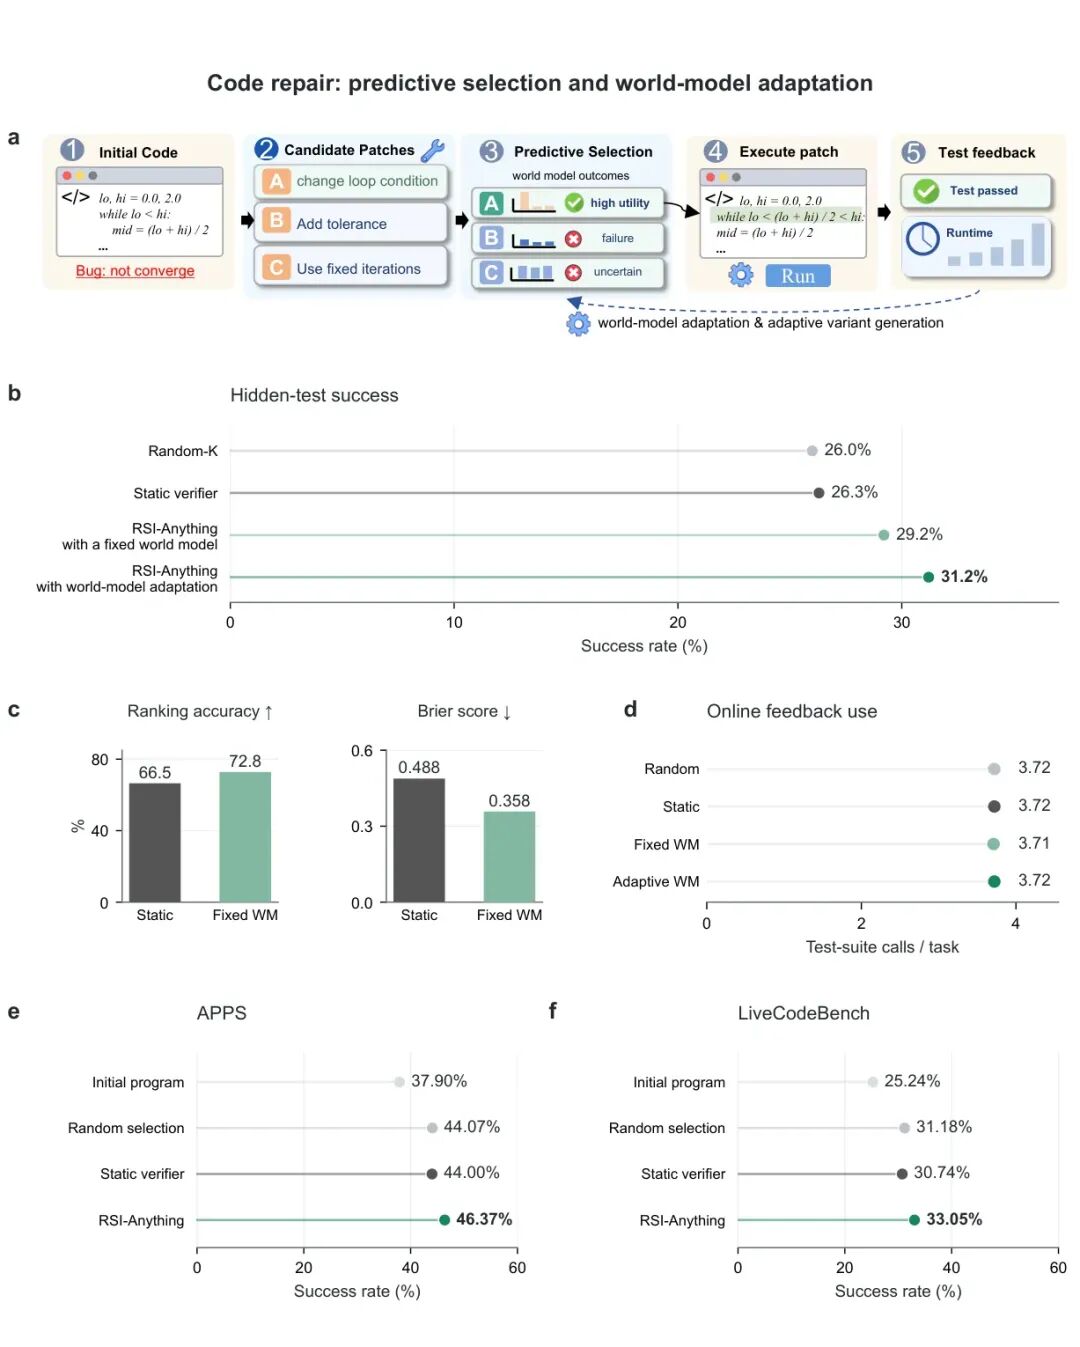
引入预测性选择后,隐藏测试通过率从静态验证器的 26.3% 升到 29.2%;再用执行反馈反哺预测器,进一步到 31.2%。候选排序准确率从 66.5% 提到 72.8%,五分类 Brier 分数从 0.488 降到 0.358,预测明显更准也更稳,而在线测试调用几乎没变——同样的反馈预算,纯靠「眼光」多涨近 5 个点。
换到 APPS 入门集与 LiveCodeBench v6,优势照样成立:最终全测通过率分别为 46.37% 与 33.05%,都压过随机选择与静态验证器。
03 点界面:点得更少,错得更少
GUI 任务的提升更直观。MiniWoB++ 勾选任务上,成功率从基线 51% 一路爬到 99%,平均动作数反而降了 39.4%(5.30→3.21 次/回合),重复点击从 237 次直接清零。到了更接近真实电脑的 OSWorld,它比初始智能体高出 18.4%,比联合优化策略、奖励与环境的 RLAnything 还要再高 5.5%。
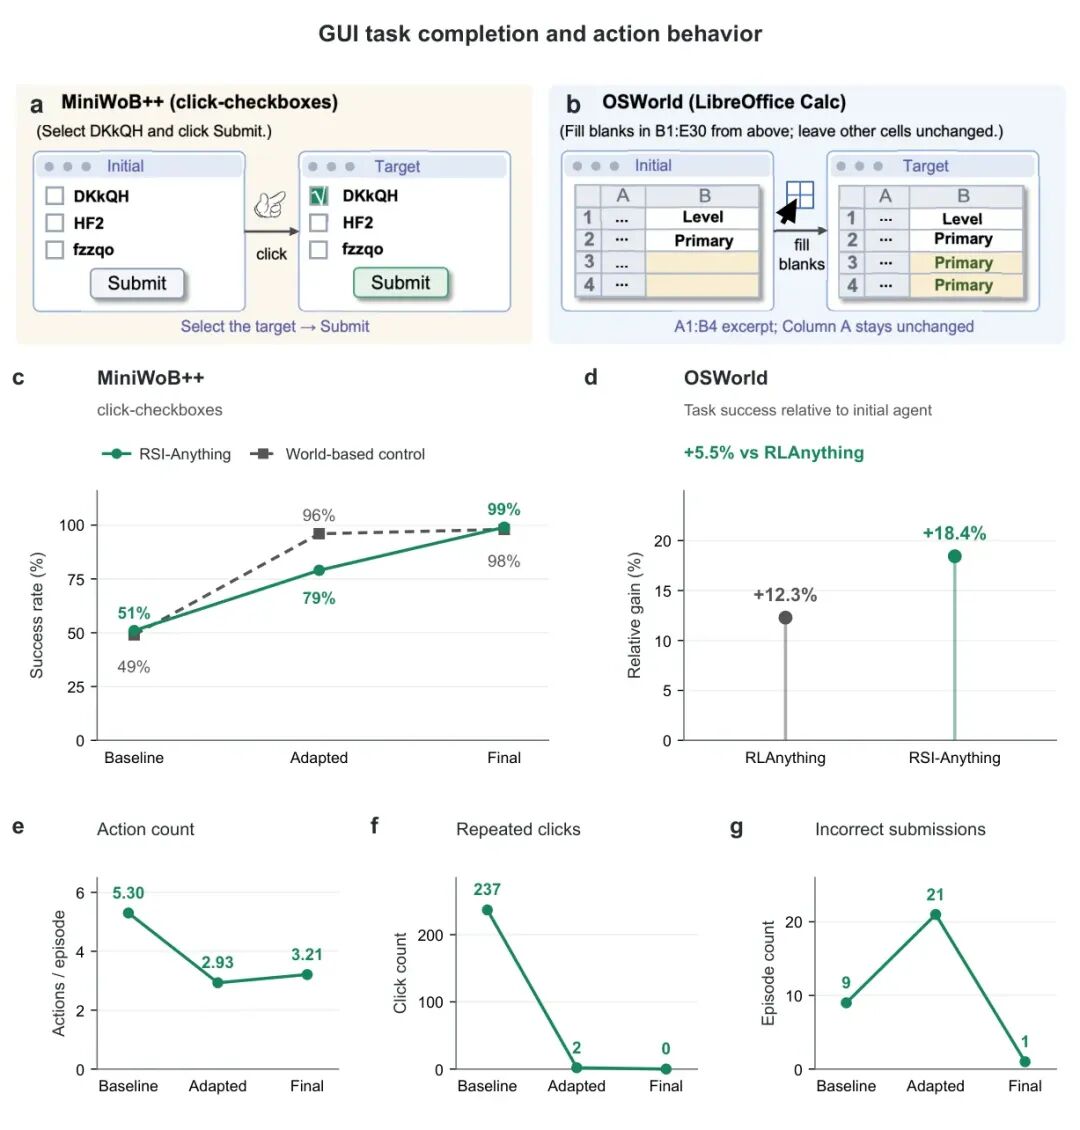
中间还有个耐人寻味的插曲:过渡的「适配版」配置动作更省(每回合 2.93 次),却带来 21 次错误提交;最终版把误提交压到 1 次,代价只是每个回合多零点几步。留用检查挑中的,不是最快的版本,而是综合最稳的那个。
04 排实验:4B 小模型,五个版本一路爬坡
实验室规划是这套框架最「物理」的考验。同一个 4B 策略,在 RSI-Anything 流程里连续迭代出五个版本,LabHorizon F200 Level-2 得分从 21.80% 爬到 46.01%,翻了一倍还多。
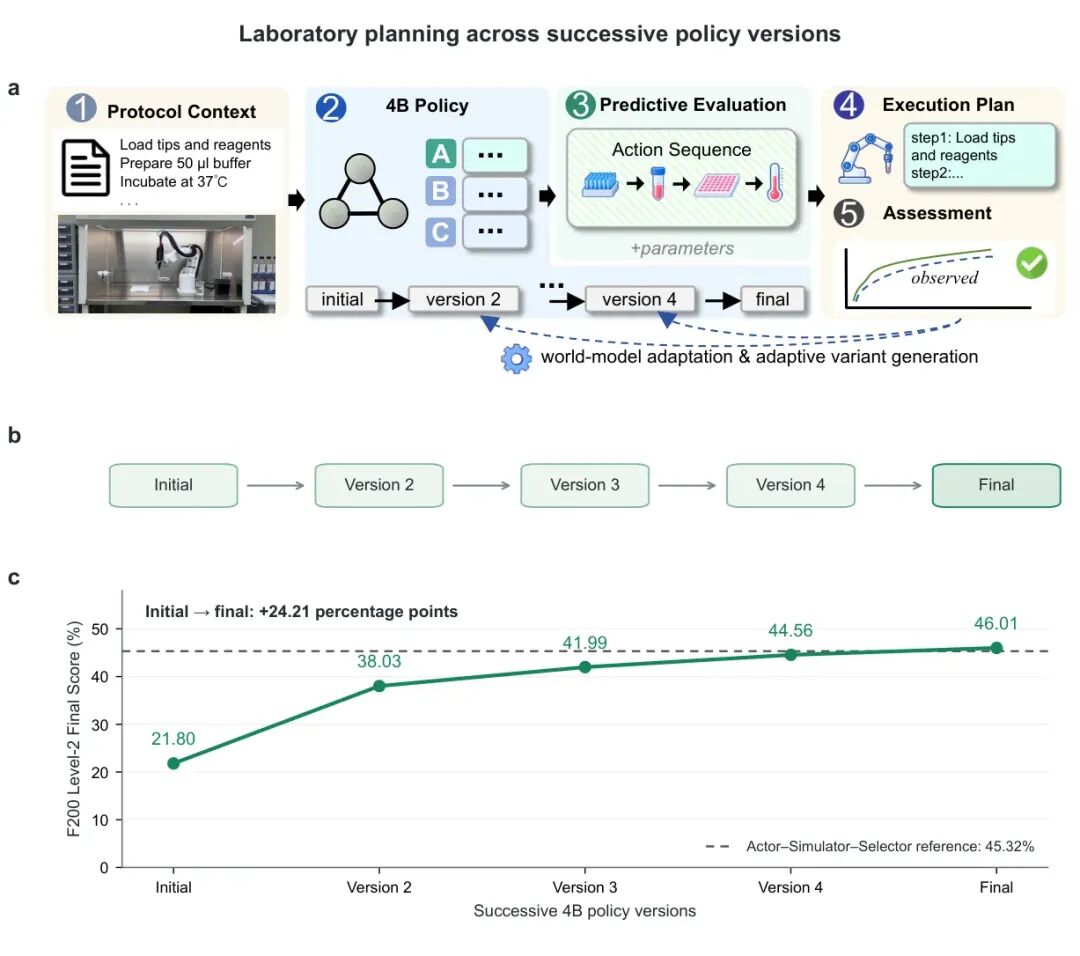
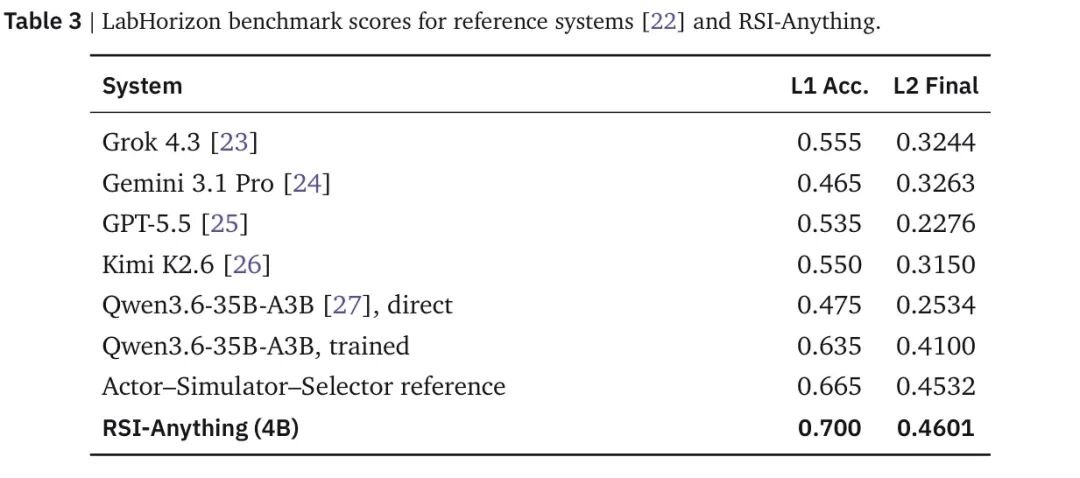
顺手超过了由 35B Actor 加 Gemini 3.1 Pro 组成的 Actor–Simulator–Selector 参考系统(45.32%)。Level-1 下一步动作预测准确率 0.700,同样高于参考系统的 0.665。
05 做化学:40 次实验,多榨出 14 个百分点产率
化学是检验「反馈预算」最严苛的场景——每条数据都是真金白银的实验。两个 Suzuki–Miyaura 偶联筛选中,RSI-Anything 用世界模型预测产率来排序候选条件,再拿实测产率反哺模型。
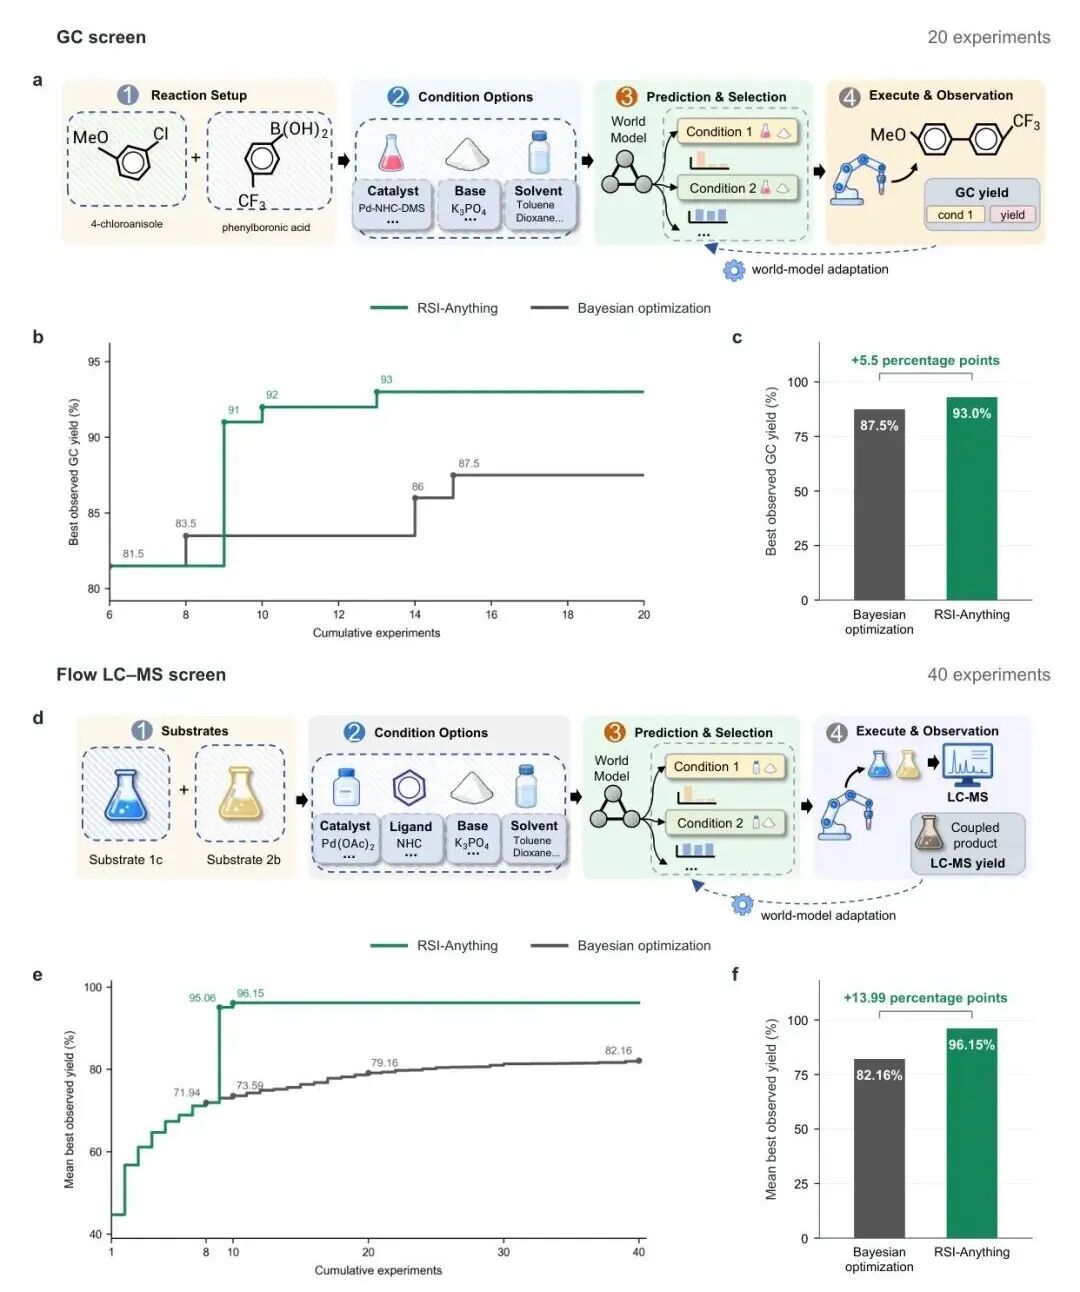
GC 筛选 20 次实验后,最佳产率 93.0% 对 87.5%;流动相筛选 40 次实验后是 96.15% 对 82.16%——同样的实验次数,多榨出近 14 个百分点。
06 免疫科学:从进化工作流到治疗假设
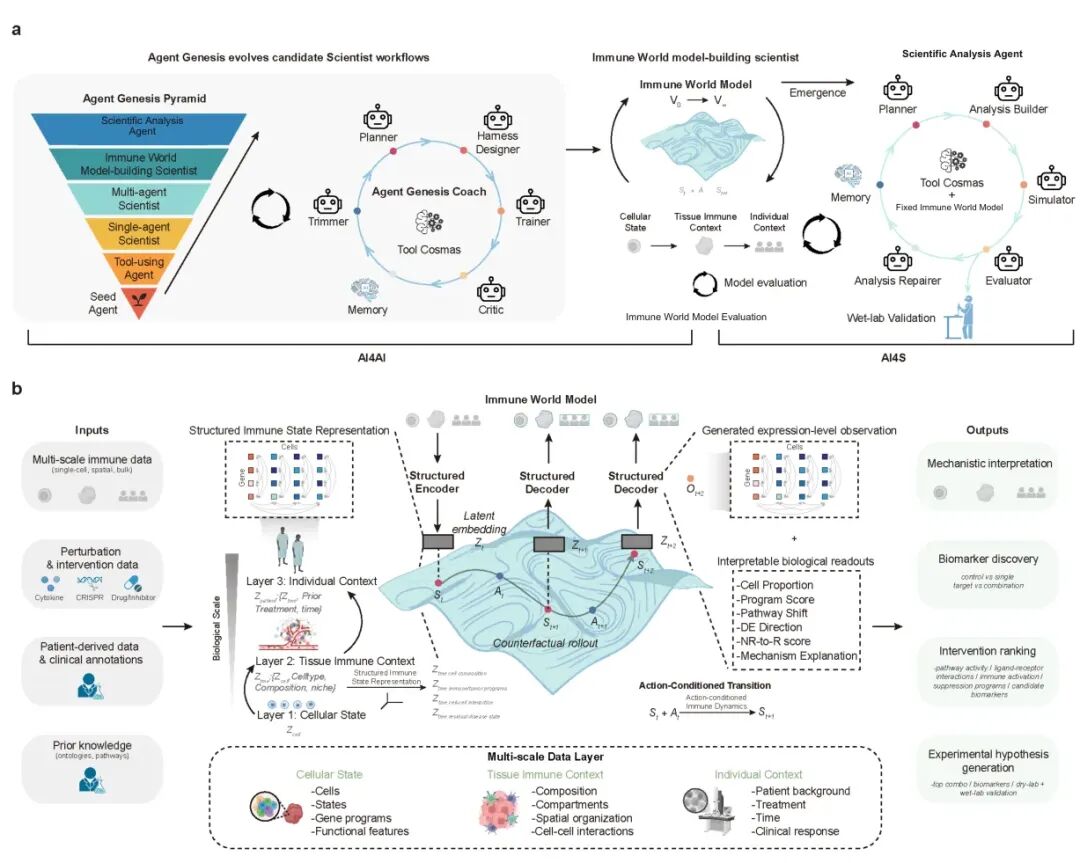
压轴是一场端到端演示:先用 Agent Genesis 进化出科学智能体工作流,构建免疫世界模型——它把细胞、组织、个体三层免疫状态都编码进来,把细胞因子、基因扰动与候选疗法当作显式动作去预测后果。随后分析智能体带着这个模型做模拟、自纠错、排候选,最终产出前瞻性治疗假设——SIRPα 抑制联合 IL-36γ 轴调控。从「怎么搭流程」到「提出什么假说」,整条链路都套在同一个框架里。
相关链接:
|  发表于 1 小时前
|
查看: 4|
回复: 0


