744B 参数的 MoE 大模型,常规认知里需要几十万元的服务器集群。可 GitHub 上一个 3.5 万 Star 的纯 C 项目,硬把它塞进 25GB 内存的消费级电脑,速度居然还能用。
痛点:参数越大,门槛越高,普通人连门都摸不着
这两年大模型的参数规模像坐上了火箭。
从 70B 到 405B,再到 744B、2.8T,MoE(混合专家)架构让总参数膨胀得越来越快。但每个 token 真正激活的参数只有几十 B,其余专家都在「待命」。矛盾点在于:知识储量上去了,加载门槛也把大多数人挡在门外。
一张 24GB 显存的 4090 跑 70B 都费劲;想在本地跑 744B,常规思路要么堆更多卡、要么租更大的云实例,要么做激进量化牺牲精度。按 2026 年主流云厂商 A100/H100 实例报价,一台 8×A100 包年费用足够在二线城市付一套房首付;按小时租用,跑一个 744B 做几轮长对话,账单也能吃掉小团队一周预算。对独立开发者、高校实验室、隐私敏感企业来说,这几乎等于劝退。
于是行业形成默认共识:大参数模型天然属于云端。数据必须出门,成本必须交给云厂商,本地只配跑小模型或调用 API。Colibrì 的出现,把这道口子撕开了。
项目登场:Tiny engine, immense model
Colibrì(GitHub: JustVugg/colibri,截至 README 2026-09-17 已获 35,284 Stars)是一个纯 C 编写、零依赖的 MoE 推理引擎。它的口号很直接:「Tiny engine, immense model.」
核心思路不是把模型硬塞进显存,而是把 VRAM、RAM、NVMe SSD 统一成一个推理层级(AI memory multitiering)。重点是放置(placement)而不是适配(fit)——哪里放得下、哪里速度快,权重就放哪里;激活时再按需加载。
项目方给了一个关键承诺:速度无 SLA,但语义有硬保证。也就是说,内存不够只会让你慢一点,绝不会静默改精度、改路由、改输出结果。
目前已支持 GLM-5.2 744B、Kimi K3 2.8T、DeepSeek V4 Flash、Qwen3.6 等 9 个模型家族,而且「None of them needs a GPU」。
核心能力一:把 VRAM、RAM、NVMe 当成一层内存
MoE 的稀疏性给了 Colibrì 第一个杠杆。
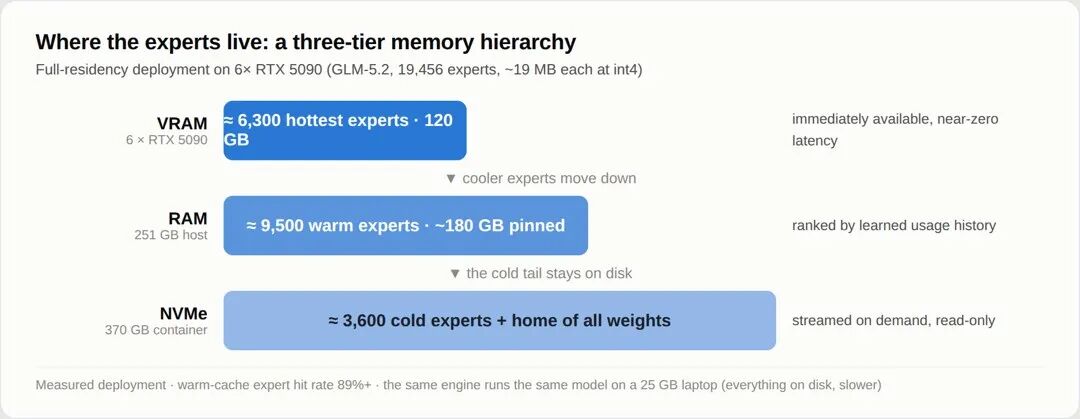
以 GLM-5.2 744B 为例,每个 token 只激活约 40B 参数,其中真正随 token 变化的路由专家约 11GB。稠密部分(attention、shared experts、embeddings)约 17B 参数,int4 量化后常驻 RAM 约 9.9GB。
剩下的 19,456 个路由专家,int4 后每个约 19MB,合计约 370GB,直接留在磁盘。需要哪个,就流式加载哪个。
这听起来像最简单的「换入换出」,但 Colibrì 把它做成了权重的 JIT:
- 路由一层前可预测性约 71.6%,引擎用逐层 LRU + 学习到的 pinned hot-store 做缓存;
PILOT=1 开启一层前瞻预取,在当前层计算时提前把下一层专家拉上来;- 运行中自动更新
.coli_usage 文件,越常用的专家越容易 pin 在 RAM/VRAM;
- 内存预算不足时,只降级速度,不降级精度。
这套放置策略把「专家热度」也当成可学习资源。第一次运行可能较慢,因为 .coli_usage 还没建立;随着对话进行,引擎会越来越清楚哪些专家该常驻 RAM、哪些可以留磁盘、哪些值得 pin 到 VRAM。对多轮长对话、固定领域问答等场景,第二次启动往往比第一次快很多。
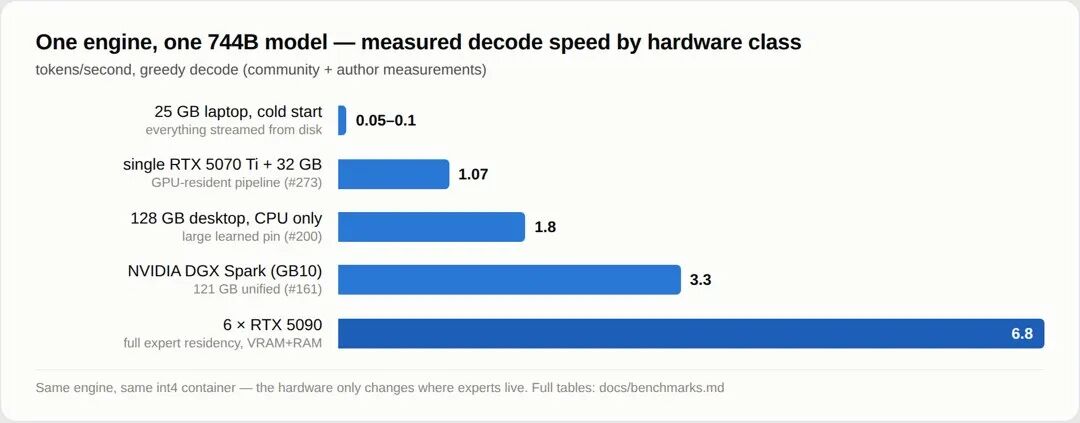
结果是在 128GB CPU-only 台式机上,warm 后约 1.8 tok/s;25GB 主机冷启动也能把模型跑起来,只是速度落在 0.05–0.1 tok/s 的诚实基线。项目方没有藏这个数字,反而把它写进 README 当参考。对很多只想「本地验证」「私有部署」「离线跑长尾任务」的场景,这已经够了。
核心能力二:I/O 不是后勤,而是推理的前线
如果每次加载专家都要等磁盘,解码会被 I/O 拖死。Colibrì 的做法是让 I/O 深度参与计算调度。关键优化包括:
- batch-union:同一个 batch 里多个位置需要同一个专家时,只读一次;
- 有界异步 I/O 池(
PIPE=1):常驻专家计算时,并行加载缺失专家;
- 路由前瞻线程(
PILOT=1):基于下一层路由预测提前预取;
O_DIRECT(DIRECT=1):绕过页缓存,在带 DRAM cache 的 NVMe 上实测 decode 提升 34%;- 双 SSD 加权镜像(
COLI_MODEL_MIRROR + COLI_DISK_WEIGHTS):按 hash 把读请求分流到两块盘,聚合带宽。
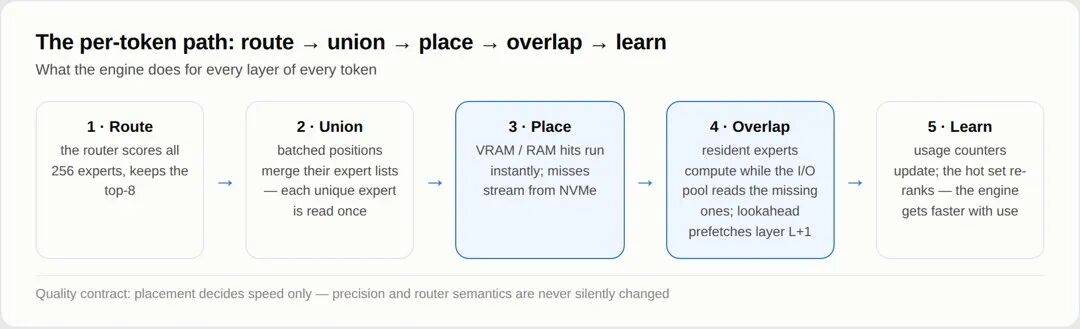
这些设计有一个共同目标:让 GPU/CPU 永远不因为等权重而空转。
实测中,两块分别为 9GB/s 和 3GB/s 的 SSD 组合,比单块快盘还能再快 33%。在 I/O 密集型的 MoE 推理里,磁盘带宽和计算带宽被拉到同一优先级。
核心能力三:无 GPU 能跑,有 GPU 更快
Colibrì 不假设你手里有 A100。
它支持 CPU、CUDA、Metal、Vulkan、NUMA,以及「部分专家驻留 VRAM」的混合模式。官方文档的说法是:GPU 只让它更快,不是让它能跑。
- 6× RTX 5090 全驻留 744B,decode 5.8–6.8 tok/s,TTFT 约 13 秒;
- 单张 RTX 5070 Ti 笔记本级,约 1.07 tok/s;
- Apple Silicon 有实验 Metal 后端;
- Vulkan 后端让 AMD 老卡(包括 RX 580)也能上场;NVIDIA GTX 10 / RTX 20 可用
CUDA_ARCH=portable-pre-ampere NO_TC=1。
更有意思的是本地集群模式:coordinator 负责 token 生成、路由和 KV,worker 通过持久 TCP 接收「一层 routed batch-union」执行 FFN。多台普通机器可以拼成一个推理集群,不用每台都买满配 GPU。
核心能力四:语义硬保证,不靠牺牲精度换速度
很多量化/压缩方案为了「能跑」,会悄悄降精度、改路由阈值,输出质量随之漂移。
Colibrì 把这一点写进设计原则:never silently changes model precision or router semantics。
具体手段包括:
- 前向与
transformers oracle 逐 token 校验,teacher-forcing 通常 30–32/32 通过;
- MLA KV 状态压缩 57×(从 32,768 floats/token 降到 576),可持久化到
.coli_kv,重启后零 re-prefill;
- DSA 稀疏注意力强制全 key 选择,保证可复现稠密注意力;
- 量化方案明确标注误差,例如 gs64 相比 per-row int4 在 Qwen3.6 上 cosine 从 0.98777 提升到 0.99313。
也就是说,你可以在本地跑一个「和云上版本输出一致」的大模型,而不是被悄悄阉割过的版本。
架构哲学:把「内存层级」当作一等公民
Colibrì 的架构设计完全围绕「多层内存统一调度」展开:
- 每个模型家族对应一个
.c 引擎文件 + 共享头文件,公共机制一处修复、多处受益;
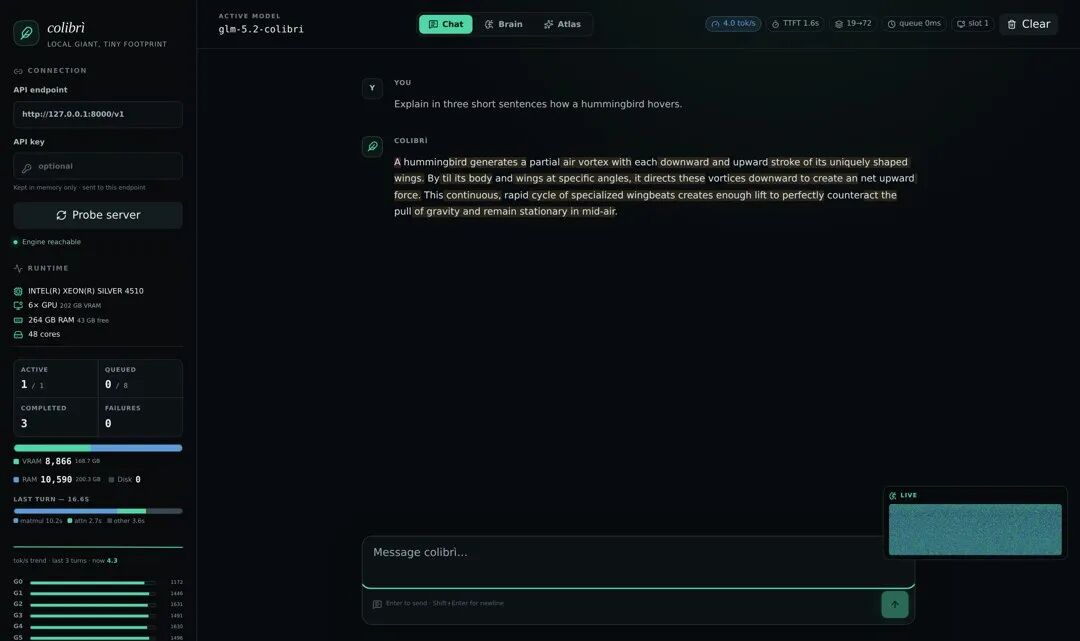
coli plan / doctor / tune 三位一体:先看 placement 计划,再做只读就绪检查,最后测量并保存本机最快安全 profile;kv_prefix.h 支持前缀复用,route_trace.h 提供引擎无关的路由遥测;- Web Dashboard 实时显示 VRAM/RAM/disk 三层占用、每轮时间分解、token 指标。
它不是在传统推理引擎上补一个缓存层,而是把缓存、预取、放置、压缩从头设计成推理的第一性原理。
快速上手:从下载到对话的最小路径
Colibrì 提供预编译二进制,解压即可用。以 Linux x86_64 为例:
mkdir colibri && tar xzf colibri-v1.8.0-linux-x86_64.tar.gz -C colibri
cd colibri
python3 coli info
获取 GLM-5.2 参考模型(推荐 gs64 + int8 MTP,约 372GB):
# 模型目录放入足够空间的磁盘
export COLI_MODEL=/nvme/glm52_i4
./coli doctor --deep
直接对话:
./coli chat
带 Web Dashboard 的 API 服务:
./coli serve --model /nvme/glm52_i4
./coli web --model /nvme/glm52_i4
几个常用调优环境变量:
export PIPE=1   # 有界异步 I/O 池
export PILOT=1  # 路由前瞻预取
export DIRECT=1 # O_DIRECT(NVMe 有缓存时推荐)
export DRAFT=0  # 关闭投机解码,若接受率低
常见问题:
-
Q:25GB 内存跑 744B,是不是只能跑极短对话?
A:上下文长度主要受 KV 缓存影响。Colibrì 的 MLA 把 KV 压到 576 floats/token,百万 token 上下文需要的内存远小于传统方案,25GB 也能跑几千 token 的对话。
-
Q:没有 NVMe,普通 SATA SSD 能用吗?
A:能跑,但 I/O 会成为瓶颈。DIRECT=1 在带 DRAM cache 的 NVMe 上收益最大,QLC 或虚拟化盘可能中性甚至负收益,建议先用 ./coli tune 测本机 profile。
-
Q:我想换模型,需要重新编译吗?
A:每个模型家族需要 make -C c <target> 编译一次,之后 coli chat/serve/web 的命令行不变,只需改 COLI_MODEL 指向新目录。
它 vs 同类方案
- vLLM / llama.cpp:更通用、生态更成熟,但通常要求权重能装进显存/内存;Colibrì 专攻「参数远超本地内存」的 MoE 场景。
- 云端 API:省心,但涉及数据出境、隐私、成本;Colibrì 让你把 744B 留在本地硬盘,按自己节奏运行。
- 激进量化 4-bit / GGUF:能压缩体积,但容易牺牲精度;Colibrì 用 int4 但把精度差异公开量化,并提供 gs64 等更稳方案。
结尾
Colibrì 让人印象最深的,不是让 744B 跑在消费级硬件上,而是把「能跑」和「跑得对」分开处理。
速度可以慢,资源可以少,但模型语义不能偷偷打折。这种工程态度,在当前「为了 demo 好看什么都敢压」的环境里,反而显得稀缺。
如果你也想过在本地拥有一套私有的大模型推理环境,而不是每次调用都担心数据离开自己的硬盘,Colibrì 值得放进工具箱。直接 coli chat 跑一次,感受下「小引擎扛大模型」的反差。
 发表于 4 天前
|
查看: 0|
回复: 0


