AI 越来越强,也被越来越多地用来开发下一版 AI。Anthropic 决定把这件事摆到台面上,今天一次性放出三组内部测量指标。
Anthropic 直接用自家的 Claude 审计员工,然后把数据公开。文章里丢出一张数据图:Claude 现在 lead 了 26% 的模型 R&D 工作,而一年前这个数字还只有 1%。
为什么现在要测量这件事
外界到今天都看不清 AI 实验室内部到底发生了什么。Anthropic 提出三组指标,就是想让公众、第三方机构和政府都能看到前沿 AI 内部的开发速度。
Anthropic 推文配图:业界 vs 监管的速度之争
Anthropic 的 CEO Dario Amodei 一直在喊「给速度踩一脚刹车」,并呼吁前沿实验室彼此协调。这篇文章就是这一议程的落地:用数字替代表态,把「我们正在用 AI 做 AI」这件事摊开给所有人看。
把看不到的论文透明度
三个指标分别测什么
第一项测 AI 主导的 AI 研发占比:现在有多少研究任务是由 AI 自己 lead 的;第二项测 AI agent 的监管程度,看人能不能盯住百万级 agent 的行为;第三项测算力分配,训练、研究、安全、合规各占多少。
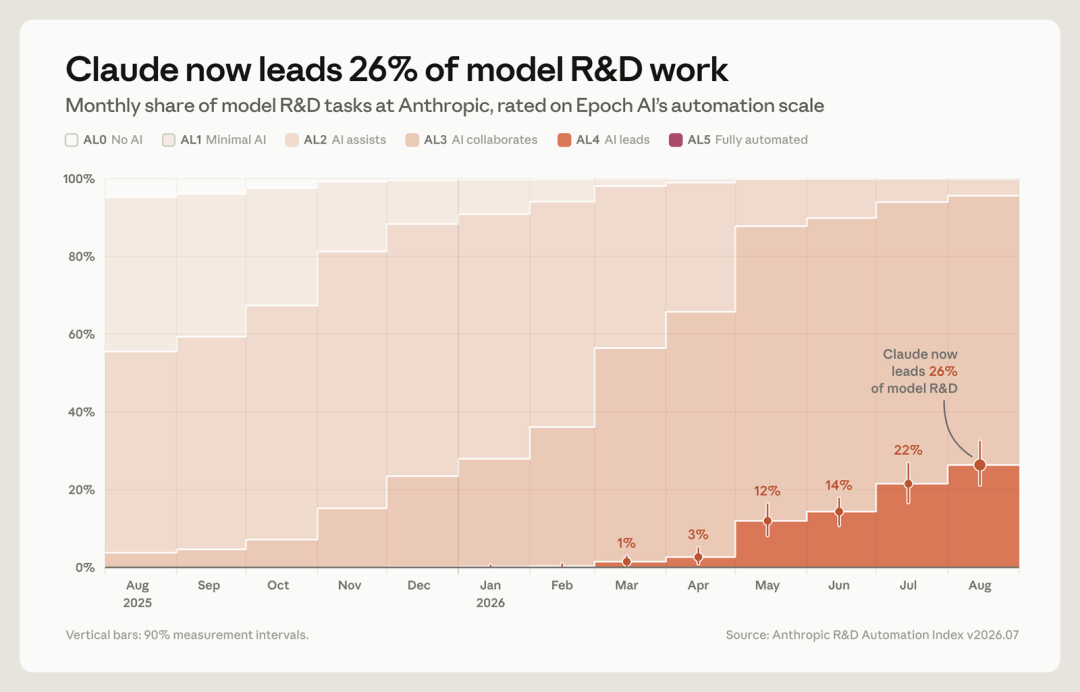
Claude 现在 lead 26% 的 Anthropic 模型 R&D 工作
Anthropic 自家快照:去年 8 月 Claude 在 R&D 任务里 lead 1% 的工作,今年 8 月已经到 26%。一年涨了 25 个百分点。AI 主导自身研发这件事,不再是预测,而是正在进行。
- AI 主导 AI 研发:从 1% 涨到 26%(一年)。
- AI agent 监管:监控体系能否盖住百万级 agent 的累计行为。
- 算力分配:训练、研究、安全、合规各占多少。
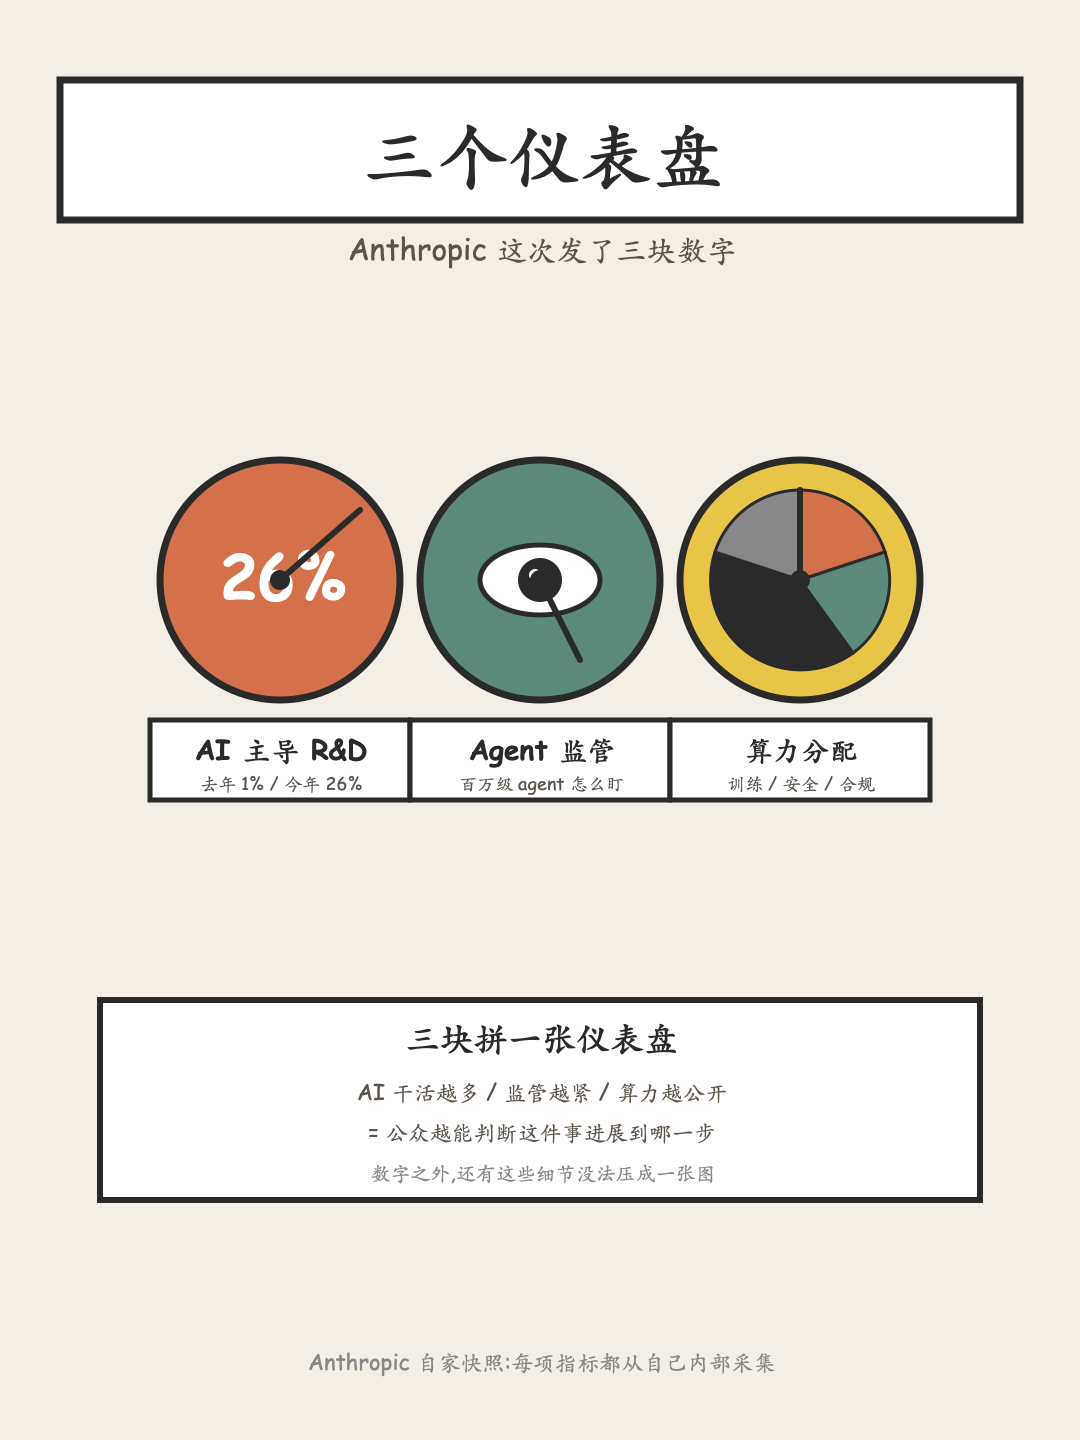
三个仪表盘:AI 干活比例 / agent 监管 / 算力
数字怎么来的,又有哪些不能说的
Anthropic 自己也承认了三个局限:一是跨实验室没有通用方法;二是评估模型和被评估模型属于同一族,可能共享同样的错误;三是长期目标是让独立第三方评估员嵌进流程,但目前还没做到。
具体方法也摆了出来:随机抽取 20% 员工的一周工作量,让 Claude 研究 agent 翻看 Slack 和内部文档,给每条任务打分;训练和评估 run 则按 metadata + 代码交给分类器判断,抽取 14% 的近 10000 个 run。
结论偏保守。同一份算力如果同时推进能力和安全,按更保守原则就不计入安全那一栏。安全与研究怎么画线、谁来举证,这些也需要业界共识。
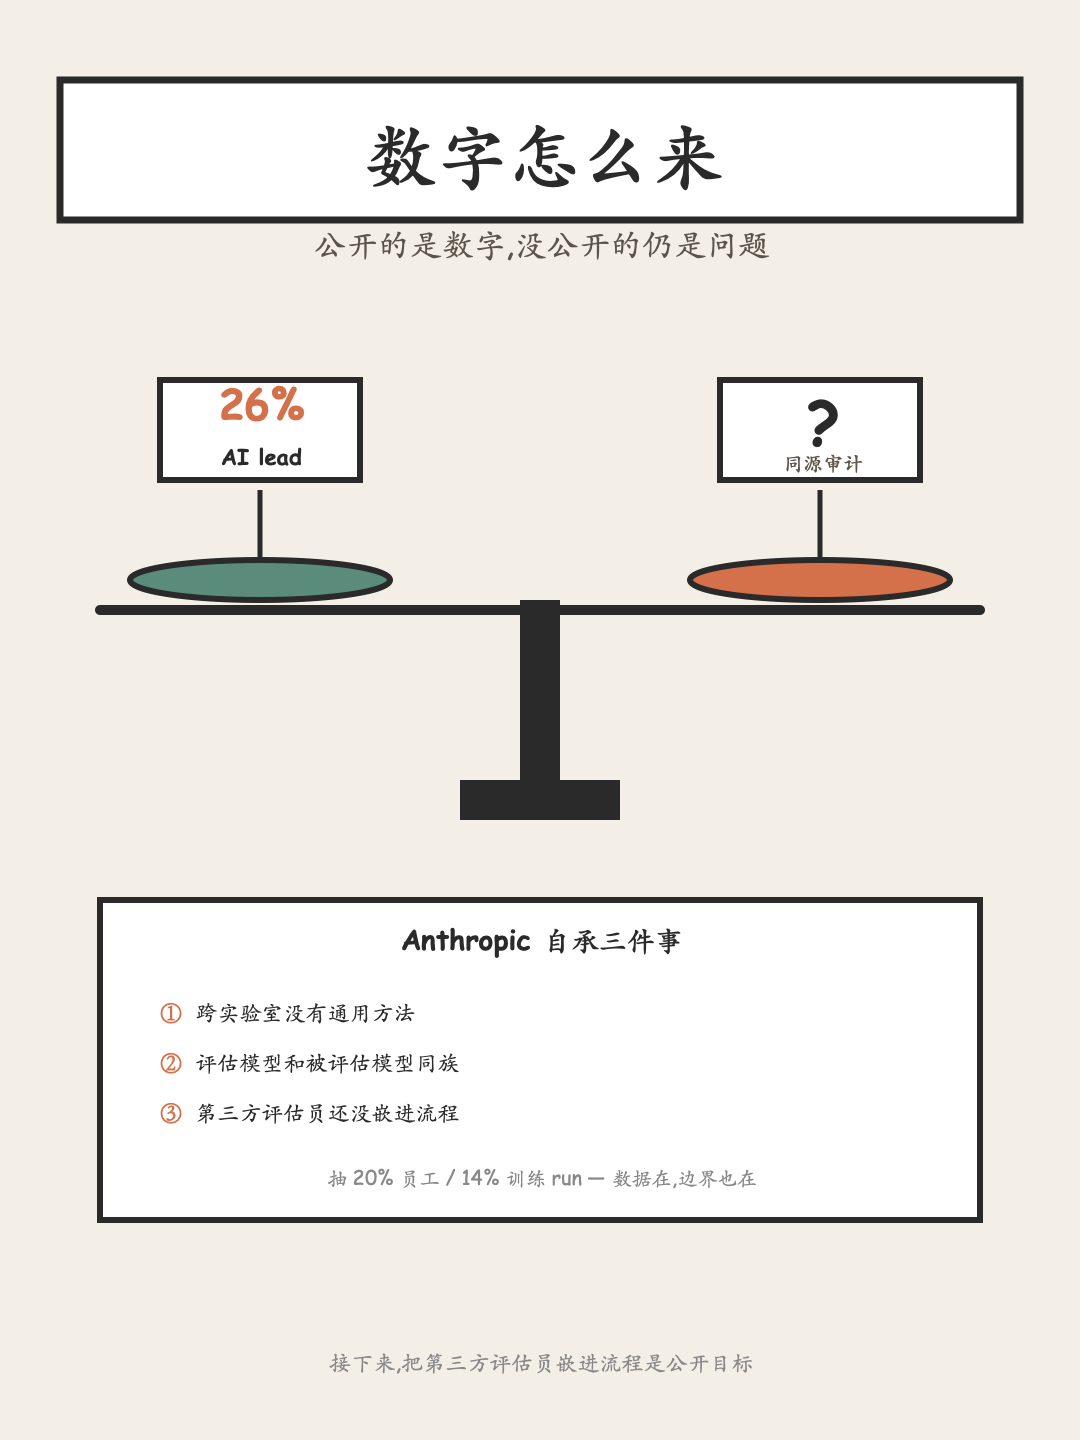
公开的是数字,没公开的仍是问题
主要来源 · Sources
- @AnthropicAI 推文:测量 AI 发展速度的三项指标
- Anthropic Institute:Measurements for understanding the pace of AI development inside frontier labs
|  发表于 半小时前
|
查看: 4|
回复: 0


