前三篇写完,我以为 MCP 最难的部分已经讲清楚了:它解决接入,不解决选型、编排和稳定性;工具一多要路由;跨信任边界必须把硬约束落进代码。
但真正把一个订单接口改造成 MCP Tool 后,我发现还漏了一个更基础的问题——我们过去设计的 API,是给确定性程序调用的;现在调用它的,却变成了一个概率模型。
调用方变了,接口设计规则也跟着变了。
这篇不从「怎么添加依赖」开始。
因为给方法加上 @McpTool,可能十分钟就能跑通。
真正困难的是:
Agent 能不能找到它?
能不能判断什么时候该调用?
能不能把参数填对?
能不能理解返回结果?
出错后知不知道下一步怎么办?
涉及写操作时,系统敢不敢让它执行?
这些问题,协议跑通并不会自动解决。
Inspector 全绿,Agent 却不一定会用
假设订单系统原来有这样一个方法:
public String query(String value) {
    return orderService.query(value);
}
把它改造成 MCP Tool 非常容易:
@McpTool(description = "查询订单")
public String query(String value) {
    return orderService.query(value);
}
启动服务后,用 MCP Inspector 测试:
initialize  成功
tools/list  成功
tools/call  成功
从协议角度看,它已经是一个合格的 MCP Tool。
但把它交给 Agent,问题马上出现了。
问题 1:query 到底查询什么?
如果工具池里还有:
query_customer
query_product
query_inventory
search_order
find_logistics
模型需要从一组语义相近的名字里猜。
程序员调用 API 时,调用目标已经写死在代码里:
orderService.query(orderNo);
模型调用 Tool 时,第一步却是先判断:
这是不是我要找的那个工具?
工具名不只是方法名,它还是模型的检索入口。
问题 2:value 应该填什么?
它可能是:
订单号
用户 ID
商品名称
物流单号
一整句自然语言
Java 编译器只知道它是 String。
但模型需要知道的是它的业务语义。
问题 3:返回一大段 JSON,下一步怎么走?
假设接口返回:
{
  "code": 0,
  "data": {
    "state": 3,
    "ext": {
      "express_no": "SF1234567890"
    }
  }
}
程序员可以查接口文档,知道:
state = 3 表示已发货
express_no 是物流单号
模型看不到你的内部枚举,也不知道 ext 里的字段意味着什么。
协议层成功,只能证明三件事:
连得上
看得到
调得通
它不能证明:
选得对
填得对
看得懂
用得安全
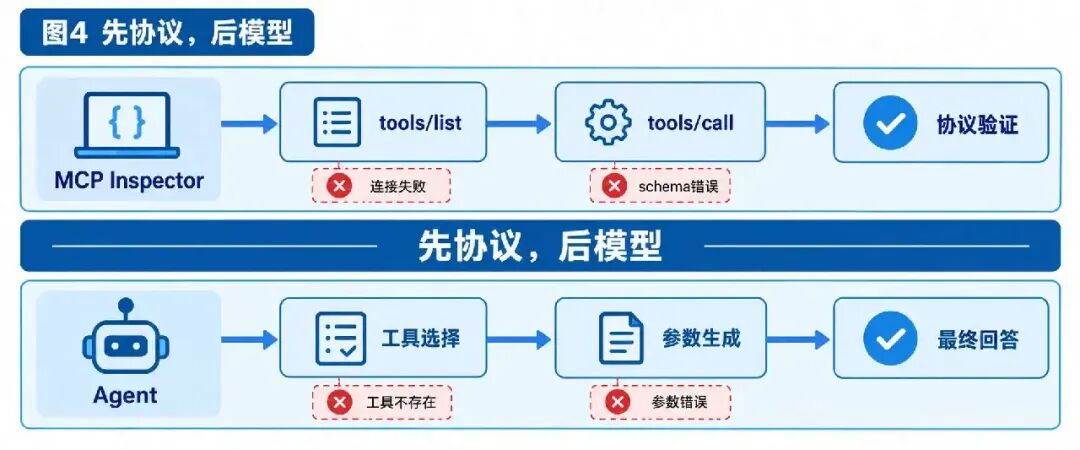
这也是这次实战得到的第一个结论:
MCP 解决的是能力如何被发现和调用,而 Tool 设计解决的是模型能否正确使用这项能力。两者不是同一个问题。
调用方从代码变成模型,API 多过一个语义层
传统 API 调用链是确定的:
程序员选定接口
    ↓
代码构造参数
    ↓
API 执行
    ↓
代码解析返回值
MCP Tool 调用链则多出了两次模型决策:
模型从工具池里选接口
    ↓
模型根据自然语言生成参数
    ↓
MCP Tool 执行
    ↓
模型理解返回结果
    ↓
模型决定下一步
也就是说,一个普通业务方法变成 MCP Tool 之后,多了四个新的接口契约:
名称契约:模型能不能找到它
描述契约:模型知不知道什么时候调用
Schema 契约:模型能不能把参数填对
结果契约:模型能不能据此继续决策
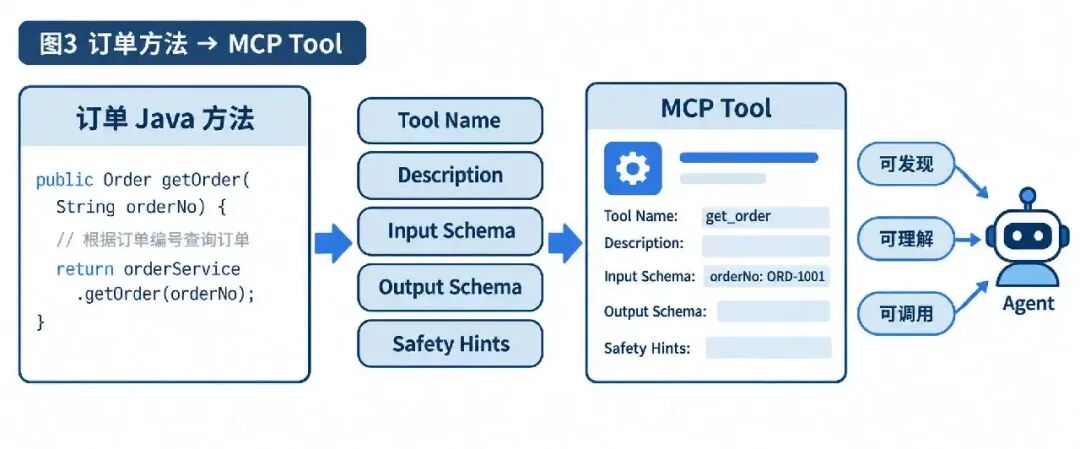
这四层共同构成了一个以前并不明显的东西:
Agent-facing API,面向 Agent 的接口。
它不是替代 REST、RPC 或 Java 方法。
它是在原来的业务接口之上,增加一层能被模型理解的语义契约。
1、工具名表达业务意图,不表达技术动作
最初的工具名是:
query
它的问题不是不能执行,而是没有说明自己的业务边界。
我把它拆成两个工具:
get_order
get_logistics
并不是因为工具越细越好。
而是这两个工具对应两个清晰、可独立判断的业务意图:
用户想知道订单信息
用户想知道物流进度
如果把它们合成一个超级工具:
handle_order_everything
短期看起来调用简单,长期却会不断加入:
查订单
查物流
取消订单
修改地址
申请退款
催发货
最后它会变成一个参数复杂、权限混乱、模型很难正确使用的万能入口。
但如果反过来,把工具拆得和数据库 CRUD 一样细:
select_order_header
select_order_item
select_payment_record
select_logistics_record
模型又必须理解内部表结构,并承担本该由业务服务完成的聚合工作。
所以工具粒度的判断标准不是「一个方法做一件事」,而是:
一个 Tool 对应一个模型可以明确识别、业务上可以独立授权的用户意图。
这和我们设计微服务边界很像。
太粗,职责混乱;太细,编排成本爆炸。
2、参数 Schema 必须表达业务语义
我们先把 value 改成 orderNo:
@McpToolParam(
    description = "订单号,例如 ORD-1001",
    required = true
)
String orderNo
这个修改看起来很小,但它同时解决了三个问题:
参数是什么
参数长什么样
参数是否必填
不过,描述仍然只是软约束。
模型可能传入:
1001
订单ORD-1001
ORD_1001
我想查ORD-1001
因此代码层还要保留硬校验:
private static final Pattern ORDER_NO =
    Pattern.compile("^ORD-[0-9]{4,20}$");

private void validateOrderNo(String orderNo) {
    if (orderNo == null || !ORDER_NO.matcher(orderNo).matches()) {
        throw new IllegalArgumentException(
            "INVALID_ORDER_NO: 订单号格式应为 ORD-加4到20位数字"
        );
    }
}
这里一定要分清两件事:
Schema 和 description:帮助模型尽量传对
代码校验:保证传错了也不能越过边界
前者提高成功率,后者守住安全底线。
这正好呼应上一篇的判据:
软约束负责引导守规矩的调用方,硬约束负责拦住不可信调用方。
大模型 并不一定恶意,但它是概率性的。从防御视角看,“模型脑补了一个错误参数”和“调用方故意构造了错误参数”,都不能绕过同一套代码校验。
3、返回值是下一轮决策依据的输入
第一个版本直接返回内部接口 JSON。
这会把三个不该暴露的问题一起甩给模型:
内部字段名
内部枚举值
内部数据结构
更稳定的做法,是返回一个面向决策的结构:
public record OrderResult(
    boolean success,
    String orderNo,
    OrderStatus status,
    String productName,
    String trackingNo,
    boolean logisticsAvailable,
    String nextAction
) {
}
例如:
{
  "success": true,
  "orderNo": "ORD-1001",
  "status": "SHIPPED",
  "productName": "机械键盘",
  "trackingNo": "SF1234567890",
  "logisticsAvailable": true,
  "nextAction": "可调用 get_logistics 查询物流进度"
}
为什么多了 logisticsAvailable 和 nextAction?
因为 Tool 的返回值不只是展示数据,它还是 Agent 下一轮推理的 Observation。
模型看到:
status = SHIPPED
trackingNo 存在
logisticsAvailable = true
就能更稳定地决定调用 get_logistics。
完整工具可以写成:
@McpTool(
    name = "get_order",
    description = "根据订单号查询订单详情。用户询问订单状态、商品或物流单号时使用",
    generateOutputSchema = true,
    annotations = @McpTool.McpAnnotations(
        title = "查询订单",
        readOnlyHint = true,
        destructiveHint = false,
        idempotentHint = true,
        openWorldHint = false
    )
)
public OrderResult getOrder(
        @McpToolParam(
            description = "订单号,例如 ORD-1001",
            required = true
        ) String orderNo) {

    validateOrderNo(orderNo);

    Order order = orderService.getByOrderNo(orderNo);

    boolean logisticsAvailable =
        order.status() == OrderStatus.SHIPPED
        && order.trackingNo() != null;

    return new OrderResult(
        true,
        order.orderNo(),
        order.status(),
        order.productName(),
        order.trackingNo(),
        logisticsAvailable,
        logisticsAvailable
            ? "可调用 get_logistics 查询物流进度"
            : "当前订单没有可查询的物流信息"
    );
}
这里最重要的变化,不是 Java Record,也不是 generateOutputSchema。
而是我们开始用下一轮模型决策需要什么来设计返回值。
这和传统 API 设计相比,多了一层认知:
接口不仅要返回业务事实,还要让概率模型尽可能无歧义地理解这些事实。
4、错误必须能被模型理解
传统方法抛异常时,调用方通常只有两个选择:
捕获
继续向上抛
但 Agent 收到错误后,需要做决策:
换一个参数?
重新调用?
调用另一个工具?
停止并告诉用户?
转人工?
如果工具只返回:
Internal Server Error
模型根本不知道下一步应该做什么。
可以把可预期的业务失败结构化:
public record ToolError(
    String errorCode,
    String message,
    boolean retryable,
    String suggestedAction
) {
}
例如订单不存在:
{
  "errorCode": "ORDER_NOT_FOUND",
  "message": "没有找到订单 ORD-9999",
  "retryable": false,
  "suggestedAction": "请用户确认订单号,不要使用相同参数重试"
}
物流系统暂时超时:
{
  "errorCode": "LOGISTICS_TIMEOUT",
  "message": "物流服务暂时没有响应",
  "retryable": true,
  "suggestedAction": "最多重试一次,仍失败则稍后再试"
}
两个错误都叫失败,但 Agent 的处理策略完全不同。
因此,Agent 系统里的异常设计不能只服务于日志和监控,还要服务于模型决策。
可以把它概括成一句话:
成功结果是 Observation,失败结果同样是 Observation。错误如果不可理解,Agent 就只能盲目重试或直接放弃。
5、查询和写操作不能放在同一个风险等级
现在,Agent 已经可以完成:
用户问题
   ↓
get_order
   ↓
发现订单已发货并拿到 trackingNo
   ↓
get_logistics
   ↓
生成最终回答
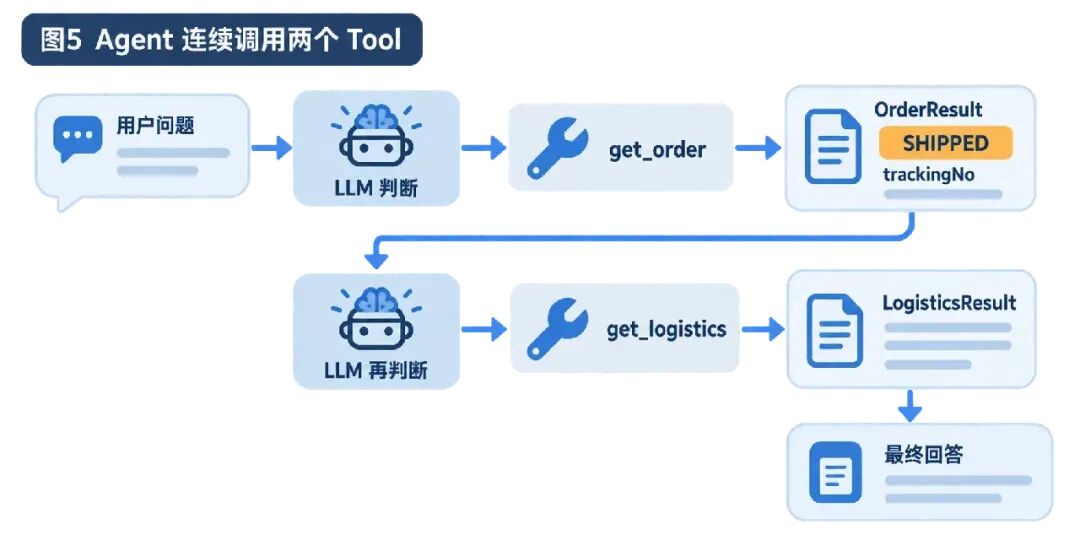
这条链路全部是只读操作。
如果下一步加入:
cancel_order
refund_order
modify_address
系统风险会立刻改变。
很多 Demo 会直接写成:
@McpTool(description = "根据订单号发起退款")
public RefundResult refundOrder(String orderNo) {
    return refundService.refund(orderNo);
}
这段代码在演示里很酷,在生产里却非常危险。
因为模型一次错误选择,就可能变成真实业务状态的改变。
更合理的设计不是让 Agent 一步执行,而是拆成状态机:
propose_refund
    ↓
返回退款金额、原因、风险和确认摘要
    ↓
用户明确确认 / 人工审批
    ↓
execute_refund
    ↓
幂等校验 + 权限校验 + 审计
对应代码边界至少包括:
身份认证:是谁在发起
权限校验:是否有权操作这笔订单
业务校验:订单当前是否允许退款
幂等控制:重复调用不能重复退款
人工确认:高风险动作不能只靠模型决定
操作审计:谁在什么时间通过什么 Agent 做了什么
Tool Annotation 里的:
readOnlyHint
destructiveHint
idempotentHint
openWorldHint
可以帮助客户端理解风险,但它们仍然只是提示。
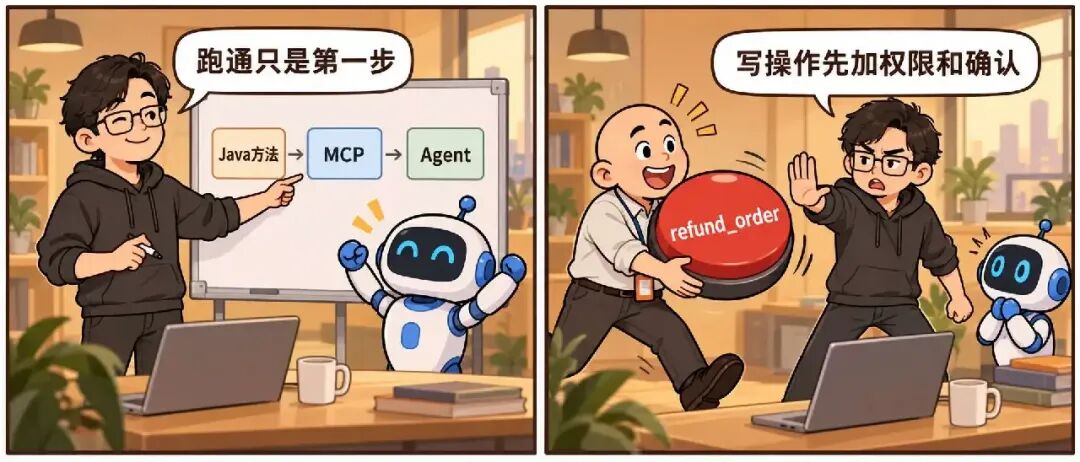
真正的安全边界必须落在服务端代码里。
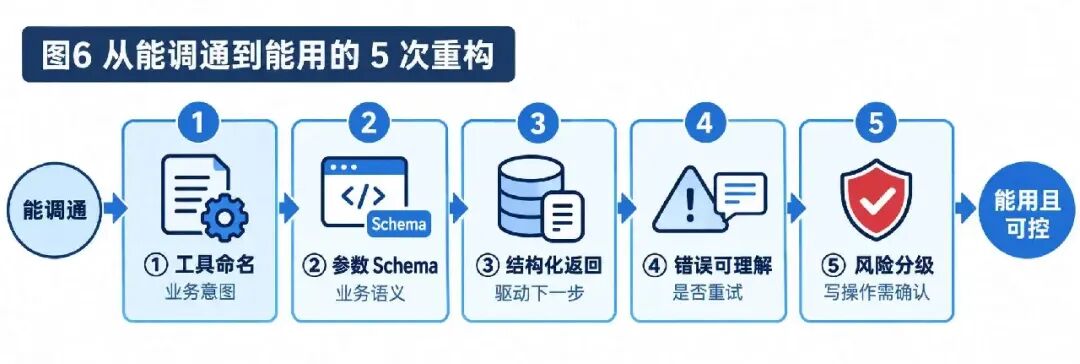
6、完整架构:MCP Server 不是业务系统的代理
完成这五次重构后,整体架构是这样的:
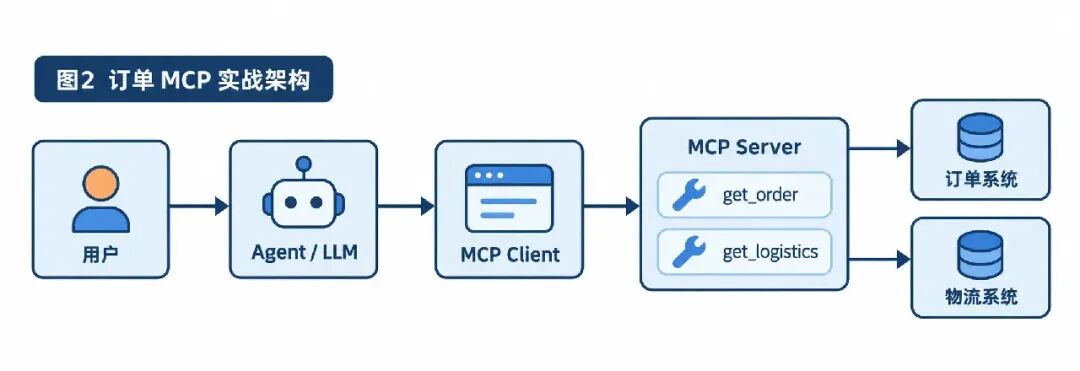
表面上看,MCP Server 只是夹在 Agent 和订单系统中间的一层。
但它不应该只是把原有 API 原样转发出去。
它至少承担五个职责:
1. 把业务能力组织成模型可识别的 Tool
2. 把自然语言参数约束成业务输入
3. 把内部返回值转换成模型可理解的结果
4. 把失败转换成模型可以继续判断的 Observation
5. 在模型和真实业务之间守住权限与风险边界
所以,企业里的 MCP Server 更像一层:
面向 Agent 的业务能力适配层。
这层如果只做协议转换,价值非常有限。
真正的价值来自它把原本只有内部程序员看得懂的能力,重新包装成模型能够发现、理解、调用,并且不容易闯祸的能力。
写到这里,还要回到第三篇的规模判据。
如果只有一个 Agent,而且工具就在同一个 Java 应用里:
一个应用
三个内部方法
没有跨语言复用
没有独立部署需求
直接使用本地 @Tool 往往更简单。
不要为了 MCP 而 MCP。
MCP 更适合:
同一项能力需要被多个 Agent 使用
Java、Python、桌面客户端都要接入
能力需要独立部署和升级
需要统一鉴权、审计和治理
工具提供方与 Agent 团队不在同一发布周期
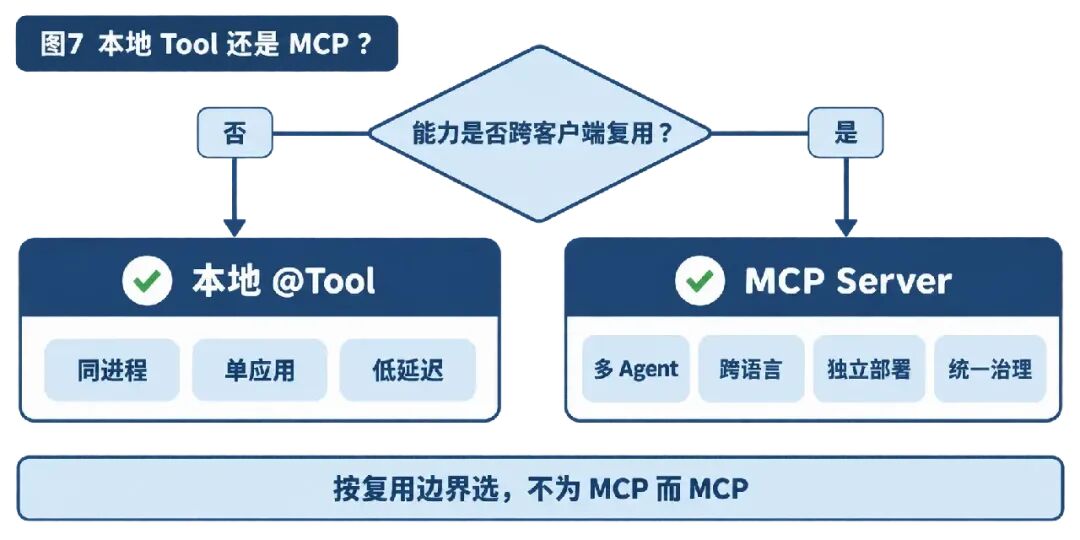
判断标准仍然不是:
MCP 火不火?
而是:
这项能力是否真的跨越了复用边界、部署边界和团队边界?
跨了,协议层有价值;没跨,本地调用通常更划算。
8、一个能跑的 Demo 离生产还差哪些验证?
如果只测试这一句话:
帮我查订单 ORD-1001,如果发货了就查物流。
然后成功返回,我们最多只能证明快乐路径跑通。
真正上线前,至少要准备下面这些回放用例:
| 场景 |
期望行为 |
| 正常订单且已发货 |
先查订单,再查物流 |
| 正常订单但未发货 |
只查订单,不调用物流 |
| 订单号格式错误 |
不调用下游,提示正确格式 |
| 订单不存在 |
不盲目重试,请用户确认 |
| 物流服务超时 |
按策略重试一次,然后降级 |
| 用户查询他人订单 |
服务端权限校验拒绝 |
| 用户诱导 Agent 退款 |
不得通过查询工具执行写操作 |
| 相同写请求重复提交 |
幂等键阻止重复执行 |
除了最终答案,还要记录完整调用链:
模型看到了哪些 Tool
最终选择了哪个 Tool
生成了什么参数
MCP 调用耗时多少
业务系统返回了什么
模型是否发生重试
为什么继续或停止
否则当 Agent 回答错误时,你只知道结果错了,却无法判断:
接入坏了
工具选错了
参数填错了
编排顺序错了
下游超时了
还是模型误解了结果
这正是上一篇「接入、选型、编排、稳定四个正交问题」的实际落地。
写在最后
做完这个订单案例后,我对 MCP 实战最大的感受,不是 Spring AI 的注解很方便。而是:
当 API 的调用方从确定性程序变成概率模型,我们需要重新设计工具的名称、语义、参数、结果、错误和风险边界。
MCP 把连接标准化了。
但连接成功之后,真正决定 Agent 能不能稳定干活的,是另一门正在形成的工程能力:
Agent-facing API Design
面向 Agent 的接口设计
它和传统 API 设计有共同部分:
清晰的职责
稳定的契约
参数校验
权限控制
幂等与审计
但它也增加了模型时代独有的问题:
工具能否被正确检索
描述能否减少语义歧义
Schema 能否帮助模型生成参数
返回值能否驱动下一轮决策
错误能否成为可理解的 Observation
高风险动作是否能阻止模型直接执行
所以,把一个接口做成 MCP Tool,绝不是加一个注解那么简单。
注解解决的是「暴露出去」。
架构设计解决的是:
暴露出去以后,模型能不能用对,以及用错了系统能不能兜住。
这才是 MCP 从 Demo 走向生产真正的分水岭。
参考资料
 发表于 1 小时前
|
查看: 5|
回复: 0


