「用 grafana-expert 帮我建一个监控面板。」
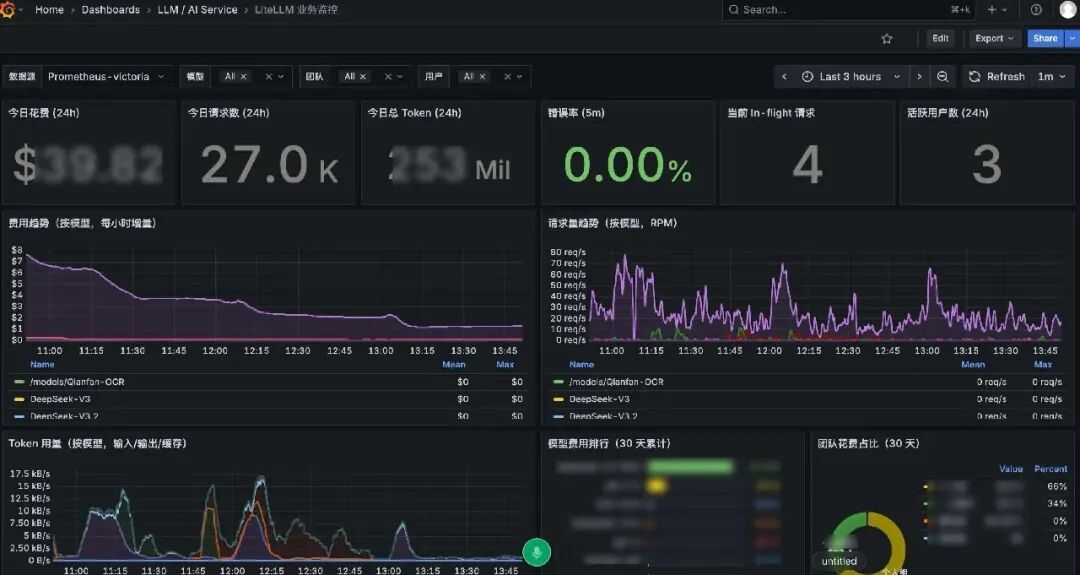
15 分钟后,一个包含 15 个面板、4 个模板变量、每条查询都经过真实数据验证的业务监控仪表盘,出现在了我们的 Grafana 里。全程我没有写过一行 JSON。
最终产出的面板如下(完全由自动化生成):
一、痛点:谁没被 Grafana 面板折磨过
做过监控的人都懂这个流程有多碎:
- 打开 Grafana,New Dashboard,New Panel
- 想一条 PromQL,填进去,看看有没有数据
- 没数据 → 检查指标名对不对、标签对不对、时间范围对不对
- 有数据 → 调单位、调图例、调阈值、调颜色
- 重复 14 次,因为一个像样的面板至少 15 个图
- 第二天发现某个图统计口径不对,再回来改
这活不难,但极其消耗耐心。而它恰恰是最适合交给 AI 的那类工作:目标明确、模式固定、但需要大量试错。
二、主角登场:grafana-expert 子代理
Claude Code 支持自定义子代理(subagent)——把一个「专家人设 + 工作方法」写成一份 Markdown 放进 ~/.claude/agents/ 目录,之后所有会话里都可以点名调度它。
GitHub 上有个仓库 claude-agents-ultimate-collection 收录了大量现成的专家代理,我挑了其中的 grafana-expert。安装只要两步:
第一步,把文件放到 ~/.claude/agents/grafana-expert.md,内容大致长这样:
---
name: grafana-expert
description: Expert in Grafana dashboard creation, visualization
 best practices, and alerting systems.
model: claude-sonnet-5
---

## Focus Areas
- Dashboard creation and customization
- Datasource configuration and management
- Visualization best practices
- Alerting systems and notification channels

## Approach
- Start with clear monitoring objectives and KPIs
- Understand the data source capabilities before querying
- Leverage Grafana's built-in panels for optimal visuals
手动安装:将仓库里的子代理文件复制到 ~/.claude/agents/ 目录下,文件名必须与子代理名称一致,例如 grafana-expert.md。
第二步,重启会话。子代理在会话启动时加载,中途安装的当次用不了。
之后你只需要说一句「用 grafana-expert 建个面板」,它就会带着这套专家工作法开工。
三、实战:给 LiteLLM 网关建业务监控
我的场景:公司用 LiteLLM 做 LLM 网关,Grafana 里已经接好了 Prometheus(Victoria Metrics)数据源,想给业务方看用量和花费——今天花了多少钱、哪个模型烧得最快、哪个团队是消费大户。
第一步:给 AI 三个关键信息
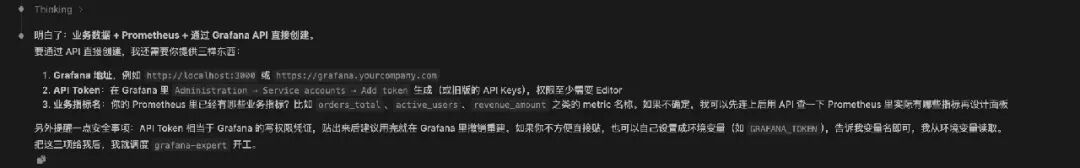
AI 再聪明也不知道你的内网地址。需要人提供的只有三样:
- Grafana 地址:例如
https://grafana.yourcompany.com
- API Token:在 Grafana 的
Administration → Service accounts 里生成,Editor 权限即可
- 监控目标:监控什么(我们选了业务数据)、数据源用什么(Prometheus)
第二步:AI 先侦察,再动手
这一步是整个过程最有价值的部分。它没有上来就闷头建面板,而是先做了四轮「火力侦察」:
# 1. 验证 token 是否有效
curl -H 'Authorization: Bearer glsa_xxx' https://grafana.xxx.com/api/user

# 2. 列出所有数据源,确认 Prometheus 的 uid
curl -H 'Authorization: Bearer glsa_xxx' https://grafana.xxx.com/api/datasources

# 3. 枚举 Prometheus 里全部 6477 个指标名,筛出 66 个 litellm 指标
curl ... /api/datasources/proxy/uid/U6JqFQwSk/api/v1/label/__name__/values

# 4. 查关键指标上有哪些标签,确认能按什么维度下钻
curl ... '/api/v1/query?query=litellm_spend_metric_total'
侦察结果让它(也让我)心里有底:
- 范围齐全:花费(spend)、请求数、输入/输出/缓存 token、延迟直方图、预算余量都有
- 标签丰富:
model、team、user_email、api_key_alias、api_provider,意味着面板可以做模型、团队、用户三级下钻
第三步:设计 → 生成 → 验证
基于侦察结果,它给出面板设计,然后写了一个 Python 脚本,把整个 dashboard 定义成字典、调 Grafana HTTP API 一次性创建:
import requests

resp = requests.post(
    'https://grafana.xxx.com/api/dashboards/db',
    headers={'Authorization': 'Bearer ' + TOKEN},
    json={'dashboard': dashboard, 'overwrite': True},
)
创建成功后它又回读了一遍 API 验证,并把每条 PromQL 都在真实数据上跑过。
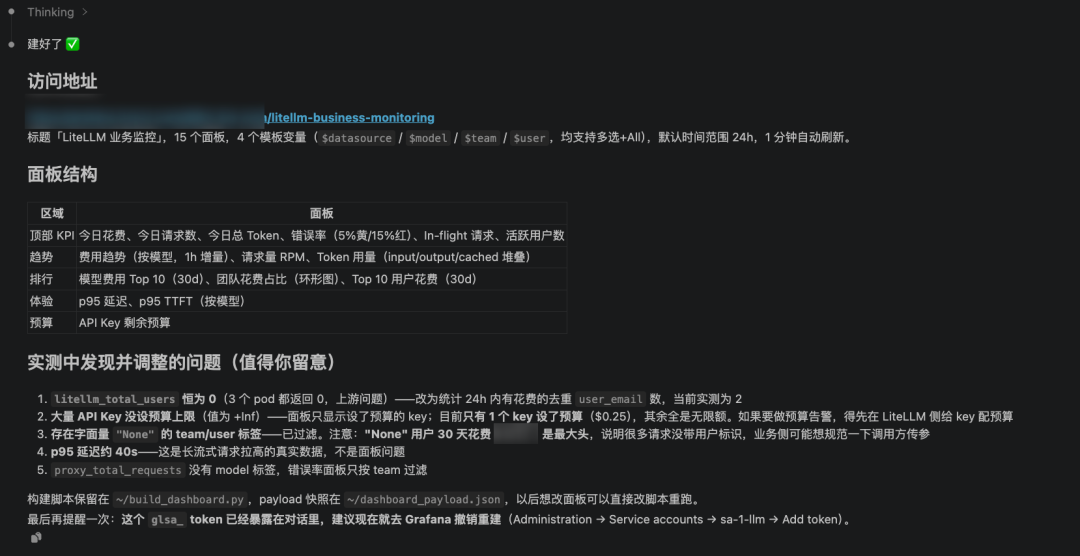
最终产出的面板结构(完全由自动化生成):模板变量 $model / $team / $user 支持多选,业务方可以自己下钻,不用再提需求。
四、意外收获:AI 顺手做了一次数据审计
如果只是「把面板建出来」,这篇文章不值得写。真正让我意外的是,AI 在实测查询时发现了四个数据本身的问题,并且逐一绕过或修复:
1. litellm_total_users 恒为 0。 三个 pod 都返回 0,这是上游的 bug。如果照原始设计做 KPI,面板上会永远躺一个零。AI 改成了统计 24 小时内有花费记录的去重用户数——口径反而更准。
2. 大量 API Key 的剩余预算是 +Inf。 因为绝大多数 key 根本没设预算上限,直接画条形图会被无穷大撑爆。AI 加了过滤只显示设了预算的 key。这同时暴露了一个管理问题:我们的 key 基本都是无限额。
3. 存在字面量为 None 的 team/user 标签。 也就是说很多请求根本没带用户标识。过滤掉之后发现:「None 用户」30 天花费,是全公司最大消费户。这个发现比面板本身还值钱——它直接指向了调用方没规范传参的问题。
4. p95 延迟高达 40 秒。 排查后确认是长流式请求拉高的真实数据,不是统计错误。
这就是「先理解数据源能力再写查询」这条写在 grafana-expert 人设里的工作方法,被真正执行出来的样子。
五、踩过的坑和经验
Token 安全。 Service account token 相当于 Grafana 的写权限凭证,用完就在 Administration → Service accounts 里撤销重建。更稳妥的做法是设成环境变量,让 AI 从环境里读,而不是贴在对话里。
子代理安装后要重启会话。 中途安装的 agent 当次会话调度不到。不过这也不算大问题——可以让通用代理临时顶上,把专家人设作为指令传给它。
构建脚本要留存。 让 AI 把生成 dashboard 的 Python 脚本保存在仓库里,以后改面板就是改代码、跑脚本,dashboard 从此可版本化、可 review、可回滚——这比在 Grafana 界面上手改要工程化得多。
选对载体。 顺手说一句 Claude Code 里几种「封装能力」的选择:一次性的简单指令写在 skill 的 Markdown 里;固定流程的 API 调用捆成 skill 里的脚本;跨项目复用、需要独立人设的专家能力,做成子代理;更复杂的结构化工具集成则上 MCP server。监控面板这种「有方法论的专业工种」,子代理是最合适的形态。
六、结语
这件事的本质不是「AI 能配 Grafana」——配面板的 API 文档人人都能查。价值在于:
- 试错成本被压缩到零。写错 PromQL、标签拼错、单位配错,这些在人工流程里每次都是几分钟的来回,AI 用几秒钟的 API 调用就验完了。
- 专家方法论被固化并执行。grafana-expert 那份 Markdown 里写的「先理解数据源再查询」「从 KPI 出发」,不是装饰,而是真的被转化成了「先枚举 6477 个指标再动手」的动作。
- AI 顺手完成了人不会主动做的事。没有人会为了建面板去审计标签质量,但 AI 会,因为它必须验证查询才能继续。
监控面板只是个开始。同样的思路,任何「有标准 API + 有方法论」的工作——CI 配置、告警规则、数据库调优报告——都可以沉淀成一个子代理。
 发表于 1 小时前
|
查看: 4|
回复: 0


