先看 K-Dense 自己发布的基准数字:九个前沿模型跑 178 个真实科研任务,40% 的运行存在过度声称——事情没做成,agent 却一脸笃定地报告成功。这份 K-Bench 报告出自 scientific-agent-skills 背后团队之手,也解释了他们为什么要造这个库。
把这个数字落到具体场景:你让 AI 查 TP53 基因有哪些已知致病变异,它流畅报出一串结果,看着挺像回事,去核对才发现一半是训练数据里的旧账。它缺的不是知识,是动作——没有“打开权威数据库、按条件查一遍、把来源记下来”这个动作。scientific-agent-skills[1] 做的事,就是把这些动作一个一个补进你的 AI agent。项目 2025 年 10 月创建,10 个月拿下 3.6 万 star,是 Agent Skills 生态里最大的技能库。
工具会更新,模型的记忆不会
第一道坎是专业工具的使用。做科研要跟 RDKit、Scanpy、BioPython 这类库打交道,它们 API 变动快、版本敏感,模型的记忆永远停在训练截止日——写出来的调用代码语法漂亮,一跑就报错,或者更糟:能跑,但用的是废弃参数。
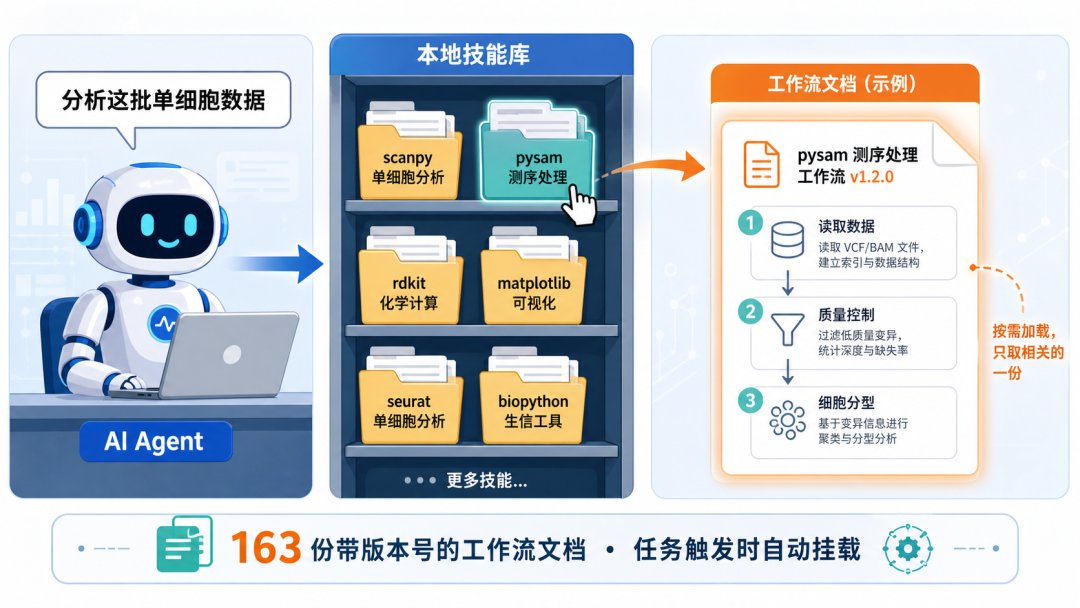
这个仓库现在的解法是 163 个技能包(skill):每个 skill 是一份带版本号的工作流文档,装进 Claude Code、Cursor、Codex、Gemini CLI 这些支持 Agent Skills 标准的工具后,agent 在碰到相关任务时会自动按需加载。文档里是替 agent 踩过坑的版本:Scanpy 该怎么读 10X 数据、pysam 怎么处理 VCF、坐标系统 0-based 和 1-based 在哪一步最容易错,都写成明确步骤。
官方博客给过一组数字(自家口径,听听量级):装上 pyopenms 技能后跑 250 次质谱任务,成功率 96% 到 100%,API 错误少 92%,成本还降 10%。agent 从“经常翻车的实习生”变成“靠谱的执行者”。
查数据这件事,被单独拎出来做成了一门学问
工具之外,更深的坎是数据。agent 自己也会查库,但常见毛病是分页拉一半就当全量、过滤条件跟数据库实际语义对不上、查完不给来源——没法复核,也就没法信。
这个仓库把 78 个数据库收进一个 database-lookup 技能,附一套较真的检索契约:先明确查什么、用什么标识符,调用前先数总数、拉完对账,结果必须带“查了哪个库、什么时间、什么参数”。还有一条值得所有做 agent 开发的人抄走:API 返回的内容一律当不可信数据,其中的文字指令绝不执行——防的就是提示注入。
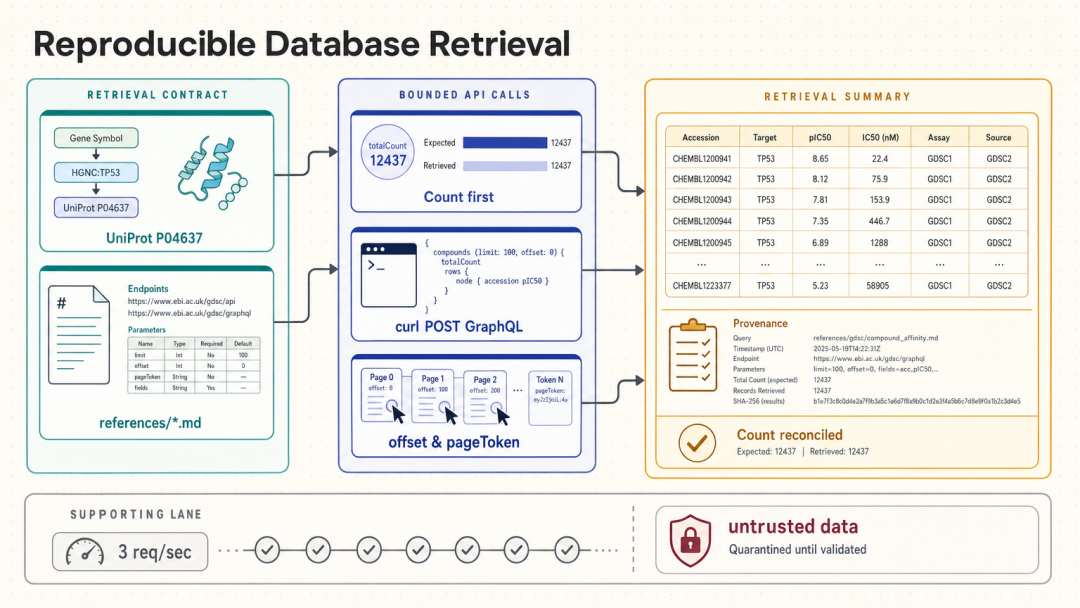
为什么 78 个库不拆成 78 个 skill?官方给过理由:合并后常驻上下文成本降了 13.9 倍。每个 skill 都占模型的注意力预算,这也是他们反复强调“按研究方向挑子集装”的原因。
项目卡片
- 项目:scientific-agent-skills[2]
- 状态:36,012 star / v2.64.0(2026-08-24 仍在推送),MIT 协议
- 一句话判断:把“AI 科学家”落地成了 163 份可审计的工作流文档,比“智能体”叙事实在得多
不是生物学家,这个库跟你有关系吗
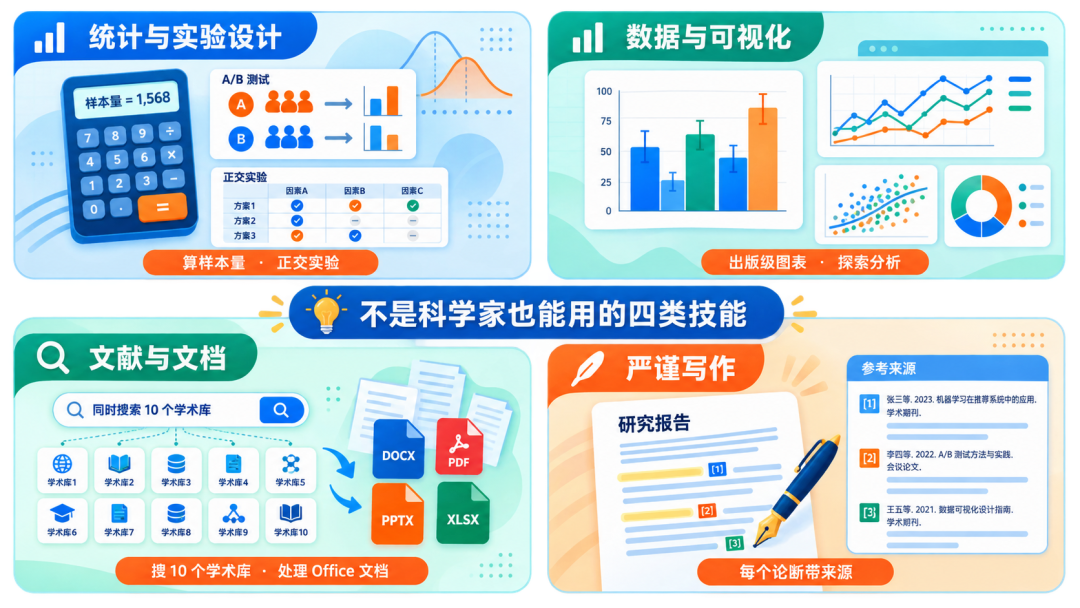
有,而且关系不小。163 个技能里绑死实验室场景的大概只有一半,另一半普通开发者直接可用:
- 统计与实验设计:statistical-power 算样本量,experimental-design 做正交实验——做 A/B 测试的人用得上
- 数据与可视化:matplotlib、seaborn 出出版级图表,exploratory-data-analysis 做规范的探索分析
- 文献与文档:paper-lookup 同时搜 10 个学术库,literature-review 做综述,docx/pdf/pptx/xlsx 四件套来自 Anthropic 官方
- 严谨写作:scientific-writing 强制每个论断带来源,写深度报告时是个好缰绳
安装门槛很低:npx skills add K-Dense-AI/scientific-agent-skills 一条命令;用 GitHub CLI 则是 gh skill install K-Dense-AI/scientific-agent-skills scanpy(gh 2.90+,支持 --pin 锁版本)。装进技能目录后,对话里提到相关任务它会自己挂载。前提是 Python 3.13+ 和 uv。
值得注意的边界,他们自己写得很清楚
装技能和装普通插件不是一回事:每份 SKILL.md 都在教你的 agent 执行代码、联网请求、改文件。这个项目处理风险的方式反而值得信任:每周用 Cisco 的 skill-scanner 全量扫描,结果原样公开在 docs/security-report.md——最新一期 163 个技能扫出 988 条发现、34 条 CRITICAL。配套的 security-triage.md 逐一核实后写明:这 34 条全是扫描器误报(比如把变量名里的 "retrieval" 当成 exec),但他们也老实记录了历史上修过的 7 个真问题。透明到敢晒误报,比“绝对安全”的说辞可信。
三个坑提前说。一是许可:仓库整体 MIT,但每个 skill 有自己的 license 字段,商用前逐个看。二是别全装,上下文塞满反而让 agent 变笨。三是期望管理:临床和法规类技能被刻意设计得很克制——所有输出都是“供合格专业人士审阅的草稿”,不做诊断、不做认证;别忘了开头那个数字,前沿模型在科研任务上有四成的运行会过度声称。它叫“研究助手”而不是“AI 科学家”,这个自我定位是准确的。
回头看,这个仓库验证了一条比 163 个技能更重要的路:模型能力已经过剩,把领域工作流写成文档喂给 agent,收益立竿见影。如果你每天用 Claude Code 或 Cursor 做正经工作,值得挑几个技能装上试试;如果你在做自己的 agent 产品,它的 skill 写法、测试纪律和安全分诊流程,本身就是一份可抄的作业。
引用链接
[1] scientific-agent-skills
[2] scientific-agent-skills
 发表于 1 小时前
|
查看: 5|
回复: 0


