AI 编程助手在改动大型项目时有个老毛病:回答问题之前得先读文件。十几个文件挨个读下来,token 烧掉不少,文件之间的调用关系还是经常漏掉。它手里只有 grep 和关键词匹配,你的项目整体长什么样,它其实并不知道。
Graphify 想解决的就是这个问题。它会把代码、文档、PDF 这些内容整个扫一遍,生成一张知识图谱,之后 AI 助手要回答问题,先查这张图就行,文件不用重新翻了。
这个项目今年 4 月才放出来,现在 GitHub 上已经 12 万 Star 了。
先简单介绍下
Graphify 本身不是一个独立软件,而是给 AI 编程助手装的一个技能。装好之后,在助手里敲 /graphify,它就开始扫描当前项目,扫完给你一张知识图谱。这张图是实实在在的文件,能查,能遍历。另外得说清楚,它跟向量数据库不是一路东西。向量检索返回的是"长得像"的内容,这张图给的是具体的关系。
功能拆解
一条命令建图,产出三个文件
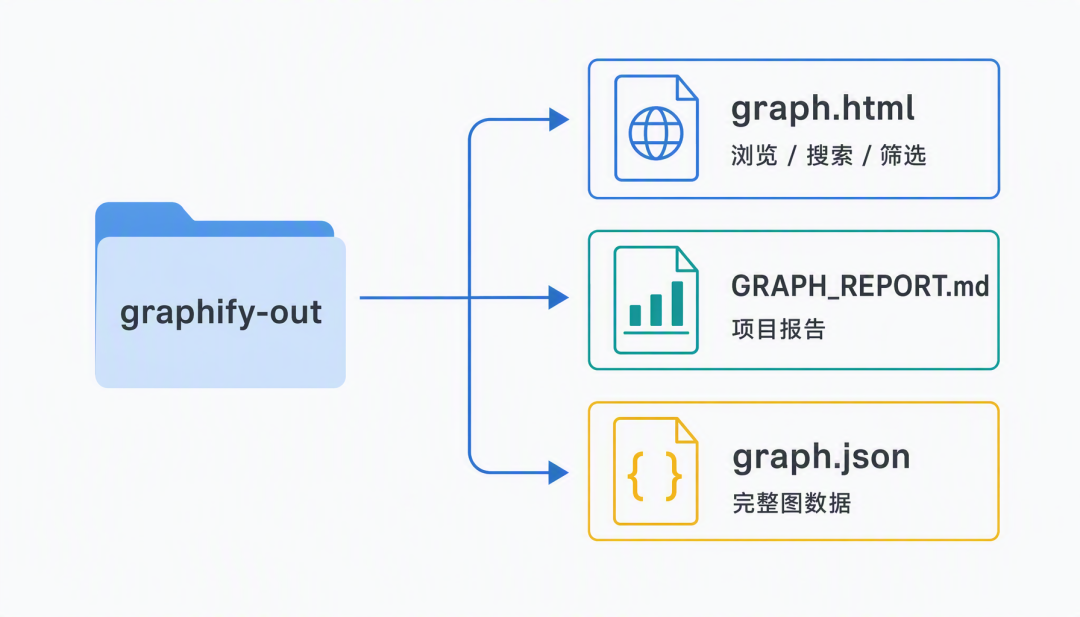
在助手里敲 /graphify .,等它跑完,项目里会多出一个 graphify-out 目录,里面就三个文件。
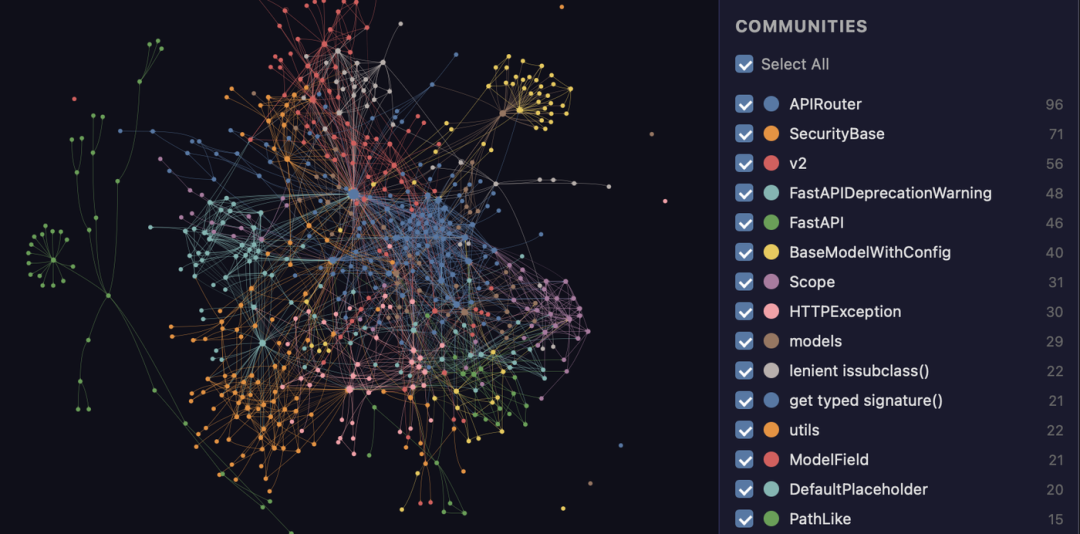
下面这张图是它拿 FastAPI 的代码库跑出来的。每个节点是一个概念,颜色一样的是同一个子系统,全是自动分出来的:
代码解析完全本地化,不烧 API 额度
这一点我认为是最划算的。代码文件全部走 tree-sitter 语法树解析,支持 40 种上下的语言,整个过程不碰大模型,代码也不出本机。也就是说,光建代码这部分的图,一分钱 API 费用都不用花。
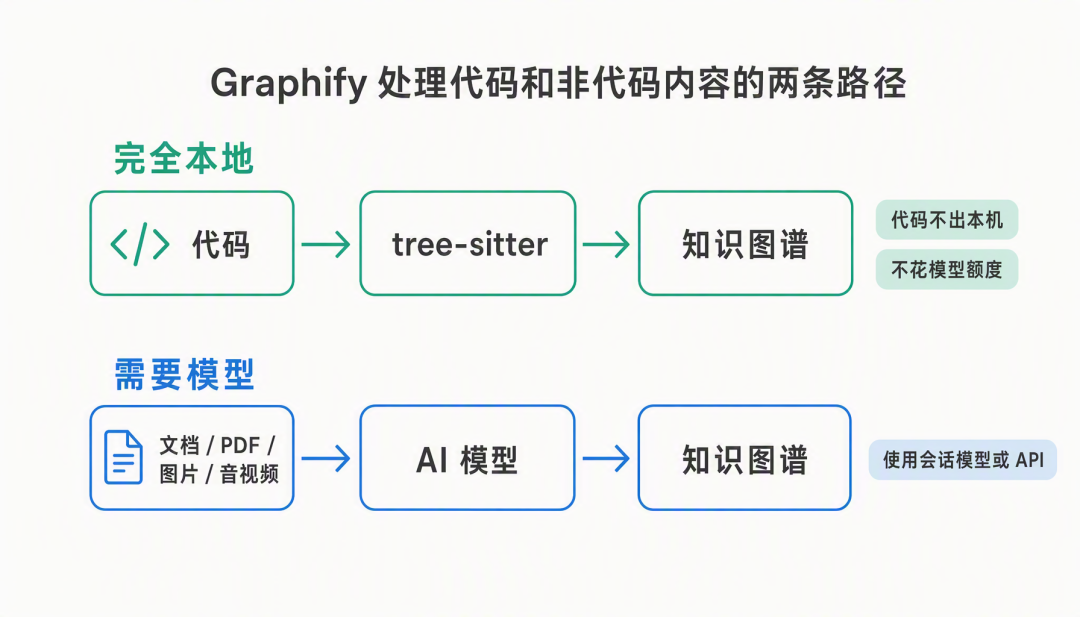
需要模型参与的只有文档、PDF、图片、音视频这些非代码内容,用的是你 AI 助手自己会话的模型,或者你自己配的 API key。
每条关系边都带来源标签
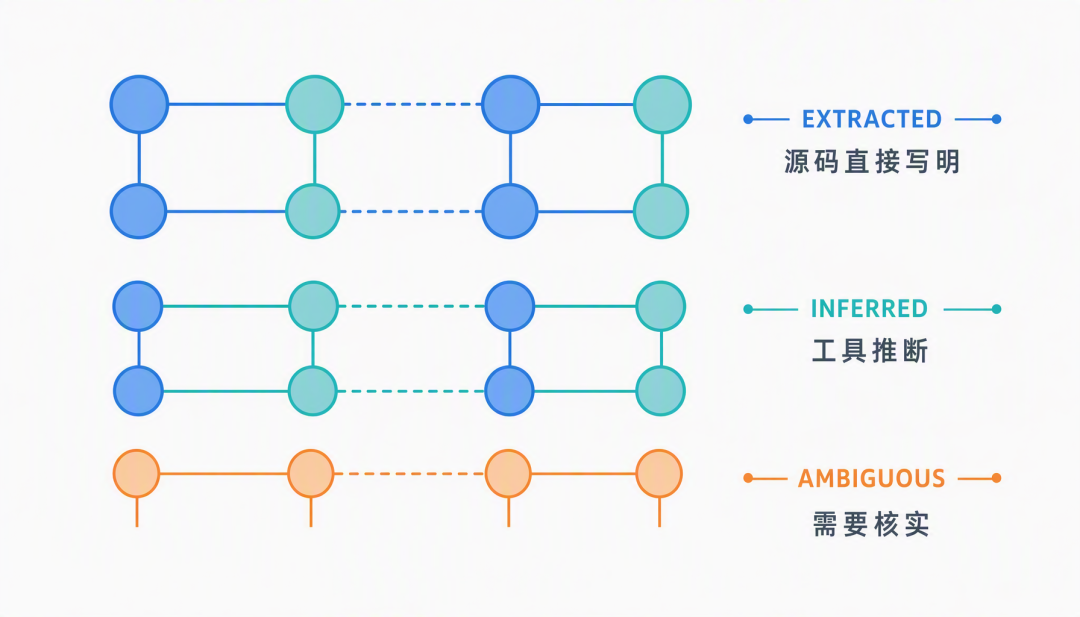
图里的每条关系边都挂着标签。EXTRACTED 的意思是源码里直接写了这个关系,INFERRED 的意思是工具自己推出来的。真拿去查问题的时候,哪些关系是代码里实打实存在的,哪些还得再核实一遍,扫一眼就清楚了。报告里还有一类 AMBIGUOUS,工具自己都拿不准的边,也会单独标出来。
查询在图上真实遍历
图建好以后,查东西主要靠三个命令:
query 接大白话的问题,返回一块相关的子图;path 用来看两个东西中间是怎么连起来的;explain 解释一个概念和它周围一圈的关系。
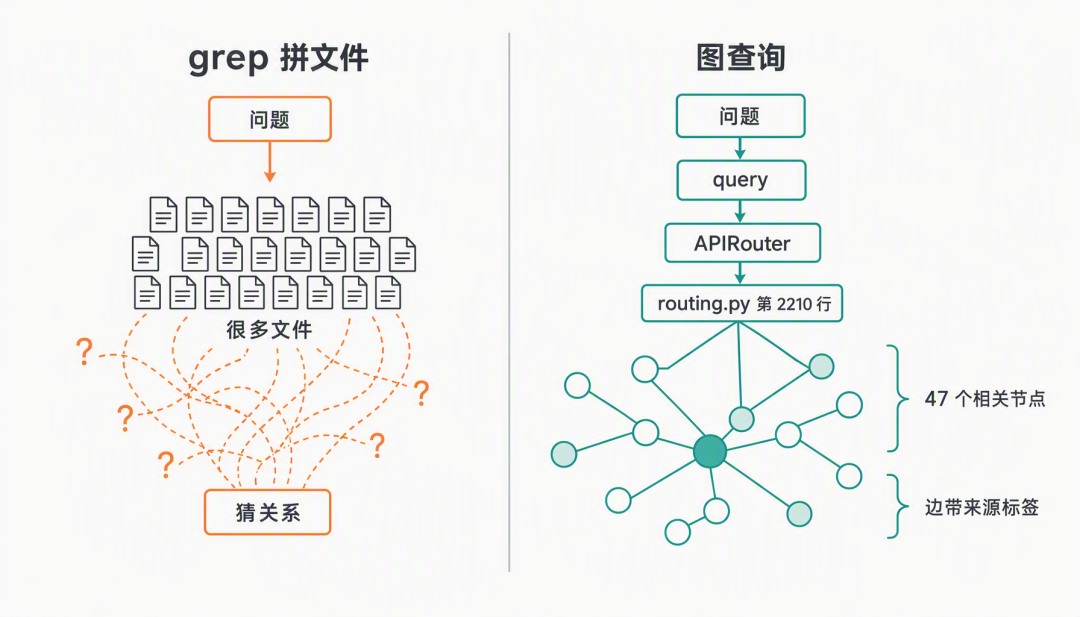
官方文档里举了个例子:拿 FastAPI 的图问 APIRouter,结果里能看到它出自 routing.py 的第 2210 行,连着 47 个节点,每条边都有来源标签。
有了这张图,AI 助手拿到的上下文是顺着真实代码关系查出来的路径。跟以前那种 grep 出一堆文件再让模型自己拼的做法相比,要靠谱得多。
官方还放了基准测试的数据:
LOCOMO 数据集上,它的 recall@10 是 0.497,同场对比的 mem0 是 0.048,supermemory 是 0.149。QA 准确率这项它是 45.3%,比 mem0 高,不过比 supermemory 的 49.7% 要低一些。
自动识别核心节点和子系统
建图的时候它还会顺手做两件事。
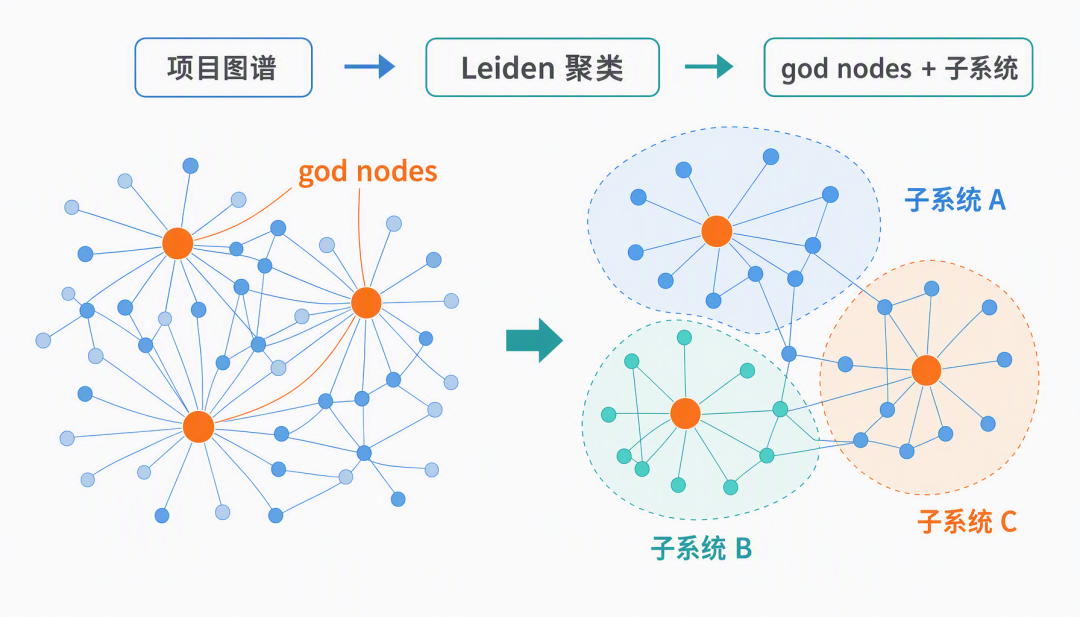
一件是找 god nodes,也就是连接数最多的那批概念。整个项目干什么基本都绕不开它们,新人接手项目先把这份名单过一遍,大概就知道重点在哪了。
另一件是拿 Leiden 算法把图切成一个个子系统,每个子系统会自动起好名字。在 graph.html 里可以按子系统一块一块地看。
非代码内容也进同一张图
除了代码,Markdown、PDF、图片、视频音频、SQL 表结构、Terraform 配置这些都能进图。Word、Excel 和视频要单独装对应的扩展包。
有一点我挺喜欢的:代码里 NOTE、WHY 开头的注释,还有架构决策记录,会被抽出来做成单独的节点,挂在它解释的那段代码上。这样当时为什么这么写的,和代码本身就在一张图里了,提问的时候两边能一起查到。
图谱随代码增量更新
图不是建一次就丢在那了。改过的文件可以增量更新,不用全量重跑。装一个 git hook 之后,每次 commit、切分支,它都会自己重建图。图文件可以直接提交进仓库,团队里其他人 clone 下来就有图用。
想给别的工具接的话,图能做成 MCP 服务,也能起个 HTTP 服务,整个团队共用一份。它另外还有个 PR 看板,能看到每个 PR 动了图里的哪些区域,哪些 PR 撞在同一个子系统上、合并顺序要小心,review 排期的时候有点用。
快速开始
就两条命令,环境里有个 Python 3.10 以上就行:
uv tool install graphifyy
graphify install
第一条把命令行工具装上,第二条把它注册给你的 AI 助手。装完在助手里敲 /graphify . 就开始跑了。中间想改什么,直接用大白话跟助手说,只看代码、重新聚类、不要可视化页面这些,都有现成的参数。
有几个坑提前说一下。
PyPI 上的包名是 graphifyy,两个 y。其他叫 graphify 什么什么的包都跟官方没关系,不过装完以后命令还是叫 graphify。Windows 上用 PowerShell 的话,要敲 graphify .,不能带斜杠,那个斜杠会被当成路径。
装完如果提示 command not found,多半是工具目录没进 PATH。跑一句 uv tool update-shell,再开个新终端就好了。平时用中文提问比较多的,建议把 graphifyy[chinese] 这个扩展也装上,里面带 jieba 分词。
结尾
最后说下我的想法。什么情况值得装呢?项目体量上去了,新人入职要快速摸清架构,或者团队想把项目结构共享出来,这几种情况它都帮得上忙。社区有篇评测说 500 到 5000 个文件的仓库用起来最值,我感觉这个判断靠谱。项目要是就几十个文件,那就别折腾了,直接让 AI 读文件更快。
还有一点要提前想好:代码以外的内容是要走模型的。项目里 PDF 和文档堆得多的话,建图那一步会花一些 API 额度。代码部分就完全不用操心,本地就跑完了。
总的来说,今年打着知识图谱旗号的工具见得不少,真能把图塞进日常开发流程里的不多,这个算一个。4 月发布到现在热度一直没下来,说明这个项目确实有过人之处。
开源地址
https://github.com/Graphify-Labs/graphify
 发表于 昨天 23:53
|
查看: 3|
回复: 0


