用户关系、商品关联和论文引用都能表示成图,但不同场景下节点属性、标签含义与连接规律差别极大。一张图上学到的经验,往往很难直接搬到另一张图上。换个任务,通常还得重新准备标签、重新训练模型。
研究团队提出 GraphPFN,以表格基础模型 LimiX 为基础,加入沿图边传递信息的适配器,再用 160 万个合成图数据集进行预训练。面对新图时,模型可以读取节点特征、连接关系以及部分节点的已知标签,直接预测其他节点,也可以继续微调。
这项研究围绕一般属性图上的节点分类与回归展开。对知识图谱研究来说,它给出了跨图迁移、实体属性与图结构联合建模的方法参考。论文主实验覆盖 13 个数据集,默认微调设置在其中 11 个上取得最高报告均值。
01 先学会利用样本,再处理一张新图
作者采用先验数据拟合网络,也就是 PFN 的训练方式。这里的“先验”是一套生成训练任务的规则,规定合成数据可能具有哪些结构,以及特征与标签之间可能出现哪些联系。
预训练时,作者反复生成新的图数据集。每次只向模型提供部分节点的标签,让它结合整张图的特征与连接,预测其余节点的标签。经过大量任务训练,模型逐渐学会根据当前图中的已知样本作出判断。
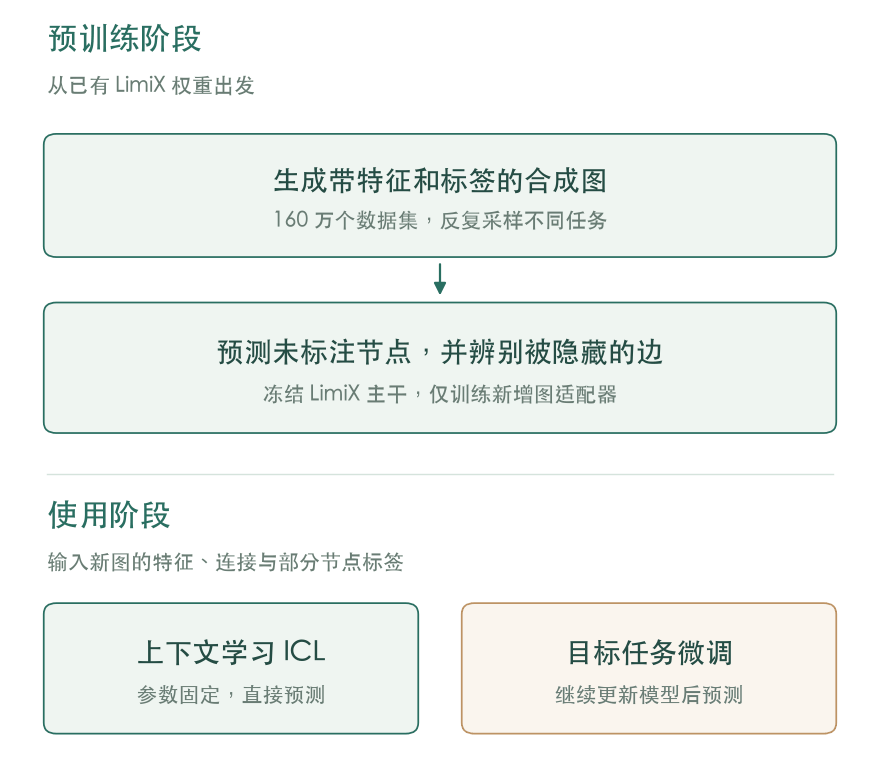
图 1|根据论文第 3、4 节整理。预训练阶段学习图适配器;在新图上,用户可以选择直接进行上下文学习,也可以继续微调。
这种直接读取当前任务样本的方式称为上下文学习,简称 ICL。模型参数保持固定,已标注节点充当当前任务的参考。它仍然需要这些标签,只是省去了针对新图更新参数的过程。
微调则继续用目标图上的训练标签更新模型。GraphPFN 的默认微调设置会同时更新 LimiX 主干与图适配器,因此需要更多计算时间。
表 1|三类图学习方法的处理方式
| 方法 |
图结构如何进入模型 |
新任务上的使用方式 |
| 常规图神经网络 |
沿图边聚合邻居信息 |
通常为当前任务训练模型 |
| G2T-FM 等图转表格方法 |
预先计算图相关特征,再交给表格基础模型 |
可进行上下文学习或微调 |
| GraphPFN |
在基础模型内部加入图消息传递,并开展合成图预训练 |
可直接读取已知标签,也可继续微调 |
表注:根据论文第 2、3 节整理。此处概括的是文中比较的方法路线。
02 合成图同时包含社群与外围节点
合成数据的质量取决于生成规则。真实网络中经常出现联系密集的社群,社群之间又有交叉连接,还散布着大量只有少数邻居的节点。作者据此设计图结构生成器。
作者先用度修正随机块模型生成若干一级图,再生成一个节点总数相同的二级图。两层图的节点经过随机对应后,将两层的边合并。一个节点由此可以同时受到两种社群组织方式影响,形成更复杂的社群形状与重叠联系。
随后,作者继续加入连接较少的新节点。新节点更容易连到已有的高连接度节点,每个新节点的初始连接数也随机变化。这样生成的图既有相对密集的核心,也有稀疏的外围。
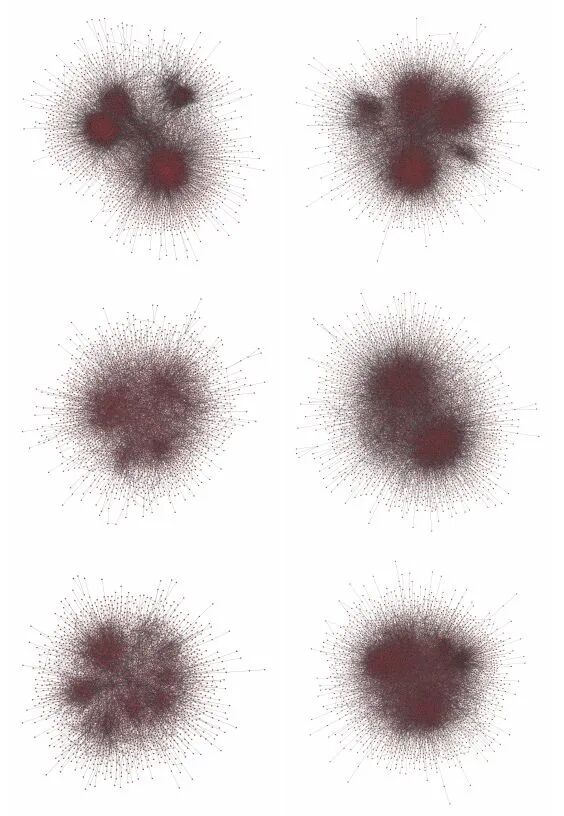
图 2|原论文图 3,PDF 第 17 页。六个示例展示了不同的社群分布与核心、外围结构。
节点属性与预测目标也需要随图结构变化。作者使用随机神经网络形式的结构因果模型生成变量,并在隐藏层中混合普通神经元与图聚合神经元。前者处理节点自身的信息,后者还会读取邻居的信息。
作者为不同数据集随机调整两类神经元的比例,并以一定概率加入节点度与 PageRank。网络完成计算后,作者从中选取部分变量作为节点特征,再选取一个变量作为预测目标,其余变量保留为隐藏因素。这样,特征与标签可以共享部分生成过程,也可以受到邻居信息的不同程度影响。
这里的结构因果模型用于构造合成数据中的变量依赖,论文没有据此推断真实网络中的因果关系。
表 2|合成数据的三个组成部分
| 组成部分 |
作者的处理 |
希望覆盖的变化 |
| 社群结构 |
合并多层随机块模型生成的边 |
社群规模、形状与交叉联系 |
| 外围结构 |
逐步加入低连接度节点 |
核心与外围的连接差异 |
| 属性与标签 |
混合节点自身变换和邻居聚合 |
特征、目标对图结构的依赖程度 |
表注:根据论文第 4 节整理。生成参数在不同合成数据集之间变化。
03 在表格模型内部加入图消息传递
LimiX 已经具备处理不同表格特征和标签的能力。作者在这个基础上增加图适配器,让模型进一步利用节点之间的连接。
LimiX 将一个节点的特征拆成多个输入单元。具体实现中,每两个特征组成一个单元,便于控制计算量。不同数据集的特征数量可以变化,模型无需为每一种特征维度重新设计输入层。
GraphPFN 内部有三种信息交换方式。
特征级注意力在同一个节点内部运行,让该节点的不同特征相互作用。样本级注意力跨节点运行,使模型利用已标注节点提供的任务信息。图消息传递注意力沿真实存在的边运行,让相邻节点交换信息。
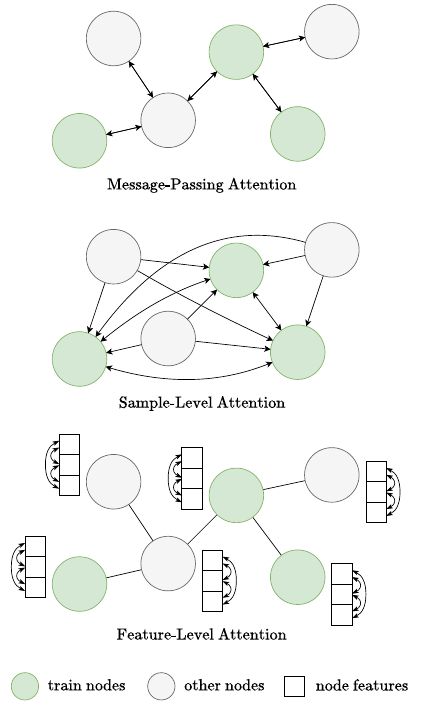
图 3|原论文图 1(a),PDF 第 4 页。自上而下依次为图消息传递、样本级注意力和特征级注意力,绿色表示提供标签的训练节点。
作者在每个 LimiX 模块末尾加入图适配器。它保留原有的特征表示方式,对各个特征单元分别执行邻居聚合,并使用同一张图的连接关系限制信息传递范围。每层适配器只读取直接相连的邻居,多层叠加后,信息可以沿着连接继续传播。
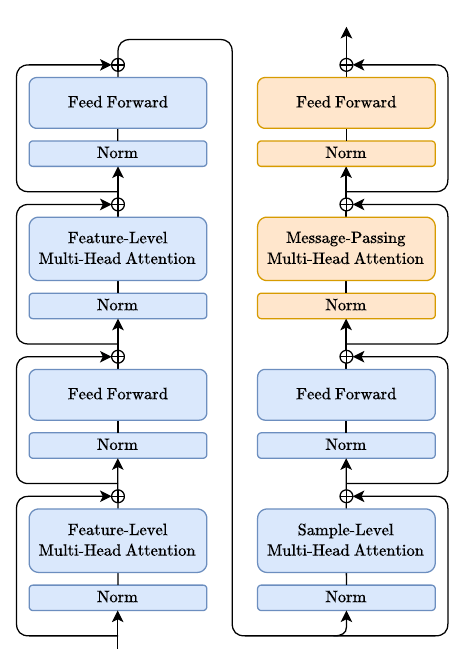
图 4|原论文图 1(b),PDF 第 4 页。蓝色部分来自 LimiX,橙色部分为新增的图消息传递模块及其配套前馈网络。
这里有个细节会直接影响使用方式。样本级注意力遵循 PFN 的约束,待预测节点从已标注节点读取信息;图适配器则按图边传递信息,允许已标注与未标注节点之间双向交换表示。模型处理整张图时会使用未标注节点的特征和连接,但不会读取它们的真实标签。
04 160万个合成任务,训练新增图适配器
作者从已有的 LimiX 权重出发进行预训练,冻结原有主干,仅更新新增的图适配器。这样既保留表格预训练获得的特征处理能力,也让新增模块学习图上的依赖关系。
预训练同时安排两类任务。一类是根据已知标签预测其他节点,分别对应节点分类与回归。另一类是掩码图建模:随机隐藏一部分真实边,再采样同样数量的未连接节点对,让模型辨别哪些节点对原本相连。
表 3|论文中的预训练设置
| 项目 |
设置 |
| 初始化模型 |
已预训练的 LimiX |
| 合成数据集数量 |
160 万个 |
| 参数更新次数 |
10,000 次 |
| 每次更新使用的数据集 |
160 个,通过多卡与梯度累积实现 |
| 训练范围 |
冻结主干,仅更新图适配器 |
| 图结构辅助任务 |
隐藏 10% 的边,并采样等量负例 |
| 辅助损失权重 |
0.1 |
| 硬件与耗时 |
8 张 NVIDIA A100 80GB,约 36 小时 |
表注:根据论文第 3.2 节整理。上述耗时不包含 LimiX 已完成的预训练。
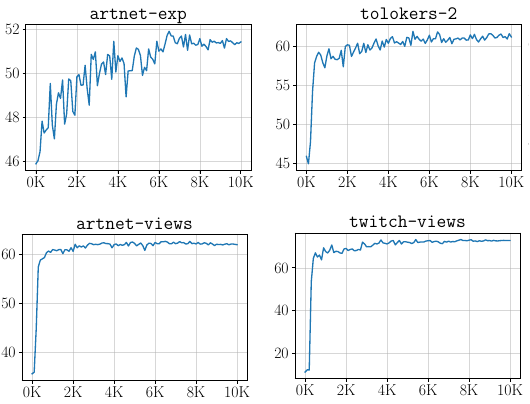
图 5|选取原论文图 2 中 artnet-exp、tolokers-2、artnet-views、twitch-views 四个面板,按两行重排。横轴为预训练步数,纵轴为各任务指标;评估使用随机特征,未做预测集成。
学习曲线显示,前 1,000 至 2,000 次更新已经带来较明显的提升,后续训练继续改善平均表现。作者每隔 100 步记录一次结果,并说明这些测试集评估只用于事后分析,没有用于提前停止训练或选择模型。
掩码图建模在这里提供额外的结构训练信号。论文最终评估的任务仍然是节点预测,当前模型尚不能直接用于知识图谱补全中的链接预测。
05 13个数据集上的结果与例外
作者使用 8 个 GraphLand 数据集与 5 个经典图数据集开展主实验,统一按 10% 训练、10% 验证、80% 测试划分。任务同时覆盖分类与回归,也包含邻居标签相近和不相近的图。主实验图规模约为 1.17 万至 16.81 万个节点,因此,训练节点占比低并不等于只给模型几个标签。
对比方法包括经过充分调参的常规图神经网络、已有图基础模型,以及 G2T-FM、TAG 等使用表格基础模型的方法。作者为常规图神经网络加入残差连接、层归一化和多层感知机模块,增强这些基线的表现。
在不更新目标任务参数的 ICL 设置下,GraphPFN 在两组数据集中的平均排名均优于常规图神经网络和其他 ICL 图基础模型。以 G2T-LimiX 为参照,GraphLand 上的平均排名从 3.88 改善到 3.50,经典数据集上从 5.60 改善到 4.40。这些排名越低越好,且应在各自表格的比较范围内理解。
微调后,GraphPFN 在 8 个 GraphLand 数据集上全部取得最佳结果。下表保留 G2T-LimiX 这一较强对比方法,便于看清增加图适配器与合成图预训练后的表现。
表 4|GraphLand 上的微调结果
| 数据集 |
任务 |
G2T-LimiX |
GraphPFN |
| artnet-exp |
分类 |
50.39 |
53.49 |
| city-reviews |
分类 |
80.65 |
80.90 |
| tolokers-2 |
分类 |
59.75 |
62.80 |
| artnet-views |
回归 |
63.24 |
65.35 |
| avazu-ctr |
回归 |
34.09 |
35.07 |
| city-roads-M |
回归 |
66.29 |
67.30 |
| hm-prices |
回归 |
77.37 |
81.06 |
| twitch-views |
回归 |
74.91 |
79.00 |
表注:重排自原论文表 1,仅列均值。分类指标为平均精确率 AP,回归指标为决定系数 R²,均保留原表乘以 100 后的展示数值,越高越好。两列均为微调设置,默认采用 10 次预测集成。
经典数据集上的结果存在差别。GraphPFN 在 amazon-ratings、facebook 和 wiki-cs 上领先,在 pubmed 和 questions 上低于 G2T-LimiX。因此,论文主实验中的结论是 13 个数据集有 11 个取得最高均值。这些结果反映表中报告的平均表现,不能据此认定每一项差距都具有统计显著性。
表 5|经典数据集上的主表结果
| 数据集 |
G2T-LimiX 微调 |
GraphPFN 微调设置 |
| amazon-ratings |
46.09 |
46.27 |
| facebook |
92.83 |
94.06 |
| pubmed |
90.94 |
90.50* |
| questions |
22.98 |
22.15 |
| wiki-cs |
83.38 |
83.99 |
表注:重排自原论文表 2,仅列均值。questions 使用 AP,其余使用分类准确率,均按原表展示,越高越好。* pubmed 的 GraphPFN 微调遇到显存不足,作者在微调行沿用了 ICL 结果,因此 90.50 并非实际微调所得。
默认评估还有两项设置需要一起看:作者为每次前向计算加入 8 个随机特征,并对 10 次前向预测取平均。ICL 表示无需更新目标任务参数,论文主表中的默认成绩包含这套集成过程。
06 消融实验说明了预训练的作用
作者进一步保留相同的 LimiX 主干和图适配器结构,将适配器换成随机初始化,再按相同流程微调。与已经过合成图预训练的 GraphPFN 相比,多项任务的表现明显下降。
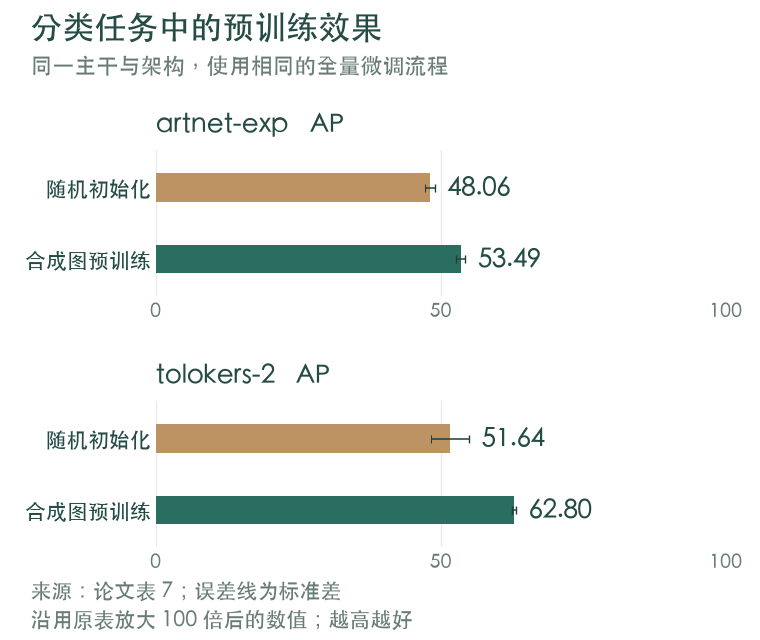
图 6|根据原论文表 7 重绘,选取两个分类数据集。两组使用同一 LimiX 主干与适配器架构,再进行相同的全量微调;差异在于图适配器是否经过合成图预训练。横线表示论文报告的标准差。
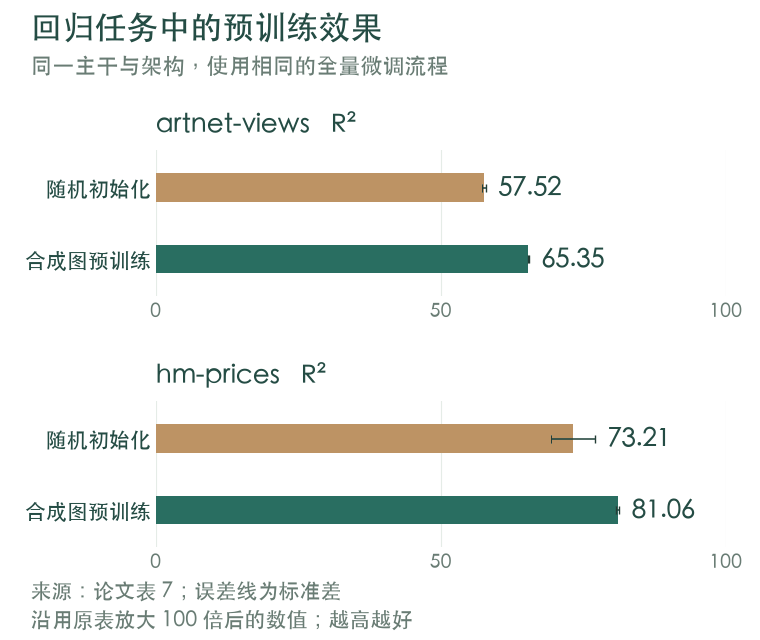
图 7|根据原论文表 7 重绘,选取两个回归数据集。已预训练的图适配器在这两个任务上也取得更好的结果。
例如,tolokers-2 从随机适配器的 51.64 提升到 62.80,hm-prices 从 73.21 提升到 81.06。这个对照说明,适配器在合成任务中学到的知识,对后续真实图学习有实际贡献。
作者还移除掩码图建模辅助任务,并将注意力适配器替换为均值聚合或 GCN 式聚合。整体结果支持保留掩码图建模和注意力适配器,但不同数据集的变化幅度并不一致。
合成图生成方式的比较则给出了更有保留的结论。作者提出的生成器整体优于简单随机连边与优先连接模型,但度修正随机块模型已经能取得相近结果,并在若干数据集上更好。
表 6|不同合成图生成规则的部分结果
| 图生成规则 |
artnet-exp |
tolokers-2 |
hm-prices |
| 简单随机连边 |
48.70 |
54.69 |
70.61 |
| 改进的优先连接 |
49.49 |
58.23 |
70.86 |
| 度修正随机块模型 |
51.14 |
61.71 |
78.19 |
| 作者的组合生成器 |
51.46 |
60.97 |
77.33 |
表注:选自原论文表 5,仅列均值。所有模型均采用 ICL,不做预测集成;前两项为 AP,后一项为 R²,沿用原表展示数值。这三列用于展示生成规则之间的差异,完整实验包含 8 个数据集。
这组结果支持在合成数据中加入有意义的图结构,也说明当前实验尚不足以认定更复杂的生成器具有稳定优势。作者保留组合生成器的理由包括结构更丰富,以及与主实验设置保持一致。
微调范围也有进一步缩小的空间。 作者保留预训练好的 LimiX 主干,只更新图适配器,在 8 个 GraphLand 数据集中的 6 个上取得与全量微调相近的表现。artnet-exp 和 tolokers-2 的差异更明显,且两者偏好的设置不同。
表 7|仅微调图适配器与全量微调的对照
| 数据集 |
仅微调适配器 |
全量微调 |
| artnet-exp |
54.65 |
53.49 |
| tolokers-2 |
61.98 |
62.80 |
| artnet-views |
65.24 |
65.35 |
| hm-prices |
81.03 |
81.06 |
表注:选自原论文表 7,仅列均值。前两项为 AP,后两项为 R²,沿用原表乘以 100 后的展示数值;两种设置均使用默认预测集成。
这一对照说明,预训练后的适配器已经承担了相当一部分任务适应工作。作者没有为仅微调适配器单独报告运行时间,因此,表中的成绩不能直接换算为节省了多少训练成本。
07 推理与微调需要不同的时间投入
作者在单张 NVIDIA A100 80GB 上比较了端到端运行时间。下表中的 GCN 包含从头训练的时间,GraphPFN 的 ICL 则使用已经完成预训练的模型。
表 8|部分数据集上的运行时间,单位为秒
| 数据集 |
GCN 训练 |
GraphPFN 单次 ICL |
GraphPFN 集成 ICL |
| amazon-ratings |
23.93 |
3.46 |
16.41 |
| artnet-views |
16.36 |
4.89 |
30.25 |
| city-roads-M |
27.29 |
2.89 |
16.22 |
| tolokers-2 |
27.24 |
2.12 |
7.03 |
表注:重排自原论文表 9,仅列均值。“单次”对应论文不做集成的 Light 设置,“集成”对应默认 10 次预测。比较使用已选好的超参数,不计超参数搜索,也不计基础模型预训练。
不做集成时,GraphPFN 在这四个数据集上的 ICL 用时约为 2 至 5 秒。加入默认集成后,时间有所增加,在 artnet-views 上超过了 GCN 的一次训练时间。微调的成本更高,论文默认微调设置在这四个数据集上约需 195 至 3,942 秒。
因此,实际使用时可以先用 ICL 查看结果,再决定是否投入微调。对需要反复处理新图的场景,这种使用顺序能够减少前期试验的等待时间。
08 对知识图谱建模的参考与边界
GraphPFN 展示了一条可行路径:通过可控规则生成大量图任务,让模型预先学习特征、邻居与标签之间的联系,再利用新图上的已标注节点完成适应。知识图谱中的实体分类、实体属性预测和跨图迁移,可以参考这种训练与使用方式。
表 9|与知识图谱任务的对应关系
| 知识图谱任务 |
可以参考的设计 |
仍需验证的部分 |
| 实体分类 |
读取已标注实体,结合属性和邻居预测类别 |
类型约束、多关系传播 |
| 实体数值属性预测 |
用节点回归联合处理属性与连接 |
属性缺失、单位和取值范围 |
| 跨图迁移 |
用多样合成图预训练共享模型 |
关系语义与领域差异 |
| 知识图谱补全 |
可参考预训练中的边辨别任务 |
三元组评分与候选实体排序 |
表注:根据论文方法整理的应用分析。这些对应关系属于本文讨论,论文没有报告上述知识图谱任务的专门实验。
迁移到知识图谱还需要补上关系语义。 论文的图适配器主要按邻接关系传递信息,没有展示针对多种关系类型、实体类型约束和三元组语义的专门建模与评估。若要用于具体知识图谱,合成数据生成器和消息传递模块都需要相应调整,效果也需要重新验证。
任务范围仍然集中在节点预测。 当前实现尚不支持直接开展链接预测或整图分类、回归。用于预训练的边辨别辅助任务,也不能替代完整的知识图谱补全实验。
规模同样是现实约束。模型需要一次处理整张图,显存占用会随节点数量和特征维度增加。作者在部分文本特征数据上先降维至 64 维,pubmed 的微调仍遇到显存不足。多分类原生支持最多 10 类,更多类别需要借助纠错输出编码等额外方法。作者设计的图先验主要面向社交与信息网络,对交通网络等具有特殊几何结构的图覆盖不足。作者还观察到,不同预训练随机种子带来的 ICL 表现标准差约为 0.3 至 0.7 个百分点。生成规则的覆盖范围和预训练的稳定性,都还有改进空间。
这篇论文提供的实验证据,集中在合成图预训练能够改善真实图上的节点预测与迁移。面向知识图谱,可以沿着这一思路进一步设计带类型和关系约束的合成任务,再用实体分类、属性预测及补全任务分别检验其效果。更多详细内容可以参考论文原文。对图基础模型与跨图迁移感兴趣的朋友,也欢迎到云栈社区和开发者们继续交流。
 发表于 前天 00:53
|
查看: 0|
回复: 0


