顶级律所花了几十年建文档库,但「过去十年最常用那条 MFN 条款」至今仍要靠资深律师口耳相传——因为文档系统存文件、数据库存记录、本体才存关系。
一、律所的「数字化悖论」:文件越多,可用的反而越少
一家百人所的并购组,问了一个看似简单的问题:「过去十年我们给 PE 基金客户起草的所有 side letter 里,出现频率最高的三条 MFN 变体分别是什么?各自都带哪些防御性例外?」
资深合伙人的第一反应不是去调档,而是打开手机翻自己的备忘录,或者干脆开个会——把当年亲手做过这事的三位老同事叫来,靠记忆拼出一份「差不多」的答案。文件当然都在 DMS(文档管理系统)里,条款当然也都在合同里。问题在于:DMS 知道的是「这份文件存不存在」,却不知道「这条 MFN 适用谁、约束谁、跟谁绑定」——这套答案一旦离开当年那几位老同事,连「差不多」的程度都拿不到。
这不是哪家律所的特例。律所的数字化,到今天为止,本质都是「文件柜的电子化」——把原本存在纸里的合同搬进服务器,方便检索、归档与权限管控。可你拿电子文件柜和资深律师脑子里那张「关系网」一比,尴尬就出来了:电脑不知道一份 side letter 中的 MFN 条款约束的是哪位 LP,更不知道这位 LP 还拿了哪些其他例外权利。
矛盾由此而来:文件越多,可被推理的反而越少。DMS 里躺着十万份合同,合伙人想回答一个跨合同、跨年度、跨对手方的问题,仍要靠问人。
二、文档系统、数据库、本体:数据组织的三个台阶
行业里讨论「数据组织」时,常常把这三个词混在一起用,但它们处理的是三种根本不同的能力:
文件管系统,回答的是「这份东西在不在、谁有权限看」。它的单位是「文件」,核心动作是上传、检索、版本管理。
数据库,回答的是「这行的字段是什么」。它的单位是「记录」,核心动作是查询、连接、聚合。一份合同可以拆成「表头(合同名、签约日、对手方)」+「明细行(条款列表、金额、币种)」——这是关系型数据库的拿手戏。
本体,回答的是「事物之间是怎么连的」。它的单位是「实体 + 关系」,核心动作是导航、推理、复合查询。一份合同里写的「基金 A 募资 5 亿美元,LP 之一是 B,B 通过 side letter 取得 MFN 权利」——本体要做的不是把这几句话拆成行存进表,而是把「基金 A」「LP B」「side letter」「MFN 权利」建模为四个独立但互联的对象,让「B 在 A 中拿到的 MFN 权利具体约束了哪些行为」成为一个可被查询的命题。
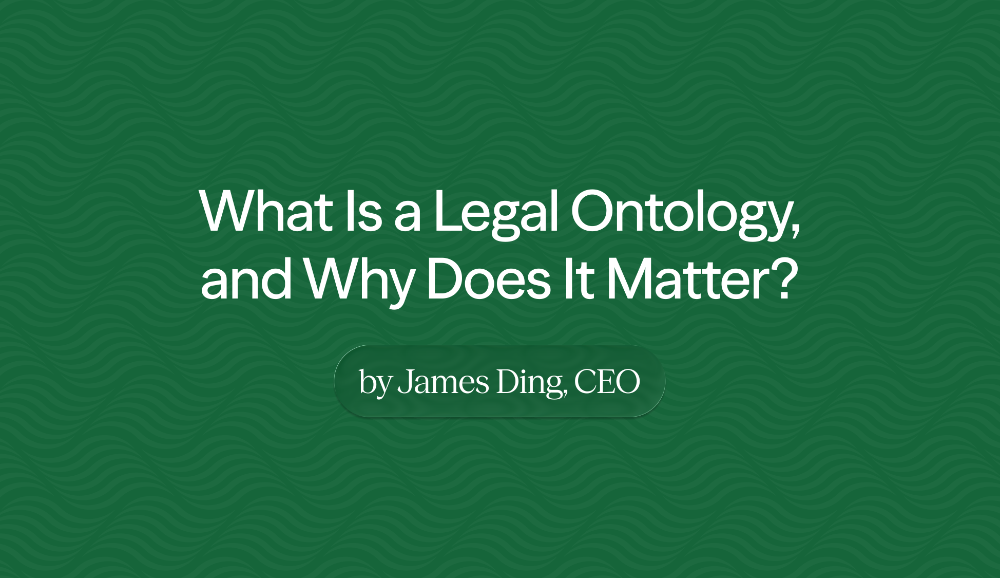
把这三件事并列起来看,能看到一条非常清晰的台阶:文件管系统是「存什么」,数据库是「怎么列」,本体是「为什么这样连」。律所过去三十年几乎所有的信息化投入,都集中在前两级台阶上——iManage、NetDocuments、Aderant 解决了「存得到」和「查得快」,但「能不能在几百份合同里做一次关系推理」,仍然是一道没人跨过去的题。
三、本体到底「长什么样」:从 PE 基金到 side letter 的关系链
抽象定义容易飘。Draftwise CEO James Ding 在 2026 年 7 月 1 日发表的博客里给了一个非常具体的例子:私募股权基金。
按他描述的逻辑,一个 PE 基金本体大致长这样:
- 基金(Fund):作为顶层对象,承载「基金名、募资规模、设立日、GP、运营人」等属性。
- LP(有限合伙人):作为单独对象,与基金通过「出资关系」连接。出资关系本身也是一条带属性的边——承诺金额、缴款节奏、违约条款。
- side letter(补充协议):作为对象,挂在特定 LP 与基金之间。它的存在意味着这位 LP 的待遇与标准 LPA(有限合伙协议)不同。
- MFN(最惠待遇)权利:作为对象,挂在某条 side letter 之下。它不是一段文本,而是一种「属性」:在满足何种条件下,这位 LP 自动取得其他 LP 已获得的更优条款。
- 防御性限制(defense investment restrictions):作为对象,与 MFN 平行挂在 side letter 之下。它与 MFN 经常相互约束——例如 LP 拥有 MFN,但放弃了投资国防类被投企业的权利。
把这些对象拼起来,关系链就是:基金—出资—LP—签订—side letter—含—MFN 权利 + 防御性限制。
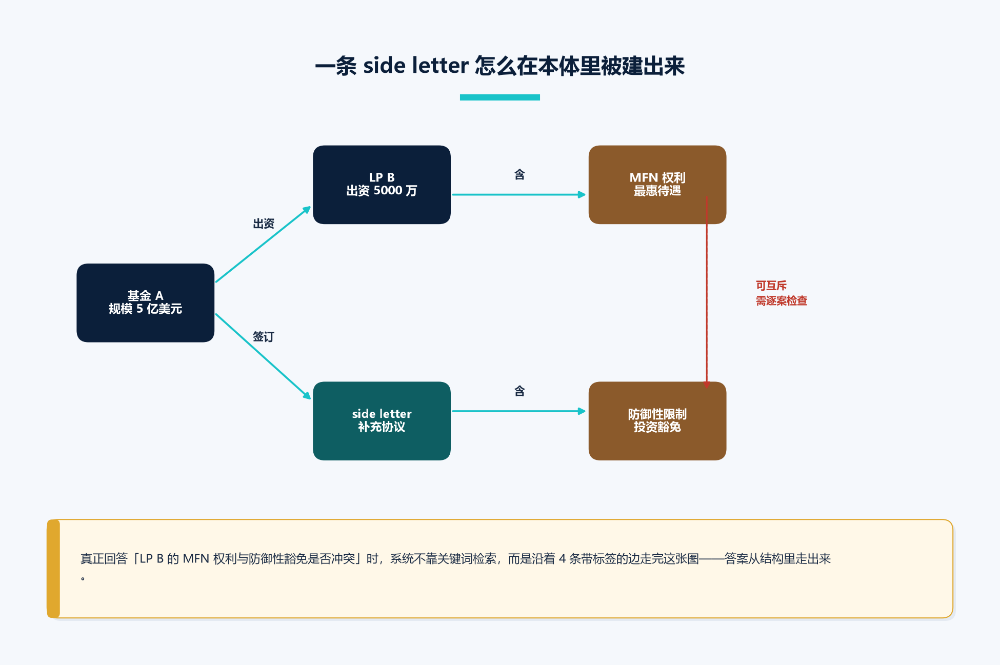
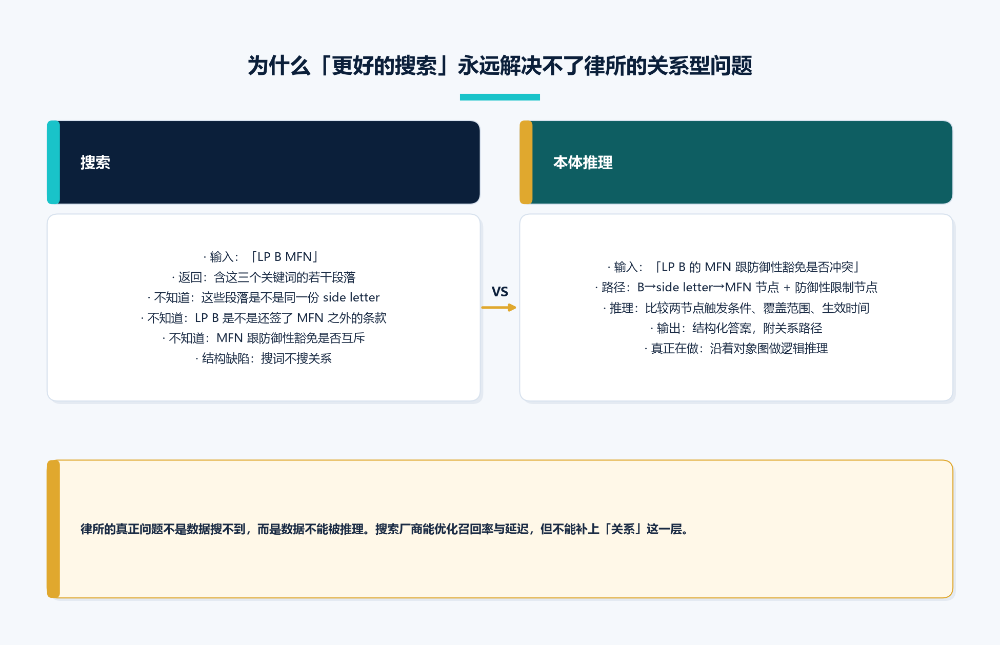
这段链的真正价值,不在于它的结构多么「像知识图谱」,而在于它把过去藏在不同文档、不同章节里的东西,连成了一个可遍历的图。当合伙人问「LP B 在基金 A 里的 MFN 权利,跟他承诺的国防类投资豁免有没有冲突」时,系统不需要去文档里捞相似段落、再人工比对,而是直接沿着关系图走一遍——B 取得的 MFN 覆盖哪些条款类型、防御性豁免覆盖哪些投资门类、两类条款的触发条件是否互斥——答案是结构化地、沿着边走出来的。
四、为什么「搜索」永远解决不了这个问题
熟悉法律科技的人会说:Elasticsearch 加 BM25 这类向量检索,召回率已经够高了,为什么还要费劲建本体?
文章给出了一段非常冷静的判断:搜索的价值在提升,但搜索的结构缺陷无法靠更好的搜索修复。
原因是搜索返回的是「与查询相似的文本」。它认识词,不认识关系。当合伙人问「LP B 在 A 中的 MFN 权利」时,搜索能召回含有「LP B」「MFN」关键词的段落,但它不知道这三件事之间是不是同一份 side letter、这份 side letter 是不是仍然有效、这位 LP 是否已经退出。
更要命的是「关系型问题」:跨实体、跨文档、跨时间窗的复合查询。「我们基金组合里,哪些 LP 同时持有 MFN 权利和防御性投资限制?这两类限制在我们正在推进的某笔投资中是否会触发冲突?」——这种问题,搜索根本无从下手,因为它要求的不只是「找到相关文本」,而是「沿着对象图做一次逻辑推理」。
文章把这件事说得很直白:问题不是律所的数据能不能被搜到,而是律所的数据能不能被推理。
这背后其实是 AI 时代一个被反复验证的命题:关系比文本更稀缺。文本可以被生成、被改写、被压缩,但「A 与 B 的关系、C 与 D 的关系、这两组关系在某种条件下的相互作用」是结构性的、不可被语料替代的。这也是为什么 2024 年到 2026 年,从 Palantir 到 Glean、从 Cambridge Semantics 到 Graphwise,整个产业的方向都是把「知识图谱」从演示文稿里搬进企业实际业务流。
五、「条款」才是律师真正思考的单元
文章还有一个细节特别值得法律科技领域的人注意:Draftwise 把建图的最小单位从「文档」下钻到了「条款(clause)」。
乍一看这像是工程细节,实际上是认知模型的差异。DMS 的最小单位是「文件」,数据库的最小单位是「记录」,而律师真正在意的——合伙人之间真正会拿来讨论的——从来不是「那份合同」,而是「那份合同里关于 keyman 的那条规定」。
Keyman provision(关键人条款)、MFN、indemnity(赔偿)、governing law(适用法律)——这些是律师的工作单位。把建图粒度定在「条款」级别,意味着:
- 跨合同的对比可以在同一抽象层做。比较「A、B、C 三个基金 side letter 中 MFN 的触发条件」时,你拿的是同一种结构化对象,而不是三段需要先理解再对齐的文本。
- 模板生成可以从结构出发。给定一套「基金 A 历史上常用的 MFN 变体」,生成新 side letter 时可以直接按对象属性拼装,而不是从模板里手工套词。
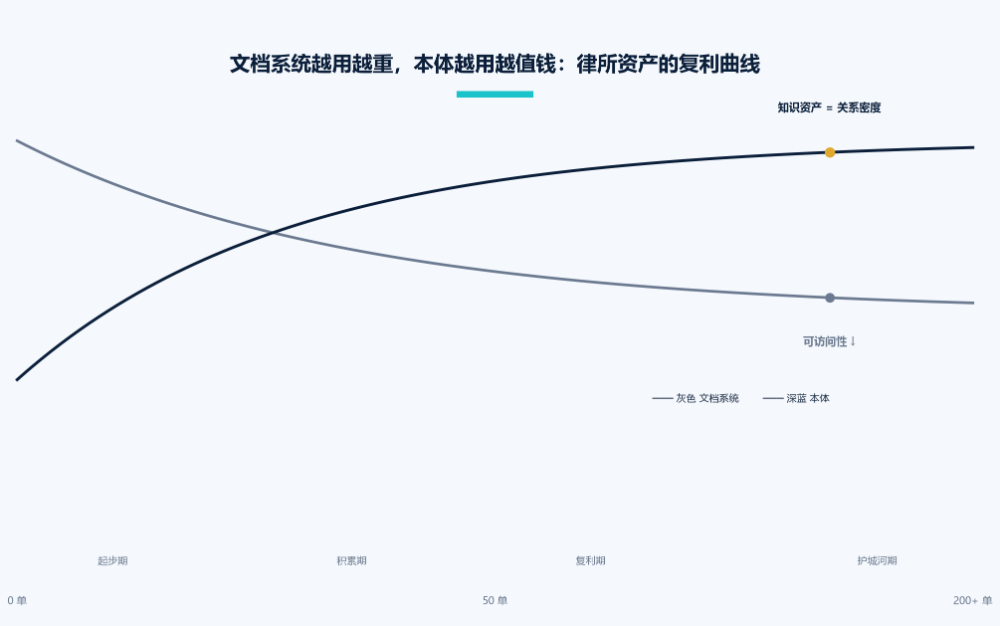
- 知识资产可以累积。每完成一单生意,那个「M」对象又多了一个实例,关系图多了一条带标签的边。
这是文章里一个我特别认同的判断:文档系统的价值不随文档数量显著增长,甚至越多越难用;而一个好的本体的价值,会随着每完成一单业务持续复利。对律所这种「知识即资产」的行业,这个差异不是技术路线之争,是商业逻辑之争。
六、产业影响:律所的「知识资产」开始真正入表
把视野拉远一点看,文章在讲的不只是法律科技的产品形态,而是一个更大的趋势:律所几十年沉淀的谈判 intelligence,第一次有了一个可被结构化承载的形态。
过去,律所最有价值的资产是「资深合伙人脑子里的东西」——他知道这件事的通常打法、那个交易里对手会怎么出招、这位客户过往偏好哪条措辞。这些知识没法被定价、没法被转让、没法在合伙人离职时「带着走」也没法「留下来」。一个律所的真正抗风险能力,等于其最资深合伙人的总和乘以他们能留在岗位上的年限。
本体化之后,这类知识有了物理上的载体。每一次交易完成,那个 LP 对象、那条 side letter、那个 MFN 变体就作为结构化数据沉淀进所里的图谱。新人入职调档的,不是尘封的文件夹,而是一张已经被前辈填得很满的图。律所抗风险能力的数学公式,第一次有可能从「合伙人个人记忆力」变成「本体图谱的密度 × 该图谱的可用性」。
更激进的推论是:律所之间的差异化将不再完全依赖「谁有更好的合伙人」,而开始依赖「谁有更好的本体」。后者可以被买卖、被复制、被员工带走;前者不行。这个反转让一些老牌强所警觉——它的护城河原本建在「人」上,而今可能被一行行 RDF 三元组悄悄抽走。
当然,这并不意味着资深合伙人的价值消失——相反,他们的价值在「决定本体里要建模什么、要忽略什么、要把哪些关系显式化」这件事上变得更高而不是更低。但他们的工作输出,终于有了「可脱离本人留存」的形态。
七、局限与冷水:本体不是万能的
把好话说完,得说冷水。法律本体的建设,绝不便宜。
第一,领域知识门槛高。把 side letter、MFN、indemnity 拆成可建模的对象,需要既懂合同法又懂数据建模的复合人才。这种人在公开市场极少,在律所内部基本要从资深律师里培养,培养周期以年计。
第二,维护成本追不上业务变化。监管变一次、合同范式变一次、对手的偏好变一次,关系图谱里的对象类型和关系类型就要跟着调整。本体和知识图谱最大的隐形成本从来不在「建起来」那一刻,而在「建起来之后的运营」。
第三,搜索厂商的反击。Elastic、Algolia 这类以向量检索为核心的厂商不会眼睁睁看着自己被边缘化。RAG(检索增强生成)的进化方向是 GraphRAG——把向量检索与图谱推理结合起来,这正是微软、Neo4j、Graphwise 这条路线在做的事。向量与图谱的边界,最终可能不是「谁取代谁」,而是「谁嵌在谁里面」。对律所来说,押注本体不等于可以放弃搜索能力,二者会被越来越紧地绑在一起。可以预判的是,未来三年法律科技产品的标准形态会是「向量检索 + 关系图谱 + LLM 推理」三件套,谁能把三者的工程化整合做到最低延迟与最高可信,谁就拿到下一代法律工具的话语权。
第四,数据敏感的合规问题。律所的合同数据是客户的核心商业秘密。把这些数据放进任何形式的图谱——无论本地还是云端——都要面对客户授权、数据出域、跨境合规等真问题。Draftwise 这类厂商必须以「我们不训练你的数据」「你的图谱是你的」作为最基础的承诺。
八、同类对比:医疗、金融、制造的本体化进程
把视野再拉远一点,会发现律所本体化并不是孤例。几乎所有「知识即资产」的行业,都在经历同一件事。
- 医疗:临床指南、药物相互作用、医保规则——这些知识一旦被本体化,CDSS(临床决策支持)才能在不被幻觉污染的前提下给出建议。这也是为什么 SNOMED CT、ICD、RxNorm 这类医学本体在过去十几年持续在投入。
- 金融:反欺诈、反洗钱、合规审查——背后都需要把账户、交易、对手、客户、规则织成一张图。这也是 Palantir 最早在 JPMorgan 拿下的那类场景的底层逻辑。
- 制造:设备、备件、故障、保养——构成工业本体的基础对象。西门子这些年从 PLM 走向数字孪生,走的就是这条路。
- 政务:一网通办背后的最大难点是「同一事项在各部门有不同的定义」——这件事不打通,各系统之间就只能靠人来翻译。本体正是用来打通的。
把这几个行业摆在一起看,本体化的进度条与行业的「错一次成本」高度相关。医疗、金融、法律的错一次成本最高,所以本体化推进也最坚决;营销、文娱的错一次成本相对低,所以进展相对慢。但近两年一个清晰的方向是:随着大模型把「理解+生成」的能力拉平到所有行业,「关系」反而成了新的稀缺品——这件事对低错一次成本行业也是成立的,只是优先级没那么靠前。对想在大模型应用层发力的团队来说,RouteFast.ai 这类模型 API 中转服务可以让 LLM 接入成本先降下来,但真正难啃的依然是业务关系怎么结构化。
九、关系即资产:每完成一单,本体就多一格
回到文章开头的那个场景。合伙人问「过去十年最常用那条 MFN 条款」,资深律师从脑子里掏答案——这件事的悲剧不在于答案不够好,而在于答案没法被复利。同一位律师明年退休时,这些答案会一起被带走;新律师入职后,要从头攒起一份自己的备忘录。
本体改变的是这件事的物理形态。每完成一单交易,那张图里就多一个对象、多一条边、多一条带标签的关系。一年下来、三年下来、十年下来,这张图会变成律所真正意义上最稀缺的资产——不是谁写的合同,而是合同之间被时间和谈判磨出来的那张关系网。
对一个习惯了「卖掉时间换钱」的律所来说,这种资产的会计科目是陌生的;对一个习惯了「靠知识图谱吃十年复利」的科技公司来说,这种资产则是全部商业模式的前提。这两条曲线正在交叉。Draftwise 这篇文章不是技术布道,是一家公司对行业未来十年的判断书。
对国内法律科技从业者,这个判断同样有直接含义:把「文档电子化」当成终点,是上一代信息化的事;把「关系结构化」当成起点,是这一代 AI 时代的事。律所的真正护城河,不在硬盘里有多少合同,在合同之间被建模出来多少条边。
落到具体动作上,国内法律科技团队有三件事可以先做起来:第一,把建图粒度从「合同」下钻到「条款」,这是与律师认知模型对齐的最小工程动作;第二,从单一业务场景切入(基金、并购、诉讼、租赁),先做透一个行业本体再横向铺开,避免一上来就做「大而全」的本体平台;第三,把每一次签约后的图谱增量作为可计量的资产指标——单签完成时图谱新增多少对象、多少关系、覆盖多少新条款类型——这条曲线本身就是「知识资产化」的会计报表。
来源:本文基于 Draftwise 官方博客《What Is a Legal Ontology, and Why Does It Matter?》(作者 James Ding,CEO,2026-07-01)的原创解读,部分图示为本号自制。
 发表于 4 天前
|
查看: 0|
回复: 0


