Jev 不是 ChatGPT 那样的聊天机器人,也不是编码模型。它不写回复、不做解释、不生成代码。
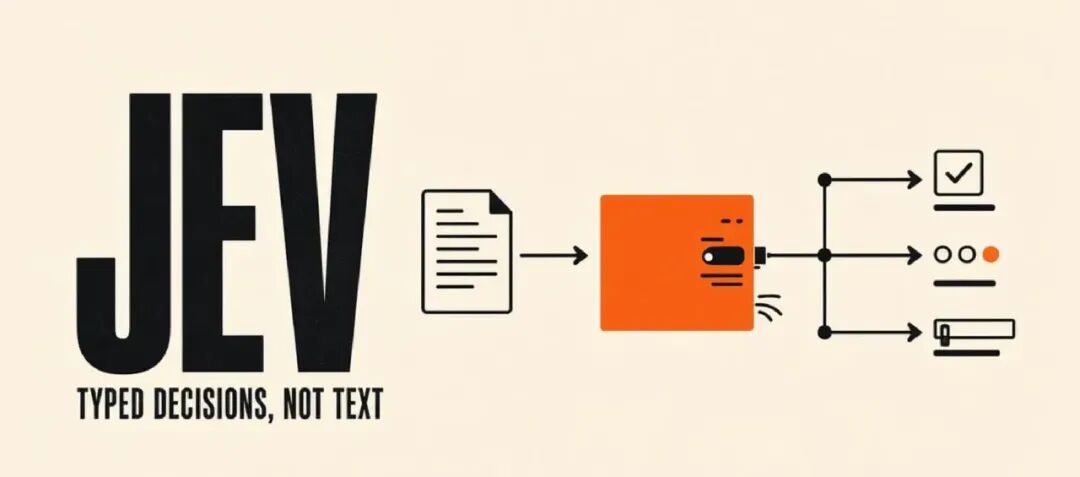
你把一批数据和一组带类型的问题交给它,它为每个问题返回一个答案:一个是/否概率,一个从你预先定义的备选项中挑出的选项,或者一个落在你自定义刻度上的位置。每个答案都带有概率。TypeSafe 称,大多数调用可在 100 毫秒左右完成;输入 token 每百万 0.042 美元,输出 token 免费。
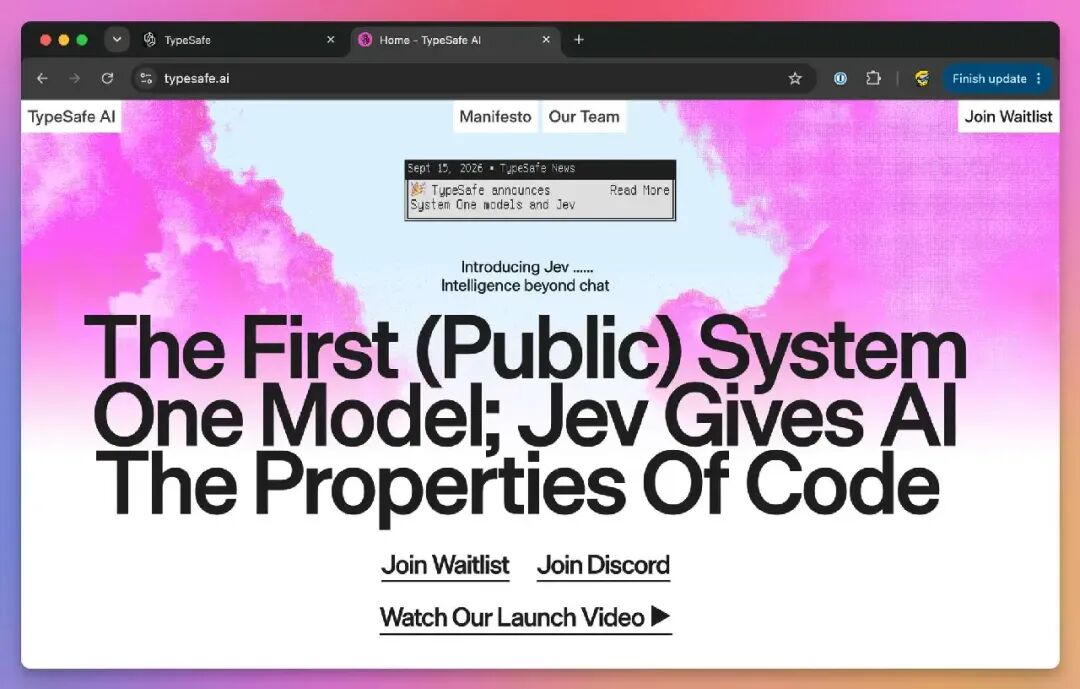
它出自 TypeSafe AI(https://typesafe.ai) —— 一家位于旧金山的实验室,于 2026 年 9 月 15 日正式亮相,手握 4000 万美元种子轮融资。Jev 是 TypeSafe 交出的第一个公开模型。TypeSafe 称其为 System One 模型,一类为“在软件内部快速做决策”而生的新模型,而非为与人聊天而生。
本文篇幅较长,覆盖以下问题:Jev 是什么、它为何存在、如何调用它、该如何看待向它提出的问题、它会在哪些地方失灵,以及我会把它用在哪些项目里面。
一句话说明 Jev 是什么
最简单的说法是:Jev 就是一个聪明的 if 语句。
普通代码根据可计算的值来分支:if (order.total > 100)。当条件可以由计算机核验时,这套做法很好用;可一旦条件变成一种“判断”,它就失灵了。这条客服消息是在发火吗?这封邮件是关于账单的吗?这 12 个按钮里,我该点哪一个才能继续结账?
当你有训练数据和固定标签时,传统分类器已经能处理范围狭窄的判断。而在 LLM 驱动的应用里,常见的做法是让通用模型返回结构化输出(structured output)。Jev 提供了另一个选择:预先定义可能的答案,拿到每个答案的概率,再根据结果做分支。
下面这个请求基于一份假想的赞助商表单。state 存放相关的表单字段,questions 则是你需要回答的问题。
{
  "model": "jev-latest",
  "state": {
    "opportunity": "link",
    "name": "Managed Postgres",
    "description": "We make a managed PostgreSQL hosting product and would like to sponsor the newsletter in October."
  },
  "questions": {
    "is_sponsor_inquiry": {
      "type": "noul",
      "instructions": "Does `description` ask to sponsor the site or newsletter?"
    },
    "product_category": {
      "type": "choice",
      "instructions": "What kind of product is described by `name` and `description`?",
      "criteria": {
        "dev_tool": "Developer tools, hosting, APIs, SaaS for developers",
        "course": "Courses, books, or training",
        "unrelated": "Anything not aimed at developers"
      }
    },
    "message_quality": {
      "type": "score",
      "instructions": "How specific is the request?",
      "criteria": [
        "Generic template, no reference to this site",
        "Mentions the site but no concrete ask",
        "Concrete ask with a timeframe or product named"
      ]
    }
  }
}
返回值的结构长这样:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_sponsor_inquiry": { "type": "noul", "noul": 0.99 },
    "product_category": {
      "type": "choice",
      "choice": "dev_tool",
      "probabilities": { "dev_tool": 0.97, "course": 0.01, "unrelated": 0.02 },
      "confidence": 0.95
    },
    "message_quality": {
      "type": "score",
      "score": 1.9,
      "legend": {
        "0": "Generic template, no reference to this site",
        "1": "Mentions the site but no concrete ask",
        "2": "Concrete ask with a timeframe or product named"
      },
      "probabilities": { "0": 0.0, "1": 0.1, "2": 0.9 },
      "confidence": 0.86
    }
  },
  "usage": { "input_tokens": 210, "output_tokens": 31 }
}
上面的数字只是示意,返回结构的形状则是精确的。其中有三点值得注意:
- 没有需要你去解读的生成式文字。API 直接返回结构化 JSON。
- 每个答案都被约束在你提供的选项之内。
product_category 只能是 dev_tool、course 或 unrelated,模型编不出第四个类别。
- 三个问题在同一次调用中同时得到回答。再加第四个问题,响应时间几乎不变。
接下来,那些枯燥的部分就可以交给你的代码了:
const { answers } = response

if (answers.is_sponsor_inquiry.noul > 0.9 && answers.product_category.choice === 'dev_tool') {
  sendRateCard(email)
} else {
  queueForManualReply(email)
}
整个思路就这么简单:模型负责判断,代码掌握下一步要做什么。
Jev 与 ChatGPT、Cursor、Codex 和 Claude Code 有何不同
大多数流行的 AI 工具都把生成式模型放在体验的中心。你给模型一个宽泛的请求,它便产出一些新的东西。
ChatGPT 的主要界面是对话。你提出一个问题,收到生成的文字、代码、图像,或者工具调用的结果。模型之所以能应对宽泛的请求,是因为响应里该放什么由它自己决定。
Cursor 不是一个模型。 它是一个可以使用不同模型的编辑器与智能体产品。你给 Cursor 一个编码任务和仓库的访问权限,它的智能体便会检查文件、写代码、运行命令、跑测试,一直干到出结果为止。
Codex 和 Claude Code 也是编码智能体。Codex 可以通过应用、CLI 和云端工作流使用;Claude Code 运行在终端和其他开发环境中。两者都接受一个目标,比如“加个认证”或“修好这个测试”,然后检查项目、选用工具、编辑文件、运行命令,如此往复。
其他智能体 CLI 工具也遵循同样的模式。终端是它们的界面,但循环仍由智能体掌控:读取请求、决定下一步、调用工具、检查结果、继续推进。
Jev 完全不这么做。它不接受开放式目标,也不会朝目标层层推进;它不会自己去检查仓库、调用工具、编辑文件,更不会维持一个持续运行的智能体循环。你的代码交给它一个 state 和一组问题,它返回带类型的答案和概率,然后就停手了。
| 工具 |
你给它什么 |
它返回什么 |
它的角色 |
| ChatGPT |
提示词或一段对话 |
生成的响应 |
通用助手 |
| Cursor |
编码任务、仓库和工具 |
文件编辑、命令、测试结果 |
编辑器与编码智能体 |
| Codex |
编码目标、项目和工具 |
代码变更与已完成的任务 |
编码智能体 |
| Claude Code 及其他 CLI 智能体 |
一条指令和本地工具 |
工具调用、编辑和终端结果 |
终端编码智能体 |
| Jev |
state 加上答案形状已定义的问题 |
选项、分数和概率 |
软件内部的决策原语 |
但是 Jev 可以嵌入这类工具内部,而不是取代它们。
编码智能体可以在运行 shell 命令之前问一问 Jev:这条命令是只读的、可逆的,还是破坏性的?智能体路由器可以用 Jev 来选择由哪个模型接手任务。SaaS 应用可以用它来判定一条客服消息该查数据库、交给生成式模型,还是转给人工。
编码智能体照旧写代码,ChatGPT 照旧写答案,而 Jev 负责处理那个指示系统走哪条路的小决策。
这改变了我们给产品添加 AI 的方式。产品不必变成聊天机器人,整个工作流也不必变成智能体。你可以保留现有的应用,只在普通 if 语句读不懂输入的地方加上一次模型调用。
这也可能改变大多数 AI 调用发生的位置。聊天机器人和编码智能体之所以显眼,是因为模型本身就是产品;而决策模型可以隐入客服队列、事件管道、垃圾邮件过滤器或权限检查之中。一次用户操作可能在后台触发好几个小判断,界面上却看不到任何 AI 的影子。
现在就断言决策模型会成长为比生成式 LLM 更大的市场,还为时尚早。但它们可能带来更大的调用量:一个人一天也许只打开 ChatGPT 几次,而普通软件可以在后台做出成千上万个微小决策。如果这种接口被证明有用,主要模型提供商就有理由推出各自面向决策的模型。
把 AI 组合进软件的想法并不新鲜。开发者早就在用小型 LLM、embedding、传统分类器和结构化输出做这件事了。Jev 的贡献在于,它是一个专为此角色设计的模型与 API:低延迟、低成本、带类型的答案,并把概率作为常规输出。
Jev 与分类器及结构化 LLM 输出有何不同
在 Jev 出现之前,在软件里做这类决策有三种常见方式:
- 手写一个
if、一条正则表达式或一棵决策树。
- 为一组特定标签训练一个分类器。
- 让通用 LLM 返回结构化输出。
手写规则快速、便宜、可预测,但当语义变得重要时,它们就会变得脆弱。传统分类器同样快,但你通常需要标注样本、一个训练步骤,还要为每个任务单独维护一个模型。
通用 LLM 无需那种按任务训练便能理解非结构化文本:今天给客服消息分类,明天审查代码评审,都不在话下。但它终究是生成式模型,哪怕你把它的答案约束成 JSON。
Jev 瞄准的是中间地带。像 LLM 一样,它接受非结构化文本和你在运行时定义的问题;像分类器一样,它返回受约束的概率分布,而不是开放式的答案。
结构化输出早已存在,而且确实管用。大多数主流模型提供商要么直接提供,要么通过工具调用(tool calling)提供。如今的 Vercel AI SDK 用 generateText() 和 Output.object() 将它们标准化,再对照你的 schema 校验结果。
真正的区别,在于答案如何产生,以及成本几何。
LLM 是一个 token 一个 token 地生成答案的。要返回 {"category": "billing", "urgent": true},它必须按顺序生成每一个输出 token,且每个 token 都以前面的内容为条件。schema 可以约束并校验结果,但生成过程仍可能失败,或在产出有效对象之前中断——AI SDK 会把这类情况报告为结构化输出错误。而如果你让 LLM 估计一个概率,这个估计也不保证经过校准(calibrated)。
Jev 不生成自由格式的字符串。TypeSafe 称,其架构会并行采样所有答案:请求中的每个问题都对照同一个 state 独立评估,输出则是在你定义的选项之上的概率分布。API 在网络上传输的依然是 JSON,但你的应用无需再从生成的文字里“还原”出一个决策。
这正是它又快又便宜的原因。TypeSafe 给出的端到端响应时间是 70 到 500 毫秒,而同类问题上前沿 LLM 需要 3 到 329 秒。价格方面,每百万输入 token 0.042 美元,比 LLM 的输入价格低大约 5 到 240 倍——后者因模型而异,从每百万 0.20 美元到 10 美元不等;输出免费,因为几乎没有输出量可计。公司招牌数字“快 193.6 倍、便宜 444.6 倍”来自它自己的工作流评估,而且它自己也承认,这属于现实世界中偏高端的情形。所以,请把它们当作上限,而非你实际能测到的水平。
另一处差异在于模型的训练方式。许多聊天模型采用 RLHF 或相关的偏好优化方法,奖励的是人类偏爱的答案;TypeSafe 则用所谓校准决策强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)训练 Jev,优化的目标是与真实结果相符的概率。所谓“校准”,指的是在大量预测中,被赋予 90% 概率的那些答案,应当有大约 90% 的时间是对的。至于单个答案是否正确,则毫无保证。另一个好处是:成功的 Jev 响应不可能包含你给定 schema 之外的值,于是“schema 错误”和“决策错误”成了两个相互独立的问题。
还有一样东西,是 Jev 主动放弃的。它不能写回复、不能生成代码、不能总结文档,也无法解释自己的推理过程。你需要文本,就仍然需要 LLM。真正有趣的架构是两者配合:Jev 负责决策,需要动笔时由 LLM 来写。
名字的由来
两个有助于建立心智模型的小知识。
System One 致敬丹尼尔·卡尼曼的《思考,快与慢》。系统 1 是大脑不费力气就能做出的快速、直觉式判断,系统 2 则是缓慢、深思熟虑的推理。在 TypeSafe 的表述里,Jev 处理第一类任务,推理模型处理第二类。
Jev 的名字取自经济学家威廉·斯坦利·杰文斯(William Stanley Jevons),杰文斯悖论(Jevons paradox)正是因他得名:蒸汽机效率提升后,煤的消耗量不降反升,因为更廉价的动力创造了新的用途。TypeSafe 的赌注是,智能也会遵循同样的曲线——当一次决策的成本远低于一美分,你就会把决策放进那些永远不会去调用 LLM 的角落。
Jev 在底层是如何工作的
这一部分我们简单聊聊就好,因为公司并未详细公开架构,而作为使用者,真正重要的只有以下几点。
请求中的每个问题(question)都基于同一个 state。TypeSafe 称,这些问题会被独立且并行地评估,因此一个答案不会成为另一个答案的上下文。其测试表明,除了模型正常的运行间采样噪声,不存在额外的批处理效应。
由于模型产出的是你选项之上的分布,而非自由格式文本,一个成功的答案不可能包含格式错误的值。TypeSafe 将这一点标为 0% 的类型错误率,并称该数字是结构性的,而非经验性的。这个保证覆盖的只是答案的形状,不代表所选答案一定正确。
输入规模也有限制。state 连同所有问题共享约 64,000 token 的预算,且 state 加最长的那一个问题必须装进约 32,000 token,约合 150,000 字符的英文文本。一个 Choice 问题最多可有 255 个选项,一个 Score 可有 2 到 10 个等级。
Jev 只读文本。state 可以是字符串、JSON 对象,或由文本构成的 JSON 数组。图像、音频和视频暂不支持。
当前模型为 jev-1.13.0,有两个别名指向它:jev-latest(稳定版,也是 SDK 的默认值)和 jev-preview(存在预览构建时向前指向新版本)。响应中总会标明实际应答的版本号 ID,因此务必将其记入日志。如果你针对某个版本调校过置信度阈值,请固定该版本的 ID,而不要使用别名。
三种问题类型
你向 Jev 提出的一切问题,都属于三种原语(primitive)之一:Noul、Choice 和 Score。每一个都由你定义,各自返回不同形状的答案。
| 类型 |
对应的问题 |
返回什么 |
| Noul |
这是真的吗? |
noul,一个 0 到 1 的概率 |
| Choice |
这些选项中的哪一个? |
choice、probabilities、confidence |
| Score |
在这个刻度上的什么位置? |
score、legend、probabilities、confidence |
每个问题都有一个由你命名的 ID、一个 type 和一个 instructions(指令)。Choice 和 Score 还需要 criteria(判定标准),Noul 则可以把 criteria 当作可选补充。
ID 是给你代码用的,不会发送给模型。所以即便 ID 看起来一目了然,也要在 instructions 里把问题写完整:refund_requested 这个键名,对模型来说什么也没说。
Noul:是/否问题
当答案非“是”即“否”时,用 Noul:这条消息是不是在要求退款、这份简历有没有提到 Kubernetes、这条评论里存不存在邮箱地址。
{
  "refund_requested": {
    "type": "noul",
    "instructions": "Does the customer ask for money back?"
  }
}
答案是一个单一的数字:
{ "refund_requested": { "type": "noul", "noul": 0.93 } }
noul 是答案为“是”的概率。接近 1 表示强“是”,接近 0 表示强“否”,接近 0.5 则意味着模型给两种答案的概率不相上下。
措辞要让高值对应“是”。“客户冷静吗?”和“客户生气吗?”都能用,但如果一个 Noul 里 true 映射到“否”,那既会搞晕模型,也会搞晕六个月后读你代码的人。
当“是”与“否”的界线较为微妙时,用 criteria 描述两边各自的含义:
{
  "is_urgent": {
    "type": "noul",
    "instructions": "Does the message convey urgency?",
    "criteria": {
      "true": "The sender asks for action today or mentions losing money or customers",
      "false": "No deadline and no consequence is mentioned"
    }
  }
}
Noul 得到 0.5 并不表示“中等”。问“这位候选人 Python 强吗?”得到 0.5,你了解到的是模型分辨不出,而不是此人水平一般。要衡量程度,请用 Score;要得到明确的是/否,就把条件定义得可判定,比如:“简历中是否写明该候选人在工作中用过 Python?”
Noul 答案没有单独的 confidence 字段。true 的概率,就是该问题返回的唯一不确定性信号。
Choice:从选项中挑一个
当答案来自一个固定集合、且选项之间不分先后时,用 Choice:哪支团队处理这张工单、这个文件是什么语言写的、这 40 个链接里哪一个通向定价页。
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this message?",
    "criteria": {
      "billing": "Charges, invoices, refunds, subscriptions",
      "technical": "Bugs, outages, integration problems",
      "sales": "Pricing questions, upgrades, new accounts",
      "other": "None of the above"
    }
  }
}
答案包含选中的选项以及完整的概率分布:
{
  "department": {
    "type": "choice",
    "choice": "billing",
    "probabilities": { "billing": 0.84, "technical": 0.15, "sales": 0.0, "other": 0.01 },
    "confidence": 0.6
  }
}
choice 是概率最高的选项;probabilities 给出你定义的每个选项之上的完整分布;confidence 则把分布的形状压缩成一个数:某一选项占主导时高,概率分散时低。在上面这个示意响应里,billing 胜出,但仍有部分概率落在 technical 上。
文档建议:只要选项列表可能覆盖不了所有输入,就补一个 other 或 none_of_the_above 选项——你不给模型留退路,它也只能硬选一个。描述每个选项时,要讲清哪些内容属于它;边界模糊时,说明它与相邻选项的区别。然后,用带标签的样本去检验这些描述。
Score:在你描述的刻度上的位置
当答案落在一个连续区间上、而你能说清每个点位代表什么时,用 Score:Bug 严重程度、候选人对某项技术的经验深浅,都是典型场景。
{
  "bug_severity": {
    "type": "score",
    "instructions": "How severe is the reported issue?",
    "criteria": [
      "Cosmetic; no impact on functionality",
      "Broken or degraded feature, but a workaround exists",
      "Blocking issue; no workaround exists"
    ]
  }
}
criteria 数组从低到高排列,每个条目所在的位置就是它的等级号(从 0 开始)。答案长这样:
{
  "bug_severity": {
    "type": "score",
    "score": 1.3,
    "confidence": 0.54,
    "legend": {
      "0": "Cosmetic; no impact on functionality",
      "1": "Broken or degraded feature, but a workaround exists",
      "2": "Blocking issue; no workaround exists"
    },
    "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }
  }
}
score 是各等级号的概率加权平均值:0 × 0.0 + 1 × 0.7 + 2 × 0.3 = 1.3。它可以落在两个等级之间。这里的 1.3 意味着“大体是存在变通方案的故障,同时带有一些‘完全阻断’的权重”——对一个只影响 Safari 用户的 bug 而言,这是相当公允的解读。
要把 probabilities 与分数放在一起看。1.0 的分数,可能意味着全部权重都压在等级 1 上,也可能是一半在等级 0、一半在等级 2——数字相同,局面却截然不同。confidence 正是用来区分二者的:前者自信,后者不自信。
Score 最重要的一条规则:描述情境,而非程度。“功能损坏,但有变通方案”给了模型可以与 state 对照的东西;“中等严重”则没有。文档指出,光秃秃的数字让模型没有任何可匹配的依据,于是它只能把概率平摊到各个等级上。
每个等级都是独立评判的。模型看不到等级号,也看不到相邻等级,所以“比上一级更糟”这种说法对它毫无意义。
每个 Score 只保留一个维度。如果某个等级写成“准时、聪明又经验丰富”,那么一个在其中一维高、另一维低的输入就无处安放,置信度也随之崩掉。请拆成三个 Score,在代码里组合——下面我们正是这么做的。
State:你给 Jev 看的内容
state 是问题所针对的内容。它可以是一个纯字符串:
"My card was charged twice for order A-104."
也可以是带命名字段的对象:
{
  "message": "My card was charged twice for order A-104.",
  "order": { "id": "A-104", "charges": [49, 49] },
  "refund_policy": "Duplicate charges are refunded in full."
}
还可以是数组,用于一段对话或一组记录。
大多数请求建议用对象,因为这样可以用反引号路径把问题精确指向 state 的某一部分:
{
  "policy_supports_refund": {
    "type": "noul",
    "instructions": "Does `refund_policy` cover the situation described in `message`, given `order.charges`?"
  }
}
反引号搭配“点号加下标”的写法,是文档推荐的字段引用方式,可以消除“问题究竟指向 state 的哪一部分”的歧义。
关于 state 还有一条规则:只发送问题需要的内容。当 state 里塞满与决策无关的内容时,准确率会下降,所以请先在代码里做过滤。如果你在给一张客服工单打分,就不要把客户的全部历史记录一起发过去;如果你在分类某个段落,就不要把整篇文档发过去。TypeSafe 坦言,这个模型和其他模型一样会遭遇“上下文腐化”(context rot),而解决办法在你这一侧。
Confidence:何时行动、何时求助
Confidence(置信度)是 Jev 最有价值的输出之一。通用 LLM 给出的概率,并不会自动获得同等程度的校准。
每个 Choice 和 Score 答案都带有 0 到 1 的 confidence,由 probabilities 的形状计算得出:集中在某一选项上意味着高置信度,分散则意味着低置信度。你不必被 TypeSafe 的定义锁死——完整的概率分布就在响应里,如果你的领域需要,完全可以自行计算统计量。
文档建议的处理方式,也是我会首先采用的起点,是把置信度划成三段:
- 高:自动执行。模型读得很清楚。
- 中:谨慎执行。请用户确认、标记待审,或先补充数据。
- 低:不执行。转人工、要求澄清,或退回到更慢的系统。
界线画在哪里,取决于答错一次的代价。TypeSafe 文档以 0.5 作为人工复核下限的示例值,以 0.9 作为执行破坏性操作前的门槛,但这些都是示例值,而非默认值。下面是用 JavaScript SDK 表达这一模式的例子:
const { answers } = await client.systemOne({
  state: userMessage,
  questions: {
    action: choice('What is the user trying to do?', {
      check_balance: 'View the account balance',
      approve_transfer: 'Approve the pending withdrawal',
      support: 'Get help with a problem',
    }),
  },
})

const action = answers.action

if (action.confidence < 0.5) {
  routeToHuman(userMessage)
} else if (action.choice === 'check_balance') {
  showBalance(accountId)
} else if (action.choice === 'approve_transfer') {
  if (action.confidence > 0.9) {
    confirmThenExecute(accountId)
  } else {
    askUserToConfirm(accountId)
  }
}
在这个例子里,0.5 的下限拦下了模型自认“拿不准”的答案;在它之上,无需确认即可执行的门槛随风险水涨船高。风险容忍度就掌握在你自己的代码里,体现在那些看得见、改得动的数字上。
从保守的阈值起步,在自己的数据上跑起来,把置信度与准确率的对应关系画成图,再据此调整阈值。合适的取值取决于你的领域,也取决于模型在你的输入上的实际表现。
获取访问权限
Jev 目前处于早期访问阶段。你可以在 typesafe.ai 加入候补名单,通过后便会收到邮件。从发布头几天用户的反馈来看,注册后一两天内就能拿到访问权限。
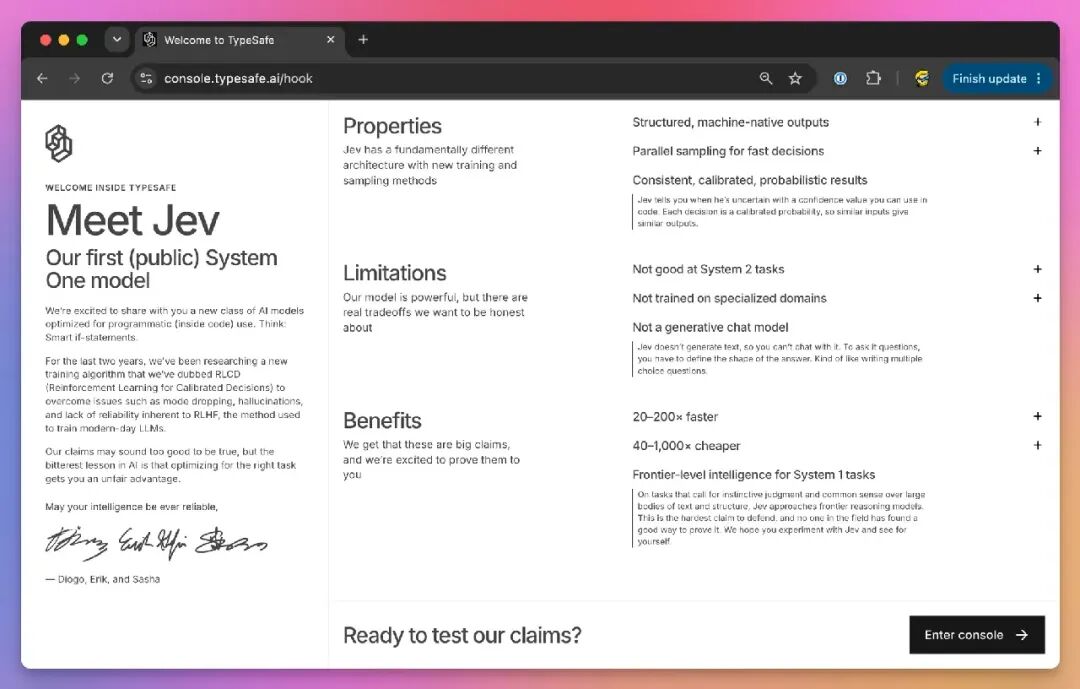
进入之后,console.typesafe.ai 会用一页简短的内容向你介绍 Jev 是什么,以及——这点尤其难得——它坦言自己不擅长什么:System 2 任务、专门领域,以及一切生成式工作。
控制台首页链接了 cookbook(实操手册)、demo(演示),以及一段可直接粘贴进编码智能体的提示词,用于安装 TypeSafe 技能。
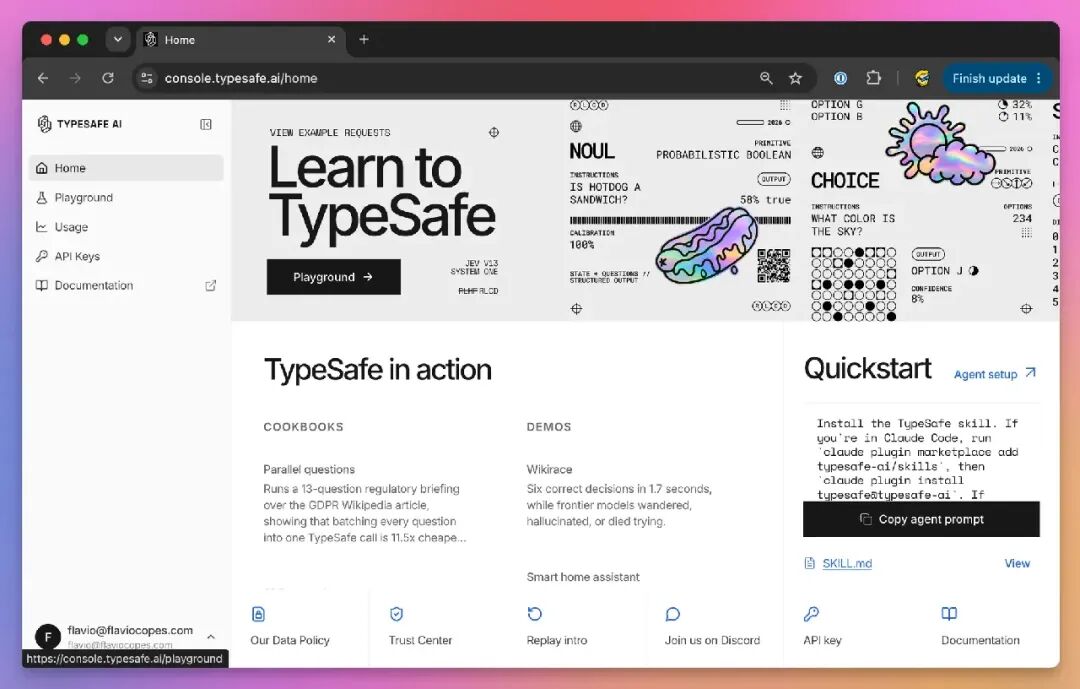
如果由我来安排,第一个小时一定会花在 Playground 上。你在左侧粘贴一个 state,添加三种类型的问题,然后对着 jev-latest 运行。右侧有三个上手演练课程,外加三个贴近真实的用例:简历筛选、审计客服智能体的聊天记录、为 HelpDesk 工单分流。
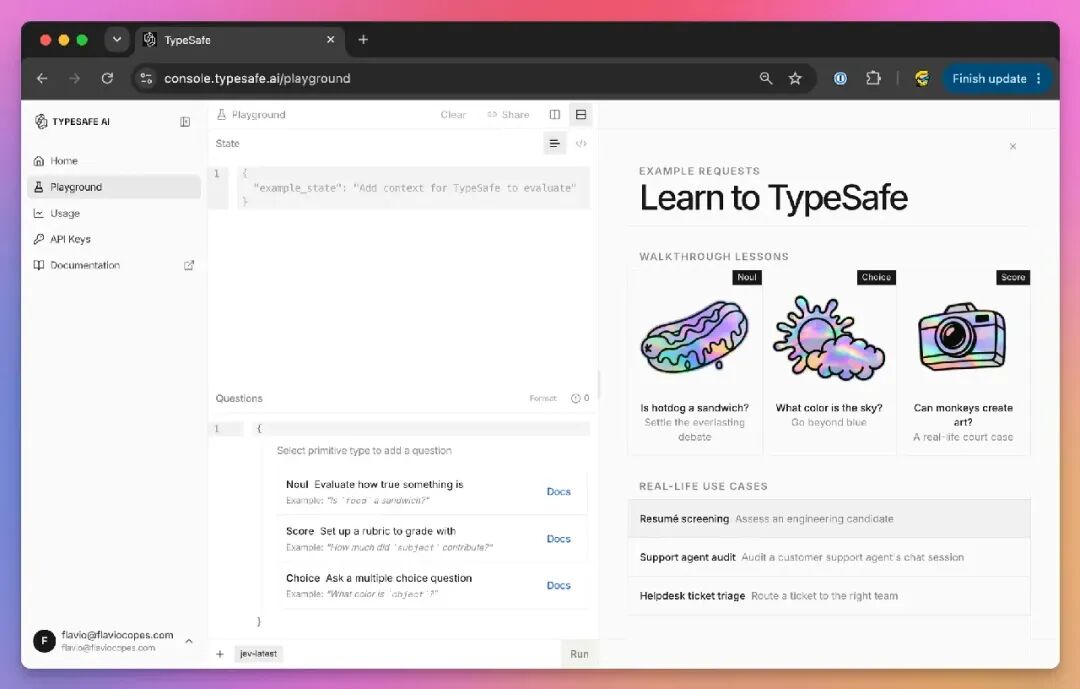
API 密钥同样在控制台中,位于 API Keys 之下;Usage 页面则显示你的 token 消耗。
如果你不想等候选名单,也可以通过 Vercel 的 AI Gateway 使用 Jev,模型 ID 为 typesafe-ai/jev,价格同样是每百万输入 token 0.042 美元。这条路径用的是 AI SDK,而非 TypeSafe 自家的 SDK,下文会有介绍。
另外 OpenRouter 也已经开放 Jev 模型调用了:https://openrouter.ai/typesafe/jev-1.13。
用 curl 发出第一次调用
所有评估请求都走同一个端点:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
把密钥写进环境变量,然后发送本文开头那个赞助商表单的例子:
export TYPESAFE_API_KEY=your_key_here

curl -s https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {
      "opportunity": "link",
      "name": "Managed Postgres",
      "description": "We make a managed PostgreSQL hosting product and would like to sponsor the newsletter in October."
    },
    "questions": {
      "is_sponsor_inquiry": {
        "type": "noul",
        "instructions": "Does `description` ask to sponsor the site or newsletter?"
      }
    }
  }'
你会拿回 answers 对象、实际应答的带版本号 model,以及包含输入/输出 token 计数的 usage。
错误码都是你熟悉的那几个:401 表示密钥缺失或错误;422 表示请求体未通过校验(响应体会指明是哪个字段);429 表示触发限流;529 表示服务过载。后两者请用指数退避(exponential backoff)重试 —— SDK 会替你做这件事。
此外还有 GET /v1/models,目前列出你的账号可以在 model 字段中使用的别名。像 jev-1.13.0 这样的带版本号 ID,即使不在列表中依然有效。
在 Node.js 中使用 Jev
JavaScript SDK 名为 @typesafe-ai/sdk,需要 Node.js 20 或更新版本,同时提供 ESM、CommonJS 和 TypeScript 类型定义。
npm install @typesafe-ai/sdk
客户端会从环境变量读取 TYPESAFE_API_KEY。noul、choice、score 三个辅助函数负责构建问题,答案类型也随之自动推断:
import { choice, noul, score, TypeSafeClient } from '@typesafe-ai/sdk'

const client = new TypeSafeClient()

const ticket = 'The export button crashes the settings page in Safari. Works in Chrome, but some of our customers only use Safari.'

const { answers, model, usage } = await client.systemOne({
  state: { ticket },
  questions: {
    category: choice('What kind of ticket is `ticket`?', {
      bug_report: 'Something is broken or behaving wrong',
      feature_request: 'Asks for something that does not exist yet',
      billing: 'Charges, invoices, refunds',
      other: null,
    }),
    severity: score('How severe is the issue in `ticket`?', [
      'Cosmetic; no impact on functionality',
      'Broken or degraded feature, but a workaround exists',
      'Blocking issue; no workaround exists',
    ]),
    has_repro_steps: noul('Does `ticket` say how to reproduce the problem?'),
  },
})

console.log(answers.category.choice)
console.log(answers.severity.score)
console.log(answers.has_repro_steps.noul)
console.log(model)
console.log(usage.input_tokens)
Choice 选项的描述写 null 表示“无需额外说明”,用在 other 这类兜底选项上正合适。
在 TypeScript 中,answers.category.choice 的类型是 'bug_report' | 'feature_request' | 'billing' | 'other'。这些标签有自动补全,未知标签过不了类型检查;如果你想让 TypeScript 强制 switch 穷尽所有分支,还可以加一个 never 断言。
你可以在请求中传入 model: 'jev-1.13.0' 来固定版本,也可以给 systemOne() 传第二个参数,为单次调用设置 timeout、retry 和 signal 选项。
几行 Python 代码
Python SDK 名为 typesafe-sdk,需要 Python 3.10 或更新版本:
pip install typesafe-sdk
用法如出一辙,只是换成了 Choice、Noul、Score 三个类:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state="I was charged twice for order A-104. Please refund the duplicate.",
    questions={
        "department": Choice(
            instructions="Which team should handle this?",
            criteria={
                "billing": "Charges, invoices, refunds",
                "technical": "Bugs and integration problems",
                "other": None,
            },
        ),
        "refund_requested": Noul(
            instructions="Does the customer ask for money back?",
        ),
    },
)

print(response.answers["department"].choice)
print(response.answers["refund_requested"].noul)
此外还有 AsyncTypeSafeClient(异步客户端)以及可配置的重试策略。
通过 Vercel AI SDK 使用 Jev
如果你的应用已经在使用 Vercel AI SDK,就不必再引入第二个客户端。AI SDK 7(自 7.0.105 起)内置了 experimental_evaluate 函数,正是为这类模型而设,TypeSafe 则是它的原生 provider。OpenAI、Anthropic 和 Google 的模型也可以通过一个适配器(adapter)回答同样的问题——该适配器会以提示方式要求它们输出结构化结果。
当前的 AI SDK 7 与 TypeSafe provider 包均要求 Node.js 22 或更新版本。安装之后,为直连 provider 设置 TYPESAFE_AI_API_KEY:
npm install ai @ai-sdk/typesafe-ai
export TYPESAFE_AI_API_KEY=your_key_here
这套接口的用词与 TypeSafe 自家的略有出入:是/否类型在这里叫 boolean,对应的答案字段是 probability。Choice 和 Score 则沿用原名。
import { experimental_evaluate as evaluate } from 'ai'
import { typeSafeAi } from '@ai-sdk/typesafe-ai'

const result = await evaluate({
  model: typeSafeAi.evaluationModel('jev-latest'),
  state: { message: 'I was charged twice. Please refund the extra charge.' },
  questions: {
    department: {
      type: 'choice',
      instructions: 'Which team should handle `message`?',
      criteria: {
        billing: 'Payments and refunds',
        support: 'Everything else',
      },
    },
    requests_refund: {
      type: 'boolean',
      instructions: 'Is the customer asking for money back?',
    },
  },
})

console.log(result.answers.department.choice)
console.log(result.answers.requests_refund.probability)
经由 AI Gateway 时,你可以跳过 provider 包,直接传入字符串形式的模型 ID。只要设置了 AI_GATEWAY_API_KEY,字符串默认就会通过 Gateway 解析:
const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: {
    refunded: {
      type: 'boolean',
      instructions: 'Was a refund issued?',
    },
  },
  providerOptions: {
    gateway: { zeroDataRetention: true },
  },
})
zeroDataRetention 是 Vercel Pro 和 Enterprise 套餐可用的 Gateway 选项。它会阻止 Vercel 与所选 provider 在处理完成后保留提示词和输出,也不允许将其用于提示词训练。但请求本身仍会经过 Vercel 和 TypeSafe。TypeSafe 的直连服务只对企业客户提供 ZDR(零数据保留),所以不要想当然地认为直连 SDK 里也有同样的选项。
关于这条集成路径,还有两个细节。其一,TypeSafe 单独提供的 confidence 统计值不在 result.answers 里,而在 result.providerMetadata.typesafe.confidence,以问题 ID 为键。其二,experimental_evaluate 也能配合 OpenAI、Anthropic 和 Google 的模型使用(同样经由提示它们输出结构化结果的适配器),这便于你在自有标注数据上把 Jev 与 LLM 逐项对比。不过这类适配器不返回概率分布,SDK 也不承诺其布尔概率经过校准,所以可比较的维度只有准确率、成本和延迟,而非置信度。
两种集成方式都必须在服务端运行。TypeSafe 直连 SDK 默认禁止在浏览器中使用,因为把 API 密钥放进客户端 JavaScript,等于把它公之于众。
一次问完所有问题
这个习惯会改变你用 Jev 做设计的方式,也是编码智能体最容易出错的地方。
相比 Jev,通用 LLM 调用通常更慢、更贵,所以工作流往往先问一个问题,再决定下一个问什么。而在 Jev 这里,同一次请求中的每个问题都基于同一个 state 并行运行,每个额外问题只消耗它自己的 token。因此,凡是你可能用到的独立问题,都应放进同一次调用——包括那些只对部分输入才有意义的答案——再由你的代码决定取用哪些。
TypeSafe 把这称为推测性扇出(speculative fan-out)。在一份 cookbook 中,把 13 个问题打包进一次调用,比 13 次顺序调用便宜 12.2 倍、快 10 倍。这项测试用的是 jev-1.12 和一个 53,777 字符的文档,所以节省主要来自“长 state 只发送一次”。若把那些单独调用并发执行,延迟差距会缩小,但多出的输入成本依然省不掉。重复测试表明,除正常的采样噪声外,批处理不会影响答案。
下面是用一次请求完成的客服工单分流。Bug 严重度只在工单是 bug 时才有意义,退款问题只在涉及账单时才需要关心——但我照样全部问出来:
import { choice, noul, score, TypeSafeClient } from '@typesafe-ai/sdk'

const client = new TypeSafeClient()

const TRIAGE = {
  category: choice('What kind of ticket is `ticket`?', {
    bug_report: 'Something is broken or behaving wrong',
    billing: 'Charges, invoices, refunds, subscriptions',
    feature_request: 'Asks for something that does not exist yet',
    other: null,
  }),
  bug_severity: score('If `ticket` reports a bug, how severe is it?', [
    'Cosmetic; no impact on functionality',
    'Broken or degraded feature, but a workaround exists',
    'Blocking issue; no workaround exists',
  ]),
  has_repro_steps: noul('Does `ticket` include steps to reproduce a problem?'),
  refund_requested: noul('Does `ticket` ask for money back?'),
  frustration: score('How frustrated is the author of `ticket`?', [
    'Calm, just stating facts',
    'Frustrated but civil',
    'Very angry, strong language, or threatening to leave',
  ]),
}

export async function triage(ticket) {
  const { answers } = await client.systemOne({
    state: { ticket },
    questions: TRIAGE,
  })

  const { category, bug_severity, has_repro_steps, refund_requested, frustration } = answers

  if (category.confidence < 0.6) {
    return { route: 'human', reason: 'unclear category' }
  }

  if (category.choice === 'bug_report') {
    if (bug_severity.score > 1.5 && has_repro_steps.noul > 0.6) {
      return { route: 'engineering', priority: 'high' }
    }
    return { route: 'bug_backlog' }
  }

  if (category.choice === 'billing') {
    return { route: 'billing', refundLikely: refund_requested.noul > 0.7 }
  }

  if (category.choice === 'feature_request') {
    return { route: 'product' }
  }

  return { route: 'human', flag: frustration.score > 1.5 }
}
一次调用,就为这棵决策树备齐了代码所需的全部信息。当工单是功能请求时,bug_severity 会被忽略——它确实消耗了输入 token,但共享的 state 只发送了一次。
注意,所有问题都集中在一个常量里,各项阈值也在同一个文件中一目了然。评审这段代码时,你需要读的就是这些问题和这些数字。
那么,什么时候才真的需要第二次请求?只有当代码在拿到第一个答案之前无法构造它的时候:比如要为 state 补充更多数据,或者第一个答案决定了下一个问题该提供哪些选项。TypeSafe 的技能推荐 cookbook 就是个好例子:第一次请求为 182 个技能排名,第二次请求再查看前三名的全文,并可能将它们全部否决。如果第二次请求的问题本可以针对原始 state 提出,那就把它们并入第一次。
在代码中组合决策
第二个习惯:当一个判断依赖多重因素时,不要问一个大问题,而是每件事各问一个问题,再用你自己掌握的权重把答案组合起来。
工单优先级就是好例子。它取决于 bug 有多严重、客户有多恼火,以及报告给工程师留下了多少可用信息。三个 Score,一次请求:
const PRIORITY_QUESTIONS = {
  severity: score('How severe is the issue in `ticket`?', [
    'Cosmetic; no impact on functionality',
    'Broken or degraded feature, but a workaround exists',
    'Blocking issue; no workaround exists',
  ]),
  frustration: score('How frustrated is the author of `ticket`?', [
    'Calm, just stating facts',
    'Frustrated but civil',
    'Very angry or threatening to leave',
  ]),
  report_quality: score('How much does `ticket` give an engineer to work with?', [
    'No detail; just says something is broken',
    'Names the feature but no steps or environment',
    'Steps to reproduce or environment, but not both',
    'Steps to reproduce and environment',
  ]),
}

function normalized(answers, id) {
  const topLevel = PRIORITY_QUESTIONS[id].criteria.length - 1
  return answers[id].score / topLevel
}

export async function priority(ticket) {
  const { answers } = await client.systemOne({
    state: { ticket },
    questions: PRIORITY_QUESTIONS,
  })

  return (
    0.6 * normalized(answers, 'severity') +
    0.3 * normalized(answers, 'frustration') +
    0.1 * normalized(answers, 'report_quality')
  )
}
三条刻度的长度并不一致(三级返回 0 到 2,四级返回 0 到 3),所以每个分数在加权前先除以自身的最高等级号。这样一来,severity 上 0.6 的权重才真正意味着:严重度的分量是挫败感的两倍。
当排序结果与团队会做出的判断不符时,你只需改一个系数重跑,而不必重写提示词。这正是这个模式(TypeSafe 称之为组合评分,composite scoring)的全部吸引力所在。
第三个模式是意图路由(intent routing),也是大多数早期实验最终落脚的地方。并非所有请求都需要同一个处理器:有些查一次数据库就能答,有些需要加载对应上下文的 LLM,还有少数必须交给人工。Jev 坐在最前面,充当那个便宜、快速的分类器,来决定走哪条路:
const { answers } = await client.systemOne({
  state: { message },
  questions: {
    intent: choice('What does the author of `message` want?', {
      order_status: 'Where is my order, has it shipped, tracking',
      product_question: 'How a product works, compatibility, specs',
      return_exchange: 'Return, exchange, or replace an item',
      complaint: 'Unhappy with service or product, wants a resolution',
    }),
    needs_reasoning: score('How much thought does a good answer to `message` need?', [
      'A lookup or a one-line fact',
      'A short explanation using product knowledge',
      'A judgment call with trade-offs or an unhappy customer',
    ]),
  },
})

if (answers.intent.confidence < 0.5) {
  return routeToHuman(message)
}

switch (answers.intent.choice) {
  case 'order_status':
    return lookupOrder(message) // no LLM involved
  case 'product_question':
    return answerWithLLM(message, PRODUCT_CONTEXT)
  case 'return_exchange':
    return answerWithLLM(message, RETURNS_CONTEXT)
  case 'complaint':
    return answers.needs_reasoning.score > 1 ? routeToHuman(message) : answerWithLLM(message, COMPLAINT_CONTEXT)
}
订单查询完全不碰 LLM,两个意图带着不同上下文进入 LLM,投诉则借助第二个分数在 LLM 与人工之间做取舍。昂贵的资源,只服务于真正需要它们的请求。
同样的形状也可以充当智能体内部的模型路由器:问 Jev 一条消息需要多少推理、符合哪种画像,然后据此选择便宜模型或昂贵模型。有人提出的一个迁移方案,就是把现有的路由提示词精简成了这两个 Jev 问题。
写出让 Jev 答得好的问题
用 Jev 的功夫,大半都在问题上。以下内容来自官方文档、控制台自带的课程,以及人们在发布头几天踩过的坑。
每个问题只求一个判断。“这条消息是否传达了紧迫感?”是个好问题;“分析这条消息并决定最佳行动方案”就不行——它把好几个判断藏在了一个答案背后。如果一个问题需要展开推理,或要权衡多个互相独立的因素,就把它拆开。
把条件写精确。Jev 回答的是你写下的问题,而不是你心里想的问题;限定词、否定和隐含条件,它都按字面理解。当你盯着一个错误答案,忍不住要解释“我其实想问的是……”时,那句解释就是这半句缺失的指令。
在 criteria 里,描述情境而非程度。对 Choice 选项,说清它包含什么、相邻选项又包含什么;对 Score 等级,描述一个具体的情境状态。当模型在你认为十分明确的输入上反复落在两个相邻等级之间时,就给每个等级配一个对象,包含一段描述和几个示例情境,并让所有等级使用相同的字段名,以便模型做同类比较:
{
  "what": "Broken or degraded feature, but a workaround exists",
  "examples": ["export fails in one browser but works in another"]
}
文档在一个 Safari 导出 bug 上验证过这一点:纯字符串的等级给出 1.30 分、0.54 置信度;同样的等级加上一个贴切示例后,变成了 1.07 分、0.90 置信度。而换成一个不相干的示例,几乎毫无变化。示例只有在与你真实输入相似时才有帮助。
给模型留一条退路:凡是可能覆盖不全所有输入的 Choice,都加一个 other 选项;凡是抽取可能缺失的信息,都加一个“未说明”(not stated)选项。让 instructions 和 criteria 口径一致,用同事第一遍就能读懂的平实语言——一旦指令问的是一回事、criteria 描述的却是另一回事,答案质量就会下滑。
数字、日期和计数,一律留在代码里做。下一节会解释原因。
最后是围绕问题的两个代码习惯。其一,把每个问题和每个阈值放进同一个文件,因为它们是整个集成中最需要人来评审的部分。其二,在信任某个阈值之前,先用带标签的样本测试:在大量预测中,更高的置信度应当与更高的准确率相关,但它并不保证某个具体答案正确。取一组你已知答案的输入跑一遍,看置信度与准确率在哪里出现分歧。有个早期测试在写定评分标准(rubric)之后,11 个发票用例全部判断正确——这个顺序(先写评分标准)与文档中的一切做法都吻合。
Jev 在哪些地方会失灵
TypeSafe 为每个模型版本发布一个名为“参差性”(jaggedness)的页面,列出 jev-1.13 做不好的事情。以下是页面内容,附上每一条的应对办法。
字面化解读——前文已有提及:模型读的是你的字面用词,不是你的意图。要么写得足够明确,要么把“解读”拆成两个字面问题。
数学。Jev 不是计算器。它数数并不可靠:无论是一个词里有几个字符、某个词出现了几次,还是列表里有多少条目。给它十六进制颜色值,它分辨不出两个颜色是否相近——问具名颜色有效,问 #FF4B0A 就不行。算术请在代码里完成,再把结果或一个具名分桶传进去。
如果需要统计符合某个语义条件的条目,那就给每个条目问一个 Noul,在代码里求和:
const items = ['typesafe', 'apple', 'california', 'banana', 'orange']

const questions = Object.fromEntries(
  items.map((_, i) => [`item_${i}`, noul(`Is \`items[${i}]\` the name of a fruit?`)])
)

const { answers } = await client.systemOne({ state: { items }, questions })

const fruits = items.filter((_, i) => answers[`item_${i}`].noul > 0.5)
console.log(fruits.length) // 3
Score 也不是测量仪。不要拿 1.4 的分数去还原“客户在从恼火到愤怒的路上走了 40%”,因为各等级之间的数值校准本身就很弱。分数应当只用于过阈值或排序,不要用来插值出幅度。
日期和时间也有同样的毛病。Jev 把日期当文本读,于是两个日期孰先孰后、相距多远、是否落在某个时间窗内,通通不可靠;格式混用或出现相对指代时,更是如此。正确做法是拆分任务:抽取属于判断,交给模型——做成覆盖月、日、年的 Choice,并带一个“未说明”选项——然后在代码里构造真正的日期,在代码里做比较。
间接性会损失准确率。双重否定、属性的属性,任何需要多次跳转才能到达的信息,都是如此。请直接指向 state 的相关部分,就事论事地问。
臃肿的 state 同样损失准确率。先做过滤。当无法确定性地过滤时,就对每个数据块(chunk)用一个 Noul 问一句“这与问题相关吗?”,在正式提问之前把无关部分丢掉。
带类型的输出,并不保证路由正确。Choice 总能返回一个允许范围内的目的地,同时却把请求送错了地方。所以要把模型、问题、criteria 和阈值作为一个整体来做版本管理。保留一组带预期答案的代表性输入,每当其中任何一环发生变化,就重放一遍。
state 会被当作数据处理,写给模型看的操纵性文本足以移动答案。TypeSafe 表示,预计会在对抗性内容上持续改进。眼下能做的:把 criteria 写精确,并在交给公众之前,先用恶意输入测试一遍。
instructions 与 criteria 相互矛盾——比如一个 true 意味着“否”的 Noul——会让答案变差。保持二者一致。
最后,它不会写作。理论上你确实可以通过链式 Choice 逐字符逼它吐出文本,但文档直言不讳:这又慢又差。如果你要抽取一个值,正确做法是先用正则或 LLM 找出候选,再让 Jev 从中挑出正确的一个。
最后这条引出一条有用的规则:用 Jev,你是从牌堆里挑一张牌,而不是让它凭空报出一张牌。每当你的直觉说“抽取 X”,就把它改写成:“这里是 X 的几个候选,是哪一个?”
人们正在用它做什么
写这篇文章时,Jev 才发布几天,所以以下都是早期实验,而非生产环境的案例研究。但它们依然能展示人们正在尝试的任务范围。
给数据打标签
这是最显而易见的用途,也是人们最先想到的一个。一个早期 demo 把 1,018 篇经过摘要的 AI 研究论文分入 24 个主题,只花了 0.08 美元,每篇论文的延迟中位数为 256 毫秒——而用 LLM 生成那些摘要,反倒花了 3.99 美元。另一项早期测试在十分钟内跑完了 98,000 条房源分类。还有一份报告称,50 万输入 token 只花了约两美分,与公布价格相符。凡是“给每一行打标签”形状的任务,都适合交给它。
简历筛选是加了评分标准的同款形状:这份简历与这个职位匹配吗——作为一个 Score。某招聘网站的早期对比报告称,这项工作的成本约为小型 LLM 的十分之一。控制台也把简历筛选列为内置示例之一。
收件箱分流的形状也一样:优先级、是否垃圾邮件、是否需要回复,每封邮件一次调用。它快到你可以亲眼看着整个邮箱被逐封分类完毕。
路由与验证
意图路由与模型路由是被提及最多的用途之一:在客服流程或智能体之前放一次 Jev 调用,决定把消息交给哪个处理器、哪个模型。
验证则是它的另一面。有人提出了这样一个工作流:某播客网站已经在用 LLM 生成剧集摘要,接下来用一个 Noul 对照文字稿核查每一条论断,并标记低概率的答案。LLM 负责写,Jev 负责查,由代码决定哪些论断需要复核。
代码评审也套用同一个模子:对 PR 里每个被修改的文件,用几个 Score 和 Noul 评估安全风险、复杂度、坏味道和提交信息的质量,最后在代码里合成一张风险矩阵。
TypeSafe 自家的 cookbook 则把触角伸向检索领域:用“每个查询-段落对配一个 Noul”的方式为 BM25 候选列表重排序;在检索到的段落送进回答模型之前,为相关性和隐藏的提示词注入(prompt injection)打分;核查引用的文献是否真的支撑它所附着的论断。
实时界面
一次调用只需几百毫秒,因此 Jev 可以在每一次停顿时运行。有个编辑器 demo 在用户打字时实时给语气、信念感、紧迫感和“读起来像 AI 写的”打分,评判标准由开发者自定义,而非某个固定检测器。
一个浏览器扩展对社交信息流中的每条帖子询问 Jev:它是激怒型内容(rage bait)、加密货币推广,还是政治争论?然后隐藏得分高的那些。与平台的固定过滤器不同,这个版本允许用户自定义类别。
游戏领域也很早就出现了它的身影。一个俄罗斯方块 demo 反复调用 Jev,在旋转、移动和下落之间做选择;一个驾驶模拟器传入结构化观测数据,询问该加速、刹车还是转弯。TypeSafe 的发布 demo 里包括一个基于结构化游戏状态运行的 Doom 机器人,约每秒十次查询,团队估算成本约为每小时 7 美元;还有一个 Wikiracing 机器人,每一步都在数百个链接中做选择,而且从不选中不存在的链接。
一个吃豆人(Pac-Man)demo 让这个循环变得直观可见:每走到一个格子,应用就发送附近的游戏状态,Jev 返回一个方向、一个策略、一个危险分数,以及 trapped(被困)、committed(已定路线)之类的标志位。代码移动角色,然后发送下一个状态。
其他早期 demo 把这套思路应用到了魔方、一门实验性编程语言、自然语言数据库搜索、浏览器与操作系统控制、语音转文字清理、欺诈检测,以及抓取内容的分类上。这些例子表明这个原语的应用面之广,但它们并不证明每个 demo 都已达到生产可用。
智能体与工具
有一个聊天机器人 demo,完全没有使用生成式 LLM。它把可用工具交给 Jev,用 Choice 问出“哪个工具能回答用户的最后一条消息?”,并在同一次调用中带上参数问题:哪个城市、哪个时间范围、哪个单位,每个都是在对话中找到的候选之上的 Choice。随后由代码调用选中的工具。这个 demo 靠一句平实的自然语言,在约 300 毫秒内端到端地关掉了一盏智能家居灯。它还回答了“雷尼尔山有多高?”——办法是抓取维基百科,再让 Jev 指出包含答案的那句话。
浏览器自动化采用了类似的分工:规划 LLM 负责确定目标,Jev 负责从实时页面的可交互元素中,用 Choice 选出下一步该点击哪一个。有个 demo 用约七秒订好了一张机票。如果你见过 Playwright 驱动的智能体在两次点击之间“思考”十秒,就会明白这个数字的分量。
另一个好用的模式,是面向大型代码库的语义 linter。把改动过的代码切成块,问 Jev 每一块是否需要关注、属于什么问题、风险有多高。对结果排序后,只把优先级最高的块发给能够解释并修复它们的编码模型。
如果某个块缺少足够上下文,应用可以提供 open_file、previous_chunk、next_chunk 之类的选项。Jev 在这些已知动作中做选择,代码去获取所需的上下文,第二次评估随即从那里继续。Jev 负责找到“该看哪里”,编码模型负责动手修改。
日志是更小一点的入门项目。与其让生成式模型解释每一行,不如问 Jev:哪些条目像是预期内的噪声、被遗忘的定时任务、影响用户的故障,或是需要关注的东西。在引入人工或其他模型之前,你的代码可以先对结果分组、排序。
自然语言 PostgreSQL 搜索也需要同样的分工。我不会让 Jev 去生成任意 SQL。代码可以提供允许使用的查询模板、表、列和过滤器清单,由 Jev 选择意图与相关选项,再由代码构建参数化查询。这样,模型处理了语义,却没有取得发明数据库操作的权限。
给编码智能体加护栏,是我会最先测试的用例。智能体想运行的 shell 命令,会在执行前被判定为只读、可逆或不可逆。在一次早期影子测试中,一条含义不明的 rm -rf 以 0.56 的概率、0.33 的置信度被判为“不可逆”——正是这个 0.33,提示外层代码去求助人工,而不是轻信被选中的那个标签。
最后一个纯属好玩:创业点子评审器。描述一个点子,十个问题会在约半秒内评估它的问题、需求、变现、分发与差异化。代码把答案汇总成 kill(放弃)、fix(修补)或 ship(上线)。结果的好坏,取决于那些问题及其评分标准。
Jev 与编码智能体
TypeSafe 发布了一个智能体技能(agent skill)。在让 智能体 集成 Jev 之前,请先装上它 —— 因为在 LLM API 上训练出来的智能体,会犯同样两个错误:每次调用只问一个问题,以及凭空发明请求字段。
Claude Code 用户:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Cursor、Codex 及其他工具:
npx skills add typesafe-ai/skills --skill typesafe-ai
这个技能会把智能体引向实时文档(Mintlify 在任意文档页 URL 后加上 .md 就能以 Markdown 形式提供内容,智能体对此喜闻乐见),列出三种原语,并解释扇出与置信度门控。
TypeSafe 建议作为第一步的提示词,也是我会用的那一句:
Using the TypeSafe skill, explore the project and find opportunities for using
intelligent judgement to stand in for complex parsing or other fragile code.
在它动手写任何代码之前,先审阅它给出的方案。然后要求它把每个问题和每个阈值集中到一个文件里。智能体写问题的水平有限,你们必然要一起反复打磨。
我如何在自己的工作流中使用 Jev
我有控制台访问权限,但尚未把 Jev 投入生产。我的计划是:从自己每天都在做的决策入手,让 Jev 以影子模式(shadow mode)跑在现有工作流旁边,先比较它的答案,再让它掌控。
在启动编码智能体之前先分派任务
我用编码智能体做小型修复、长链研究、浏览器操作,以及涉及多个仓库的任务。它们并不都需要同一个模型或同一套环境。
我可以把任务、仓库名和可用智能体的简短说明交给 Jev。一个 Choice 就能选出路由,例如 deterministic_script、fast_agent、reasoning_agent、browser_agent 或 human;一个 Score 可以衡量请求的模糊程度;再来一个 Noul 检查它是否需要访问我电脑上已登录的应用。
Jev 不会自己去启动智能体。我的代码会读取这些答案,套用置信度阈值,再把任务发给我原本就在用的工作流。
给 shell 命令加一道安全检查
在编码智能体执行命令之前,我可以把命令、当前目录和少量仓库状态发给 Jev。
一个 Choice 把它归类为 read_only、reversible 或 irreversible;几个独立的 Noul 则检查它是否会删除文件、改写 Git 历史、部署到生产环境,或触及仓库之外的东西。
起初我只记录答案。等攒够足够的真实样本之后,高置信度的只读命令可以放行,而不确定的或破坏性的,仍旧来找我确认。
给赞助咨询和简报回复分类
我的赞助商表单已经通过 Cloudflare Pages Function 发送结构化提交。我可以加一个 Noul 判断这是不是真实的赞助咨询,一个 Choice 判断产品类别,一个 Score 判断请求的具体程度。
我会先把这些答案加到现有邮件里,决定仍然由我来做。如果这些标签确实有用,代码可以准备好对应的回复或价目表,但不自动发送任何东西。
收到的简报回复,则可以用同一组问题的简化版:一个 Choice 区分致谢、失效链接、提问、赞助线索和 other,让我优先打开需要回复的消息。
给 Events Logger 加上语义优先级
Events Logger 把我各个应用的事件汇集到一块仪表盘上。每个事件有项目、类别和标题,外加可选的描述与标签。
我可以加一个 Score 表示严重度,再加几个 Noul 判断事件是否描述了影响用户的故障、是否造成损失、是否需要处理。原有的信息流保持时间顺序,我则多出一个按语义优先级排序的视图。
这是很好的第一个生产测试,因为模型根本弄不坏任何东西。答案错了,改变的只是仪表盘的排序,不会碰到数据或基础设施。
在 Bootcamp 项目里试一试
Bootcamp(训练营)的项目,给了我一个讲解“决策模型该放在哪里”的好载体。我会把 Jev 设计成核心项目完成之后的可选扩展,而不是学生从第一天起就要依赖的东西。
每个项目至少有一处地方,适合让普通代码处理事实、让 Jev 处理模糊判断:
| Bootcamp 项目 |
我会问 Jev 什么 |
留在代码里的部分 |
| Personal Dashboard |
哪个现有类别最适合这个新链接? |
URL 校验、存储、编辑与排序 |
| Events Dashboard |
这个事件是预期内的噪声、影响用户的故障,还是紧急事项? |
API 认证、事件接收、搜索与图表 |
| Shared Expense Tracker |
这条支出描述该归入哪个类别? |
金额、余额、分摊,以及谁欠谁 |
| Live Chat Room |
这条消息是垃圾信息、辱骂内容,还是可能需要审核? |
认证、房间、消息投递与提及 |
| Recipe Finder |
生成的食谱是否符合要求的饮食和食材? |
食谱生成、缓存、收藏与图片加载 |
| Port Pilot |
这个进程看起来可以安全停止、状态不明,还是可能是系统服务? |
读取端口与进程、解析精确值、发送信号 |
| Recipe Finder Pro |
根据复杂度,这个食谱请求该由哪个模型处理? |
支付、订阅、权益与访问控制 |
| Your Own Product |
这个产品内部的哪个模糊判断会受益于带类型的概率? |
产品的主工作流,以及每一条确定性规则 |
Shared Expense Tracker 恰好展示了这条边界。Jev 能读懂“和 Luca、Sara 一起吃披萨”并建议归为 food,但它永远不该去计算每个人该付多少钱——那部分算术必须保持精确。
Port Pilot 需要更严格的边界。Jev 可以在进程旁边附上一个风险标签,但它不该亲手杀掉任何东西;操作系统查询、PID 校验和确认动作,都留在代码里。
对 Recipe Finder 来说,食谱仍然由语言模型生成,Jev 承担的是另一项工作:检查结果是否符合饮食要求、是否用到了用户提供的食材、是否需要再生成一次。这正好向学生展示生成式模型与决策模型如何协同。
我会把它变成每个项目都通用的小练习:
- 先完成确定性版本。
- 找出一个需要理解语义的决策。
- 在调用 Jev 之前,先写出可能的答案。
- 收集至少 20 条真实输入,并标注预期答案。
- 在不改变应用行为的前提下运行 Jev。
- 复盘错误,调整问题。
- 只自动化低风险的结果。
这样一来,每周 Bootcamp 的主题都保持完整:学生依然要学数据库、API、认证、实时数据、AI 生成、CLI 工具和产品开发。当项目需要判断时,Jev 只是他们可以顺手加上的又一个原语。
我将如何逐步推进
每个工作流,我都会走同样的流程:
- 保持现有行为不变。
- 让 Jev 在旁边跑,记录完整答案。
- 标注它的决策对与错的情形。
- 用这批数据调整问题和阈值。
- 先自动化低风险路径。
- 不确定的情形,继续交给人工或更强的模型。
我不会用 Jev 做写作与改写、转写摘要、精确算术,也不会用它处理任何以图像为输入的任务。当确定性代码已经能做出正确决策时,我也会原样保留——毕竟一个不花钱的 if,永远好过一次可能出错的模型调用。
成本与速度
价格简单明了:每百万输入 token 0.042 美元,输出免费。TypeSafe 首页将其表述为每十亿 token 42 美元——同一个数字,换了个更能说明问题的说法。
来算一笔账。在 TypeSafe 的示例中,一张客服工单连同问题约 300 token,折合每次调用约 0.0000126 美元,也就是同样规模的 10 万张工单花 1.26 美元。至于分类 98,000 条房源的成本,则取决于每条房源及其问题包含多少 token。
经由 Vercel 的 AI Gateway,公布费率同样是每百万输入 token 0.042 美元,计费方式与其他 Gateway 模型一致。
速度方面,TypeSafe 报出的端到端时间为 70 到 500 毫秒,并称大多数查询落在 100 毫秒上下。这些数字测自服务所在的美国西海岸。从意大利访问,则需要额外叠加网络延迟。相比 LLM 的 40 到 200 倍加速能否成立,取决于具体是哪个 LLM、哪类任务。
限流,截至本文写作:每秒 250,000 token、每分钟 1,200 个请求,早期访问期间动态调整。
Jev 能把 AI 账单砍掉 50% 甚至 60% 吗?
可以,但那个数字取决于负载。Jev 只压缩账单中“它能替代的那部分决策”的开销。
粗略的算式是:
总节省金额 = 分类调用占比 × 这部分调用的节省幅度
假设一家公司每月在 AI 上花 10,000 美元,其中 6,000 美元花在分类、路由、打分和验证上,而新路径的成本只有原来的 5%,那么节省就是 5,700 美元,相当于原账单的 57%。
但如果分类只占负载的 10%,Jev 就不可能把总账单砍掉 60%——就算把那部分调用降到几乎免费,最多也只能省下 10%。
这一优势在大规模场景下才真正显现。一家分析数亿条记录的公司,可能正在用通用模型对每条记录做一个小判断。把这些重复性决策转给 Jev,把前沿模型留给真正需要推理或生成输出的情形。
要度量整条管道。预处理、重试、失败请求、人工复核,以及任何仍然运行在 Jev 之前或之后的生成步骤,都要算进去。前面那篇研究论文的例子中,Jev 分类花了 0.08 美元,但准备摘要又花掉了 3.99 美元。
Jev 目前只接受文本,不接受图像、音频和视频。“资产分类”工作流需要文本元数据,或者另一个先把资产转成文本的模型——这一步同样要计入成本。
从哪里开始
去 typesafe.ai 加入候补名单;如果你有 Vercel 账号又不想等,也可以直接走 Gateway 路径。
第一个小时请使用 Playground,粘贴一条真实的客服消息、一行真实的日志、一份真实的表单提交。
然后,挑一个你的代码已经硬编码、或靠一条总是出错的正则来应付的平淡决策:路由、批准、跳过。用一个 Noul 或一个 Choice 替换它,把置信度与现有行为并行记录一周,之后才允许它真正行动。“聪明的 if 语句”这个说法很贴切——而接纳一个新 if 的方式,正是一次只加一个分支。
本文译自 Flavio Copes 的 A deep dive into Jev, TypeSafe's System One model,原文地址:https://flaviocopes.com/jev/(发布于 2026-09-17,更新于 2026-09-18),版权归原作者 Flavio Copes 所有。本译文仅供个人学习交流使用,请勿用于商业用途。
 发表于 4 天前
|
查看: 1|
回复: 0


