L8.院士
6601
0
806
近期被全网玩出花的模型叫 Jev,来自 TypeSafe——创始人 Diogo Almeida 是前 OpenAI 成员,参与过 ChatGPT 背后的指令跟随研究。
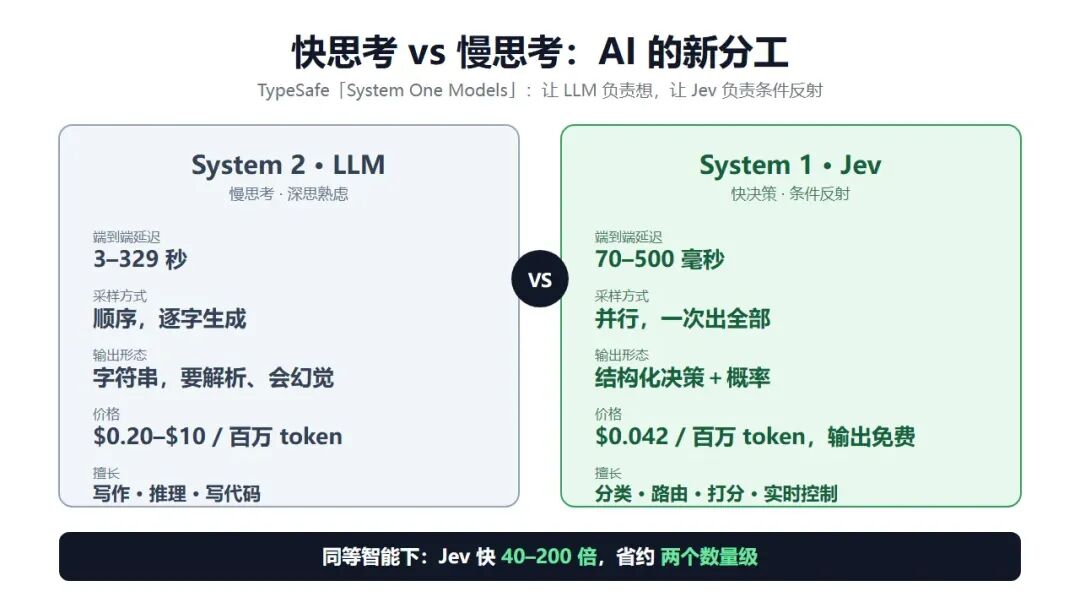
Jev 不是更强的聊天模型,而是把智能塞进代码里的那行 if——LLM 负责想,Jev 负责 reflex。
快思考 vs 慢思考:AI 的新分工
模型发布才一周,网友已经把它玩明白了。五种玩法,每一种都在打 LLM 的软肋。
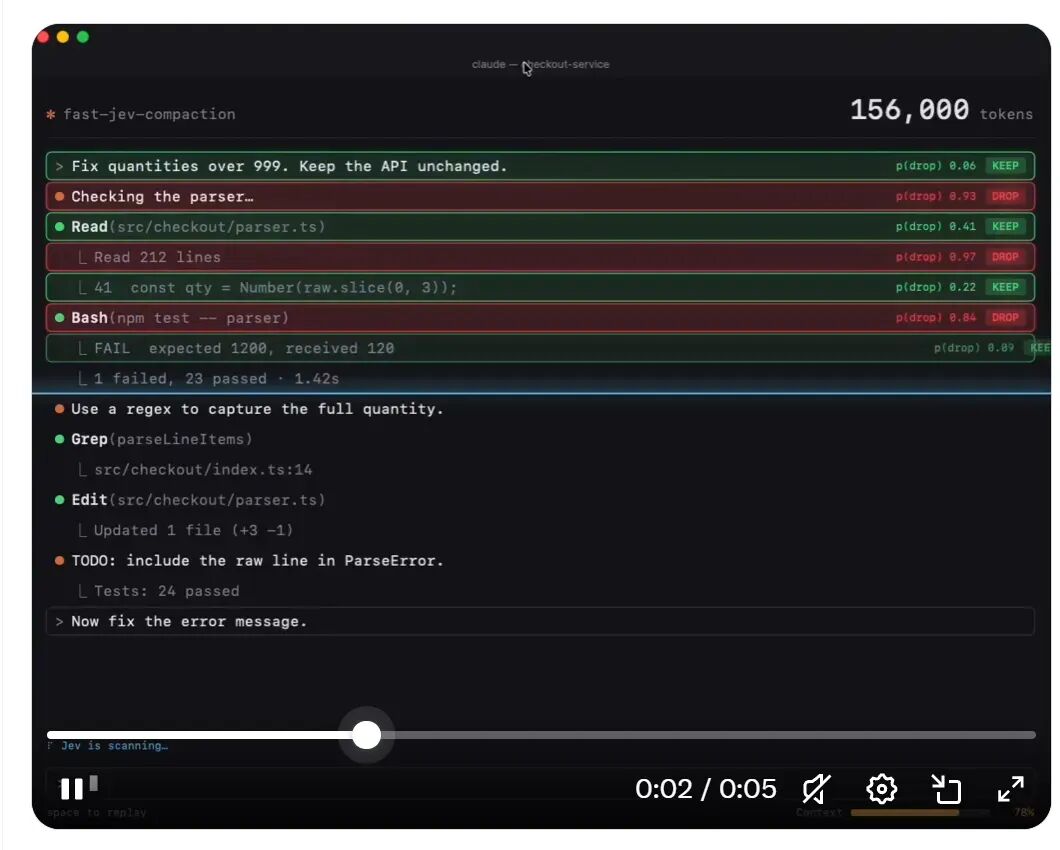
玩法一:瞬时上下文压缩。
2026 年了,为什么压缩还在靠总结 prompt?
来源:https://x.com/tamarajtran/status/2100694549362553153
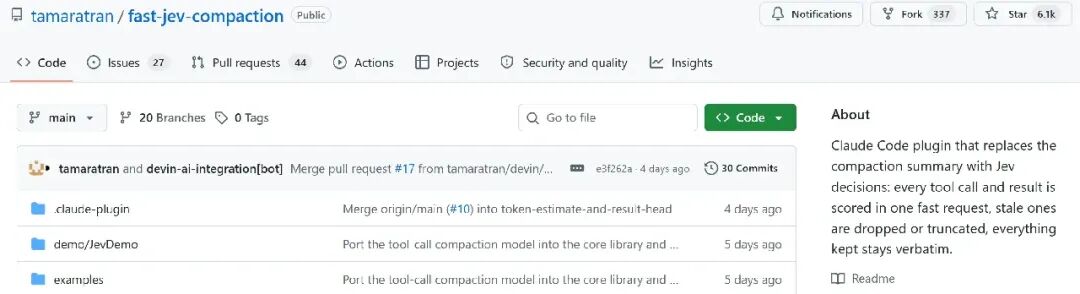
Jev 给每个 tool call 打分、丢掉无关内容,压缩从"再调一次大模型"变成"一次打分"。这是 agent 工程师每天疼的地方,所以传得最广。
来源:https://github.com/tamaratran/fast-jev-compaction
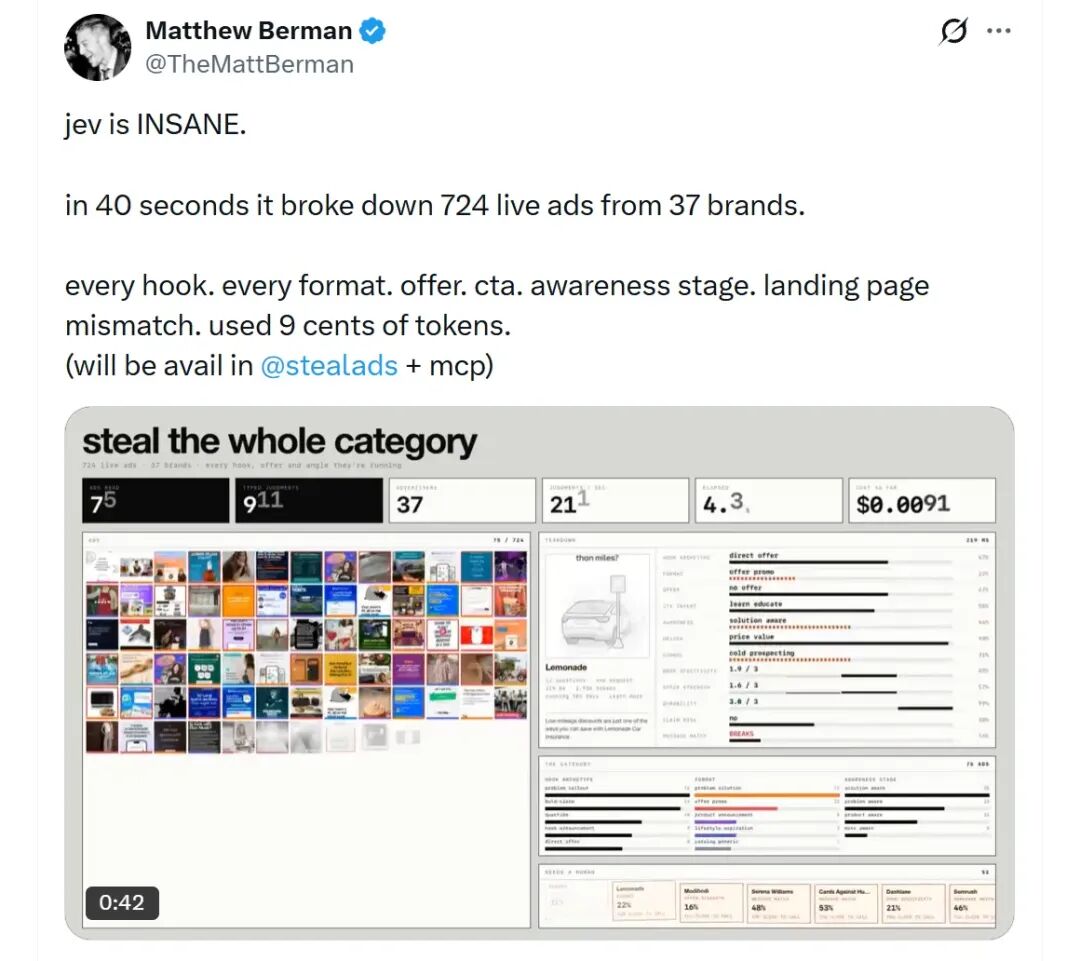
玩法二:广告情报拆解。
Matthew Berman 用它 40 秒拆完 37 个品牌的 724 条 在投广告——每一条的 hook、格式、offer、CTA、认知阶段、落地页错配,全部拆完,只花了 9 美分 token 费。
来源:https://x.com/TheMattBerman/status/2100654891756589230
这套东西即将进他的产品 stealads,还会以 MCP 形式开放。
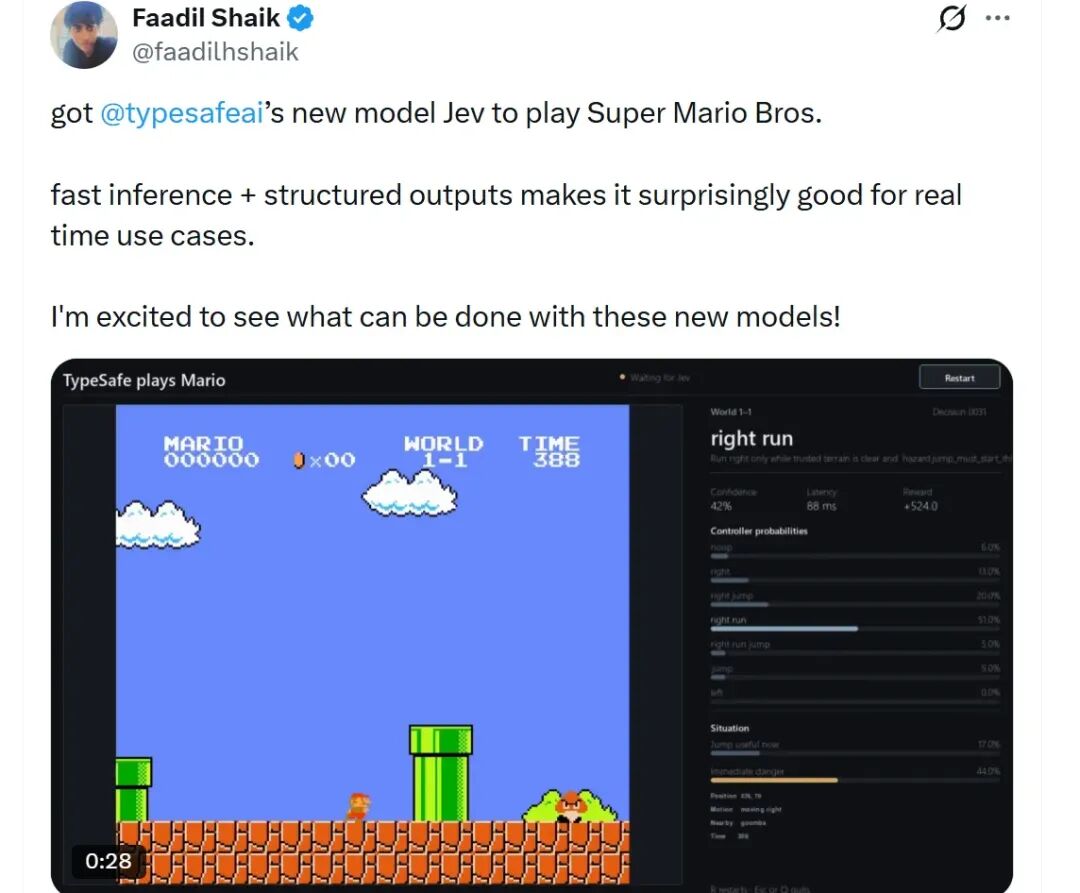
玩法三:实时玩游戏。
Faadil Shaik 让 Jev 实时玩《超级马里奥兄弟》。快推理加结构化输出,第一次把"前沿模型"够到了游戏帧率的实时决策上。
来源:https://x.com/faadilhshaik/status/2100086301894881578
已开源: https://github.com/fhshaik/typesafe-mario
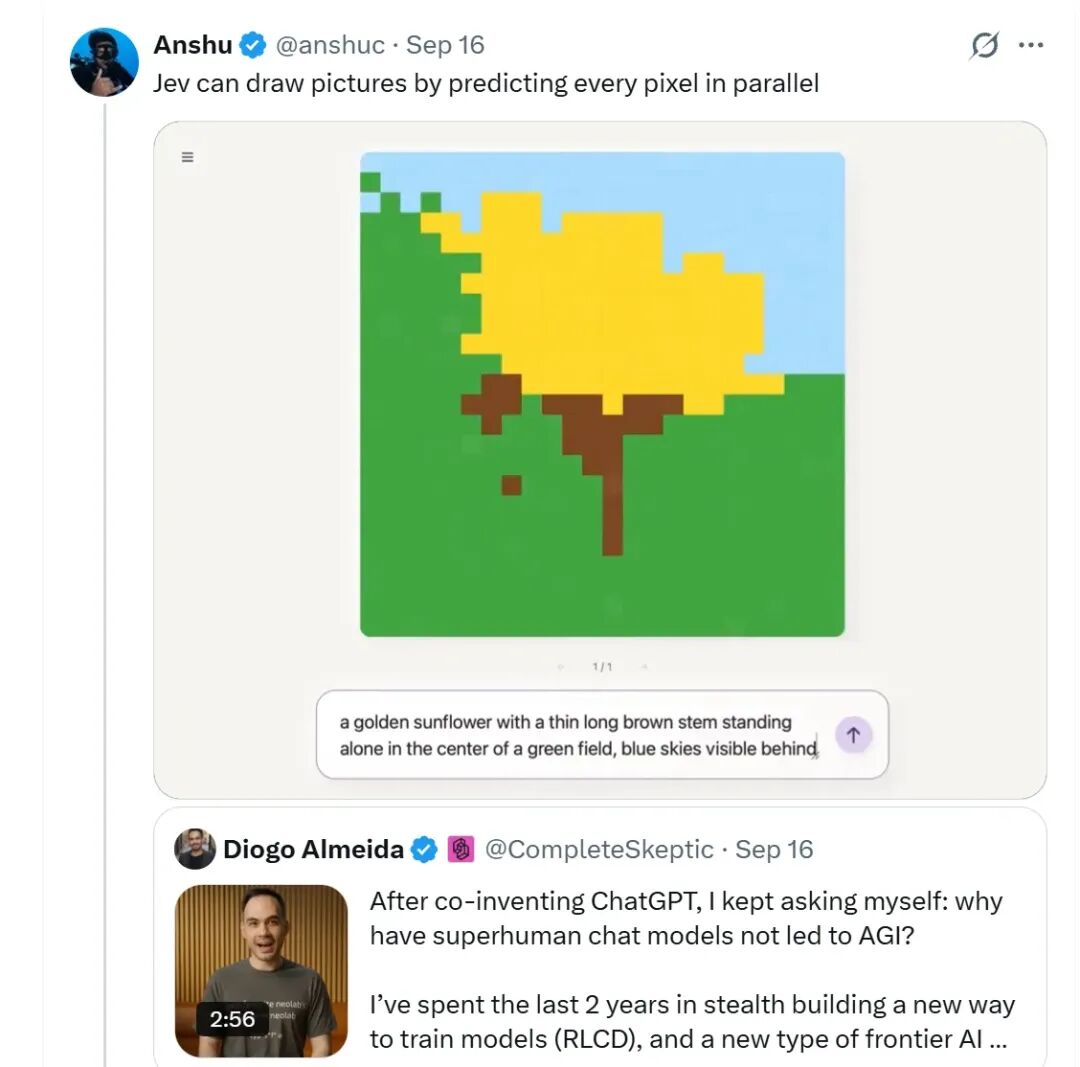
玩法四:把概率分布变成动画。
Anshu 做了个图像逐像素点亮的加载动画。像素点亮的顺序不是随便闪的——是按 Jev 输出的概率分布随机采样。有人问这跟取最高概率有啥区别?作者说试过,质量没差别:分布本身就是信息。
来源:https://github.com/fhshaik/typesafe-mario
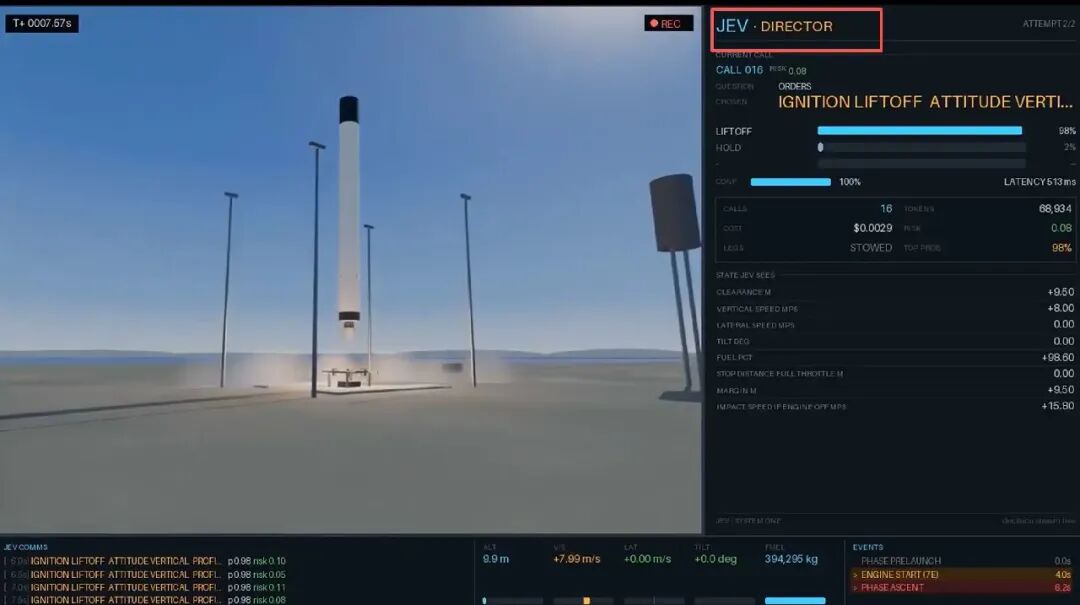
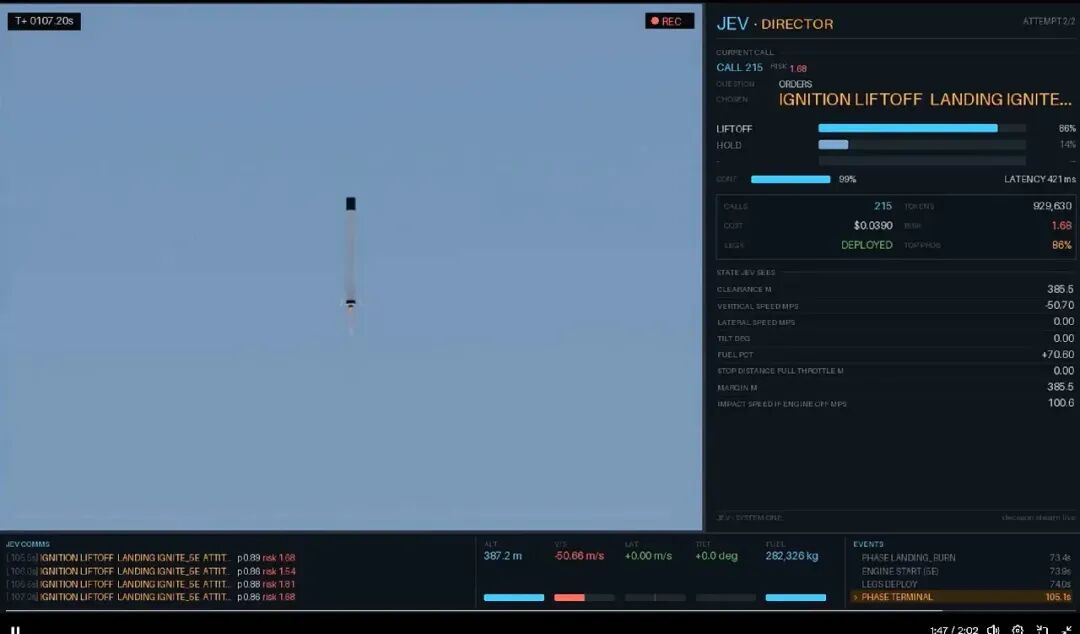
玩法五:回收火箭。
最后一个最疯:在 MuJoCo 里搭了一枚猎鹰 9 级火箭——42 米、425 吨、9 台发动机、真实大气、马赫数相关阻力、侧风、推进剂耗尽,然后无自动驾驶、无预设轨迹、无安全否决代码,所有决策全交给 Jev。
飞行器每 0.8 秒失稳一次,Jev 以约 1 Hz 频率做决策、单次输出 0.4 秒,着陆点火自己选了 5 台发动机。12 次实验之后,它自主把助推器落了地——全程 245 次调用,API 费 4 美分。
来源:https://x.com/uttkarsh_42/status/2100690568947159309
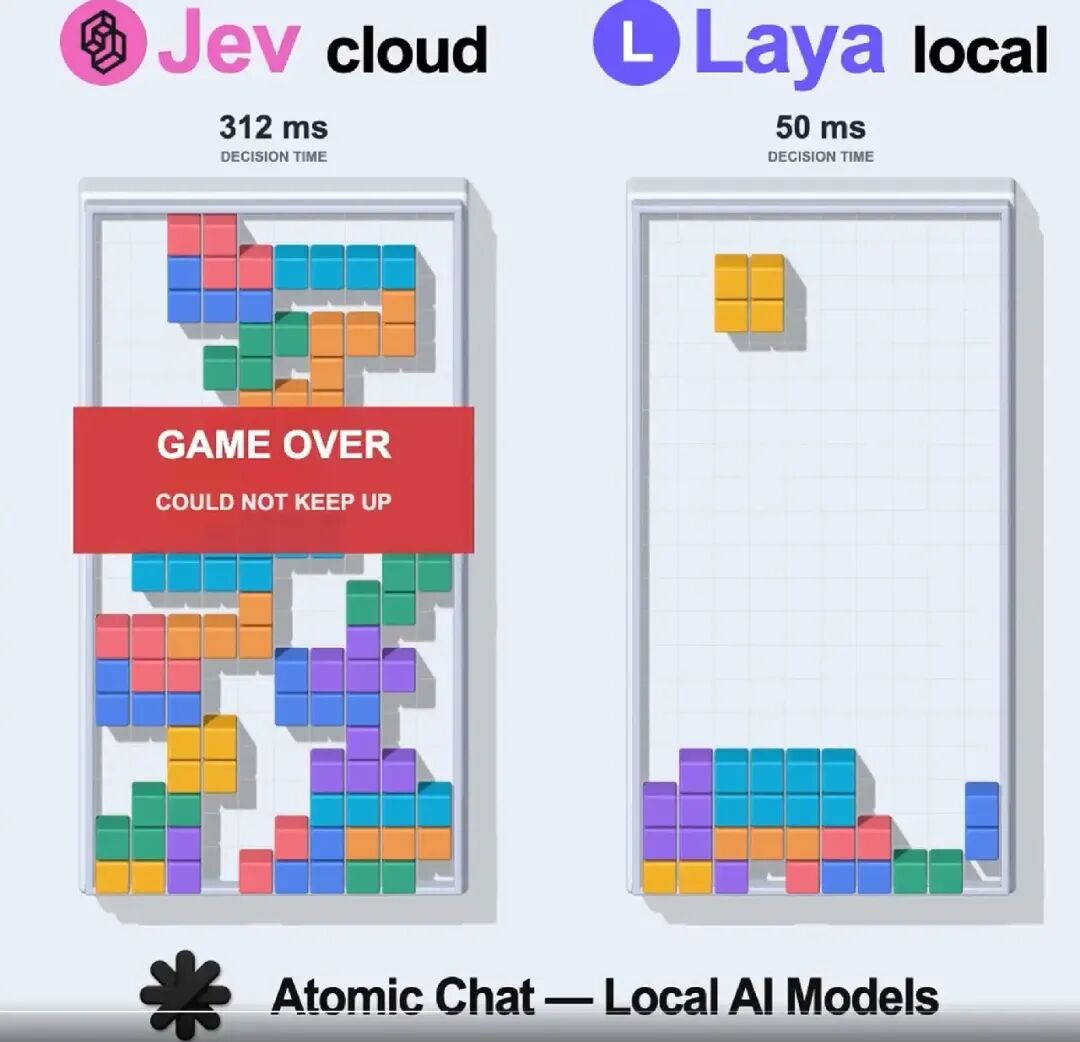
有人撇嘴:"这不就是个分类器吗?" Utkarsh 的回应值得整段抄:是的,但它是个非常好用的分类器——它的速度和决策质量,给真实世界的任务打开了一整扇新门。Jev 赢的不是智能上限,而是智能的价格和延迟。 同样的智能,便宜两个数量级、快两个数量级,能干的事就完全不是一回事了。
Jev 这个名字,来自经济学家杰文斯——就是那个"杰文斯悖论":煤越便宜,烧煤的生意反而越大。作者的原话类比是:智能成本每降一个数量级,解锁的新用例多更多个数量级。
来源:https://x.com/atomic_chat_hq/status/2102160983409955244
火箭和马里奥都只是玩具 demo。真正的量,藏在千万行代码里那些"聪明的 if"——以前用 if-else 写太蠢、调 LLM 又太贵的模糊判断,第一次有了第三选项。
LLM 负责想,Jev 负责 reflex。两个大脑各干各的——这才是 Jev 该有的玩法,也确实是赢麻了。这类一手玩法在云栈社区还有不少开发者在持续跟进。
收藏0回复 显示全部楼层 举报
发表回复 回帖后跳转到最后一页
查看 »
手机版|小黑屋|网站地图|云栈社区 ( 苏ICP备2022046150号-2 )
GMT+8, 2026-11-9 22:34 , Processed in 0.067493 second(s), 43 queries , Gzip On.
Powered by Discuz! X3.5
© 2025-2026 云栈社区.
 发表于 2026-9-23 01:09:56
|
查看: 167|
回复: 0
 /1