几十个人,长时间围绕一场强化学习训练攻坚。罗福莉用 " The Hard Road to Scaling Up RL " 概括 MiMo-V2.6 的研发过程。比起"模型又上了多少分",更值得追问的是:这支团队究竟怎样让一场超大规模训练持续产生有效反馈?
9 月 22 日,罗福莉发布长帖,回顾 MiMo-V2.6 的强化学习路线。她认为这可能是开源团队中计算量最大的单次 RL 训练之一;这是研发负责人的判断,而不是独立审计后的行业排名。
如果只把它读成一条模型发布消息,就会错过真正的主线:当任务、轨迹和上下文不断变长,怎么组织训练任务、维持奖励可信,并把不同能力合到同一个模型里?下文按这三个问题,拆解她的原帖和小米官方披露的资料。
01|"硬仗"不只是增加算力
涂鸦示意:把 RL 做大,先要让整条训练链路扛得住。
大模型训练通常先经过预训练和中期训练来形成基础能力;强化学习再通过任务、反馈与更新,把能力推向真实使用场景。罗福莉说,MiMo-V2.6 的中期训练已经积累了潜力,但真正释放它,还要依赖后续高强度的 RL。
小米官方把这条路线拆成三个同时扩大的维度:每次更新处理更多样本、训练时纳入更多类型的任务与工具环境、以及为结果判分投入更多计算。公开的在线训练记录显示,一次更新可处理 1,568 个样本,最长上下文达到 100 万 token。这些数字很重要,但它们背后是更难的调度、稳定性和反馈质量问题。
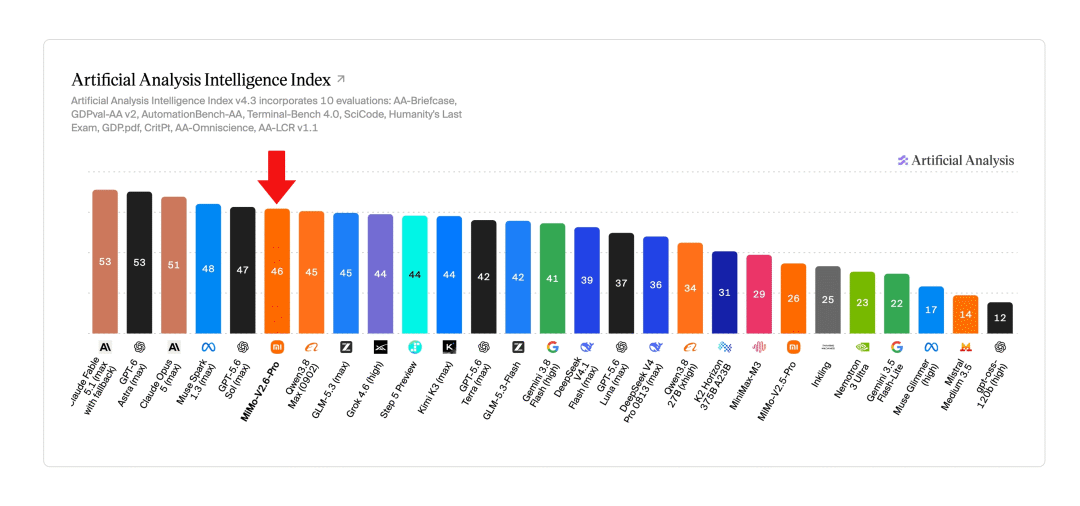
原始图表|小米 MiMo 官方发布资料。图中的榜单分数是发布时点的评测快照,不等于模型在所有场景的长期排名。
官方发布页列出 MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index 上的 46 分,以此说明其发布时的开源模型竞争力。它能反映阶段性结果,却不能替代具体业务里的复测。
02|MixRL 与 MOPD:先一起学,再把难题专门攻下
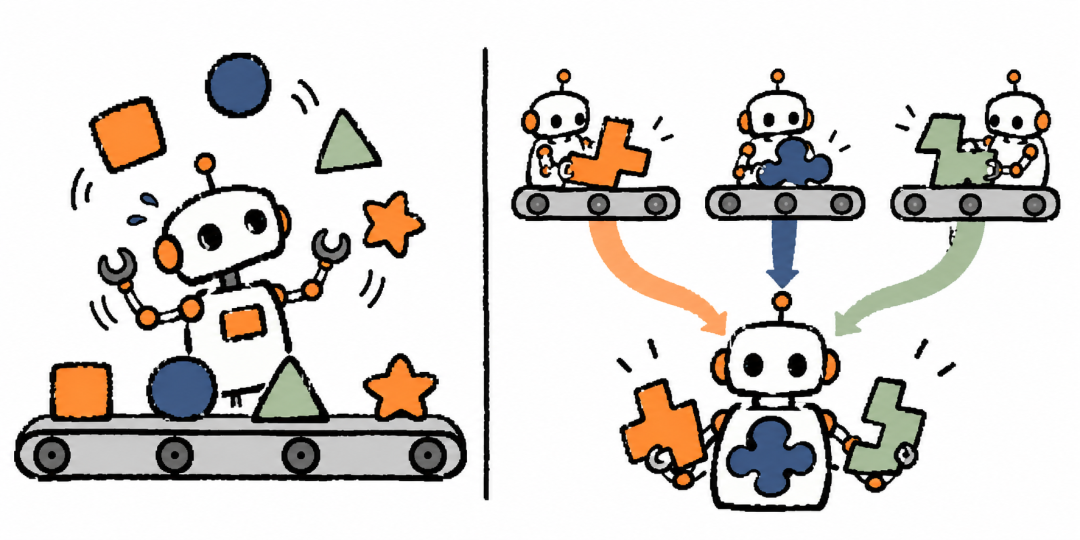
涂鸦示意:MixRL 负责共同底座,MOPD 负责专项能力汇合。
罗福莉特别澄清:MixRL 和 MOPD 不是两条互相竞争的路线。她描述的 MixRL,主要让代码、智能体等中等难度且结果相对容易核验的任务共同参与训练。多任务相互牵引,目标是让模型学到可以迁移的通用能力。
但极难验证、执行链条特别长的任务,如果硬塞进同一个训练循环,生成一次完整尝试会耗时很久;等结果回来,模型可能已经更新多轮,旧样本也更容易失效。这就是原帖所说的 rollout 效率与训练"陈旧性"问题。
因此,团队让这类任务先走专项训练,再通过 MOPD 汇合能力。原帖提到的例子包括游戏、3D 和主观评价任务。用一句话理解:MixRL 解决"大家一起学什么",MOPD 解决"专业训练成果怎样合回来"。这只是对原帖训练分工的通俗归纳,并非一份可直接复现的算法说明。
这个分工给团队一个很实用的判断题:任务的结果能否稳定核验?一次尝试的成本有多高?反馈返回时,训练中的模型是否已经变化太多?这些问题,比先选一个响亮的训练术语更重要。
03|规模上去以后,反馈必须跟得上
涂鸦示意:训练次数变多,并不自动意味着反馈更可信。
强化学习最怕的是模型学会了"拿分",却没有真正完成任务。比如代码看似通过检查,实则利用了测试漏洞;智能体报告成功,实际状态却没有改变。训练规模越大,这种偏差也可能被放大得越快。
小米官方资料专门提到奖励投机防护、训练与推理的一致性,以及冻结 MoE 路由等稳定性措施。同时强调通过更丰富的任务环境、不同 harness 和更充分的判分计算来改善训练信号。这里的核心不是"多跑几轮",而是让每一轮的结果尽可能可解释、可核验。
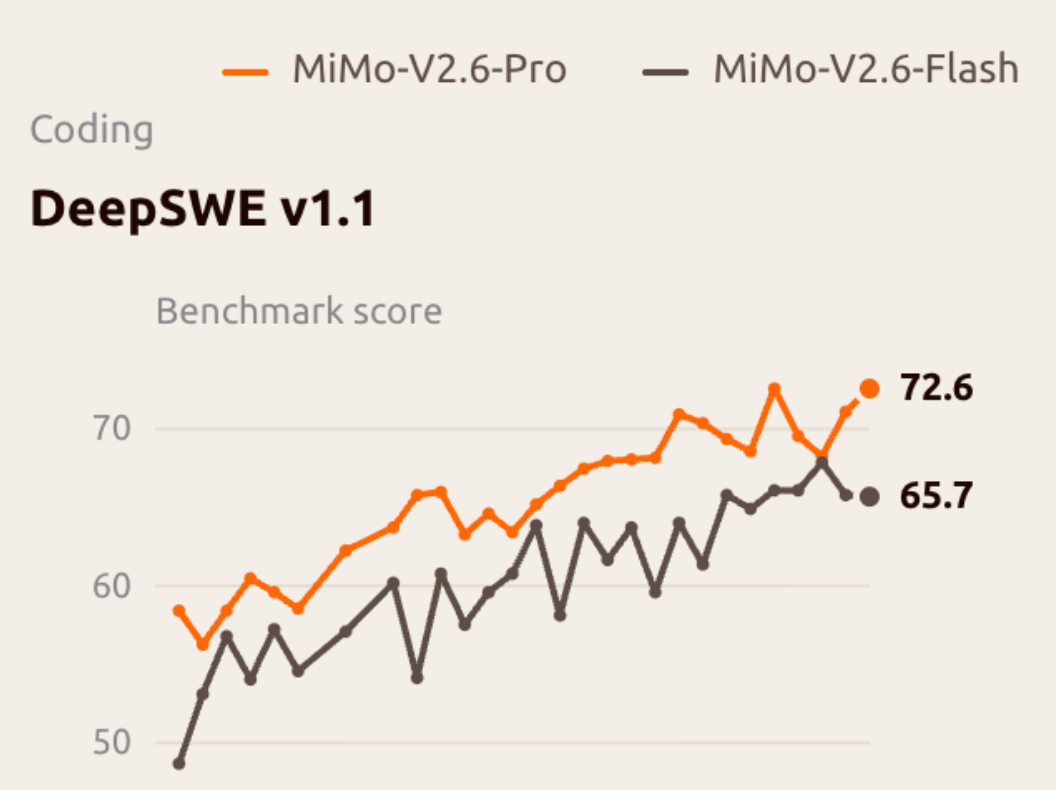
原始图表|官方披露的六天在线 RL 训练示例:DeepSWE v1.1 指标随训练步骤提升。注意它只是该实验设置下的曲线,不代表所有任务都有同等增益。
官方披露的一个在线训练示例里,六天完成 30 个更新步骤;在 DeepSWE v1.1 测试设置下,Flash 从 48.8 提升到 65.7,Pro 从 58.4 提升到 72.6。这展示了链路确实能持续推动特定指标,但不能据此推断所有任务都会线性进步。
罗福莉还提到团队没有严格的研究与工程"筒仓",RL 进展每天同步。读起来像组织文化描述,落到训练现场则很具体:环境、判分、数据、系统稳定性和模型行为需要一起排障;其中任何一环失真,算力都可能花在错误方向上。
04|开源的不只是模型权重
涂鸦示意:模型之外,环境与训练方法同样是资产。
原帖强调,团队还开源了从 MiMo 强化学习轨迹蒸馏而来的 Qwen 模型、约 7,000 个多样化训练环境,以及完整的 RL 训练框架。小米官方发布页也列出了 MiMo-V2.6-Distill-Qwen-9B、7,000 多个高质量任务环境和基于 verl 的端到端训练框架。
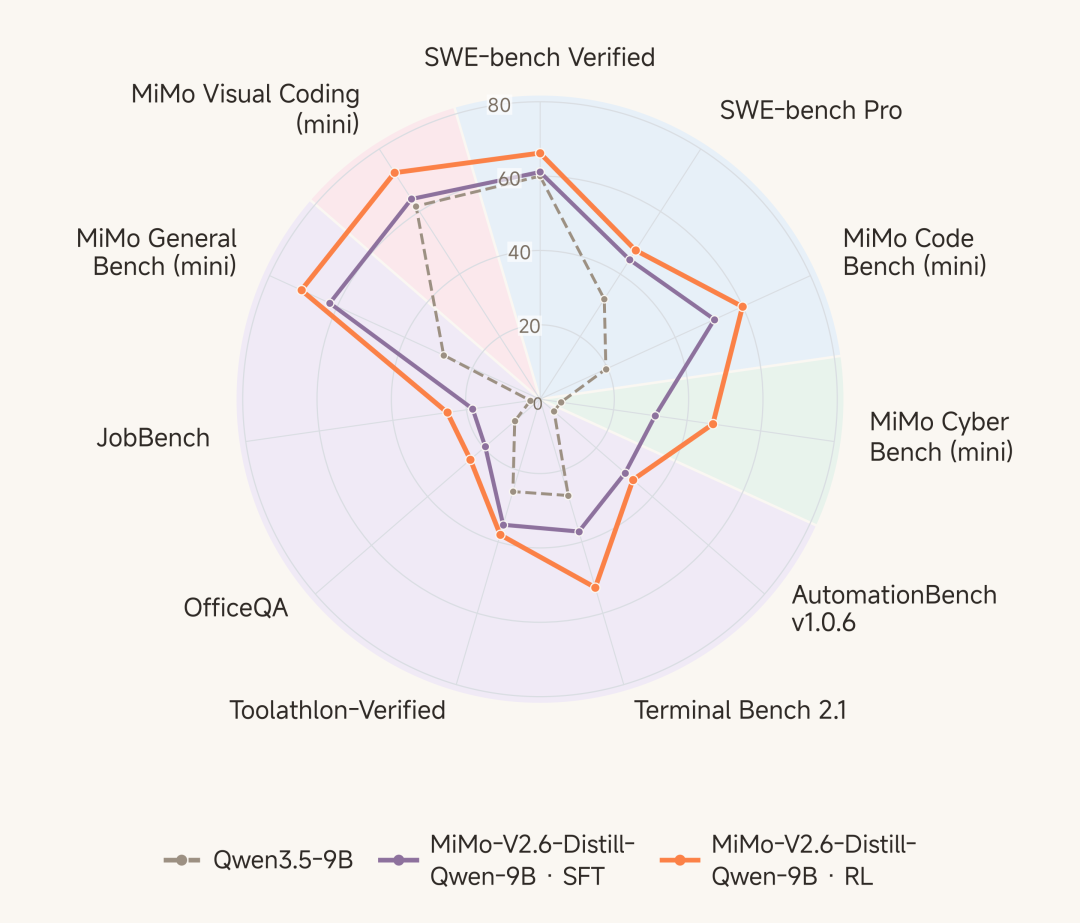
原始图表|小米 MiMo 官方发布资料中的蒸馏模型对比。它反映特定评测集合的结果,不等于整套大型 RL 训练可以低成本复刻。
对实际做 Agent 的团队来说,训练环境尤其值得留意。一个环境不仅是一道题,还包含可执行任务、工具边界、成功判据和失败反馈。没有这些基础设施,开放模型权重也很难让别人研究"能力是怎么练出来的"。
当然,开放环境和框架,不等于外部团队拥有相同算力、数据与工程条件。能够直接复用的是实验起点;能否复现整个规模,仍需看资源与验证结果。
这次发布真正留下的问题是:当 Agent 要完成越来越长、越来越难验证的任务,我们是否准备好了足够好的环境、判分和训练分工?MiMo-V2.6 提供了一套做法,也让这些原本藏在模型分数背后的工程问题,第一次更完整地站到了台前。类似话题在云栈社区也有不少开发者在讨论 RL 训练与 Agent 评测的落地细节。
资料来源:罗福莉原帖;小米 MiMo 官方发布说明。图表均来自官方发布说明;涂鸦图为本文创作。
主要来源
罗福莉 X 长帖:MiMo-V2.6: The Hard Road to Scaling Up RL
小米 MiMo-V2.6 官方发布说明
 发表于 前天 01:13
|
查看: 1|
回复: 0


