这道题的开场往往只有一句话:“给你一个场景,让你设计一个 Agent 系统。”
多数人从这里开始画图:用户输入、意图识别、规划、工具调用、观察、循环、输出。图画得挺标准,因为网上到处都是。
画完面试官追一句:那你这套东西跟一个 if-else 串起来的流程有什么本质区别?
答不上来,这题就废了。
所以得先把“Agent 到底是什么、它跟上一代软件差在哪”讲清楚。背定义没用。
01 什么是 AI Agent
1. 先讲范式在变
Karpathy 在 2025 年 6 月 YC 那场演讲里把软件分成三代:1.0 手写逻辑,2.0 用数据训出权重,3.0 用自然语言描述意图、由模型执行。一句话解释:你的工作性质变了。
| 维度 | Software 1.0 | Software 2.0 | Software 3.0 |
| 核心范式 | 写逻辑:定义规则和流程 | 定目标:提供数据和架构 | 描述意图:提示词和上下文 |
| 编程内容 | 写代码 | 准备数据、训练模型 | 写提示词、管上下文 |
| 执行核心 | CPU | GPU | LLM |
| 构建对象 | 算法与逻辑 | 网络的权重 | 系统的行为与目标 |
| 典型提问 | 我该怎么实现这个功能 | 我要什么数据来训练 | 我该怎么设定目标 |
这张表真正要说明的是第三行的位移:执行核心从 CPU 换成了 LLM,你的产物就从可复现的代码变成了带概率的行为。后面所有设计上的区别,根子都在这儿。
2. Agent 是给大脑装手脚
行业里有个流传很广的公式:Agent = LLM(推理)+ Planning + Memory + Tool Use。
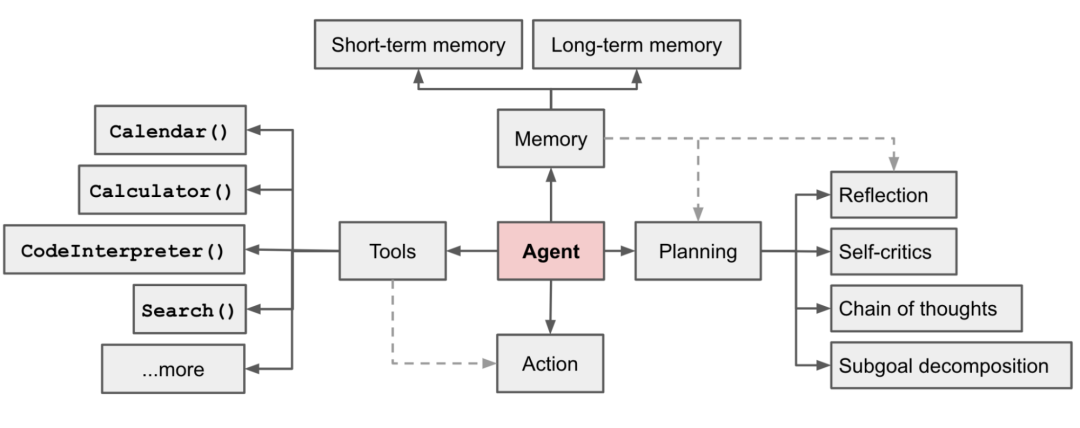
公式本身背下来不加分,加分的部分是能说清这四块里,哪一块在你的业务里真的能落地、落地要付什么代价。
| 维度 | LLM | Agent |
| 本质 | 推理内核,一个预测引擎 | 执行系统,一个有手有眼的程序 |
| 架构 | Transformer 网络,参数与权重 | LLM + 规划 + 记忆 + 工具 |
| 角色 | 被动的知识专家,等着被提问 | 主动的执行者,自己排步骤 |
| 边界 | 上下文窗口以内 | 能读外部数据、能改外部状态 |
| 状态 | 基本无状态 | 有状态,记得本轮干过什么 |
关键差别落在最后两行。一旦它能改外部状态,“答错了”就从一句不准确的话,变成一张派错的单。
3. 实践:某客服工单
客服工单:客户报故障、提需求,走服务热线或客户经理进工单系统,按产品线派给工程师,处理完回单。客户是甲方,SLA 写在合同里。
这个场景跟电商客服不是一回事。C 端客服答错了,用户骂两句就走;政企工单派错了,客户打给客户经理,客户经理打给你,然后这事进周会。
所以真正在考的是“你敢不敢让它自己跑”。
先列四条约束:
- 工单流程是监管流程。 受理、派单、处理、回单,每一步有 SLA 计时、有审计留痕、有人考核。流程顺序不能由模型决定。
- 字段错了会往下传导。 产品线抽错,派单就派错;紧急程度判低,SLA 就定松。这类错误系统不报错,只在客户那儿炸。
- 客户描述质量极差。 “网断了”“用不了了”“赶紧派人来”,这是真实工单的开头。
- 一单可能跨多个产品线。 政企客户常常一条专线、一朵云、一批物联网卡一起用。一次“上不了网”,可能专线断了,可能云侧安全组改了,也可能物联网卡欠费。
四条推下来,这套系统的位置很清楚:工作流外壳 + 模型内核。这个结论在第 5 小节还会推一遍,因为整篇的支点就是它。
02 六个能力
通常我们把 Agent 拆成六块:提示词、规划、工具、记忆、执行架构、协同。但每块要讲清三件事:用不用、用什么、代价是什么。
Part 1 提示词:把文本转化为输出接口
提示词工程有四个常见动作:角色设定、零样本/少样本、输出格式化、工具提示模板。工单场景只留两个,角色和格式化。
少样本这里用不上。字段抽取不需要示例引导,给三个示例反而会把模型往示例的措辞上带,客户说“光路断了”,它照着示例写成“网络不通”。
角色那一句也不是客套。“你是政企客服工单的受理助手,服务对象是政企客户,工单要进 SLA 计时”,这句话激活的是模型里跟工单、SLA、派单相关的语料分布。换成“你是一个乐于助人的助手”,它会开始安慰客户。
你是政企客服工单的受理助手,服务对象是政企客户,工单要进 SLA 计时。
从客户描述里抽取字段,严格按下面的 JSON 输出,不要输出任何 JSON 之外的内容。

{"product_line": "专线|云|物联网|其他",
"fault_type":   "中断|劣化|无法登录|其他",
"affected_scope": "一句话概括影响范围",
"start_time":   "客户描述的时间,看不懂就填 null",
"evidence":     "从原文摘出你判断的依据,一句"}

客户描述:{{raw_text}}
两个细节值得说。
一是最后那个 evidence 字段。这个字段给下游没用,是留给人看的。派单的同学看到“判成专线”,能顺着这句话回去核。没有这个字段,模型判错了你只能猜它怎么想的。
二是 start_time 允许填 null。很多提示词会把字段写成必填,模型为了凑齐就编一个时间出来。允许它说“不知道”,比逼它编强。
输出格式化这条,在工单里是硬要求:往下游交付的是接口,不是文章。所以解析层的写法比提示词更关键。解析失败要容错,并且把报错原文回传给模型让它自己改一次,别在提示词里反复加“必须”“一定”,那只会让它在失败时更啰嗦。
Part 2 规划:只有一个地方用得上
规划能力在 Agent 里指两件事:把目标拆成步骤再执行,也就是 Plan-and-Execute;或者边做边看结果再决定下一步,也就是 ReAct。工单受理这一段两样都不需要,因为步骤是人定的,模型来拆只会拆乱。
只有一处例外:跨产品线的单。
客户说“我们整个园区都上不了网”,要同时看专线状态、云侧安全组、物联网卡状态,再判断是哪一层的问题。这种单让它跑一次 ReAct 是合理的,因为它得在三个只读接口之间来回看结果。
但它的输出只给人看,不驱动动作。原因很直接:一条推理链里错一步,后面全歪,而这一步错没错没有自动判定的办法。所以这段结论落在工单的“排查建议”栏,工程师看一眼,采纳与否自己定。
Part 3 工具:schema 写得比模型好更重要
工具定义四要素:名字、什么时候用、参数(类型、是否必填、含义)、返回什么。少写一条,模型就会在边界上乱撞。
工单场景的工具不多,四个:查客户产品档案、查工单历史、查知识库、建单。
## query_customer_products(customer_id: str) -> list[dict]
- 什么时候用:需要确认客户名下有哪些在用产品时。
  客户只说了故障现象、没说产品线的时候,先调这个。
- 返回:[{"product_line": "专线", "status": "正常",
        "circuit_no": "***", "region": "***"}]
- 注意:欠费停机也会返回 status="停机",这种情况不要判成故障。
最后那句“注意”是踩出来的。第一版没写,模型看到客户说“网断了”,查出来专线状态是“停机”,照样判成故障派给网络组,工程师跑一趟发现是欠费。把这条写进工具描述之后,这类单少了很多。
工具描述本质是提示词的一种,写的是这份能力怎么用,而不是这个函数做什么。所以最值钱的那一行,往往写在“什么情况下别用”上。
Part 4 记忆与知识:这里要的不是记忆
一次报障的对话通常三五轮就结束,上下文短到不用担心窗口。工单场景里短期记忆几乎不重要,真正撑住这个业务的是知识库。
而知识库要干三件具体的事,缺一件就不好用。
- 语义对齐。 客户说“网口烧了”“光猫亮红灯”,坐席记成“链路异常”,工程师那边叫“专线中断”。同一个故障三套说法,知识库得能对上,否则检索出来的东西工程师看不懂。
- 链路落点。 从这张单能落到具体的设备、网元、合同号和 SLA 条款。落不下去的知识,工程师拿到了也动不了手,他还得再问一遍客户。
- 经验复用。 把历史单的处置过程压成“故障模式 + 检查点 + 处置模板”。新单进来先召回模式,再决定查什么。光有处置结果没用,工程师要的是“这种情况先看哪三项”。
把知识库当资料库用,是这个场景里最常见的错。它真正的作用是让模型拿到专家上下文,而且拿到的部分能直接执行。做到没做到,看输出的东西工程师能不能照着干活。
Part 5 执行架构:三个范式,选中间那个
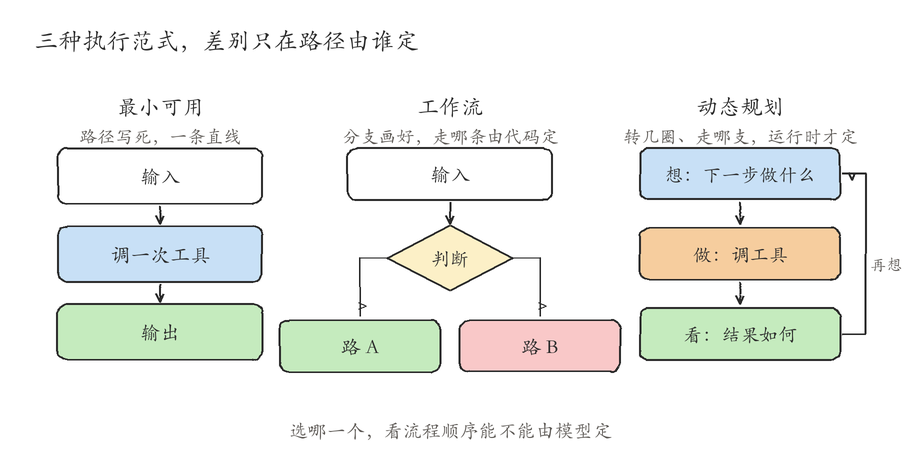
图1:三种走法,选错一种,后面全是坑
三种主流走法,差别在执行路径由谁定。
| 范式 | 路径由谁定 | 适合什么 | 代价 |
| 最小可用 | 代码,一条直线 | 问问、查查、解释一下 | 多步任务做不了 |
| 工作流 | 代码,画好的分支 | 流程固定、要审计 | 灵活性差,改流程要改代码 |
| 动态规划 | 模型,运行时决定 | 探索型,路不清楚 | 不可预测,成本高,难调试 |
工作流内部还分三种编排:链式,一关接一关;路由,先分流再各自处理;并行,同时查几个源再汇总。工单受理是链式为主,跨产品线那一段是并行。
这个场景落在中间那个。
理由前面讲过:流程是监管流程,顺序不能由模型定;但每一步内部的信息处理又离不开模型。所以形态是“工作流外壳 + 模型内核”。
这个判断有个直接后果:别给模型“决定下一步做什么”的权力。 落到代码上就是编排用状态机写,每个状态的出口是枚举,模型只能填这个状态里的字段,选不了下一个状态。
这么定跟保不保守无关。派错一张单的代价不会落在模型身上,落在工程师和客户经理身上,所以决定权不能给它。
Part 6 协同:受理段串行,定位段是 MoE
受理是串行的,抽完字段才能校验,校验完才能检索。上多个 Agent 只会让链路更长、更难查,所以这一段单 Agent 加状态机就够。
但跨产品线定位那一段不一样,它天然是 MoE 结构:一个总控,三个只读的领域排查 Agent,分别管专线、云、物联网。总控从客户档案里读出客户名下的产品清单,按清单并行派下去,收上来汇总成一份排查线索。
这类场景里的“总控 + 领域专家”,区别在权限。这三个 Agent 只读,不改状态、不改工单,输出只有一个用途:给工程师看。
代价也得说清:三个只读 Agent 意味着三套工具封装和三套评估集,而它服务的只是跨产品线那一小部分工单。所以我们把它排在后面,等受理段的准确率稳住了再动。
03 工程实践中的三个变化
1. 研发流程的转变
核心关注点,从功能实现到目标达成。传统研发的验收标准是点这个按钮出这个页面,写进需求文档就定死了。这里的验收标准是派单命中率,得先标一批单才知道基准在哪儿。所以项目启动的第一件事是标数据,不是搭架子。
流程驱动力,从计划驱动到实验驱动。没有“需求、开发、测试、发布”这条线。改一版 schema,跑一遍评估集,涨了就留、跌了就退。所以这个项目里没有测试用例,只有评估集:测试用例判对错,评估集给分布。
协作方式,从基于接口到基于目标与评估。评估集得由业务方和工程一起定,因为“派给哪个组算对”只有派单的人知道。这条最容易漏,漏了就会出现指标很好看、业务方不用的情况。
2. 设计范式:只看错了能不能改回来
选型不用列一堆维度,一条就够:这个环节错了,能不能改回来。
改得回来的,交给模型,快;改不回来的,交给规则,慢但稳。
| 环节 | 错了能改回来吗 | 谁定 |
| 故障描述 | 能,工程师看一眼能顺手改 | 模型 |
| 产品线 | 不能,派错就派错了 | 规则,查客户档案 |
| 紧急程度 | 不能,SLA 从这里开始计时 | 规则,按合同条款 |
| 派单组 | 不能,一步错到客户那儿 | 规则,查路由表 |
这张表就是整套系统的权力分配图。第 04 节的代码基本是在实现它。
3. 开发方式:为什么这里只能写代码
低代码那一类(Dify、Coze、AI Studio)能拖出工作流、能接 API、自带状态管理和重试;纯代码那一类(LangChain、LangEngine、Spring AI、AgentScope)什么都要自己写,但什么都能自己定。
选型不看复杂度,看三件事。
- 要不要接内部老系统。工单系统、客户档案、网管,都是十几年的老接口,鉴权和字段映射得在代码里磨。
- 要不要细粒度权限。客户 ID 只能从当前会话取,模型传过来的一律不认,这层收口在低代码里做不了那么死。
- 要不要审计留痕。每一步谁做的、模型给了什么建议、代码怎么定夺的,都要能回放。
三条里有一条不满足,低代码就够用。三条全要,只能写代码。工单这个场景三条全中。
04 政企客服工单的落地
1. 背景与整体方案
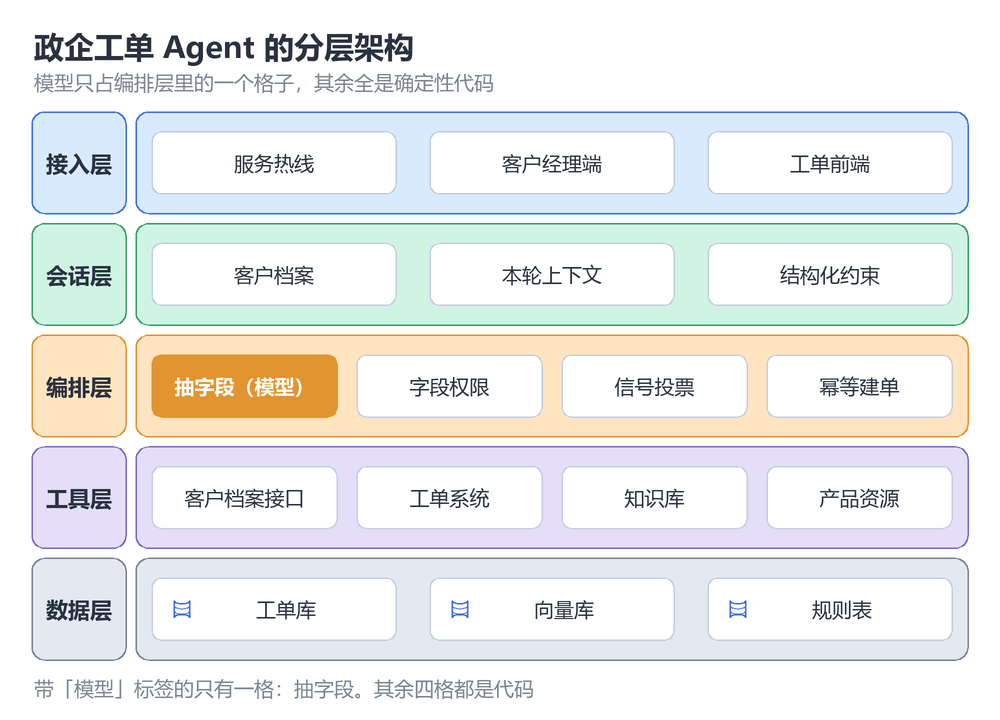
图2:五层分工,模型只占编排层里的一格
五层里只有编排层的第一格是模型,负责抽字段。其余都是代码:字段权限、信号投票、幂等建单。
这个比例是有意压的。抽字段是模型不可替代的地方,其他环节给它加权力,收益很小,风险很大。
2. 流程设计
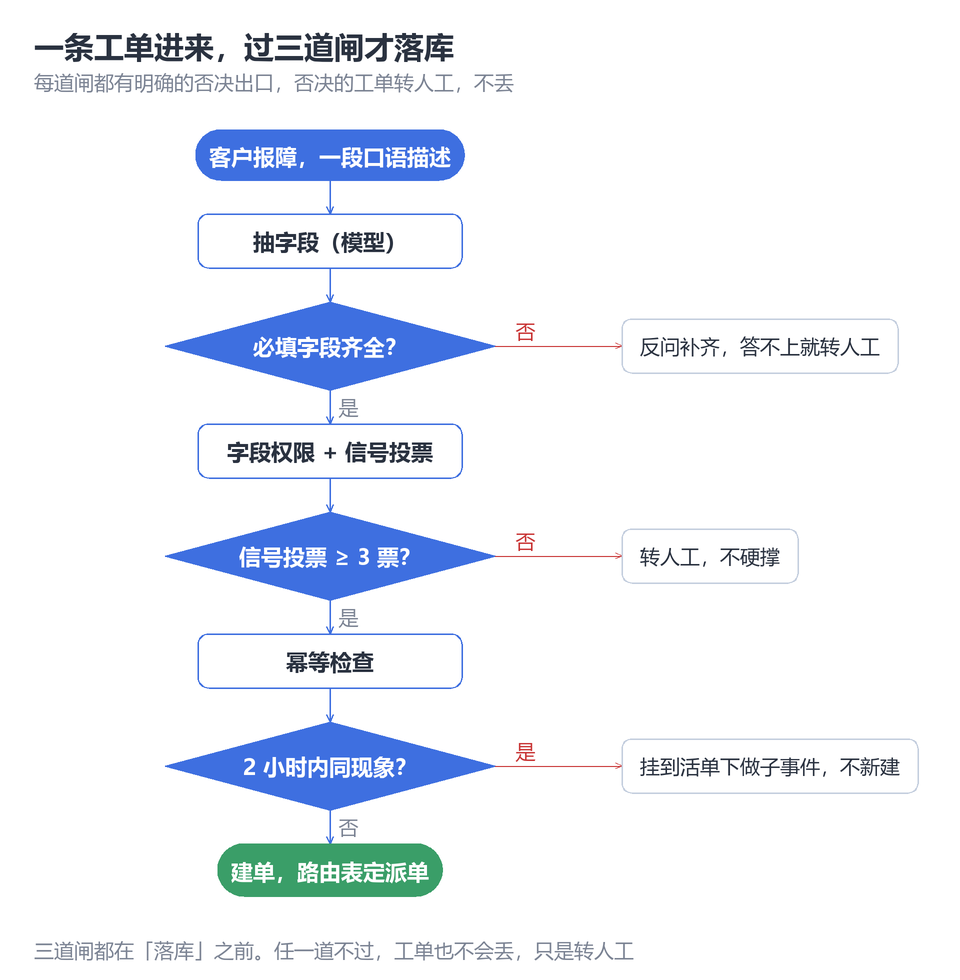
图3:三道闸都在落库之前,任一道不过就转人工
一条工单要过三道闸,任何一道不过都转人工,但工单本身不会丢。
第一道,字段权限。 不是所有字段模型说了都算。
FIELD_SPEC = {
    # 模型说了算:错了只影响工单可读性
    "fault_desc":     {"kind": "text", "owner": "model"},
    "affected_scope": {"kind": "text", "owner": "model"},

    # 规则定夺:模型给建议,最终值由规则算
    "product_line":   {"kind": "enum", "owner": "rule",
                       "values": ["专线", "云", "物联网"],
                       "fallback": "其他"},
    "urgency":        {"kind": "enum", "owner": "rule",
                       "values": ["P1", "P2", "P3", "P4"]},

    # 系统填:模型碰都不该碰
    "sla_deadline":   {"kind": "derived", "owner": "system"},
}
owner 这个字段是关键,它决定冲突时听谁的。
fault_desc 标 model,因为它错了顶多工单描述难看,工程师看一眼还能干活。product_line 标 rule,因为模型说的只算建议:它说“专线”,规则去客户档案查这个客户名下有没有在用的专线,有就采信,没有就落“其他”并标待确认。
第二道,信号投票。 四个信号,每个都是确定性的、能单独查的。
def confidence(parsed, profile, similar):
    hits = 0
    # 1 必填字段一个不缺
    if all(parsed.get(k) for k in REQUIRED):
        hits += 1
    # 2 枚举值都在合法集合里
    if all(v in FIELD_SPEC[k]["values"]
           for k, v in parsed.items()
           if FIELD_SPEC.get(k, {}).get("kind") == "enum"):
        hits += 1
    # 3 和客户档案不冲突
    if owns_product(profile, parsed.get("product_line")):
        hits += 1
    # 4 召回的近邻工单,方案收敛
    if solution_agreement(similar) >= 0.6:
        hits += 1
    return hits / 4
4 票直接落库,3 票落库但标待核,2 票以下转人工。
这套的好处在于错了能查。模型自报的 0.92 你没法复盘,信号投票能告诉你到底是哪一条没过。
第三道,幂等建单。
def idem_key(parsed):
    raw = "|".join([
        parsed["customer_id"],
        parsed.get("product_line", ""),
        norm(parsed["fault_desc"]),   # 去标点、去语气词
    ])
    return hashlib.md5(raw.encode()).hexdigest()
建单前查一次 2 小时窗口内有没有同 key 的活单,有就挂到那张单下面做子事件,不新建。
这条跟 Agent 一毛钱关系没有。但没有它,前面做得再准也白搭:客户打三个电话,坐席点三次提交,系统里就是三张单,三个工程师各自跑一趟。
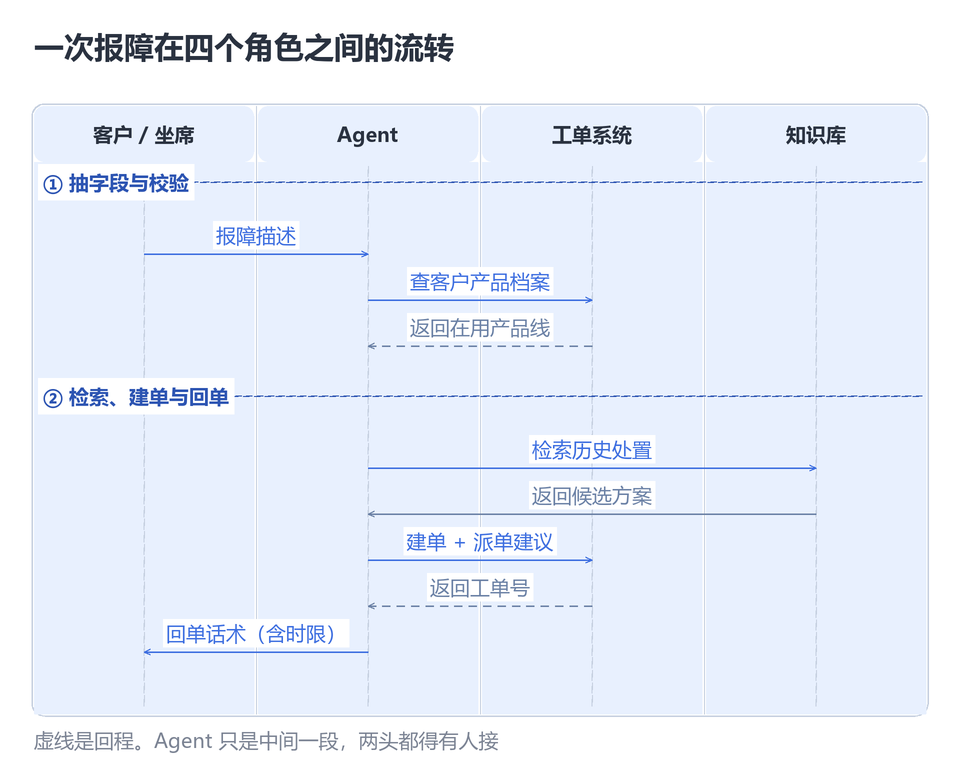
图4:Agent 只是链路中间一段,它挂了前后都得接得住
3. 知识体系:检索为什么不能纯向量
工单描述短、口语化、术语密度高。纯向量检索“连不上网”,会召回一堆“网络不稳定”“网速慢”的,语义确实近,处置方案完全不同。
所以先用结构化字段把候选集砍到很小,再在子集里做语义排序。
def retrieve(parsed, k=5):
    return es.search(index="ticket", body={
        "query": {"bool": {
            # 硬过滤:产品线 + 故障大类 + 时间窗
            "filter": [
                {"term":  {"product_line": parsed["product_line"]}},
                {"terms": {"fault_type": FAULT_FAMILY[
                    parsed["product_line"]]}},
                {"range": {"closed_at": {"gte": "now-18M"}}},
            ],
            # 语义排序:只在过滤后的子集里算
            "must": [{"knn": {"desc_vec": {
                "vector": embed(parsed["fault_desc"]), "k": 50}}}],
        }},
        "size": k,
    })
时间窗这个参数不是拍脑袋能定的,得拿产品线的换代周期去推。我们那边是 18 个月,因为它调整过一次组网:超过这个窗口的工单里,处置方案有一半跟现在的网络对不上。老单全灌进向量库,召回得很准,准得离谱,它召回的是三年前那套已经拆掉的架构。
4. 兜底
模型超时或报错,走模板。字段不全的工单照样能建,标“待补全”,派给人工受理组。工单不能因为 Agent 挂了就不进系统。
置信度低,转人工。
检索为空,明确说查不到。这一条必须落到代码,落到提示词上没用。
def render_reply(ticket, hits):
    if not hits:
        return TEMPLATE["no_match"]   # 固定话术:已受理,稍后联系
    # 方案段只允许引用工单号,不接受自由文本
    refs = [h["ticket_no"] for h in hits if h["score"] > 0.72]
    return TEMPLATE["with_ref"].format(refs="、".join(refs))
检索为空的时候,模型倾向于根据经验推断一个方案,写出来还挺像回事。所以方案那一段的取值只有两个来源:检索到的工单号,或者人工填。模型不许自由生成。
那段固定话术不好看,但它不骗人。客户宁愿收到“已受理,工程师稍后联系”,也不愿意收到一个编出来的处置方案。
05 实践体会
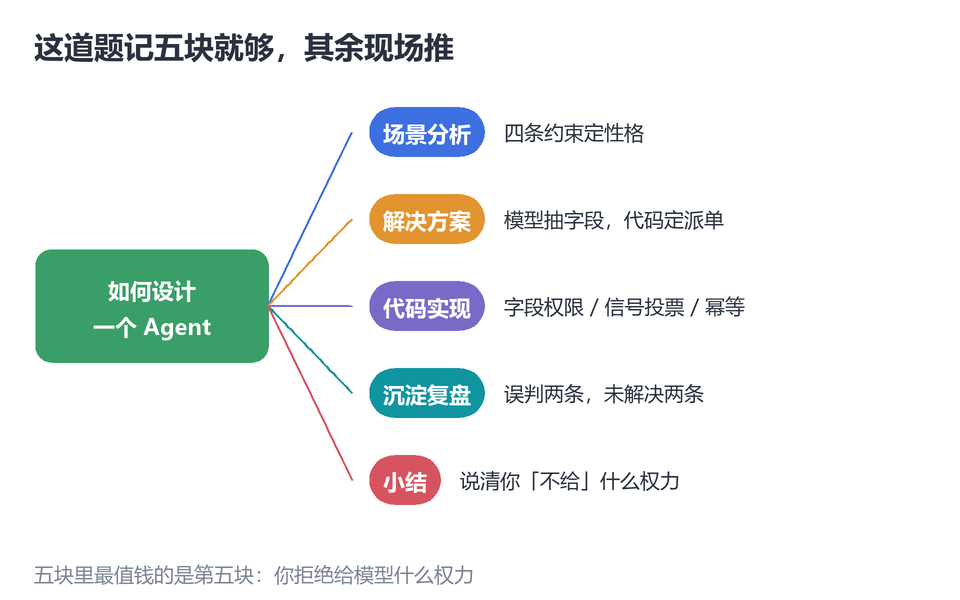
图5:五块,最值钱的是最后一块
让模型自报置信度不可靠
第一个,开始让模型自报置信度。在 JSON 里加了个 confidence 字段让它自己打分。跑了一阵发现,它无论对错都给 0.9 上下。这个数没有校准意义,模型不知道自己不知道。后来才换成信号投票。
第二个,一开始想做全自动派单,理由是想省人力。上线后发现派错单的代价远大于省下的人力,政企客户派错一次会被投诉到客户经理,严重的影响续约。
改成“模型给建议、路由表定夺”之后,人力没省多少,但投诉少了,这笔帐算得过,这就是成本的概念。
评估集不能随机抽
随机抽 500 条,八成是“宽带报修”“密码重置”这类简单单,模型全对,指标很好看,问题一个都没测出来。
要抽的是分歧样本:转人工的、回单被返工的、SLA 超时的、同一客户 7 天内重复报的。这四类里藏着模型所有的错法。
指标三个,按重要性排:派单一次命中率,这个错了代价最大;关键字段准确率,product_line、urgency、fault_type 这三个;回单返工率,返工说明要么信息错,要么话术不能直接用。
还有一个容易漏的:分布漂移。产品线改名、技能组重组、SLA 口径调整,任何一次变动都会让之前的离线指标失效。评估集要跟着组织变,不是建一次用一年。
上线顺序也有讲究。
第一版只放抽字段,派单还是人点,回单还是纯模板。跑稳了再放派单建议。理由是抽字段错了工程师能改,派单错了就投诉,先把错了能纠的那部分放出去。
当然还有很多遗留问题。
跨产品线的单怎么拆。客户一条专线加云同时出问题,模型能抽出两个产品线,但拆成两张单还是合成一张,现在还是人工判。拆了怕协调不了,合了怕两个组互相等。这事卡在流程上,技术层面反而没什么可做的。
回单话术的承诺边界。我把时限段做成占位符了,但模型有时候会绕过占位符,在别的地方补一句“很快就能解决”。后置规则拦不全。正在试的方向是把回单从“生成”改成“选句”,代价是话术会更死板。
06 写在最后
最后,面试怎么答。
90 秒版本:先问这个场景的约束,有没有 SLA,错了谁承担,客户是不是甲方。然后说约束把系统性格定死了,能抽字段、能给建议,流程顺序一步都不由它定。接着讲分工和收敛,最后讲兜底和评估。
三个加分点:说清楚你为什么不给模型某个权力,比说它能干什么值钱;说置信度用可验证信号,别用模型自报;主动说评估集要抽分歧样本。
这题真正在考的,是你能不能把“不确定”和“确定”分开。模型那半边注定不确定,所以越往后的环节越要确定。分开之后,架构图长什么样反而不重要了。
(文中场景做过脱敏:客户名称、工单编号、组织与产品线命名都替换或简化过,字段名与代码为示意结构,不对应任何在运行系统。)
参考资料:
 发表于 昨天 22:24
|
查看: 2|
回复: 0
 /1


