一次工具调用结束,Agent 把结果追加进历史再请求模型继续工作。上一轮处理过的输入和生成内容又出现在下一轮输入里。在 Prefill/Decode 分离部署中,新请求先交给 Prefill,而上一轮生成阶段的 KV 留在 Decode。要减少重复计算,系统需要让这份历史跨过工具等待,并在下一轮计算前到达 Prefill。
这里需要同时考虑两项成本:为等待下一轮而保留 KV 会占用多少缓存资源;下一轮真正需要它时,取得这些状态又要花多久。实践中常见两种保留位置——直接留在 Decode 的设备内存,或先把副本写到主机内存再由 Prefill 获取。两种方式把资源占用与获取延迟放在不同位置。
一次完整的跨轮请求大致按以下顺序发生:上一轮 Decode 保留可复用状态并返回元数据;工具执行期间状态继续被保留;路由器把旧来源信息交给本轮 Prefill;Prefill 做本地匹配并计算候选增量;工作进程检查有效性并决定是否读取;处理未被覆盖的输入后,再交给本轮 Decode 生成。需要注意的是,上一轮 KV 的来源 Decode 与本轮生成目标 Decode 可以是不同节点。
本文以 vLLM 双向 KV 传输及相关卸载实践「Improve TTFT for Multi-Turn Agentic Workloads with Bi-Directional KV Transfer in vLLM」为观察对象,先看下一轮实际缺少多少历史,再讨论保留位置、定位方式与读取阈值。
先计算下一轮缺少的历史
假设上一轮输入为 H,Decode 随后生成 R,工具返回的新增输入为 T。在聊天模板保持旧 Token 序列一致的情况下,下一轮输入可以表示为 H + R + T。
Prefill 是否仍保留 H 对应的 KV,直接影响下一轮需要取回或重新计算多少历史。如果本地仍能命中 H 对应的 KV,就不需要重新计算这部分输入;此时,可以尝试从 Decode 取回 R 中已经计算、但 Prefill 尚未持有的 KV,新增的 T 则仍需本地计算。如果 H 对应的本地 KV 已被淘汰,那么 H 也进入需要从远端取回或重新计算的历史范围。
在 vLLM 的双向 KV 传输实现中,调度阶段会先扣除本地已覆盖的部分。设本轮输入长度为 N,Prefill 本地已覆盖 L 个 Token,Decode 宣告的可复用范围为 C,那么候选的额外远程复用量为:
M = max(0, min(C, N) − L)
该计数建立在远端状态确实对应当前输入前缀的前提上,实际读取还需要映射到可传输块。
用一组假设值看这次决策:当前输入有 19,456 个 Token,Decode 可提供前 18,432 个,还有 1,024 个 Token 未被远端提供的范围覆盖。
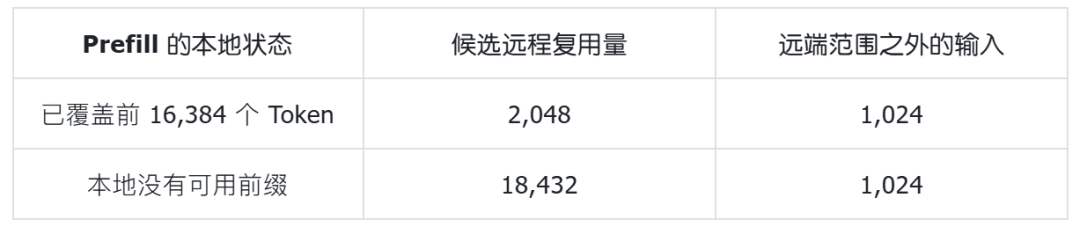
同一份 Decode 历史,在两种本地状态下对应相差九倍的远程复用量。判断读取是否划算时,应比较这些增量各自的读取与重算时间。
以候选增量为 2,048 Token 的情况为例,它超过了默认的 64-token 门槛,因此可以形成读取候选。之后仍需满足实际读取条件,元数据有效、块仍在 TTL 内、前缀对齐等。成功加载后,远端范围之外的 1,024 个 Token 继续由 Prefill 本地计算。若候选增量只有 32 Token,则在默认门槛下不被计作远程加载,直接走本地计算路径。
以候选远程复用量为 2,048 Token 为例(假设块大小为 16 Token,约对应 128 个块)。
- 设备内存回读路径:定位来源与连接建立、NIXL 读取、完成后对剩余 1,024 Token 的本地计算。总耗时 ≈ 定位与读取耗时 + 剩余计算耗时。
- 直接重算路径:2,048 + 1,024 = 3,072 Token 全部由 Prefill 本地计算。当定位与读取耗时 + 剩余计算耗时 < 全量重算耗时 时,读取更优。CPU 副本路径还需额外计入对等传输与设备加载时间。
注:以上为结构示意,具体数值需按模型、硬件与网络实测。
这会改变保留成本与复用收益之间的关系。在这个例子里,即使 Prefill 只缺 2,048 个历史 Token,Decode 仍可能保留覆盖更长历史的块。实际显存占用应按被额外保留的物理块计量,并考虑共享前缀。会话总长度、额外可省的重算量和实际占用的显存,是三项不同的数据。
工具执行期间决定保留位置
保留与读取发生在两个不同的时点。保留决策发生在上一轮结束时。此时系统只知道本次生成了哪些块、当前缓存压力,以及可能的下一轮等待时长,并不知道下一轮 Prefill 本地会覆盖多少。因此,上一轮的 TTL 或 CPU 卸载决策,只能基于“可能被复用”的预期,而不能依赖下一轮实际的候选远程复用量。
读取决策发生在下一轮请求到达 Prefill 之后,此时本地覆盖已确定,才能计算出候选远程复用量,并与阈值比较,决定是否发起读取。
设备内存路径可以直接利用 Decode 刚生成的 KV,以下按 v0.29.0 文档中的 CUDA device-buffer 双向模式讨论,P、D 两端均需启用 bidirectional_kv_xfer。正常结束请求时,NixlConnector 延后释放相关块,并导出块位置、已计算 Token 数与到期时间。decoder_kv_blocks_ttl 控制这次延后释放的期限,默认 480 秒。
工具等待较短、旧块仍能保留时,下一轮可以直接从设备上的已有状态读取。随着等待会话增加,这些已经停止生成、却仍在等待取用的块,也会占用缓存池。延长 TTL 会扩大等待下一轮的窗口。若会话迟迟没有发起读取,也会延长相关块被额外保留的时间;若预期消费者已读完并完成通知,延后释放可以提前结束。评估驻留成本时,应记录被额外保留的物理块和实际持有时长。
主机内存副本提供了另一种保留方式:先把 KV 写到 CPU 内存,后续复用不再要求原来的设备页一直为它保留。它增加写出和恢复过程,换来设备缓存被回收后仍有副本可找的机会。vLLM 的 CPU KV 卸载实践「Inside vLLM's New KV Offloading Connector: Smarter Memory Transfer for Maximizing Inference Throughput」将写出设计为异步操作,读回则仍需在相应状态被使用前完成。
本文所引 CPU P2P 路径依据 llm-d dev 文档,该路径目前标为实验性;使用时需确保引擎与路由组件版本相互兼容。
跨轮场景还有一个容易遗漏的条件:CPU 副本是否包含生成阶段的 R。只保存输入 H,在 Prefill 本地已经命中 H 时,无法补上本轮真正缺少的生成历史。llm-d 的 Prefill/Decode 点对点指南因此要求 Decode 使用 offload_prompt_only=false,并配合能够保持生成序列一致的聊天模板。
CPU 也有容量边界。所核对的分层实现使用可配置的缓存替换策略,默认最近最少使用;旧副本可能因后续访问和容量压力被淘汰。v0.29.0 的卸载连接器还将保存视为尽力而为:一次保存未能完成,会减少后续命中机会,不能把“启用了卸载”直接当成“历史已经存好”。
Prefill 定位并取得历史状态
设备内存路径使用上一轮导出的具体位置。多轮路由器按 conversation_id 保存 Decode 的 kv_transfer_params,在下一轮将它们交给 Prefill。Prefill 知道来源引擎、请求、块 ID 和连接地址后,发起 NIXL 读取,将可复用 KV 读入本地接收位置,再处理剩余输入。路由器只负责请求与元数据,KV 不经过路由器。
CPU 副本路径需要找到仍持有相应前缀的来源。llm-d 的跨 P/D 配置通过多连接器组合常规 NIXL P/D 交接与卸载连接器/P2P 层。缓存事件索引用于定位候选源,来源信息被传给实际执行 Prefill 的实例;该实例请求需要的块,源端确认可提供的部分,再完成对等传输。
两条路径的搬运位置不同:
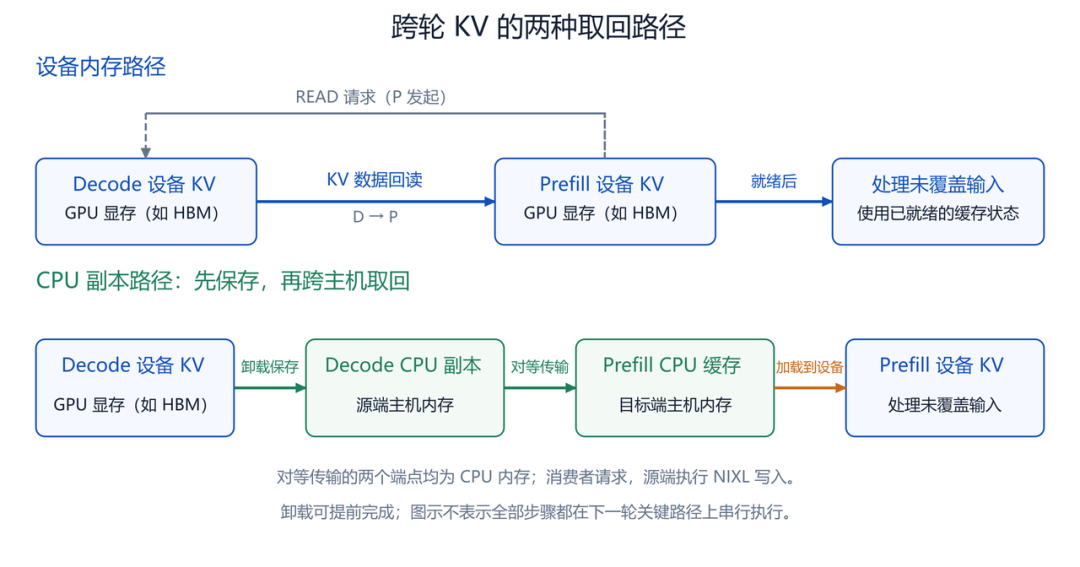
图注:设备内存路径由 Prefill 直接发起 NIXL 读取;CPU 副本路径需先卸载、对等传输再加载到设备。
CPU 路径中的对等传输发生在主机内存之间。消费者发起获取请求后,源端通过 NIXL 写入匹配数据;目标侧还需经 CPU 缓存加载到设备,模型才能使用。分层实现将 CPU 主层作为外部数据进入 GPU 的入口。
这使两种定位方式承担了不同的条件。设备路径依赖上一轮那组位置仍有效;CPU 路径依赖索引可见、块仍存在且能够匹配。连接地址正确并不足以证明内容可复用,CPU 路径还要核对块大小、哈希与 KV 布局的兼容性。
两条路径取得历史后,Prefill 都要继续处理未被覆盖的输入,再进入本轮 P→D 生成流程。把历史存到 CPU,并没有取消后续的设备加载和常规交接。
按实际路径校准读取阈值
沿上述路径取回历史状态,需要与直接重算作同条件比较。回到第一节的例子,本地命中充分时只缺 2,048 个历史 Token,本地缓存丢失时则缺 18,432 个。更大的候选范围提供了更多减少重算的机会,也需要搬运更多 KV。它是否值得读取,还取决于模型的重算成本、KV 数据量和传输路径。
设备回读需要定位来源、必要的连接建立与元数据协商、读取和完成等待;CPU 副本路径还涉及源副本可用性、对等传输与目标侧设备加载。CPU 写出可以提前进行,但这项后台工作仍消耗带宽和容量。评估下一轮的等待时,需要区分已经提前完成的工作,以及请求到达后仍必须等待的部分。
vLLM 的 kv_recompute_threshold 默认 64 Token,在调度阶段对额外远程复用量作判断。低于阈值的增量不被计作远程加载。
CPU P2P 的来源选择使用 minCachedTokenDelta:候选源相对目标实例多覆盖的前缀,达到相应条件后才触发获取。其校准指南在 gpt-oss-120b、H200、RDMA/IB 参考配置上给出 2,048 Token;其他模型、硬件和传输条件需要重新测量。这个索引侧决策之后,引擎还需确认实际块是否可用。
64 与 2,048 作用于不同实现、不同阶段和不同路径,不能直接拿来比较方案效率。对于同一组请求,需要对照的是:相同的本地命中范围下,取得额外历史到可用于计算所花的时间,与直接重算这段历史的时间。阈值的作用是在调度阶段过滤掉明显不划算的小增量;最终是否读取,仍取决于实际读取条件是否满足。
同时记录等待占用与下一轮工作量
先固定一组真实的跨轮请求,保留其 Token 前缀、每轮新增内容与工具等待分布。只看总输入长度,无法区分第一节中 2,048 与 18,432 个远程候选 Token;只看下一轮延迟,也无法说明前一段等待占用了多少缓存。
对设备路径,需要确认上一轮是否导出元数据、块在读取时是否仍有效,以及 Prefill 实际读回多少。示例路由器的记录有效期为 450 秒,设备块默认保留期限为 480 秒。在透传了远端到期时间的双向回读中,工作进程还会在读取前检查到期风险;排队和连接建立也会消耗剩余窗口。因此,路由器侧的缓存命中仍需结合实际读取完成记录判断。
对 CPU 路径,需要把生成历史的保存、后续存活和再次命中分开记录。主机层的字节数、命中范围以及设备加载时间,才能说明副本是否补上了本轮缺口。
跨轮历史发生变化时,还要区分两种定位方式。对沿用上一轮块位置的 NIXL 回读,若摘要或剥离推理痕迹使旧状态与当前输入不再对应,上层应停止使用不适用的旧传输参数,避免读取错误位置的 KV。
CPU P2P 则按当前请求所需块的前缀哈希查找。哈希包含前序上下文,发生变化的部分不能继续匹配旧前缀,仍一致的较早前缀可能继续复用;正常查找未命中的部分由引擎计算。
性能证据也应保留原来的比较条件。vLLM 的双向传输实验使用一 Prefill 一 Decode 部署、Amazon EC2 P5en 实例与 AWS 弹性网络适配器,关闭 Prefill 本地前缀缓存来模拟缓存丢失;在 GLM-5-FP8、20K 输入的测试点,TTFT 从 2,334 毫秒降到 702 毫秒。它支持对应配置中以远程回读替代重算的收益。
llm-d 的跨 P/D 测试「Pull, Don't Recompute: Peer-to-Peer KV Cache Sharing in llm-d」则报告,在 2P4D、每 Pod 一张 H200、拉取阈值为 1,024 Token 的配置中,Llama-3.1-8B 移动了历史 KV、释放出 Prefill 计算容量,但 TTFT 接近持平。该对照同时加入了 CPU 卸载层与对等获取,效果应归于这组改动。
这两个结果提示需要分别衡量“减少了多少计算”和“请求提前返回了多久”。前者可能换来更多服务容量,后者还受到读取、恢复与排队影响。验证时同时记录等待期间的占用与下一轮实际取回量,能更清楚地判断在当前负载下,设备块保留、CPU 副本还是直接重算哪条路径更合适。
参考资料
- vLLM: Improve TTFT for Multi-Turn Agentic Workloads with Bi-Directional KV Transfer in vLLM, 2026-10-12, vllm.ai/blog/2026-10-12-bidirectional-kvxfer-multiturn-agentic-workload
- IBM Research、Red Hat/llm-d: Pull, Don't Recompute: Peer-to-Peer KV Cache Sharing in llm-d, 2026-08-15, llm-d.ai/blog/p2p-kv-cache-sharing-llm-d
- vLLM/IBM Research: Inside vLLM's New KV Offloading Connector, 2026-01-08, vllm.ai/blog/2026-01-08-kv-offloading-connector
- vLLM: NixlConnector Usage Guide (v0.29.0), github.com/vllm-project/vllm/blob/v0.29.0/docs/features/nixl_connector_usage.md
- llm-d: P2P KV-Cache Sharing, llm-d.ai/docs/dev/architecture/kv-management/p2p-kv-cache-sharing
- llm-d: Enable P2P Prefix Cache Sharing, llm-d.ai/docs/dev/well-lit-paths/foundations/enable-p2p-prefix-cache-sharing
- vLLM:v0.29.0 源码,github.com/vllm-project/vllm/tree/v0.29.0
- vLLM Issue #43094: Bidirectional KV transfer produces incorrect results when reasoning traces are stripped between turns, github.com/vllm-project/vllm/issues/43094
在 云栈社区 上,围绕大模型推理引擎与 Agent 系统的讨论一直不少。如果你正在从零搭建多轮 Agent 应用,尚硅谷大模型线课程覆盖了从 Python 基础到 LangChain、MCP、RAG 与 Agent 开发的完整链路,也涉及 Prefill/Decode 分离部署中的工程实践,可以作为系统性的补充。
 发表于 1 小时前
|
查看: 2|
回复: 0
 /1


