Cowork Agent 要在文档和工具组成的工作环境里自主规划、检索信息,再靠连续执行把任务跑完。可问题在于,如何规模化地构建证据充分、评判可靠的训练任务,把长程交互中积累的经验转化为模型能力?这其实是训练这类 Agent 的核心难点。
小红书 AllSpark 团队给出的解法是 Navalia。它从跨文档任务切入,自动搭建文档环境,合成证据可追溯、答案可验证、带真实多步依赖的任务,再结合轨迹采集与后训练,走出一条从数据到训练的完整链路。
在五项基准上,Navalia 全面超过基座模型,各项得分提升 13.07–23.06 个百分点,在文档检索、专业研究、长程任务执行等场景里都表现出更强的能力。
论文题目: Navalia: Advancing Cowork Agents through Verifiable Task Synthesis and Long-Horizon Post-Training
论文链接: https://arxiv.org/abs/2610.26887
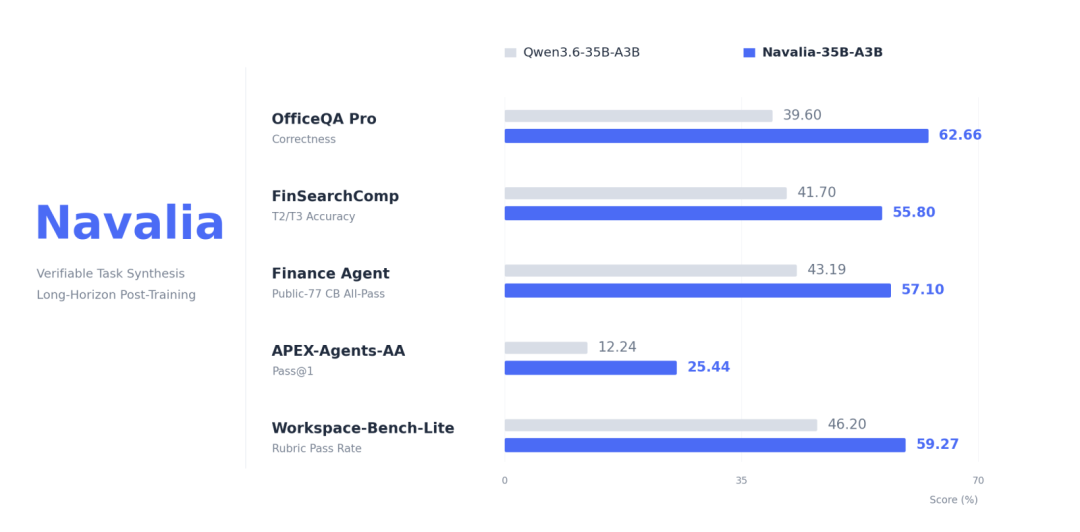
图 1:Navalia 与基座模型在五项基准上的表现。各基准采用各自的评分指标,数值均为百分数。
写在前面
训练 Cowork Agent,先得给它一个能真正干活的阵地:有文件可查、有工具可用,还有必须连续多步操作才完得成的任务。随着训练规模扩大,这些环境还要不断覆盖新的材料、业务约束和工作流程。
难点也随之出现。一个环境可以精心搭建,可成千上万个训练实例怎么持续产生?生成出来的任务有充分材料支撑吗?能给训练提供可靠反馈吗?
环境如何扩展。 真实办公资料往往不公开,不同岗位的文件组织和工作流程差异也很大。人工逐个搭建环境,根本满足不了规模化训练对数量和多样性的需求,所以必须自动构建可供 Agent 反复交互、可靠执行任务的工作环境。
任务如何验证。 在构建好的环境里,合成任务需要充分证据支撑,参考答案要经过核验,评分机制也要能准确判断模型回答对不对,为轨迹筛选和强化学习提供可靠反馈。
交互如何用于训练。 Agent 在环境里积累的经验,得变成有效的模型更新。高质量示范先要筛选,长轨迹得适配有限的上下文窗口,最终结果还要反向指导检索、分析和工具选择。环境、任务与训练因此必须作为整体一起设计。
Navalia 的切入点正是跨文档检索与分析。公开报告成了它规模化构建的数据源,系统自动组织文档环境、生成可验证任务,再结合轨迹采集与长程后训练,把从数据到模型的整条配方跑通。
01 把文件组织成可扩展的训练环境
Navalia 为同一份文件建立文档与事实两种视图。文档视图保留正文、标题和表格,Agent 通过工具检索就能读取;事实视图则把文档数据整理成结构化记录,明确每个数值对应的指标定义、单位、时间范围、统计口径和原文出处。系统用事实视图选证据、构造任务、核验答案,Agent 则通过文档视图自主查找资料、完成分析。
基于同一批材料,Navalia 能组合出不同任务。系统先选定跨期聚合、趋势比较、统计分析或回归等分析方法,再定下分析对象、时间范围和目标指标,同时检查文档是否满足数据需求。跨期分析要求材料覆盖指定时间范围,跨对象比较讲究数据在时间和口径上的可比性;满足不了就重新采样任务配置。
通过检查后,支撑任务的文档会与其他时期、其他对象的相关文档一起组成任务环境。每项任务平均包含 5.85 份支撑文档和 208.69 份干扰文档,模型需要从中辨别并找齐有效证据。通过改变分析对象、时间范围、文档组合和分析方法,系统可以持续构造新的任务环境。
02 先把证据和计算理清楚,再生成问题
环境定下来后,下一步就是给题目挑出真正用得上的证据。这件事不能只看名称:同一个概念可能在不同文档里有不同叫法,名称相近的指标,定义、单位、统计口径也未必一致。能不能参与同一次计算,得结合上下文细看。
Navalia 从候选文档的完整事实集合出发,让 LLM 根据语义和上下文判断哪些记录满足计算要求,而不是靠关键词或固定指标规则做预筛。事实一多,就先在每份文档内部语义预选,再跨文档联合判断,尽量不遗漏。
多步任务还得有真实的计算依赖。比如先用多个时期的数据拟合趋势,再用拟合结果预测下一期数值,最后和最近一期的实际值比较。后一步必须用前一步的结果。Navalia 把这些关系写进可执行计算链,由预先实现的数值程序处理回归、预测等复杂运算,中间结果和证据来源全部留存。
证据和参考答案都齐了,系统才生成题面。分析对象、时间范围、指标口径、计算要求等条件全部保留在问题里。随后,独立复核模型重新求解,检查问题、证据和答案是否对应得上;程序化检查再核对时间覆盖、单位、步骤依赖等硬性条件。两道检查都通过的任务,才有资格进入后续训练。
这一流程让任务生成建立在可追溯的证据和可执行的计算之上,也为后续训练提供了能够核验的反馈依据。
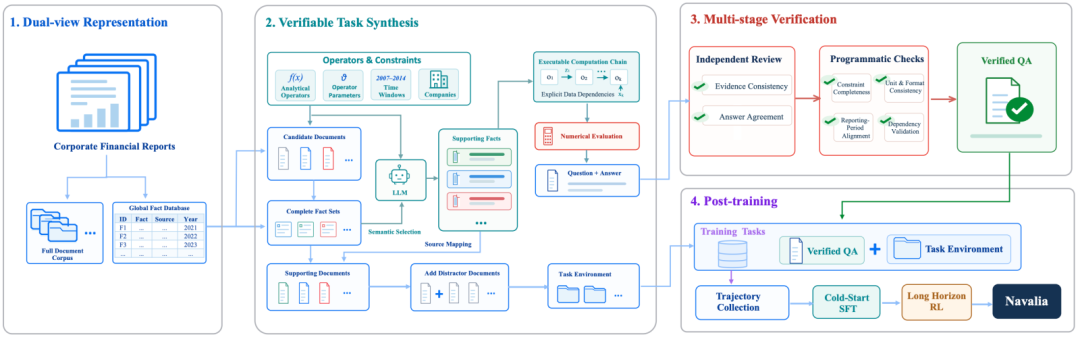
图2:Navalia的环境构建、任务合成与后训练流程。
03 长程后训练:SFT与RL
Navalia 先让强教师模型在任务对应的文档环境里自主检索、分析、作答,采集完整交互轨迹。轨迹经过答案正确性、工具调用有效性和最低交互轮数三层筛选,再按分析算子或组合模板分组均衡采样,用于冷启动监督微调(SFT)。每一轮回复还会接受质量评估:低质量回复保留在后续交互上下文中,但不计入对应监督损失。
长程交互中,模型回复与工具返回不断累积,需要通过上下文管理控制可见历史。Navalia 在教师轨迹采集与 RL 在线采样中采用轻量化 ReAct Harness,并统一使用 FIFO 上下文管理:窗口最多保留 30 轮交互,以 10 轮为步长更新,较早的交互依次退出窗口。
在对照实验中,相较于逐轮滑动窗口,FIFO 将每条轨迹产生的平均样本数从 40.52 降至 3.90,减少 90.4%;OfficeQA Pro 准确率由 49.96% 提升至 51.56%。这一结果表明,在该设置下,FIFO 在减少训练样本数量的同时,保持了下游任务表现。
完成 SFT 后,Navalia 进入强化学习(RL)阶段。训练前先根据冷启动模型的采样成功率筛任务,重点练那些“确实可解、但当前模型还不能稳定完成”的题目,再通过在线交互继续优化策略。
长轨迹被划分为多个片段后,早期行动怎么获得反馈?Navalia 根据完整轨迹的最终任务奖励计算组相对优势,并在同一轨迹的所有片段间共享。这样一来,前面的证据检索、工具选择和分析行为,也能拿到基于最终任务结果的训练信号。对于因单次回复达到生成长度上限而终止的轨迹,Navalia 仍将最终奖励纳入优势计算与动态采样统计,但屏蔽整条轨迹的策略损失,减少截断失败对前期有效探索的不当惩罚。
04 五项基准,检验能力能否迁移
这套配方想达成的目标很明确:让 Agent 学会在复杂工作环境里查找材料、整合证据、调用工具,并把多步任务持续推到底。团队用五项基准检验这些能力能否迁移到新场景。这些基准覆盖文档问答、专业研究、跨应用操作等不同任务形态,评估模型能否把训练中形成的检索、推理和工具使用能力,搬到全新材料和流程上。
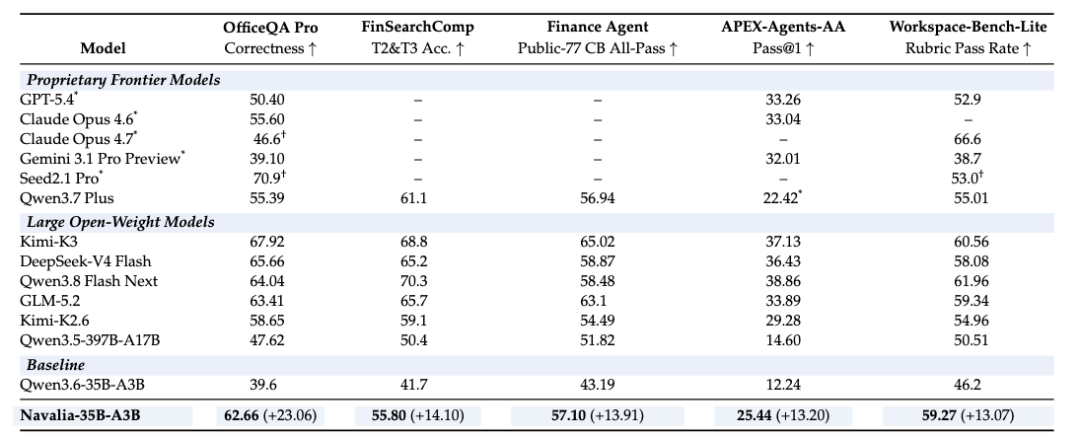
图3:Navalia在五大基准上的主结果。
与同配置评测的较大模型相比,Navalia 在五项基准上的得分全部超过 Qwen3.5-397B-A17B;在 Finance Agent Benchmark 和 Workspace-Bench-Lite 上,还比 Kimi-K2.6 和 DeepSeek-V4-Flash 分别高出 2.61% 和 1.19%。这说明针对性的任务构造与后训练,确实能有效提升 35B 模型在复杂专业与办公任务里的竞争力。如果你经常需要在不同大模型 API 之间切换做对比评测,RouteFast.ai 这类聚合中转服务会省不少事。
进一步分析 OfficeQA Pro 的交互轨迹,可以看到性能提升背后的行为变化:训练后,找齐全部支撑文档的任务比例从 45.4% 升至 69.8%,支撑文档召回率从 50.8% 升至 74.7%。模型能够更完整地获取任务所需的关键证据,为后续分析与作答提供更充分的依据。
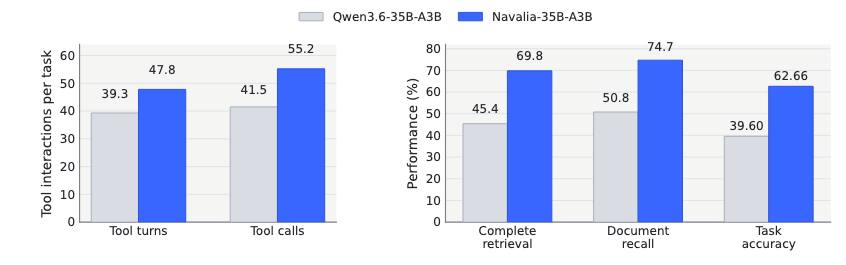
图4:Navalia与基座模型在OfficeQA Pro上的工具使用、证据检索与任务准确率对比。
在不同的执行框架中,Navalia 也保持了性能优势。在采用与训练阶段不同 Harness 的 APEX-Agents-AA 和 Workspace-Bench-Lite 上,Navalia 较基座模型分别提升 13.20 和 13.07 个百分点。跨任务、跨 Harness 的评测结果进一步表明,这套训练配方形成的能力可以迁移到新的任务与交互环境中。
Navalia 的完整配方从文档双视图、可验证任务合成一路覆盖到长程后训练,把环境、数据和策略迭代连成闭环。对 Agent 训练或文档智能感兴趣的开发者,不妨到 云栈社区 里看看更多相关实践与讨论。
 发表于 1 小时前
|
查看: 6|
回复: 0
 /1


