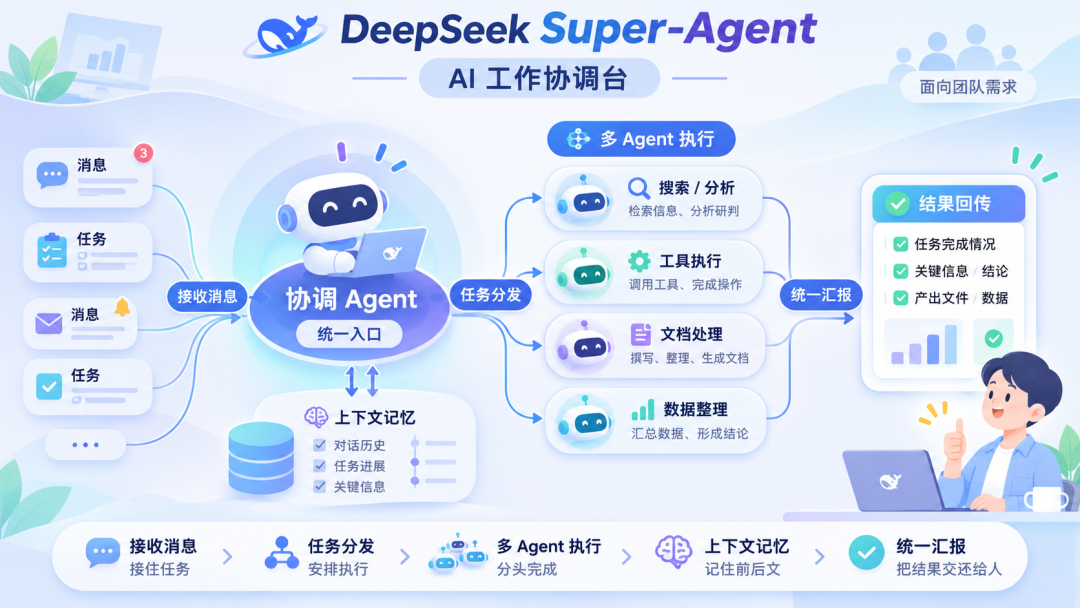
DeepSeek 开源了一套名为 Super-Agent(超级 Agent 系统) 的研究原型。它探索的不是怎样让一个 AI 回答得更好,而是:当 AI 同时面对多项工作和不断到来的消息时,怎样接住任务、安排执行、记住前后文,并把结果交还给人。
简单说,Super-Agent 像一个 AI 工作协调台:一个 Agent 负责接收和协调,多个 Agent 在后台分头执行,最后由统一入口汇报。
下面用一个团队需求的例子,看看这套系统为什么需要、怎样运作,以及目前的开源原型实际覆盖到哪里。
一、为什么需要 Super-Agent?
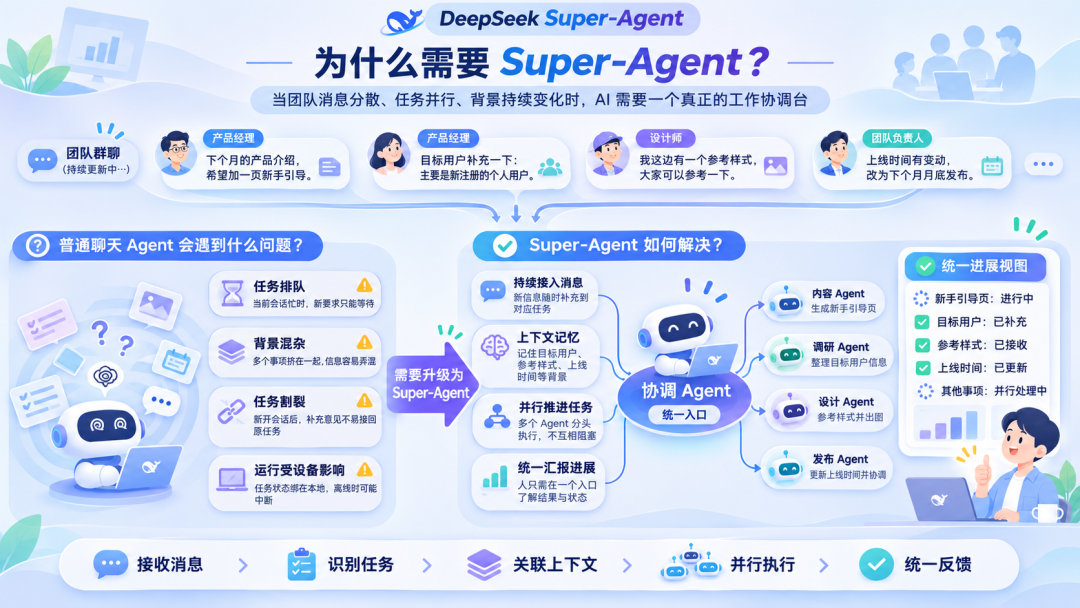
假设团队群里有人提出:“下个月的产品介绍,希望加一页新手引导。”产品经理补充目标用户,设计师发来参考样式,负责人又调整了上线时间。相关信息散在不同消息里,团队还可能同时推进其他事项。
即使有 AI 帮忙,人仍得自己盯着好几段对话:把消息转给 AI、重复补充背景、确认它有没有处理完。AI 越能做事,人有时反而越像调度员。
如果只是给一个普通聊天 Agent 接入群聊和文档消息,也还有几个问题:
- 任务排队:一个会话忙着处理当前工作时,新要求可能只能等。
- 背景混杂:不同事项都挤在同一段对话里,模型容易把信息弄混。
- 任务割裂:每条消息都新开会话,虽然能同时处理,但后续补充意见不一定能接回原任务。
- 运行受设备影响:如果思考过程和任务状态都绑在一台电脑上,电脑离线时工作也可能中断。
Super-Agent 要解决的,正是多项工作如何持续接入、并行推进,同时让人仍能统一了解进展。
二、Super-Agent 的总体架构是什么?
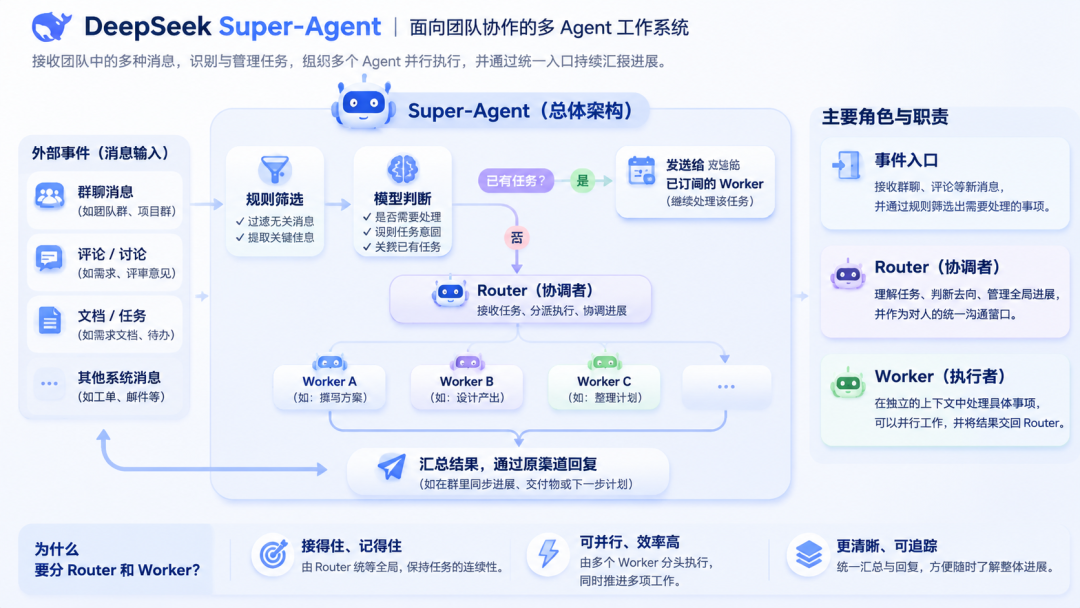
先看全貌。Super-Agent 不只是几个 Agent 组成的小组,而是一套接收事件、管理任务、执行工作并持续运行的系统。它的消息流大致如下:
群聊、评论等外部事件
          ↓
规则筛选 → 模型判断是否需要处理
          ↓
已有任务? ── 是 → 发送给已订阅的 Worker
          │
          否
          ↓
       Router 接收并分派
          ↓
多个 Worker 并行执行
          ↓
Router 汇总,通过原渠道回复
图里的几个角色可以这样理解:
- 事件入口:接收群聊、评论等新消息,并筛掉明显无关的内容。
- Router(协调者):判断新事项交给谁,协调不同任务,并作为对人的统一沟通窗口。
- Worker(执行者):在各自独立的上下文里处理具体事项,可以并行工作,再把结果交回 Router。
为什么要有 Router 和 Worker 两层?可以想象一个人同时负责接收所有需求、亲自完成每件事:事情有连续性,但只能一件件做。反过来,如果每来一条消息就换一个人处理,速度可能更快,却没人记得这些工作之间有什么联系。
Super-Agent 把两种职责分开:Router 像协调人,记住全局情况并安排工作;Worker 像执行同事,各自专心处理一项任务。这样既能接续相关消息,也能同时推进几件事。
三、团队需求如何被接住和推进?
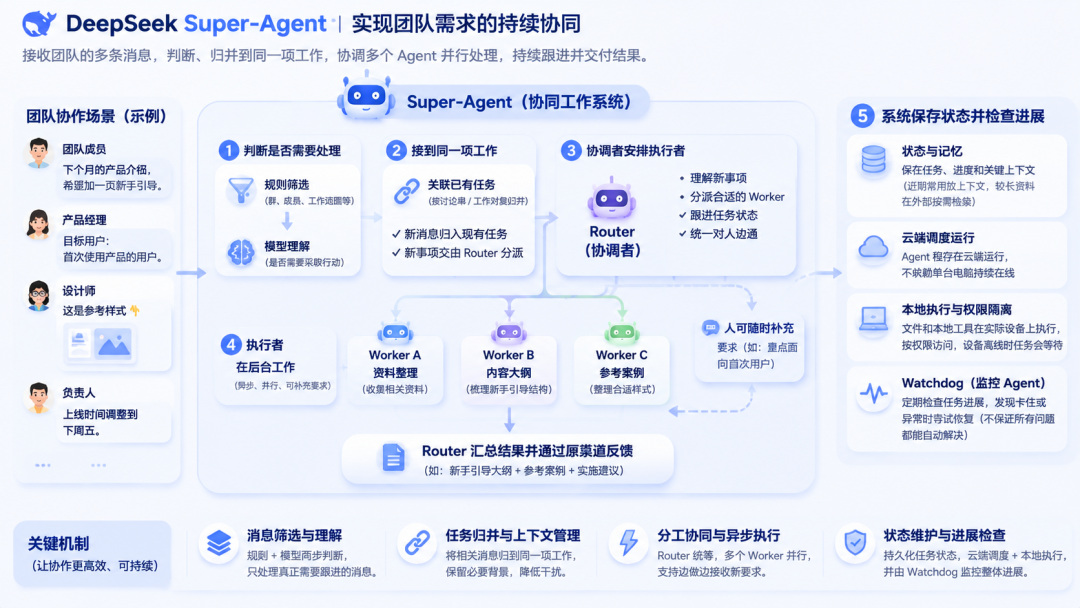
下面跟着“新手引导”这项团队需求,看一条消息如何进入系统、找到负责的 Agent,再一步步变成可交付的结果。
第一步:判断消息是否需要处理
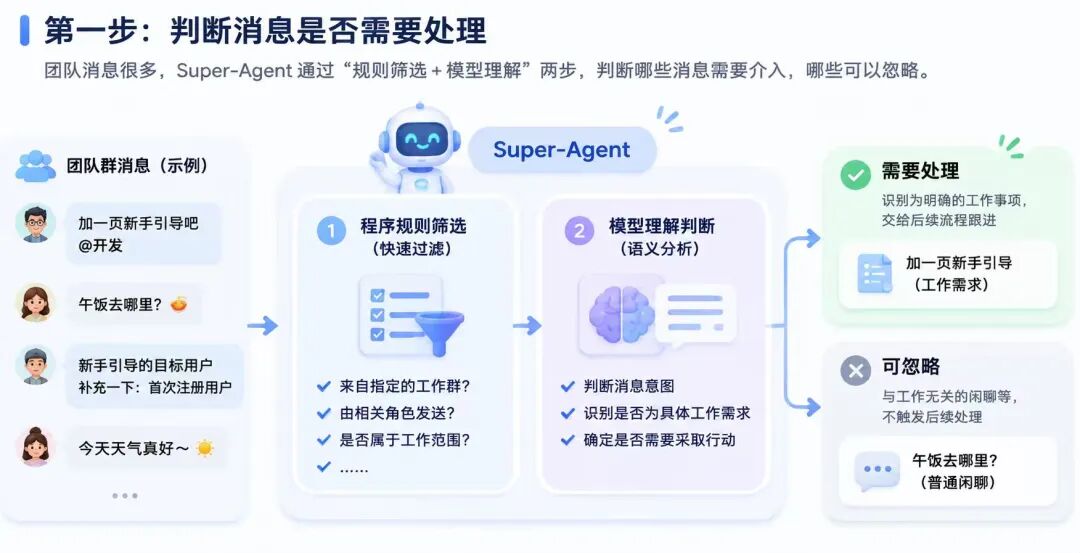
团队群里的消息很多,并非每条都需要 Agent 介入。Super-Agent 的设计把判断分成快慢两步:先用程序规则筛选,例如消息来自哪个群、谁发的、是否属于指定工作范围;通过筛选后,再由模型理解消息内容,判断要不要采取行动。
比如“加一页新手引导”可能是需要跟进的工作;普通闲聊则可以忽略。这样不必让模型对所有消息都做完整分析。
第二步:把相关消息接到同一项工作
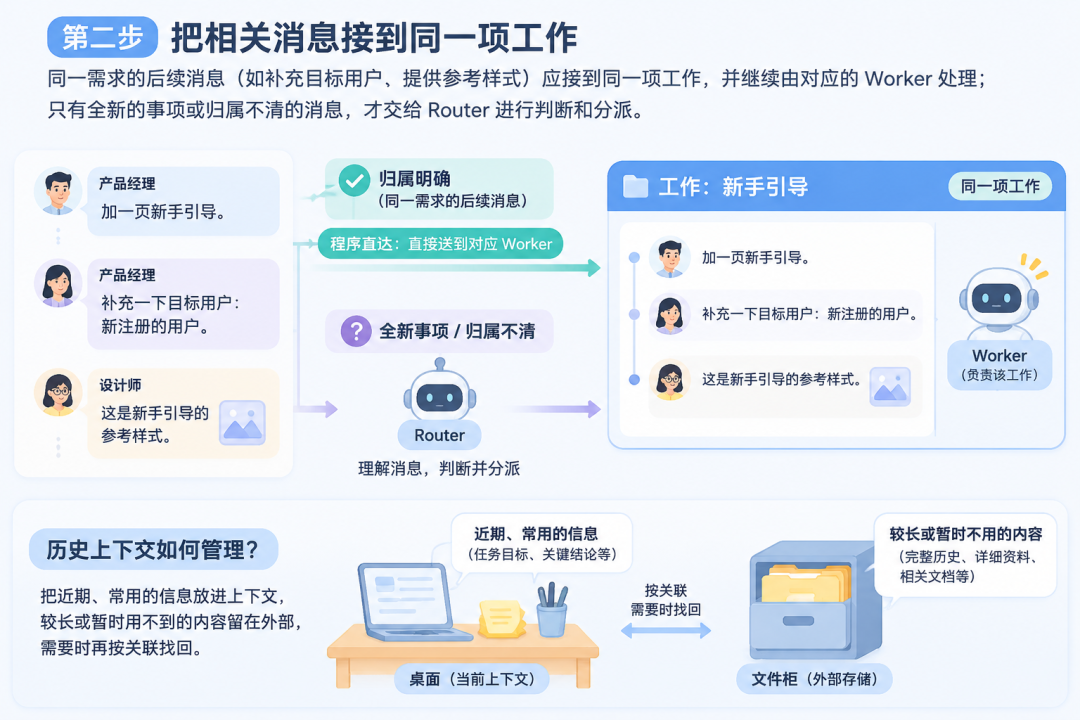
如果产品经理随后补充目标用户,设计师发来参考样式,这些内容都属于刚才的新手引导需求,系统应当把它们接到同一项工作,而不是重新开一个互不相关的对话。
在 Super-Agent 的设计里,同一个讨论串或工作对象可以关联到负责它的 Worker。后续消息若归属明确,就能直接送到那个 Worker;如果是全新的事项,再交给 Router 判断和分派。
这样,已知归属的消息走程序直达这条“快路”,只有新事项或归属不清时才需要 Router 推理。这能减少协调开销,也避免每条后续消息都重新做一次任务分派。
不过消息送到 Worker 后,还要决定给它看多少历史。把所有内容都塞进上下文,会占用模型的注意力;只给当前一句话,又可能缺少必要背景。
设计思路是把近期、常用的信息直接放进上下文,把较长或暂时用不到的内容留在外部,需要时再按关联找回。可以理解为把常用资料放在桌面,不常用的收进文件柜,并在桌上留好索引。
第三步:协调者安排执行者
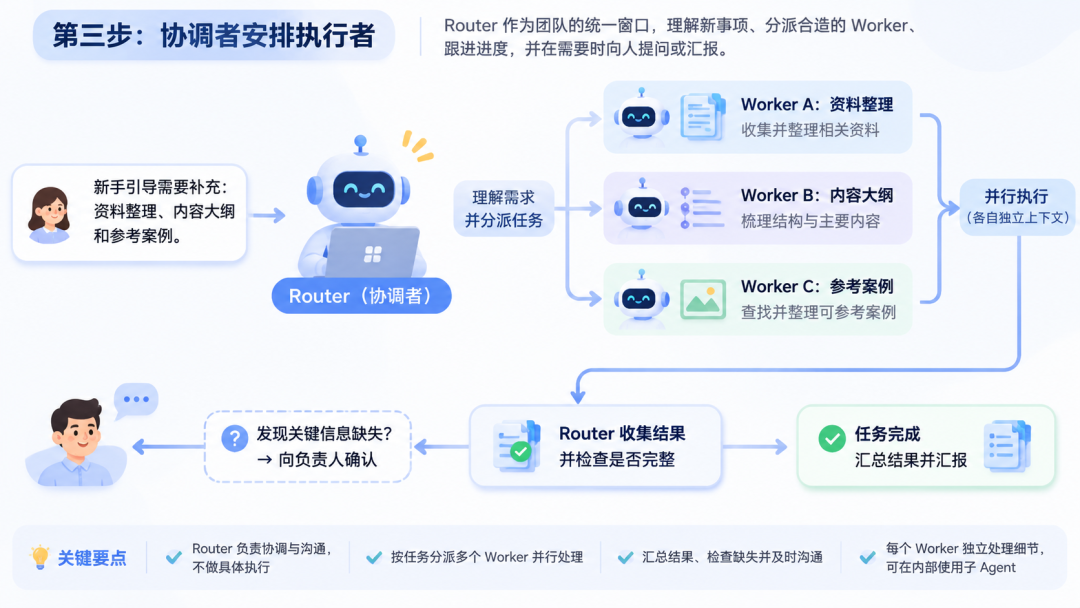
Router 是对团队的统一窗口,也像项目协调人。它理解新事项的大意、安排 Worker、跟进状态,并决定何时向人提问或汇报。Router 被设计成轻量协调层,不负责完成所有具体工作,甚至可以不配置执行命令的工具。这样它能专注于跨任务的联系和对人的沟通。
比如新手引导需求中,资料整理、内容大纲和参考案例可以分别交给不同的 Worker 并行准备;Router 收集结果,发现缺少关键信息时再请负责人确认。
Worker 处理的细节不会都挤进 Router 的上下文里。每个 Worker 在自己的上下文中专注一项工作;它也可以在内部再使用子 Agent,Router 不必参与每个执行步骤。
第四步:执行者在后台工作,人可以继续补充要求
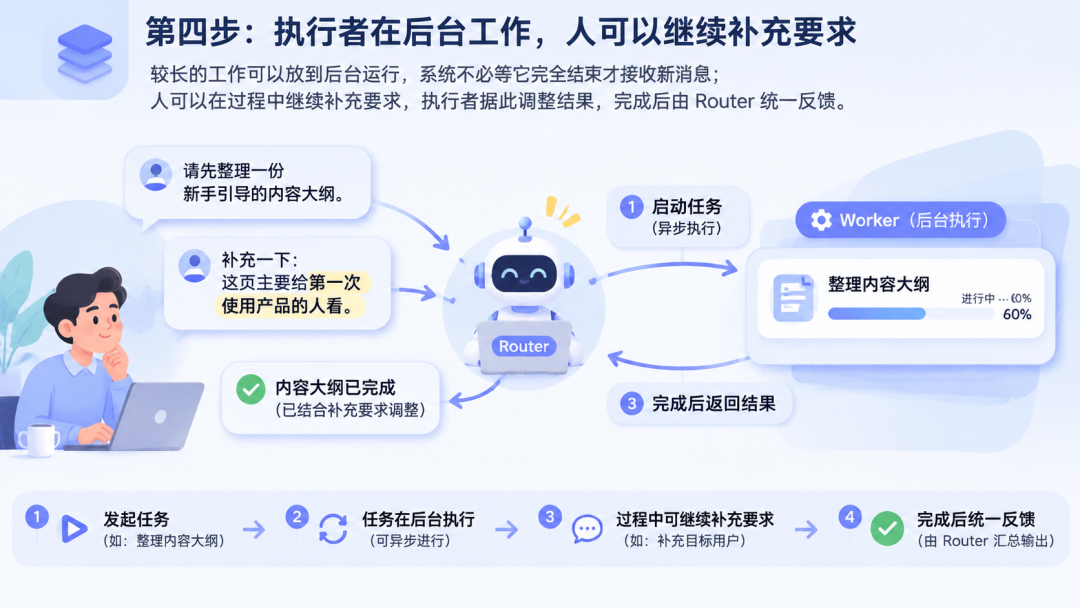
较长的工作可以放到后台运行,系统不必等它完全结束才接收新消息。技术上,这类操作采用异步方式:Agent 发起任务后先拿到“已启动”的结果,任务完成后再把结果作为新事件送回;如果不再需要,也可以停止后台任务。
例如,内容大纲还在整理时,负责人补充“这页主要给第一次使用产品的人看”。这条新信息可以回到相关任务中,Worker 据此调整结果。完成后,Worker 把产出交给 Router,由 Router 统一反馈。
第五步:系统保存状态并检查进展
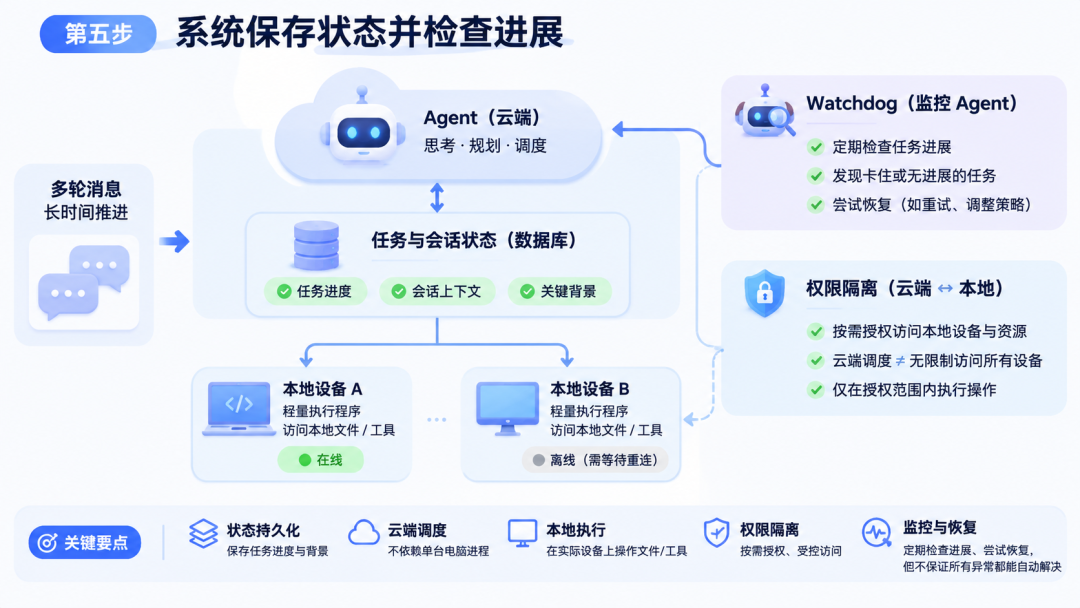
要让工作跨越多条消息和较长时间继续推进,系统需要保存任务状态和相关背景。设计上把三件事拆开:负责思考和调度的 Agent 程序可以在云端运行,会话和任务状态保存在数据库,文件和本地工具则留在实际工作的设备上,由设备上的轻量程序执行需要本地环境的操作。
这样,Agent 的运行不必和一台电脑上的单个进程绑在一起;但如果某项工作必须访问的设备离线了,它仍要等设备重新连接。云端调度和本地执行之间也必须做好权限隔离,不能把“持续在线”误解成“可以不受限制地访问所有设备”。
系统还可以安排一个 Watchdog(监控 Agent)定期检查任务是否卡住或失去进展。它可以发现问题并尝试恢复,但不能保证所有异常都能自动解决。
四、用这套架构,团队的工作方式会怎样变化?
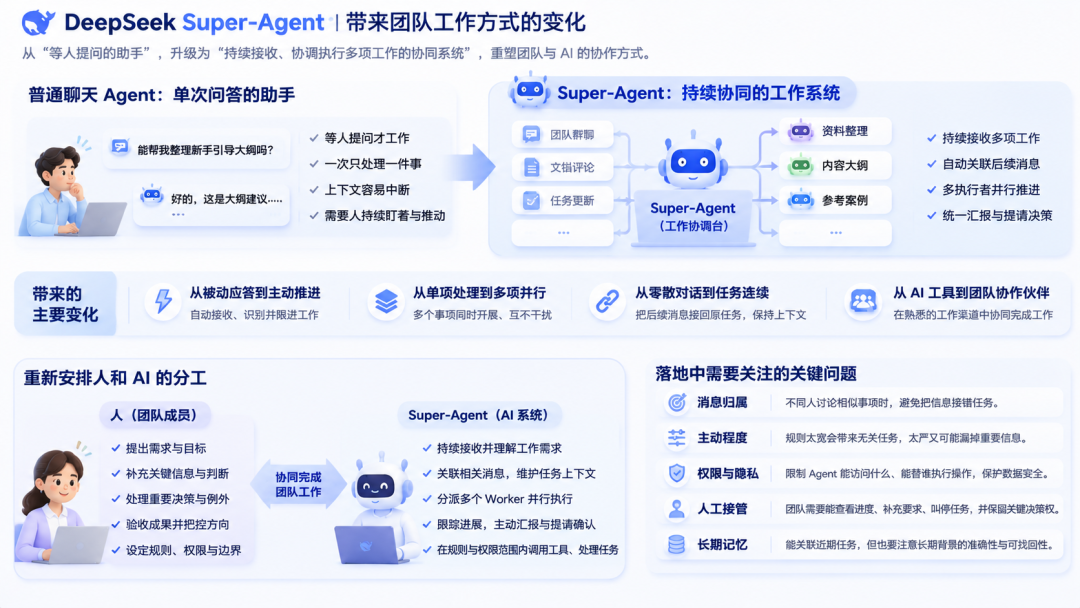
普通聊天 Agent 更像一个等人提问的助手;Super-Agent 希望成为持续接收工作、协调多个执行者的系统。
对团队来说,理想状态是:成员在熟悉的工作渠道里提出要求、补充信息,Agent 负责把相关内容接续起来,在后台推进不同事项,再把需要人决定或验收的结果提出来。
它和常见的 多 Agent 团队 也有侧重点差异。多 Agent 团队通常关心怎样把一项复杂工作拆成子步骤;Super-Agent 更关心怎样管理多项持续到来的工作。
两者可以结合:一个 Worker 内部仍然可以再用多个 Agent 合作。可以把差别理解为:Agent Team 像一组同事围绕一个项目分工;Super-Agent 还多了一层持续运作的工作台,接收不同事项、把后续消息接回原任务,并统一决定什么时候需要团队介入。
这套设计还要面对什么问题?
把任务交给系统协调,不代表人可以完全不管。至少还要处理这些问题:
- 消息归属:不同人同时讨论相似事项,系统可能把信息接错任务。
- 主动程度:规则太宽会带来无关任务和通知,太严又会漏掉值得处理的消息。
- 权限与隐私:Agent 可能接触文件、工具和凭据,需要限制它能访问什么、能替谁执行操作。
- 人工接管:团队需要能查看进度、补充要求、叫停任务,并在关键决定上保留控制权。
- 长期记忆:系统能关联近期任务,不代表几个月后的重要背景也一定能准确找回。
Super-Agent 更像是在重新安排人和 AI 的分工:系统负责持续接收、协调和执行,人负责设定边界、处理关键决定、验收结果。
五、开源原型目前覆盖到哪里?
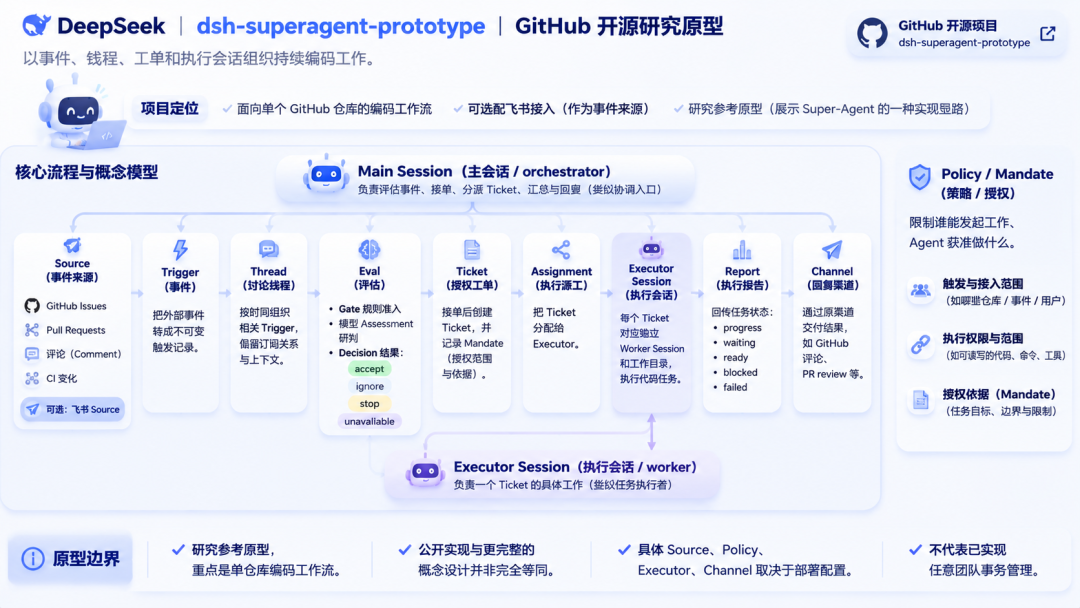
DeepSeek 已公开 dsh-superagent-prototype。仓库将它定位为研究参考原型,主要面向单个 GitHub 仓库的编码工作流,也可以选配飞书接入。
公开文档能看到 Source、Trigger、Thread、Ticket、Main Session 和 Executor Session 等实际概念,以及事件接入、任务授权、执行和面板等实现内容。
仓库也明确说明,公开实现与内部版本及技术文章讨论的完整设计并不完全相同,有些设计方向尚未在原型中实现。
上文介绍的 Router/Worker 分工、快慢路径和状态分离,帮助解释的是整体架构思路;不能据此认为开源原型中的每个设想都已完整落地,或已经适用于任意团队工作流。
结语:从独立对话到持续协作系统
Super-Agent 讨论的核心,不是简单地多开几个 Agent,而是如何让工作持续进入系统、把相关消息接回已有任务、让多个执行者并行推进,并由统一入口向人汇报。Router、Worker、事件筛选、异步执行、状态保存和 Watchdog,分别承担协调、执行、接收、续跑、记忆和检查等职责,共同组成一个面向多任务的 Agent 系统。
DeepSeek 的开源原型提供了一个可供研究和实践的起点,但具体能力要以公开实现为准。是否采用类似架构,最终要看任务是否需要持续接收外部事件、并行推进多项工作,以及团队能否清楚地验证结果并保留必要的控制权。
 发表于 昨天 23:52
|
查看: 4|
回复: 0
 /1


