尼恩说在前面
最近有小伙伴在准备一线互联网企业(如得物、阿里、滴滴、极兔、有赞、希音、百度、网易、美团、蚂蚁等)的面试时,遇到一系列与 Jev 相关的问题。比如,有同学面试大厂挂了,碰到这样一道题:
面试官问:Jev 为什么能做到比同类大模型快 193 倍、便宜 444 倍?
很多同学没有系统梳理过,面试不满意。类似的面试题还有:
相关面试题1:传统大模型为何在判断类任务中既慢又贵?
相关面试题2:Jev 的“单次前向传播+并行评估+强类型输出”架构,相比自回归生成有哪些本质优势?
下面我们就来系统梳理 Jev 在客服系统中的定位,以及如何与 LLM 组合成一套低成本、快响应的方案。
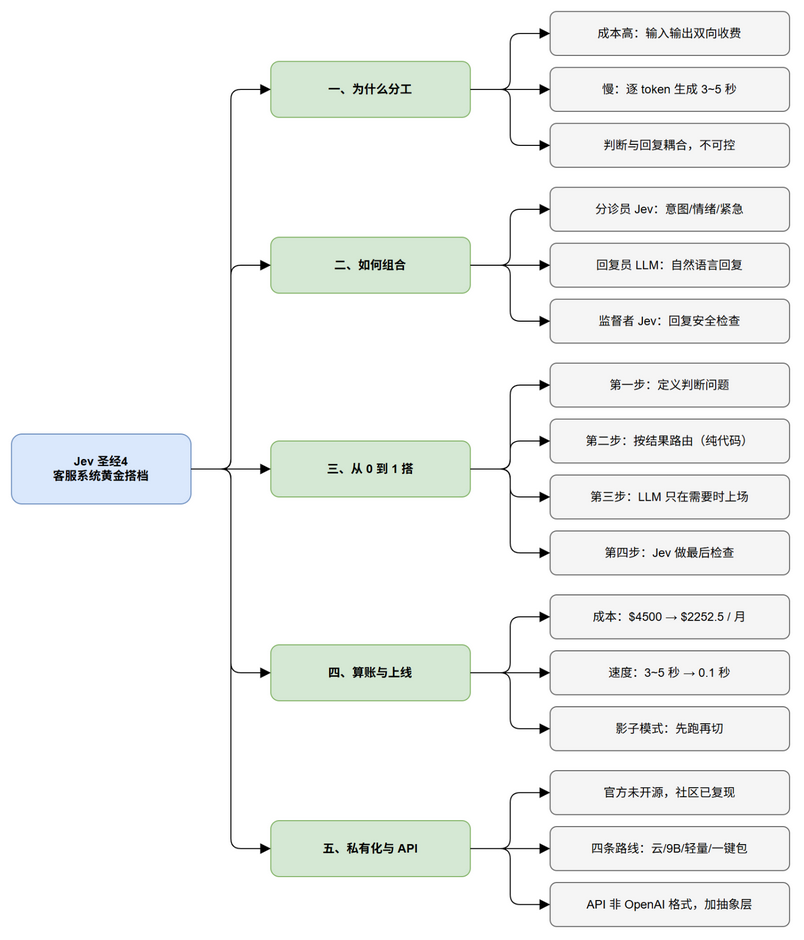
一、在客服系统里,Jev 和传统 LLM 怎么分工?
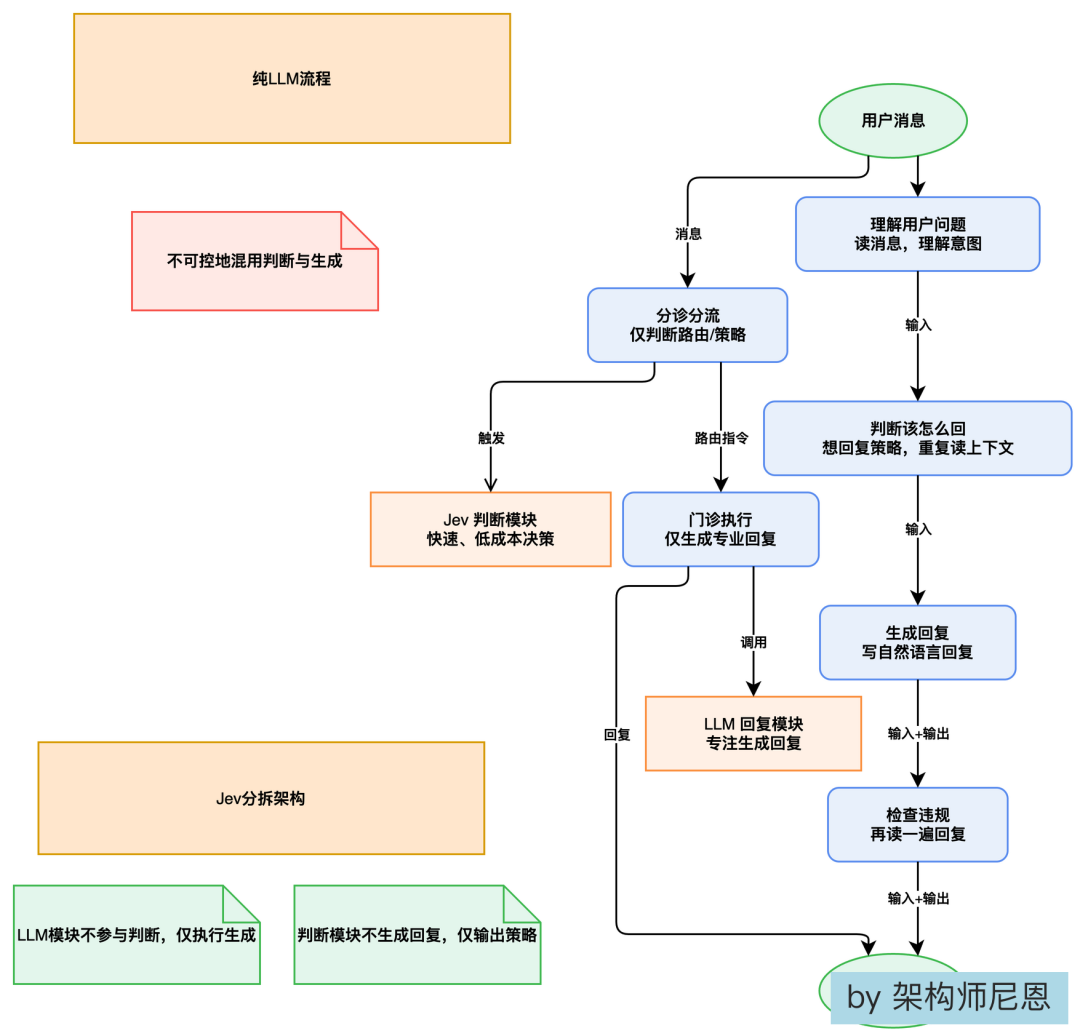
先看纯 LLM 方案的账。
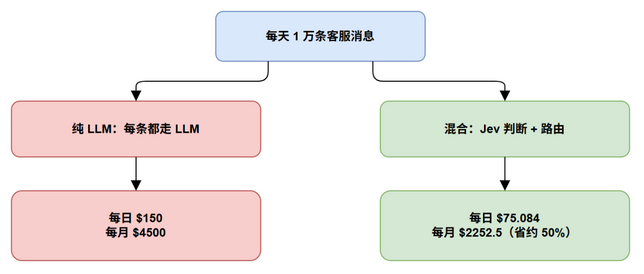
假设你有一个客服系统,每天处理 1 万条消息。每条消息进来,LLM 都要做判断 + 生成回复。
| 环节 |
做什么 |
花多少 |
| 理解用户问题 |
读消息,理解意图 |
输入 token 费用 |
| 判断该怎么回 |
想回复策略 |
输入 token 费用(重复读上下文) |
| 生成回复 |
写一段自然语言回复 |
输出 token 费用 |
| 检查有没有违规 |
再读一遍回复 |
又一轮输入 + 输出费用 |
打个比方:这就像你去餐馆吃饭。厨师不仅要做菜,还要自己点菜、自己摆盘、自己端给你、自己尝一遍咸淡。一道菜下来,每个环节都要额外花时间。
纯 LLM 方案的三个代价:
第一个代价:成本高。 每条消息,LLM 要读上下文(输入),还要生成回复(输出)。输出 token 的价格通常是输入的 3~5 倍。
打个比方:你坐出租车,起步价是输入费用。但你每多说一句话,计价器就跳一次——这是输出费用。你跟司机聊一路,最后车费能多一半。
具体数字:按当红旗舰模型的价格,输入 $10/百万 token,输出$50/百万 token。一条客服消息,假设输入 500 token,输出 200 token。单条成本 = 500×$10/1M + 200×$50/1M = $0.005 +$0.01 = $0.015。
一天 1 万条,就是 $150。一个月$4500。
第二个代价:慢。 LLM 生成回复要逐 token 输出。一条 200 token 的回复,大概要 3~5 秒。用户发消息过来,等 3 秒才收到回复,体验不算好。
打个比方:这就像你给客服发微信,对方每打一句话都要想 3 秒。你发一句"在吗",过 3 秒收到"在的"。你问"我的快递到哪了",又过 5 秒收到回复。聊 10 句,等了 40 秒。
第三个代价:判断和回复混在一起,不可控。 你让 LLM 做判断的时候,它顺便把回复也写了。你没法单独控制判断这一步。万一它判断错了,回复也跟着错。
打个比方:这就像一个裁判同时当运动员。他既判罚又下场踢球,你没法保证他判罚是公正的——因为他自己就是运动员。
Jev 能解决什么? Jev 把判断这一步单独拆出来。判断的事,Jev 干,又快又便宜。回复的事,还是 LLM 干。两者分开,各干各的。
打个比方:这就像医院里分诊台和门诊分开。分诊护士只管分流,医生只管看病。分诊错了不影响医生看病,医生看不好也不怪分诊台。
二、Jev + LLM 如何组合?
核心思路:判断交给 Jev,回复交给 LLM。
打个比方:这就像医院的分诊台和门诊医生。分诊护士(Jev)负责判断该挂哪个科、病情有多急。门诊医生(LLM)负责看病、开处方、跟病人解释病情。
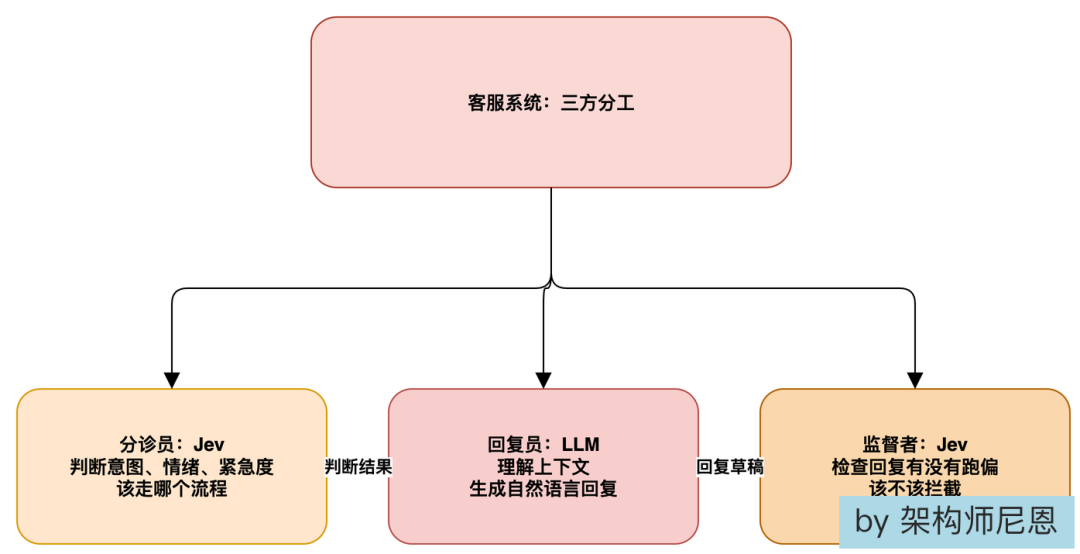
| 角色 |
谁来干 |
干什么 |
| 分诊员 |
Jev |
判断用户意图、情绪、紧急程度、该走哪个流程 |
| 回复员 |
LLM |
理解上下文,生成自然语言的回复 |
| 监督者 |
Jev |
检查 LLM 的回复有没有跑偏,该不该拦截 |
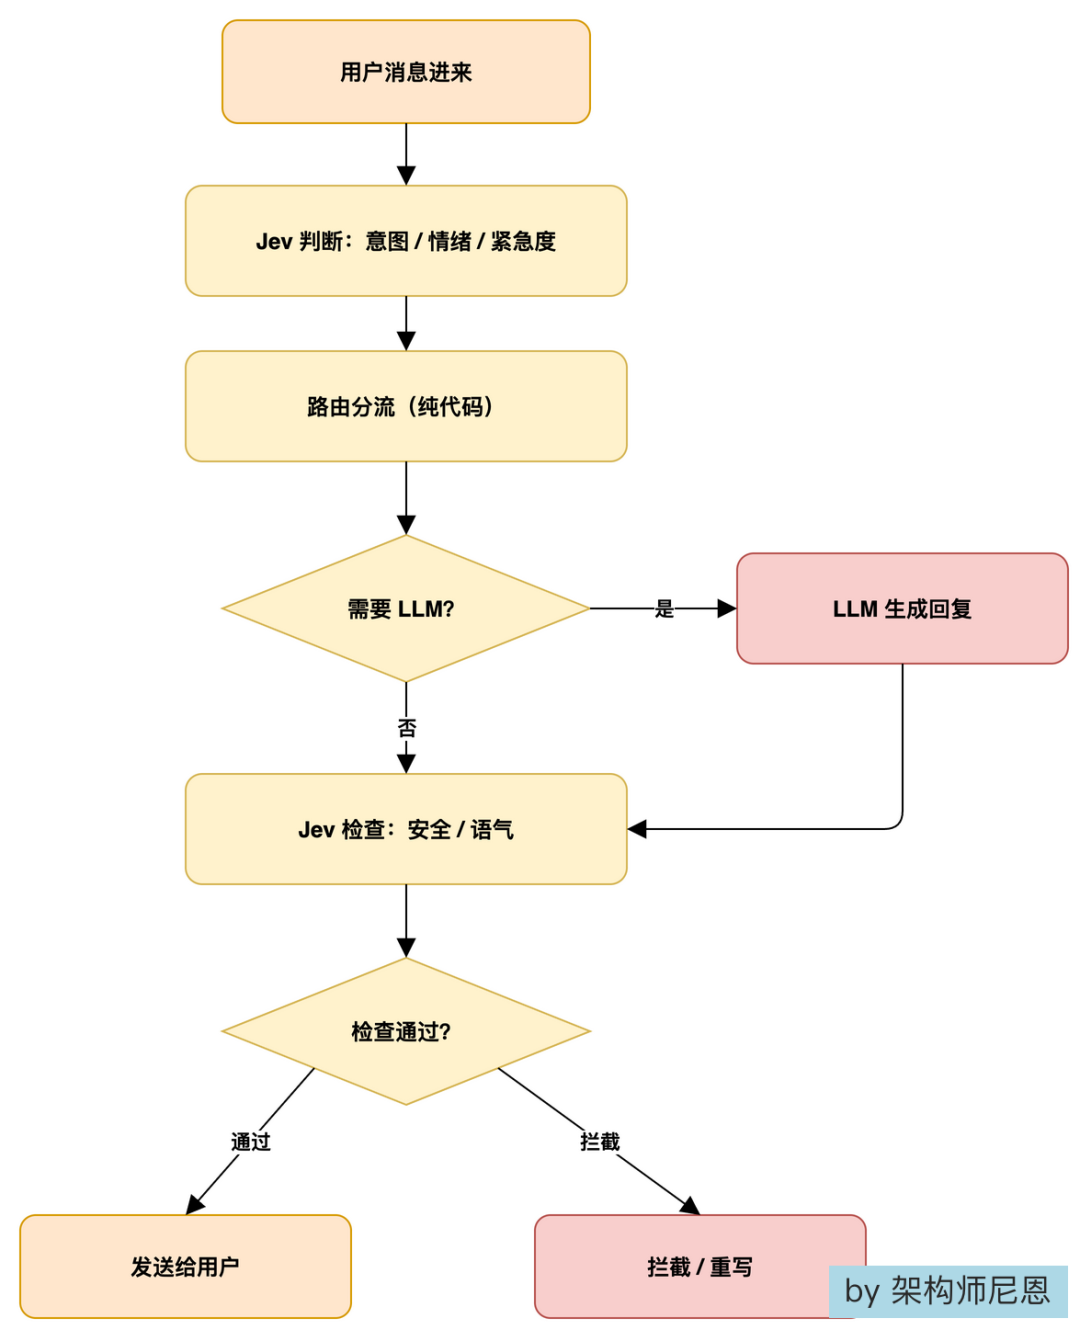
整个流程跑下来,是这样的:
用户消息进来
    ↓
Jev 判断:意图是什么?情绪多激动?紧急程度?
    ↓
路由:简单问题走自动回复,复杂问题转 LLM,紧急问题转人工
    ↓
LLM 生成回复(如果需要)
    ↓
Jev 检查:这个回复安全吗?有没有违规?
    ↓
发送给用户 / 拦截人工审核
为什么要这么分? 因为客服系统每天要处理海量消息。每一条消息进来,都要做一堆判断:这是咨询还是投诉?这个用户生气了没有?这个问题该走自动流程还是转人工?以前这些判断全交给 LLM。一条消息进来,LLM 读完、想完、写完一段话,再从这段话里把判断抠出来。又慢又贵。现在把判断这一步拆给 Jev。Jev 不生成文字,直接返回选项和概率。LLM 只在需要写回复的时候才上场。
打个比方:这就像你公司以前只有一个全能员工,从接电话到写方案到做财务全包了。现在你招了一个专职前台(Jev),专门负责接电话、分流。原来那个全能员工(LLM)就专心做方案。
三、从 0 到 1 搭一套 Jev + LLM 组合
第一步:定义判断问题
先想清楚:一条客服消息进来,我们要做哪些判断?
打个比方:你开一家店,顾客进来了,你得先判断他是来吃饭的、还是来问路的、还是来找茬的。不同的人,走不同的流程。
在客服场景里,通常要判断这几件事:
| 判断项 |
类型 |
选项 / 刻度 |
| 用户意图 |
Choice |
咨询 / 投诉 / 退款 / 查询订单 / 其他 |
| 情绪程度 |
Score |
1~10 分 |
| 是否需要转人工 |
Noul |
是 / 否 |
| 紧急程度 |
Choice |
低 / 中 / 高 / 紧急 |
| 是否涉及金额 |
Noul |
是 / 否 |
这些判断,一次调用 Jev 全部搞定。
# 一次问完所有判断项
result = jev.ask(
    state=user_message,
    questions=[
        {"type": "choice", "question": "用户意图?",
         "options": ["咨询", "投诉", "退款", "查询订单", "其他"]},
        {"type": "score", "question": "情绪程度?", "scale": [1,2,3,4,5,6,7,8,9,10]},
        {"type": "noul", "question": "是否需要转人工?"},
        {"type": "choice", "question": "紧急程度?",
         "options": ["低", "中", "高", "紧急"]},
    ]
)
一次调用,4 个判断全部返回。不用分 4 次问。
打个比方:这就像你去医院挂号。分诊护士一次性问完:哪里不舒服?多久了?有没有发烧?一次性把所有判断做完。不用问完一个,再问下一个。
第二步:按判断结果路由
判断完了,按结果分流。这一步是纯代码逻辑,不调模型。
打个比方:这就像高速公路的匝道。车到了这里,按目的地不同走不同的匝道。有的去北京,有的去上海,有的去天津。不用车自己选路,收费站直接指引。
路由逻辑长这样:
# 路由分流
intent = result["用户意图?"]["choice"]
emotion = result["情绪程度?"]["score"]
urgency = result["紧急程度?"]["choice"]
need_human = result["是否需要转人工?"]["probability"]
if need_human > 0.8:
    route_to_human()           # 明确需要人工,直接转
elif urgency == "紧急":
    route_to_vip_queue()       # 紧急问题,进优先队列
elif intent in ["查询订单", "咨询"]:
    route_to_auto_reply()      # 简单问题,走自动回复
else:
    route_to_llm()             # 其他情况,交给 LLM 处理
这里的关键是:简单问题不碰 LLM。查询订单这种事,Jev 判断完,直接走数据库查单,自动回复就完了。不用让 LLM 生成一段话。
打个比方:这就像你打银行客服电话。问"余额还有多少",语音播报直接告诉你。不用转人工,也不用跟你聊半天。
第三步:LLM 只在需要的时候上场
哪些情况需要 LLM?
| 场景 |
为什么需要 LLM |
| 复杂投诉,需要共情和解释 |
Jev 只会判断,不会写共情的话 |
| 用户情绪激动,需要安抚 |
需要自然语言,有温度 |
| 多个问题混在一起,需要拆解 |
需要理解上下文,组织语言 |
| 需要生成个性化的回复 |
需要创造力,不是干巴巴的模板 |
LLM 上场的时候,Jev 已经把判断结果给它了。LLM 不用再重新判断一遍,直接基于判断结果写回复。
# LLM 生成回复
reply = llm.generate(
    system_prompt="你是一个客服,用户在投诉退款问题",
    user_message=user_message,
    context=f"用户情绪:{emotion}/10,紧急程度:{urgency}",
)
打个比方:这就像医生看病。分诊护士已经把病情告诉你了(哪里不舒服、多久了、严重不严重)。你直接写诊断和处方就行,不用再从头问一遍病史。
第四步:Jev 做最后一道检查
LLM 写了回复,发出去之前,Jev 再检查一遍。
打个比方:这就像新闻联播的审稿。稿子写完了,总编先看一遍,有没有错别字、有没有敏感内容、有没有跑偏方向。没问题了,才播出去。
检查什么?
# 回复安全检查
check = jev.ask(
    state=reply,
    questions=[
        {"type": "noul", "question": "回复是否包含违规内容?"},
        {"type": "noul", "question": "回复是否准确回答了用户问题?"},
        {"type": "choice", "question": "回复语气?",
         "options": ["友好", "中性", "生硬", "冒犯"]},
    ]
)
根据检查结果决定:
# 根据检查结果分流
if check["回复是否包含违规内容?"]["probability"] > 0.5:
    block_reply_and_review()   # 有违规,拦截人工审核
elif check["回复语气?"]["choice"] in ["生硬", "冒犯"]:
    regenerate_reply()          # 语气不对,让 LLM 重写
else:
    send_reply()                # 没问题,发送给用户
打个比方:这就像快递发货前的质检。流水线下来的包裹,质检员抽查一遍。有问题的打回去重做,没问题的发货。
四、算一笔账:成本降了多少
假设条件:
- 每天处理 1 万条客服消息
- 纯 LLM 方案:每条消息都走 LLM
- 混合方案:Jev 做判断 + 路由,简单问题自动回复,复杂问题走 LLM
纯 LLM 方案的成本:
| 项目 |
数值 |
| 输入 token(每条) |
500 |
| 输出 token(每条) |
200 |
| 输入价格 |
$10 / 百万 token |
| 输出价格 |
$50 / 百万 token |
| 单条成本 |
$0.005 +$0.01 = $0.015 |
| 每日成本(1 万条) |
$150 |
| 每月成本 |
$4500 |
混合方案的成本: 先分流。假设:
| 分流去向 |
占比 |
数量 |
| 直接转人工(不用模型) |
10% |
1000 条 |
| 自动回复(Jev 判断 + 模板回复) |
40% |
4000 条 |
| 走 LLM 生成回复 |
50% |
5000 条 |
Jev 判断的成本:
- 每条消息都调一次 Jev 做判断
- 输入 token:200(用户消息 + 问题定义)
- Jev 输出免费
- 单条成本:200 × $0.042 / 1M =$0.0000084
- 1 万条成本:$0.084
LLM 的成本(只处理 5000 条):
- 输入 token:500
- 输出 token:200
- 单条成本:$0.015
- 5000 条成本:$75
混合方案总成本:
| 项目 |
成本 |
| Jev 判断(1 万条) |
$0.084 |
| LLM 生成(5000 条) |
$75 |
| 每日总成本 |
$75.084 |
| 每月总成本 |
$2252.5 |
对比一下:
| 方案 |
每日成本 |
每月成本 |
| 纯 LLM |
$150 |
$4500 |
| Jev + LLM |
$75 |
$2252.5 |
| 节省 |
$75(省 50%) |
$2247.5(省 49.9%) |
打个比方:这就像你公司以前所有人都打出租车上班。现在你招了个前台(Jev),先判断谁住得近、谁可以坐地铁、谁必须打车。结果一半的人不用打车了,交通费省了一半。
速度呢?
| 环节 |
纯 LLM |
Jev + LLM |
| 判断意图 |
3~5 秒(LLM 生成 + 解析) |
0.1 秒(Jev 直接返回) |
| 简单问题回复 |
3~5 秒 |
0.1 秒(模板回复) |
| 复杂问题回复 |
3~5 秒 |
3~5 秒(LLM 生成) |
简单问题的响应时间,从 3~5 秒降到了 0.1 秒。用户发一条"我的订单到哪了",几乎是秒回。
打个比方:这就像你去银行办业务。以前不管办什么业务,都要等 5 号窗口的柜员一步步给你办。现在前台先分流:查余额的去自助机,1 分钟搞定。办贷款的才去柜台等。
五、上线前的准备:影子模式
不要一上来就全量切。先跑影子模式。
打个比方:这就像新司机上路。先在副驾驶坐着,看老司机怎么开。开了几周觉得自己行了,再自己开。
影子模式怎么跑?
| 步骤 |
做什么 |
| 1 |
Jev 在旁边跑,但不影响现有流程 |
| 2 |
记录 Jev 的判断结果 |
| 3 |
对比 Jev 的判断和实际结果,看对不对 |
| 4 |
根据数据调整判断项和阈值 |
| 5 |
先在低风险场景自动化 |
| 6 |
跑稳了,再逐步扩大范围 |
代码上怎么实现影子模式?
# 影子模式:Jev 跑,但不影响主流程
jev_result = jev.ask(state=user_message, questions=[...])
# 记录 Jev 的判断,但实际还是走原来的流程
log_to_database({
    "user_message": user_message,
    "jev_intent": jev_result["用户意图?"]["choice"],
    "jev_confidence": jev_result["用户意图?"]["confidence"],
    "actual_route": original_route,  # 原来的流程结果
})
跑一周,看数据:Jev 判断的意图,和实际走的流程,一致率是多少?不一致的地方,问题出在哪?
打个比方:这就像你给新来的实习生一个小本子,让他把每天看到的东西记下来。一周后你翻他的本子,看他观察得对不对。观察对了,再让他试着做点小任务。
调阈值的时候,用数据说话。 比如你设了一个"置信度 > 0.8 就自动执行"的门槛。跑了一周,发现置信度 0.8~0.9 区间的案例,实际正确率只有 70%。那这个门槛就得调。
# 根据数据调整阈值
# 跑了一周发现:confidence > 0.9 时正确率 95%
# confidence 0.7~0.9 时正确率 75%
# confidence < 0.7 时正确率 50%
AUTO_EXECUTE_THRESHOLD = 0.9   # 只有 0.9 以上才自动执行
HUMAN_REVIEW_THRESHOLD = 0.7   # 0.7 以下必须人工
打个比方:这就像你开车设限速。刚开始不知道路况,先设 60。开了一周发现这条路路况好,可以开到 80。但某个弯道事故多,就降到 40。所有的限速,都是根据实际情况调出来的。
总结一下:客服系统里怎么搭 Jev + LLM?
| 环节 |
用什么 |
干什么 |
| 意图判断 |
Jev |
一次调用,判断意图、情绪、紧急程度 |
| 分流路由 |
纯代码 |
按判断结果走不同流程 |
| 简单问题 |
Jev + 模板 |
不用 LLM,直接自动回复 |
| 复杂问题 |
LLM |
生成自然语言回复 |
| 安全检查 |
Jev |
LLM 回复发出去之前,Jev 审一遍 |
核心思路就一句话:判断的活交给 Jev,回复的活交给 LLM。 Jev 负责"快和省",LLM 负责"准和暖"。两者搭在一起,成本降一半,简单问题秒回,复杂问题有温度。这不是选 Jev 还是选 LLM 的问题,是怎么把它们俩配成一套最优组合的问题。
六、Jev 怎么私有化?需要多少算力?API 兼容吗?
TypeSafe 官方没有开源 Jev 的权重和训练方法。 到现在也没放出模型权重、完整架构和训练方案。你不能像部署 Llama 那样,直接去 Hugging Face 下一个官方 Jev 模型回来跑。
打个比方:这就像你买了一台品牌电脑,厂家把主板焊死了,不让你自己换零件。你只能用它的云服务,或者自己攒一台兼容机。
但开源社区已经把兼容机攒出来了。目前有三条路可以走:
| 方案 |
代表项目 |
模型大小 |
协议 |
适合谁 |
| 官方云 API |
TypeSafe 官方 |
闭源 |
商业 |
想快速上手、不折腾的团队 |
| 开源复现(大模型版) |
APUS OpenJev |
9B ~ 35B |
MIT |
有 GPU、追求效果的团队 |
| 开源复现(轻量版) |
Laya / Laya-MLX |
322M ~ 421M |
MIT |
普通电脑就能跑、追求轻量的团队 |
打个比方:这三条路就像你吃饭。官方 API 是去餐厅点菜,别人给你做好端上来。APUS 那种大模型版是自己买食材下厨,火候自己掌握。Laya 那种轻量版是煮泡面,开水一冲就能吃。
各方案的关键数据:
| 项目 |
参数规模 |
最低内存 |
延迟 |
硬件要求 |
| APUS OpenJev v1 |
9B |
~18GB(FP16) |
79 毫秒(RTX PRO 6000) |
需要 GPU |
| Laya 原版 |
421M / 322M |
~1GB |
33ms(Tesla T4) |
GPU 或 CPU |
| Laya-MLX |
421M / 322M |
687MB ~ 944MB |
7.4ms ~ 13.4ms(M3 Max) |
Apple Silicon Mac |
| 一键包(V2EX) |
DeBERTa-v3-large |
~1.66GB |
CPU 可跑 |
普通 Windows PC |
打个比方:最轻量的 Laya-MLX,322M 参数版本,内存只要 687MB。你拿个十年前的笔记本都能跑。打个游戏都卡的电脑,跑这个决策模型绰绰有余。
七、为什么需要 Jev 私有化?
用云 API 有三个代价。
第一个代价:数据要出你的服务器。 你把用户消息、业务数据、工单内容,全部发给 TypeSafe 的云。它们读到了,才能做判断。
打个比方:这就像你把公司的财务报表全部交给外面的会计事务所做分析。分析结果是给你了,但报表上的数字,人家也全看到了。如果你们行业对数据安全有要求,这就有问题。
哪些行业对数据安全敏感?
| 行业 |
敏感数据 |
| 金融 |
用户交易记录、风控判断 |
| 医疗 |
患者病历、诊断记录 |
| 法律 |
案件材料、客户隐私 |
| 政务 |
公文内容、市民信息 |
这些行业的客户数据,按法规要求可能根本不能出国,或者不能发到第三方云服务上。
第二个代价:用量大了之后,成本会累积。 云 API 按 token 收费。你刚开始用,一天几千次调用,花不了多少钱。但如果业务跑起来了,一天几百万次调用呢?
打个比方:这就像你用自来水。刚开始用水少,水费没多少。但如果你开了个洗车行,每天洗几百辆车,水费账单就不好看了。这时候自己挖口水井,反而更划算。
第三个代价:网络延迟和可用性。 每次调用都要走公网。你的请求发到 TypeSafe 的服务器,再从那里返回结果。中间经过的网络节点越多,延迟越高。
打个比方:这就像你跟隔壁工位的同事说话,得绕到总部再绕回来。本来两步路的事,因为要走外网,多花了几十毫秒。而且万一 TypeSafe 的服务挂了,你的系统也跟着停。你把命脉交到了别人手里。
私有化部署解决了什么?
| 问题 |
云 API |
私有化 |
| 数据安全 |
数据出服务器 |
数据不出内网 |
| 成本可控 |
按 token 计费,量越大越贵 |
一次性硬件成本,跑多久都行 |
| 延迟 |
走公网,几十毫秒起步 |
本地调用,亚毫秒级 |
| 可用性 |
依赖对方服务稳定性 |
自己掌控,想跑多久跑多久 |
打个比方:用云 API 就像租房子,每个月交租金,房东说涨租就涨租。私有化就像买房子,一次性付清,住多久都行,没人能把你赶出去。
八、私有化 Jev 具体怎么干?三种方案怎么选、怎么搭
方案一:APUS OpenJev(9B 大模型版)
适合谁: 有 GPU 服务器、追求判断准确率的团队。
技术路线:
- 底座模型:Qwen3.5 系列、Google Gemma 系列开源模型
- 复现方式:不改模型本身,在外面包一层"只输出选项概率"的工作流
- 开源地址:HuggingFace 上的
apus-ailab/APUS-OpenJev-v1
- 协议:MIT,随便用
硬件需求:
| 精度 |
9B 模型显存需求 |
推荐显卡 |
| FP16 |
~18GB |
RTX 4090 / RTX PRO 6000 |
| INT8 量化 |
~9GB |
RTX 3090 / RTX 4080 |
| INT4 量化 |
~5GB |
RTX 3060 12GB / RTX 4070 |
张旭博士的实测:RTX PRO 6000 上,单次决策时间 79 毫秒。和官方 Jev 的 70~500 毫秒,在同一水平线上。
代码怎么调:
# APUS OpenJev 调用方式
from openjev import OpenJevModel
model = OpenJevModel.from_pretrained("apus-ailab/OpenJev-v1")
result = model.ask(
    state="用户说:我被扣了两次钱,想要退款",
    questions=[
        {"type": "choice", "question": "该分给哪个部门?",
         "options": ["售前", "售后", "技术", "账务"]},
    ]
)
打个比方:这个方案就像你自己买了一套高级厨房设备,请了个大厨。硬件投入大,但做出来的菜味道好。适合每天要处理大量判断、对准确率有要求的场景。
方案二:Laya(轻量开源版 Jev)
适合谁: 普通服务器、甚至个人电脑,就能跑的场景。
技术路线:
- 底座模型:ModernBERT-large(421M)、mmBERT-base(322M)
- 协议:MIT,GitHub 10.4k Star
- 上下文:512 ~ 1024 token
- 支持语言:100+ 种语言
硬件需求:
| 版本 |
参数 |
峰值内存 |
M3 Max 延迟 |
| Laya 英文 |
421M |
~944MB |
13.42ms |
| Laya 多语言 |
322M |
~688MB |
7.39ms |
在 Tesla T4 上,单问题 33 毫秒,批量处理时平均 7.2ms/问题。
代码怎么调:
# Laya 调用方式
from laya import DecisionModel
model = DecisionModel.from_pretrained("laya-base-multilingual")
result = model.predict(
    state="这封邮件是关于账单问题的",
    questions=[
        {"type": "noul", "question": "是否涉及退款?"},
        {"type": "score", "question": "紧急程度?", "scale": [1, 2, 3, 4, 5]},
    ]
)
打个比方:这个方案就像你买了个微波炉。不用明火,不用大厨,插电就能用。做不出满汉全席,但热个饭、煮个泡面,分分钟的事。
方案三:Laya-MLX(Apple Silicon 原生版 Jev)
适合谁: 用 Mac 开发、或者想在 Mac 上跑本地决策的团队。
技术路线:
- 在 Apple MLX 框架上重新实现了 Laya 的完整神经网络
- 不需要 PyTorch 和 Transformers runtime
- 模型下到 Mac 里直接跑,不走云端 API
硬件需求:
- macOS 14+
- Python 3.11+
- Apple Silicon(M 系列芯片)
代码怎么调:
# Laya-MLX 三行运行
import laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(state=text, questions=questions)
第一次运行会自动下载模型文件,之后的推理完全在本地跑。
打个比方:这个方案就像你把一个应用装进了 iPhone 里。不用联网,不用服务器,手机本地就能跑。关了网照样能用。
方案四:Windows 一键包(CPU 就能跑)
适合谁: 没有 GPU、普通 Windows PC,想快速体验的开发者。
V2EX 上有人把 Hugging Face 上的开源复现模型打包成了 Windows 一键包:
- 解压即用,约 1.66GB
- 内置 Python 3.10,不用配环境
- CPU 就能跑,不需要显卡
- 完全免费
打个比方:这个方案就像你买了个即热饮水机。插电就出热水,不用你烧水,不用你等。打开就能用,关了就完事。
九、Agent 怎么对接 Jev?和 OpenAI API 兼容吗?
TypeSafe 官方 API 是什么格式? 不是 OpenAI 兼容格式。TypeSafe 用的是自己定义的接口。
打个比方:这就像你家里的插座。国标插头插国标插座,英标插头插英标插座。你不能拿国标插头直接往英标插座里塞——形状不对。
官方 API 的调用方式:
# TypeSafe 官方 SDK 调用
from typesafe_sdk import Choice, TypeSafeClient
client = TypeSafeClient()  # 自动读环境变量 TYPESAFE_API_KEY
result = client.system_one(
    state="客户说:我被重复扣款了",
    questions={
        "department": Choice(
            instructions="工单分给哪个团队?",
            criteria={"billing": "付款退款", "technical": "系统故障"},
        ),
    },
)
HTTP 接口是 POST 到 /v1/systemone,传入 state 和 questions。
SDK 有哪些?
| SDK |
语言 |
安装方式 |
| typesafe-sdk |
Python |
pip install typesafe-sdk |
| @typesafe-ai/sdk |
JavaScript / TypeScript |
npm install |
| Vercel AI SDK |
JS / TS |
内置 experimental_evaluate |
第三方平台也支持了:
| 平台 |
支持方式 |
| Vercel AI Gateway |
接入后 24 小时内近 13% 付费团队使用 |
| Cloudflare Workers AI |
直接调用 |
| OpenRouter |
同步上线 |
打个比方:这就像 USB 接口。一开始只有 TypeSafe 自己的电脑有 USB 口,后来别的厂商也做了兼容的 USB 口。现在你拿个 U 盘,插哪个品牌的电脑都能用。
开源版的 API 兼容吗? 这是关键问题。APUS OpenJev、Laya 这些开源复现项目,对外提供的接口,和 TypeSafe 官方接口不完全一样。
打个比方:这就像你买了个兼容墨盒。外形长得跟原装墨盒差不多,装上去也能打印。但有些高级功能可能用不了,或者打印质量略有差别。
| 对比 |
TypeSafe 官方 |
APUS OpenJev |
Laya |
| 接口格式 |
自定义 typesafe 格式 |
类似但不完全一样 |
类似但不完全一样 |
| 输出原语 |
Choice / Score / Noul |
Choice / Score / Noul |
Choice / Score / Noul |
| 并发能力 |
一次调用多问题并行 |
支持 |
支持 |
| 置信度校准 |
RLCD 训练,校准过 |
校准过但程度不同 |
校准过但程度不同 |
怎么从云 API 平滑迁移到私有化? 打个比方:这就像你换手机。通讯录要导过去,聊天记录要导过去,APP 要重新装。但如果你用的是同一个品牌,数据迁移就简单很多。
迁移的时候,建议加一层抽象:
# 抽象一层,方便切换后端
class DecisionModel:
    def ask(self, state, questions):
        raise NotImplementedError

class TypeSafeModel(DecisionModel):
    def ask(self, state, questions):
        # 调用 TypeSafe 官方 API
        ...

class LocalOpenJev(DecisionModel):
    def ask(self, state, questions):
        # 调用本地部署的 OpenJev
        ...

# 业务代码只依赖抽象层
model = LocalOpenJev()  # 换成 TypeSafeModel() 也可以
result = model.ask(state, questions)
这样你今天用云 API,明天切私有化,业务代码一行都不用改。
打个比方:这就像你家里的水管。不管你接的是自来水公司,还是自己打了口井,水龙头一开就有水。水管的接口是标准的,水源可以随便换。
十、送个架构师:一张技术选型决策表
| 你的情况 |
推荐方案 |
理由 |
| 想快速体验,不折腾 |
TypeSafe 官方 API |
注册就用,送 1.2 亿 token |
| 有 GPU 服务器,追求准确率 |
APUS OpenJev 9B |
79 毫秒,效果对标官方 |
| 普通服务器,想跑本地推理 |
Laya 421M |
1GB 内存,CPU 就能跑 |
| Mac 开发,想本地调试 |
Laya-MLX |
7MB~944MB 内存,M 系列芯片秒出 |
| 没有 GPU,想快速体验 |
Windows 一键包 |
解压即用,CPU 跑 |
| 数据不能出内网 |
私有化部署(任选开源版) |
数据不出服务器 |
成本对比:
| 方案 |
初期投入 |
后续成本 |
适合量级 |
| TypeSafe 云 API |
$0 |
$0.042 / 百万输入 token |
中小规模 |
| APUS OpenJev |
一块 RTX 4090(~$1600) |
电费 + 折旧 |
大规模 |
| Laya 轻量版 |
现有服务器就能跑 |
电费可忽略 |
中小规模 |
打个比方:用云 API 就像打车,出门就走,按里程付费。私有化就像买车,一次性付钱,之后随便开。开得越多,买车越划算。
总结:Jev 私有化怎么选?
| 维度 |
结论 |
| 官方开源了吗 |
没有,权重和训练方法都没放 |
| 有开源复现吗 |
有,APUS 9B 版和 Laya 轻量版都已开源 |
| 最低硬件门槛 |
688MB 内存(Laya-MLX),普通电脑就能跑 |
| 推荐生产部署 |
APUS OpenJev 9B,需要一块 GPU |
| API 兼容 OpenAI 吗 |
不兼容,TypeSafe 用自己的接口格式 |
| 开源版接口和官方一致吗 |
输出原语一样(Choice/Score/Noul),但接口细节不同 |
| 怎么平滑迁移 |
加一层抽象层,业务代码不依赖具体后端 |
核心就一句话:Jev 官方没开源,但开源社区已经把它的平替做出来了。 最轻量的 688MB 就能跑,有 GPU 的 9B 版效果对标官方。API 不是 OpenAI 格式,但输出原语一样,迁移的时候加一层抽象就行。
关于 LLM 选型与 API 中转的更多实操经验,欢迎来云栈社区一起交流。
 发表于 3 小时前
|
查看: 6|
回复: 0


