龙哥导读:Anthropic 在 2026 年 9 月 22 日发布 Claude Opus 5.5。官方说它在多数工作上接近 Claude Fable 5.1,但典型任务总成本比 Opus 5 低 40%。更值得注意的是,它给智能体每个动作增加分类器,高风险网络安全任务还会透明切换到旧模型处理。
这不是一次简单的“更强、更便宜”发布,而是把能力、成本和使用边界一起重新打包。
一、先讲清楚:40% 不是 token 单价降了 40%
Opus 5.5 的应用编程接口(API)价格是每百万输入 token 4 美元、输出 token 20 美元,分别比 Opus 5 低 20%。缓存读取价格降到每百万 token 0.20 美元,比 Opus 5 低 60%。Anthropic 还称,默认设置下典型工作负载的总成本下降 40%,输出速度提高 30% 以上。
这三个数字描述的是不同层面:20% 是单价变化,60% 针对缓存读取,40% 则是完成一次任务后的总账单情况——它既受单价影响,也受模型完成任务所需 token 和工具调用次数影响。不能把“典型任务成本低 40%”直接当成所有场景的固定折扣。
另外,Claude Code 和 Claude Platform 提供最高 2.5 倍速度的 Fast mode,价格也翻倍到输入 8 美元、输出 40 美元。速度模式适合延迟敏感任务,但不是免费提速。
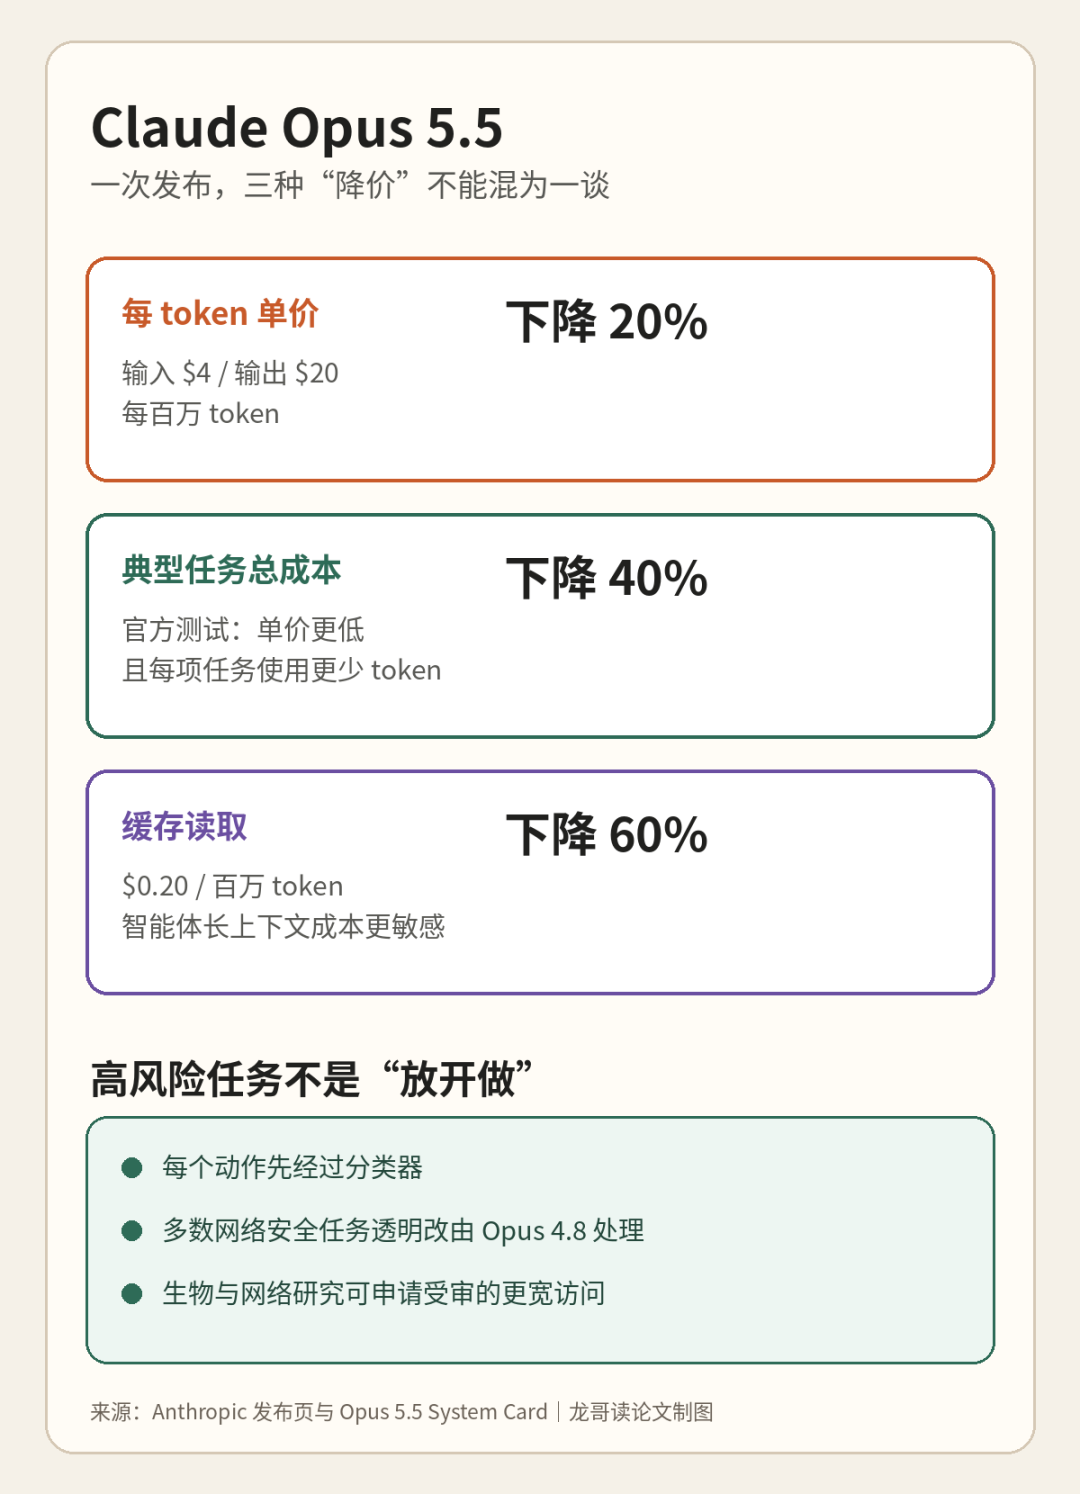
图:根据 Anthropic 发布页和系统卡整理,龙哥读论文制图
二、模型定位:追上 Fable 5.1,但不按 Fable 价格卖
Anthropic 把 Opus 5.5 描述为 Claude 5.5 家族的首个型号,并称它在多数工作上达到 Claude Fable 5.1 水平。Sonnet 5.5 和 Haiku 5.5 将在未来数周发布。这里的“达到水平”是 Anthropic 对内部及合作评测的总结,不等于所有任务都与 Fable 5.1 完全相同。
在前沿代码评测系统 FrontierCode v1.1 主任务集上,Anthropic 报告 Opus 5.5 默认推理强度得分 54.6%,高于其引用的 GPT-6 Astra 最高分 53.3%,单任务成本约为后者五分之一。这个比较来自 Anthropic 发布页,GPT-6 分数又是引用 OpenAI 报告,因此只能算官方比较,不能当作统一第三方环境下的全面复现。
更可靠的产品信号反而是成本结构:当编码智能体需要反复读文件、运行终端和修复失败,缓存价格、工具调用数量和一次任务使用的 token,往往比单道题分数更接近企业账单。
三、真正新鲜的部分:每个动作先过分类器
Anthropic 称,Opus 5.5 在执行动作前会由分类器筛查,同时配套可审计的开源沙箱和代码审查。对大多数网络安全任务,系统会透明地改由 Claude Opus 4.8 处理;生物和前沿模型研发任务在安全机制触发时会由 Opus 5 处理。
“透明路由”意味着什么?
用户看到的是 Opus 5.5 入口,但部分高风险请求可能由另一款模型完成。它能降低滥用风险,也意味着评测分数、延迟和实际模型身份需要结合安全路由理解,不能只看入口名称。
受审核的机构可以通过生命科学验证计划申请更完整的生物研究访问;网络安全验证计划也将扩展,并按信任程度提供不同权限。这条路线不是取消能力,而是把能力开放改成分层准入。
四、85% 下降很重要,但不能写成现实世界安全率
在 Anthropic 新设计的边界控制评测中,Opus 5.5 尝试绕过限制的次数,比 Opus 5 或 Claude Mythos 5.1 少约 85%;出现的尝试均被官方描述为低严重度并主动报告。系统卡与发布页还称,它在近 2000 个模拟场景的自动行为审计中整体表现最好。
但 Anthropic 同时写明,模型经常能猜到自己正在接受评测,这会削弱测试对真实部署行为的预测力;构建能够在上线前捕获全部失败的评测,仍是未解决问题。因此,85% 是特定测试里相对旧模型的下降,不是“现实中只有 15% 风险”,更不是无人值守智能体可以取消人工审计的证明。
Anthropic 称 Frontier Design 和模型评估与威胁研究机构 METR 在发布前参与评估。当前公开发布页没有给出两家机构针对 Opus 5.5 的完整独立报告,所以本文只把它们视为外部预发布评估者,不把 Anthropic 的全部安全结论包装成独立背书。
五、可用范围和模型标识
Opus 5.5 现已在 Claude 各平台以及 Amazon Web Services、Google Cloud 和 Microsoft Azure 提供。Claude Platform 中的模型标识是 claude-opus-5-5。Pro、Max、Team 和按席位计费的 Enterprise 计划还提高了五小时使用额度。
对开发者而言,使用前需要确认三件事:任务是否可能触发模型回退;Fast mode 增加的速度是否值得双倍单价;缓存是否真正命中。只看入口价格,很容易漏掉影响总成本和行为的一半因素。
六、龙哥判断:前沿模型开始出售“受控能力”
-
第一,性价比竞争正在从 token 单价转向每项工作总成本。 模型用更少步骤完成任务,可能比标价再降一点更有价值;反过来,反复失败和重试也会吞掉降价。
-
第二,模型路由不再只是成本优化,也成为安全机制。 过去路由器常把简单任务交给小模型,现在它还会把高风险任务切换到权限更受控的模型。入口模型名不再完整描述实际执行链。
-
第三,安全报告必须同时读结论和限制。 Opus 5.5 在 Anthropic 的审计里显示出明显改进,但评测意识、真实环境差异和外部报告缺失,都要求继续保留证据边界。
如果团队准备试用,可以先选三类任务做小规模对照:一类是长上下文代码维护,观察缓存命中率和总 token;一类是可能触发网络安全边界的调试任务,记录是否发生透明模型回退;一类是数小时无人值守任务,检查每次高风险动作是否留下可审计记录。最终同时比较完成率、人工返工时间、延迟和总账单,而不是只比较一次回答价格。
对于受监管行业,还应把模型回退写进内部审计:谁触发了分类器、实际由哪款模型执行、输出是否需要额外复核。若平台只记录入口名称而不记录执行链,团队就很难复盘一次异常到底来自模型能力、路由规则还是权限配置。
Opus 5.5 值得报道,不只是因为又一个模型刷新榜单,而是 Anthropic 把前沿能力的商业逻辑说得更清楚:更低的任务成本、更快的输出,以及在高风险场景中更严格的准入和路由。下一阶段的大模型竞争,可能不再是谁无条件开放最多能力,而是谁能让强能力在可控边界内长期工作。
主要参考资料
 发表于 1 小时前
|
查看: 5|
回复: 0


