Jev 确实火了。这两天又翻了翻官方文档和调研资料,索性从头捋一遍,把思路理清楚。一个每百万输入 token 只要 0.042 美元、输出免费的模型,乍一看像是个"更便宜的 LLM"。但 Jev 真正的价值恰恰在于:它不写字、不写代码,只做一件事——替软件在每一个转弯处做有边界的判断。
“200 倍更快、400 倍更便宜”——这是原作者的宣传性表述,不是一个已独立复现的通用基准。真正值得拿走的,是它背后那套“强模型负责创作,窄模型负责判断,代码保留控制权”的工程分工。
它不写代码,只决定下一步怎么走
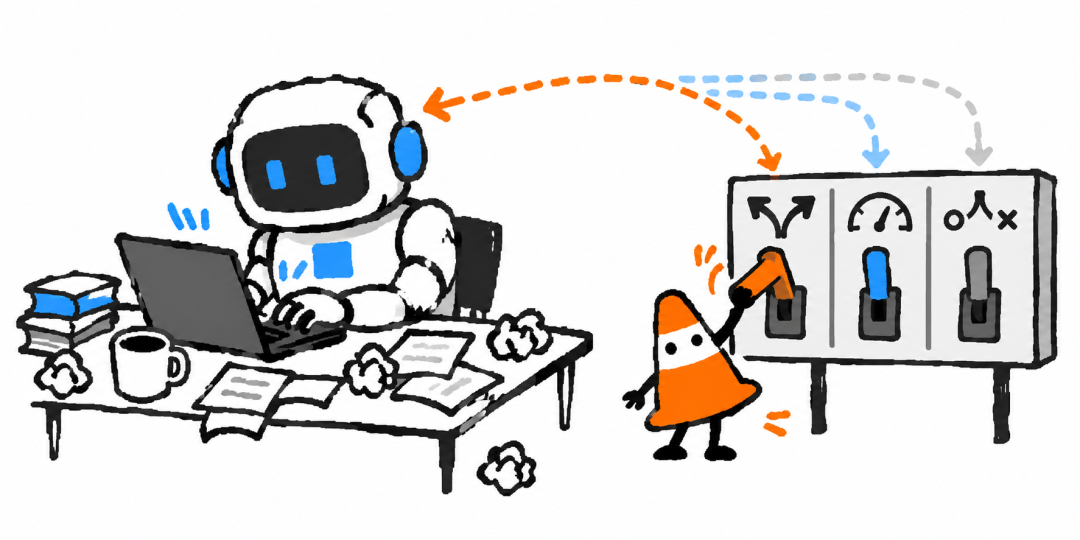
大模型负责写,小决策层负责选路。
Jev 是 TypeSafe 所谓的 System One 模型。它接收一份状态,再回答一组事先定义好的问题。结果不是一段散文,而是代码能直接读取的类型化答案和概率。
Max Quality, Minimum Cost。
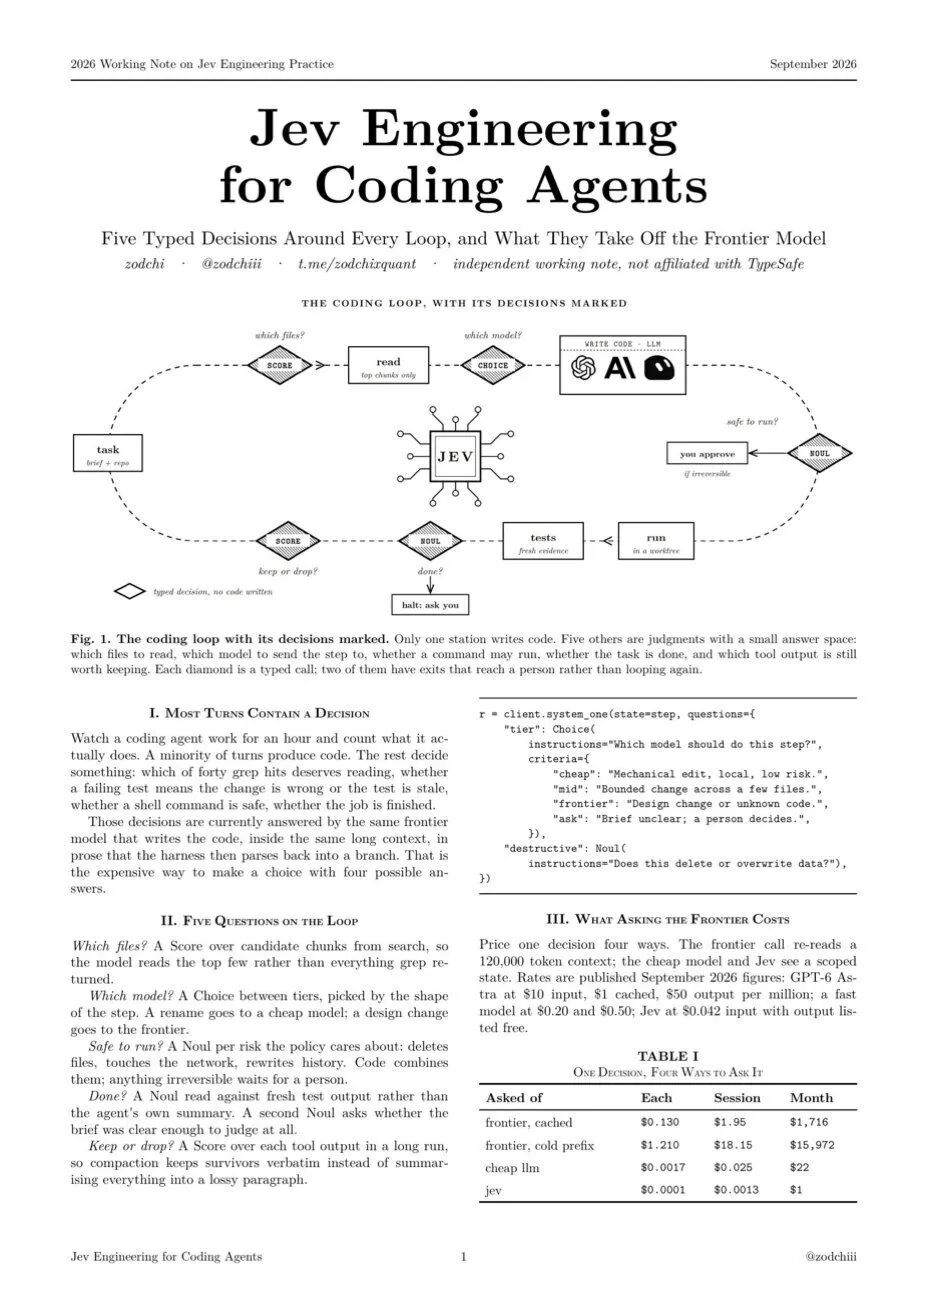
它只有三类基础答法:Choice 从候选项里选一个,Score 在预设等级上打分,Noul 返回一个是否判断的概率。这意味着,它很适合回答“该用哪个工具”“这段上下文需要显示到什么粒度”“这条命令要允许、询问还是拒绝”;却不适合让它写代码、摘要文章或做精确算术。
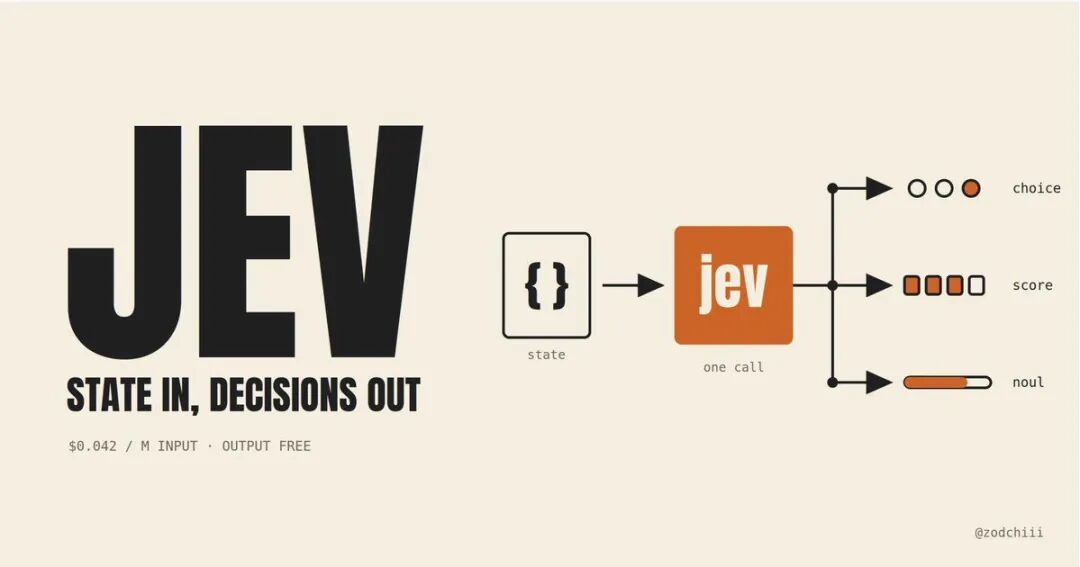
State in, decisions out。
所以它不是 Claude Code 或 Codex 的替代品,而是旁边的调度层。前沿模型继续读需求、写代码、解决新问题;Jev 则反复处理那些窄、高频、结果可结构化的小判断。单独看一次不起眼,一个会话里发生上千次,就成了架构杠杆。
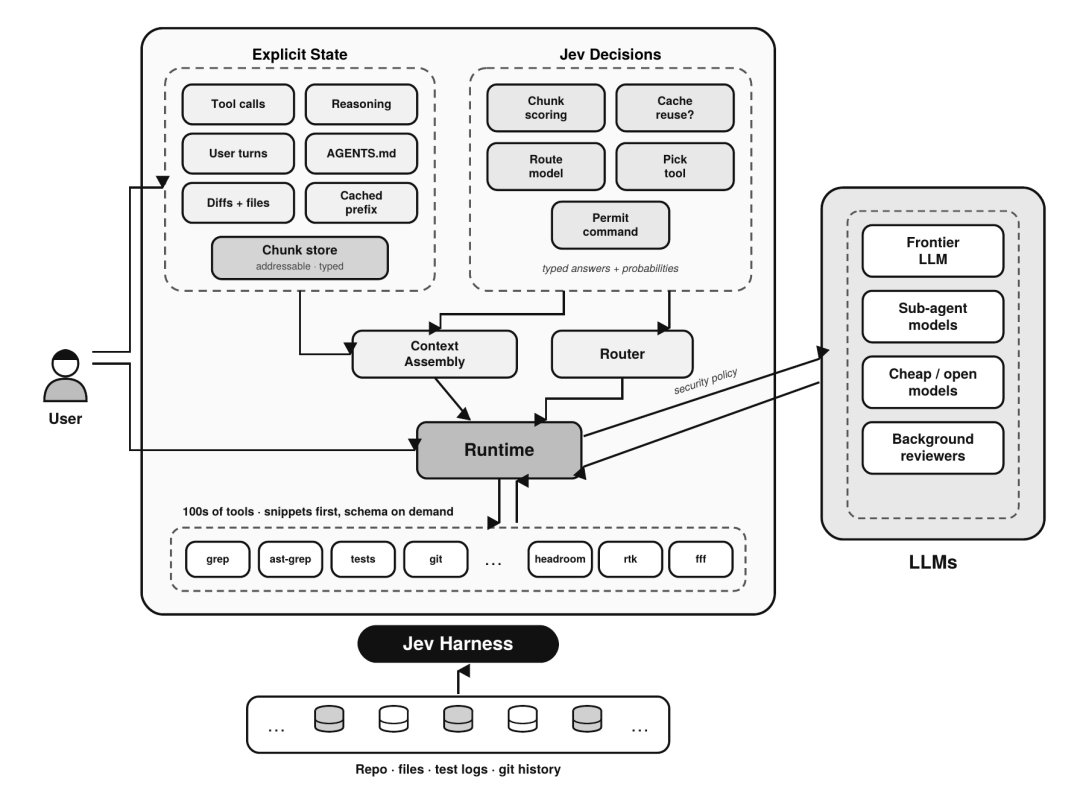
显式状态、Jev 决策与执行层的分工。
真正烧钱的,是被反复搬运的上下文
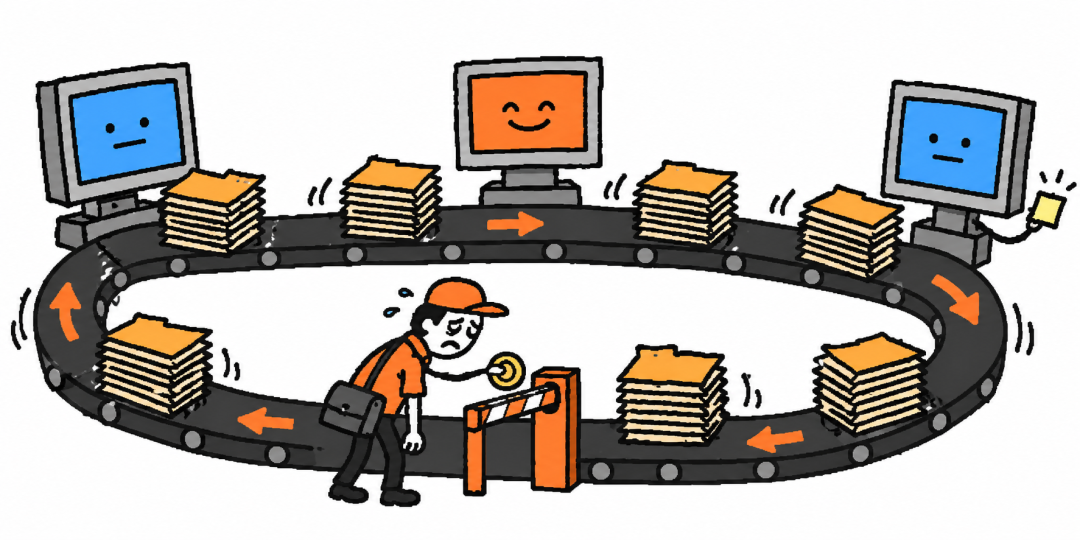
多模型路由不一定省钱,上下文每搬一次都要重新付费。
Jev 指南先给出一个极具诱惑力的数字:每百万输入 token 0.042 美元,输出 token 免费。官方还给出每秒 25 万 token、每分钟 1200 个请求、64k 总上下文的当前限制。但这些数字会随容量调整,上线前仍需要重查官方页面。
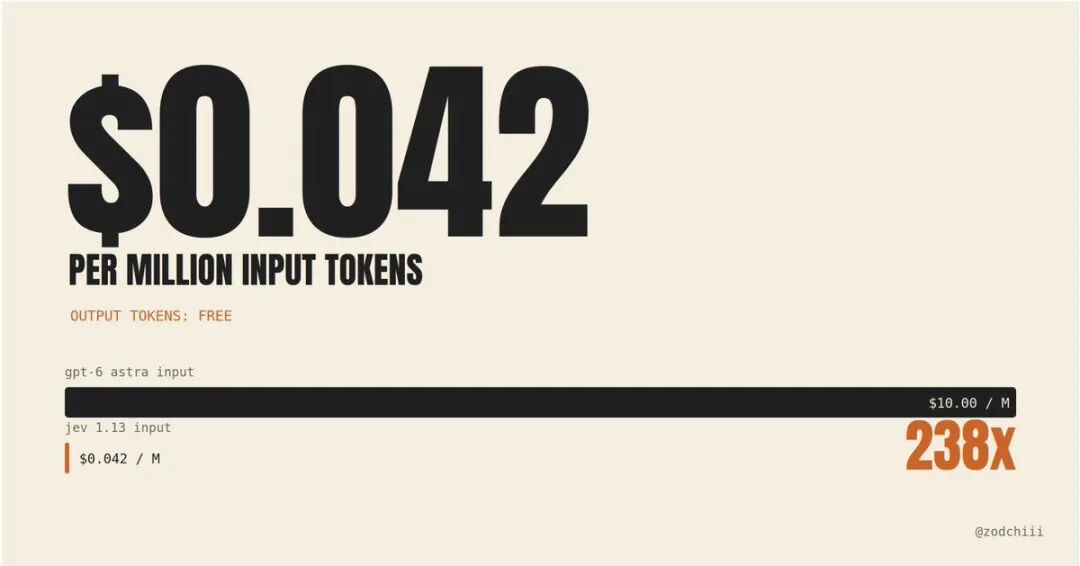
Jev 当前按输入 token 计费。
PDF 的核心追问是:如果 LLM 没有 KV cache,你还会把 coding agent 设计成一份只追加的超长聊天记录吗?现在的路由策略常常只看模型单价,忽略了交接时重新加载、重新处理上下文的成本。
笔记用一组示意数据计算:纯 Opus 路线的成本是 4.15,Opus 规划→Sonnet 执行→Opus 回审却是 6.19。这不是对所有任务的通用基准,而是一个很有用的会计视角:路由省下的模型价差,必须大于它新增的上下文重建成本。
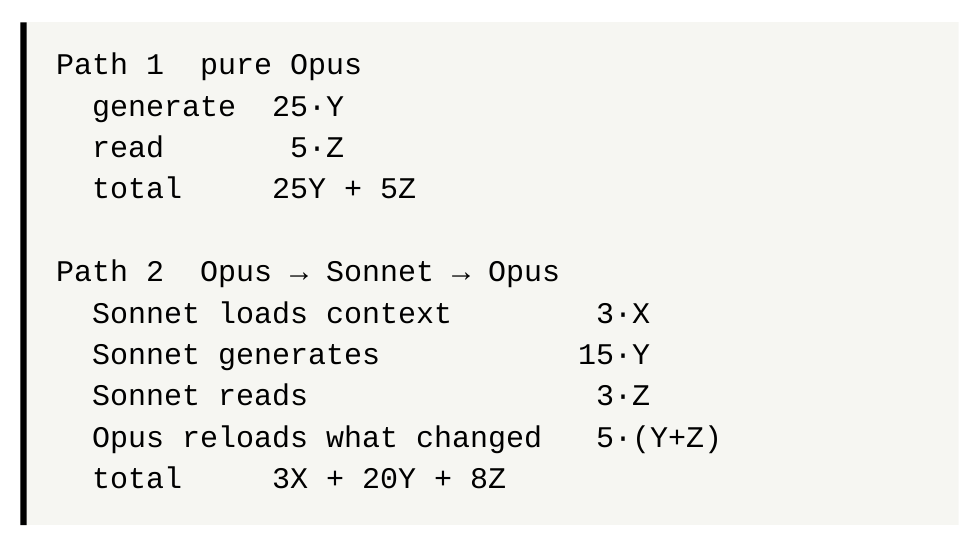
便宜模型的单价优势,可能被上下文重建吞掉。
而真正的 token 大户往往不是“写代码”。Microsoft FastContext 论文对 coding-agent 轨迹的分析显示,读取与搜索占所有工具调用轮次的 56.2%,吃掉主 agent 总 token 的 46.5%。也就是说,用最贵的大模型反复翻文件,可能比让它写 diff 更贵。
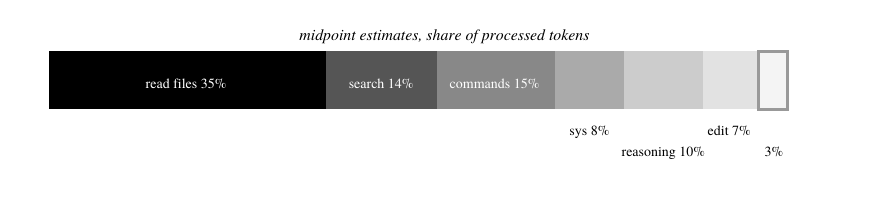
读取、搜索与命令输出占了处理 token 的大头。
12.2 倍,不靠更聪明,只靠一次问完
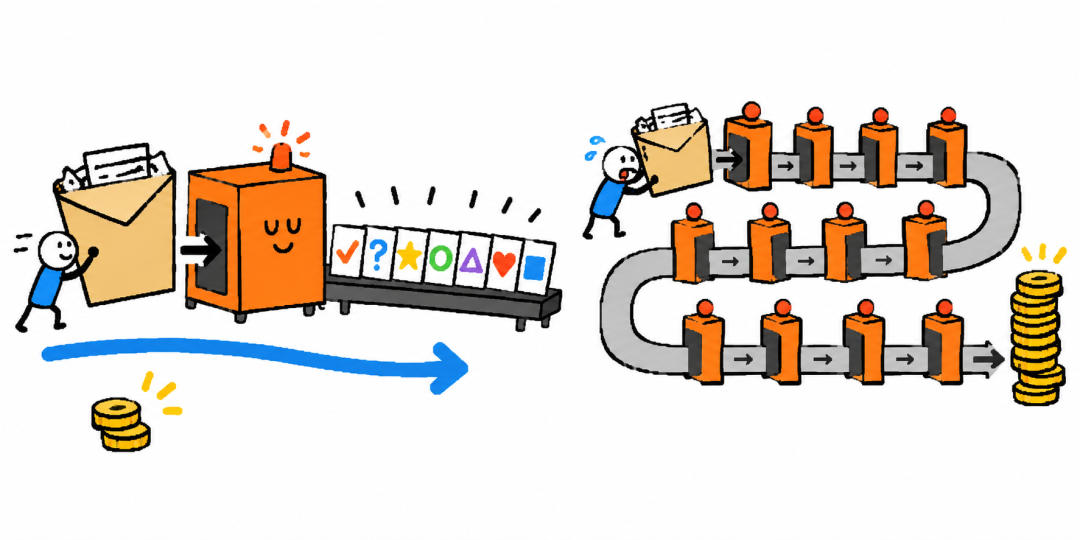
状态只送一次,问题尽量并行问完。
Jev 最值得立刻拿走的不是某个参数,而是请求形状:同一份 state 只发一次,把可能用到的独立问题都放进一个请求,然后由代码忽略当前无关的答案。TypeSafe 把这叫 speculative fan-out。
官方 cookbook 用一篇约 5.4 万字符的 GDPR 文章和 13 个问题做了对照:单次批量调用平均花费 0.000497 美元、0.27 秒;13 次分开调用合计 0.006090 美元、2.71 秒。在这个文档主导型负载里,批量化便宜 12.2 倍、快 10 倍,答案分布没有因批量化而发生实质变化。
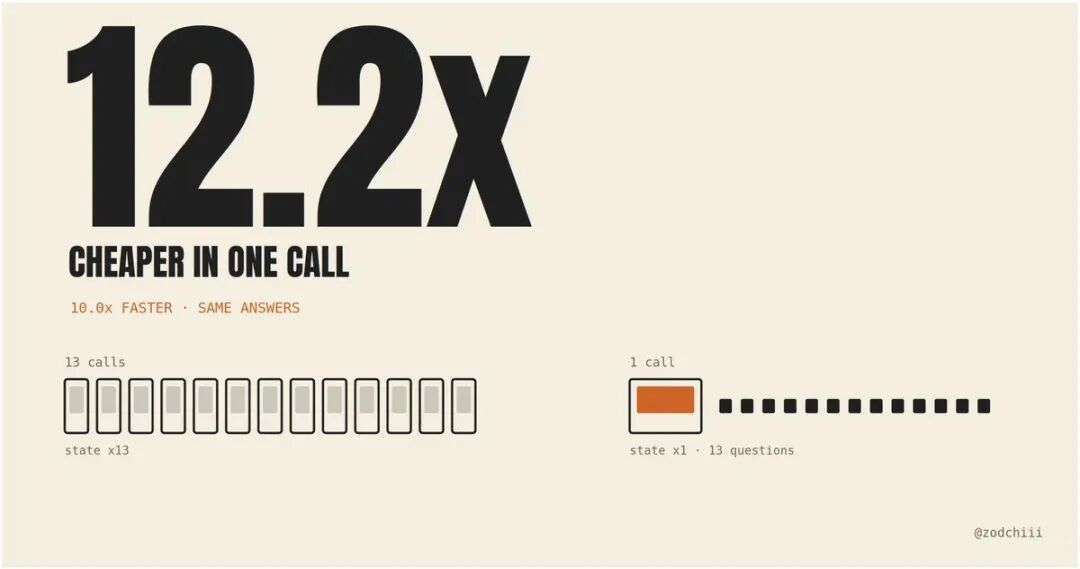
一次提 13 个问题,避免把主文档重复发送 13 次。
但“答案是什么”不等于“现在能不能行动”。Choice 和 Score 同时返回置信度:分布越集中,置信度越高。对可恢复的只读操作,阈值可以低一些;对转账、删除、发布这类高风险动作,应该要求更高置信度,并且再经人或确定性规则确认。
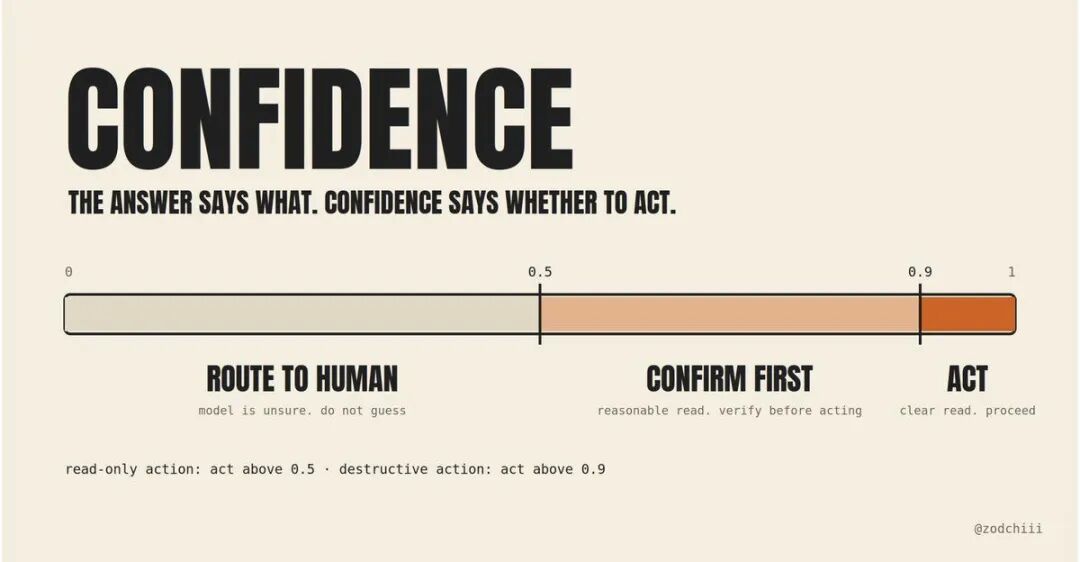
答案决定方向,置信度决定是否行动。
这里有一个容易混淆的边界:置信度只表示模型对候选答案的分布有多集中,不是权限,也不是结果验证。一个高置信度的“完成”,不能证明文件真的已经保存。侧效必须回到代码里检查。
Harness 的核心:每一轮重新组装世界
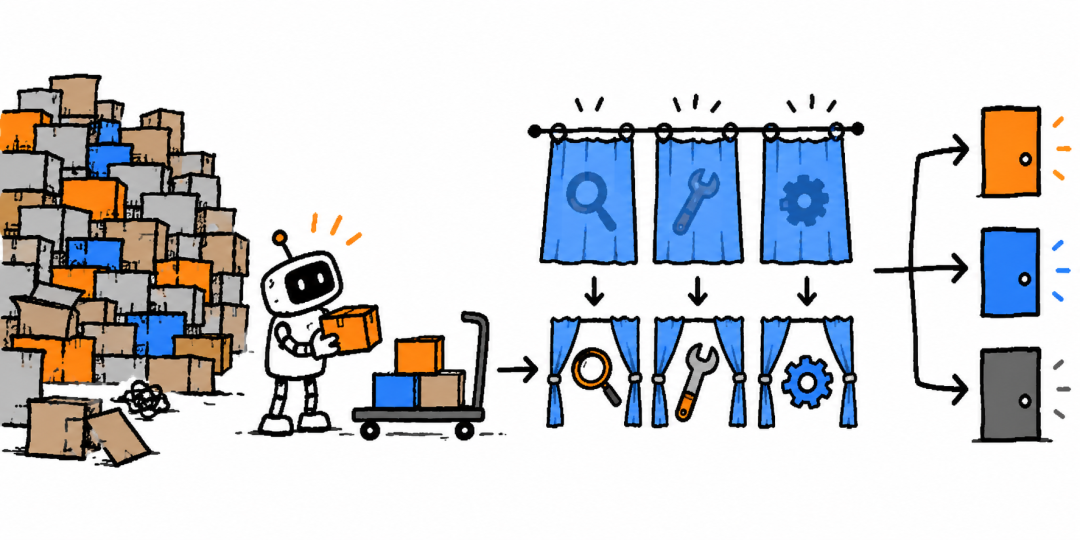
不再把全部历史塞给模型,而是按当前问题拼装上下文。
这份 技术文档 最重要的变化,是把对话历史拆成可寻址、有类型的状态块:用户目标、文件、diff、测试日志、AGENTS.md、过去的决策都可以独立保留。每轮开始前,根据当前问题决定哪些隐藏、哪些给短摘要、哪些给长摘要、哪些原文全显示。
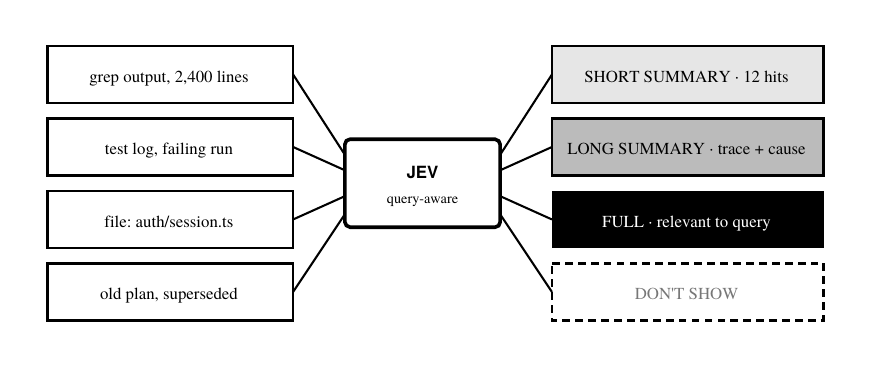
压缩应该发生在问题已知之后。
工具也不必每轮把完整 schema 摊开。第一层只给出一行功能摘要,真正选中某类工具时再加载 schema,只有临时查阅时才展开完整文档。这就像先看菜单,不是先把厨房里每个抽屉都倒在桌上。
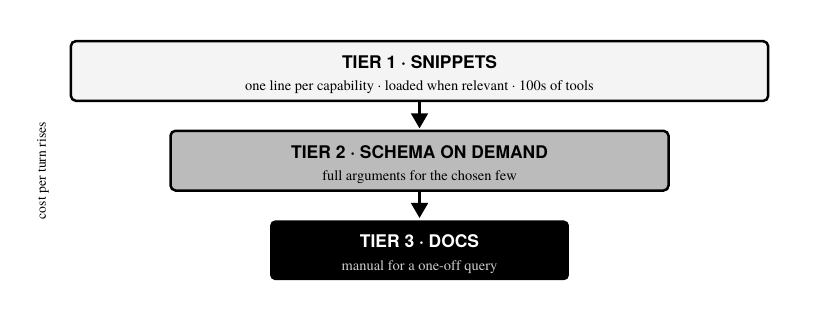
工具分级披露,无关能力不再永久占用上下文。
指令也可以附着在条件上:碰到 .tsx 才加载样式规范,进入 billing/ 目录才加载其易错说明,写文案时再引入语气样例。它们不需要全部常驻,也不该被一次粗暴 compaction 一起丢掉。
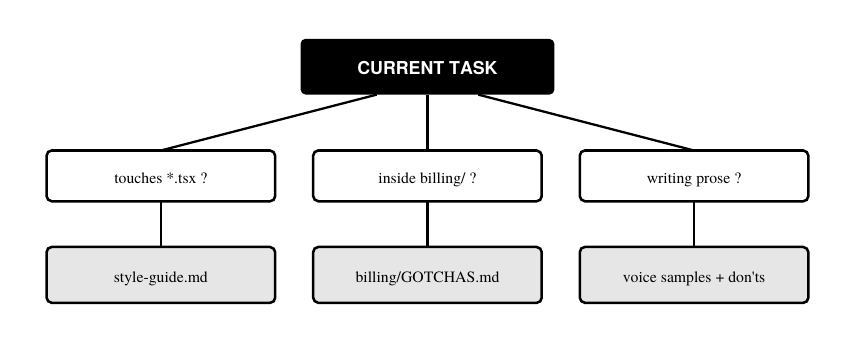
指令跟着条件走,不再跟着所有轮次走。
最后,多个只读后台任务共享同一次检索结果。代码审查、评测用例、小白解释、进度页面可以并行开工,却不必各自重读整个仓库。这比简单地“多开几个 sub-agent”更关键:并行不难,难的是只传正好够用的状态。
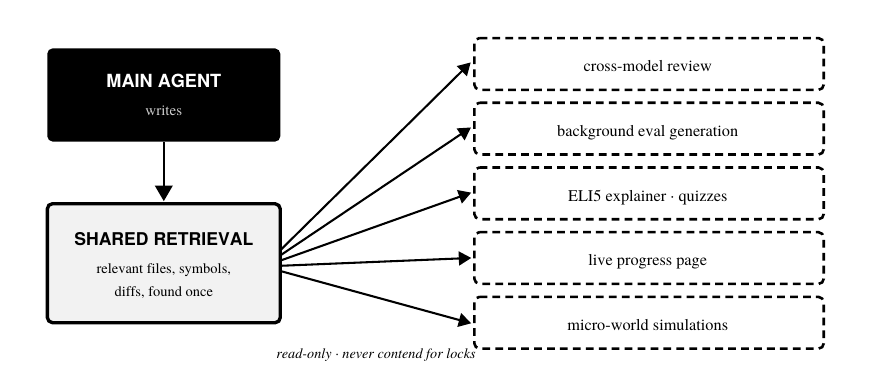
一次检索,多路只读消费。
快和便宜,不能接管安全
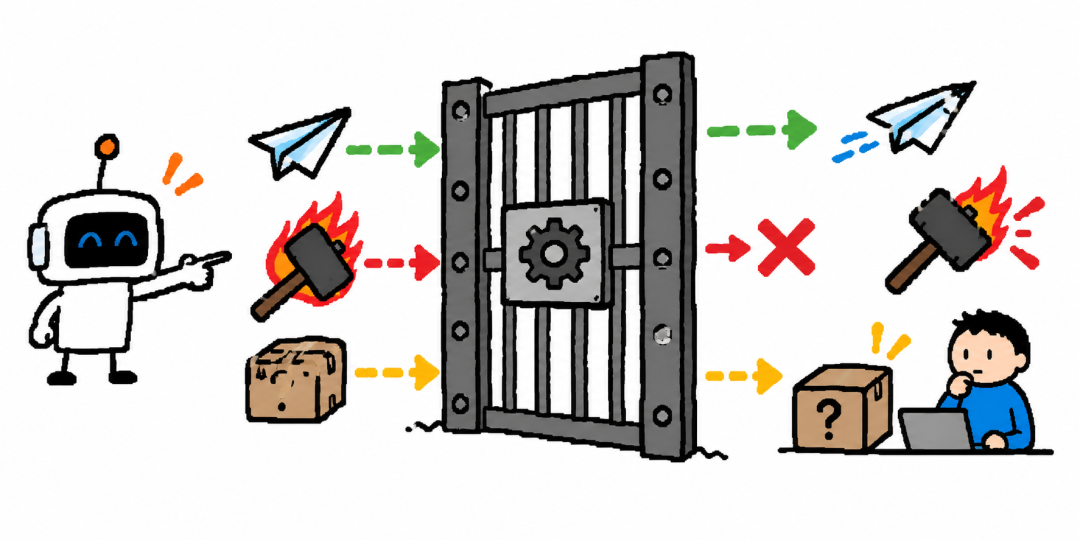
模型可以建议,真正的 allow / ask / deny 必须由代码执行。
Jev 的优势也很容易变成误用的诱因:很快、很便宜、输出又符合预设类型,于是人会忍不住把更多责任交给它。但“不能输出 schema 以外的值”,只证明答案格式受限,不证明它选对了。
速度很刺激,但稳不稳是另一件事。
TypeSafe 自己的 jaggedness 页面列了当前版本的九类边缘:过于字面理解、不擅长数学与计数、不可靠比较日期、多层间接关系掉准确率、无关长上下文造成干扰、对抗性内容可以影响答案、矛盾的指令和标准会令它混乱、不同问法之间不保证数学一致,以及它根本不用来生成文本。
- 能用解析器、正则或算术精确完成的事,留在代码里。
- 涉及秘钥、基础设施、删除和发布的操作,由确定性策略强制执行,不让模型拥有最终权限。
- 状态里的网页、文件和工具输出都可能被攻击者控制,必须建立注入测试集。
- 置信度阈值需要用自己的任务数据校准,不能照抄示例里的 0.5 或 0.9。
- 记录实际回答的版本 ID;调过阈值的生产系统应固定版本,不要默默跟着
latest 别名漂移。
如果今天就要尝试,可以从一个只读、容错成本低的判断开始:比如为搜索结果打相关性标签,或从已知工具集里挑候选项。把问题拆窄,一次并行问完,保存概率分布,设置人工回退,然后才慢慢靠近高风险路径。
所以,不要把 Jev 看成一个打折的聊天模型。它所代表的是另一种分工:生成模型负责把没见过的问题做对,决策模型负责把数千个小分叉做快,而代码负责让整个系统不越界。真正应该复制的不是“200 倍”的标题,而是这条职责边界。
主要来源
- darkzodchi:The Jev Setup Guide
- darkzodchi:Jev Harness PDF 帖文
- Jev Engineering for Coding Agents 设计笔记
- TypeSafe 官方:Models
- TypeSafe 官方:System One
- TypeSafe 官方:How to build with TypeSafe
- TypeSafe 官方:Speculative fan-out
- TypeSafe 官方:Parallel questions cookbook
- TypeSafe 官方:Confidence
- TypeSafe 官方:Jev 1.13 jaggedness
- Microsoft:FastContext 论文
 发表于 2 小时前
|
查看: 2|
回复: 0


