“这条客户已经付不了款了,怎么还被分到普通队列?”
给客服系统接上 AI 分类后,开发最怕听到这句话。模型能返回一个规整的标签,业务却未必认可:该优先处理的漏了,普通咨询又被一股脑标成紧急。
于是改提示词,补一个例子,再补一条规则。修好了这类问题,另一类又开始错。
这里有个值得试的做法:让大模型提取信息,再用一个可训练、可评估的分类器决定处理优先级。
先看两条工单
假设业务规定:正在发生的支付故障,要比活动咨询优先处理。
| 工单原文 |
真正要判断的事 |
| “急!下周活动几点开始?” |
有催促,但未必是故障 |
| “付款连续失败,客户还在柜台等。” |
没有写“急”,业务可能已经受阻 |
“语气着急”和“处理优先级高”不是同一个字段。大模型擅长读懂这层语义,但最后怎么排队,还涉及你的业务规则、等待时长和误判代价。
把这些混进一个越来越长的提示词,出错后很难定位。不妨拆成四层:
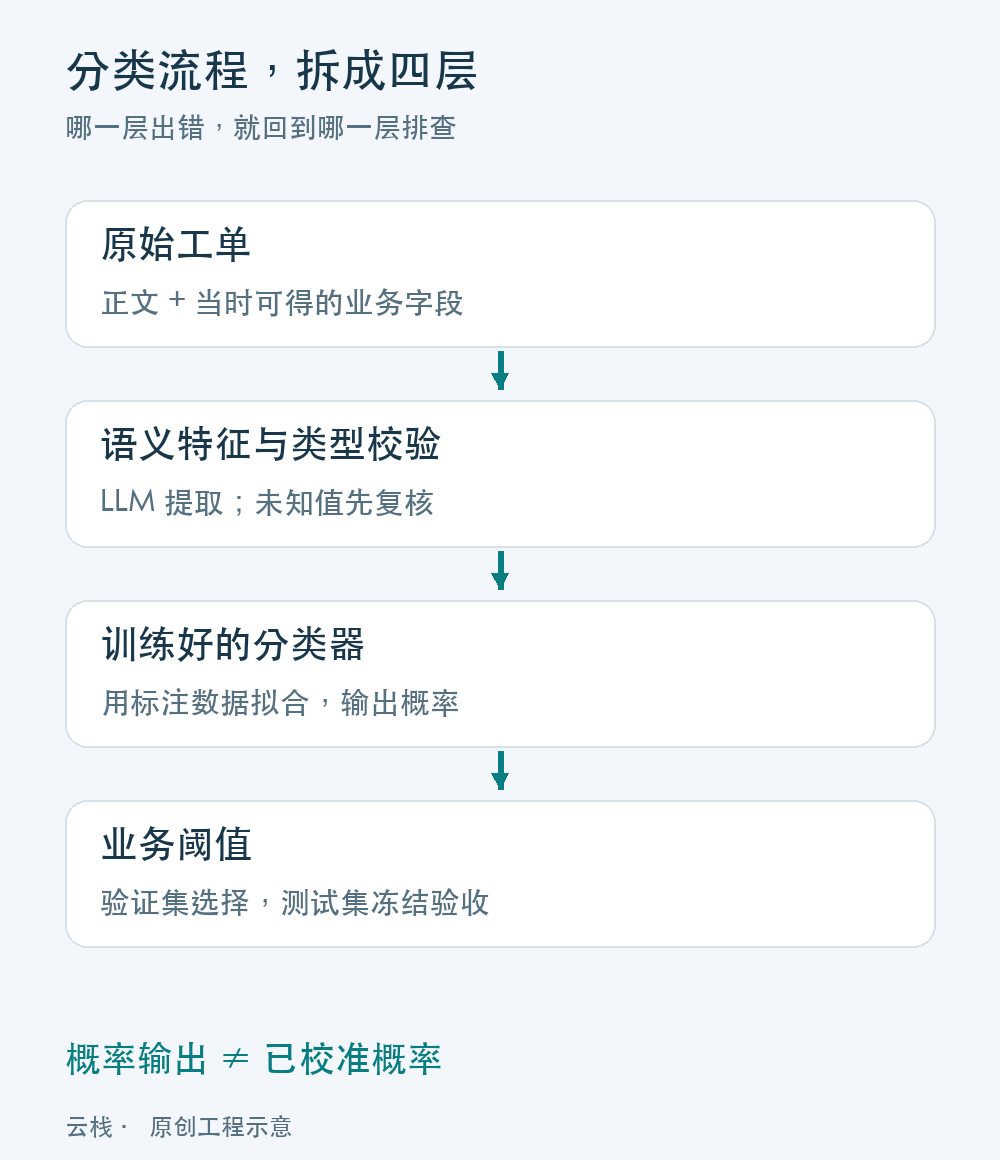
文字理解、模型打分和业务阈值分别处理。
LLM 负责从工单里提取“明确催促”“支付受阻”“缺少信息”;等待时长由业务系统计算。分类器结合这些字段输出分数,再由阈值决定是否进入优先队列。
第一步,先让输出变成能检查的字段
给模型的任务可以这样写:
提取工单信息,不决定处理优先级:
urgent_words:是否明确催促,true/false/null。
payment_blocked:是否明确描述支付受阻,true/false/null。
missing_info:是否缺少必要信息。
evidence:逐项引用原文依据。
无法判断返回 null,不自行补全事实。
要提前定义清楚:“咨询怎么付款”不等于“付款失败”。返回后校验字段类型,字符串 "false" 不能当布尔值;未知也不能直接补成 0。基础版先把缺失项交给人复核。
把特征缓存下来,并记录模型、提示词和字段版本。后面改分类阈值,就不用再让模型把所有工单读一遍。换模型或改字段定义时,再重新提取和验证。
需要为这层接入 Claude、GPT 等模型时,可以了解 RouteFast 的 API 服务。接入解决的是调用问题,字段提得对不对,仍要用自己的样本检查。
第二步,三份数据不要混着用
先划分训练集、验证集、测试集,再挑特征和调方案。同一工单的多条消息、同一客户的关联会话,不能一部分拿去训练,另一部分拿来证明效果好。
| 数据 |
只负责什么 |
| 训练集 |
拟合分类器参数 |
| 验证集 |
选特征、调阈值 |
| 测试集 |
方案冻结后验收 |
还要排除“事后才知道”的字段,比如最终退款结果、总处理时长。它们可能很准,但接到新工单时还不存在。
下面代码使用逻辑回归。把标准化和模型放进同一个 Pipeline,标准化参数也只在训练集上学习。
第三步,先商量漏报和误报的代价
漏报,是紧急工单没被挑出来;误报,是普通工单占了优先处理的位置。
如果漏报代价更高,就可以接受多处理一些误报。比如暂定“漏报一次的代价是误报的5倍”,就在验证集上找一个让下面结果尽量小的阈值:
总成本 = 5 × 漏报数量 + 误报数量
5倍只是教学假设,实际值要和业务一起定。阈值低了,通常能找回更多紧急工单,也会增加处理量。不要只看准确率,还要问一句:这些多出来的工单,团队接得住吗?
用一段完整代码跑起来
下面是自包含示例,生成300条合成特征,按180/60/60分组。它没有调用真实模型,也不是生产工单测试;目的是让你看清训练、选阈值和验收各发生在哪里。
保存为 quickstart.py,准备 Python 3.10 或更新版本,安装依赖后运行:
python -m pip install scikit-learn==1.7.2
python quickstart.py
import math
import random
import numpy as np
from sklearn.pipeline import (
    make_pipeline,
)
from sklearn.preprocessing import (
    StandardScaler,
)
from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.metrics import (
    precision_score, recall_score,
)

rng = random.Random(918)
X, y = [], []
for _ in range(300):
    u, b, m = [
        int(rng.random() < p)
        for p in (0.35, 0.25, 0.15)
    ]
    h = round(rng.uniform(0, 48), 1)
    z = -2 + 0.6*u + 2*b + 0.04*h
    prob = 1/(1 + math.exp(-z))
    X.append([u, b, m, h])
    y.append(int(rng.random() < prob))
X, y = np.array(X), np.array(y)
model = make_pipeline(
    StandardScaler(),
    LogisticRegression(max_iter=1000),
)
model.fit(X[:180], y[:180])
pv = model.predict_proba(X[180:240])[:, 1]
yv = y[180:240]

def cost(t):
    missed = ((pv < t) & (yv == 1)).sum()
    false = ((pv >= t) & (yv == 0)).sum()
    return 5* missed + false

t = min(np.linspace(0.1, 0.9, 17), key=cost)
pt = model.predict_proba(X[240:])[:, 1]
yhat = pt >= t
yt = y[240:]
print("synthetic data only; threshold:", t)
print("precision:", precision_score(yt, yhat))
print("recall:", recall_score(yt, yhat))
本地运行结果:
threshold: 0.1
precision: 0.4576...
recall: 1.0
怎么读?这批合成测试样本里的正例都被找到了,但被判为正例的记录中,真正的正例只有约46%。示例的代价设定把阈值推低了,也带来了更多误报。
“一个都没漏”听起来很好,业务却可能被误报淹没。 这就是为什么模型分数出来后,还要单独设计决策规则。
工程版另外检查了同源数据跨集合、字段缺失、错误类型和抽取版本;7项检查通过。其中一项是故意改测试标签,确认它不会反过来影响阈值选择。
最后一个坑:0.9真的代表九成吗?
不一定。模型输出0.9,只能先当作预测分数;要看一批预测接近0.9的样本中,实际正例比例是否也接近90%。这个问题叫概率校准。
原作者 Taylor Pospisil 在英文讽刺识别实验中,逐步加入 LLM 语义特征和规则特征,报告了效果改善。但换成中文客服数据,不能直接沿用它的成绩。
如果要把分数用来决定自动派单或人工复核,除了分类指标,还要看可靠性曲线。需要校准时用独立数据或合适的交叉验证;测试集不能一边用来改方案,一边当最后的成绩单。
想补逻辑回归、模型评价和交叉验证,云栈的《Python机器学习从入门到精通》有对应章节,可先看目录选学,资料按页面算力条件兑换。
起步时不必追求全自动。先用一小批人工标注数据,把“提错信息”“阈值不合适”“新数据变了”分开记录,再和直接使用 LLM 标签的方案比较效果与成本。
如果你在做工单、内容审核或线索分类,业务更不能接受漏掉一条,还是多报一批?这个答案,往往比先换哪个模型更值得讨论。
学习入口
- 概率校准:
scikit-learn.org/stable/modules/calibration.html
- Python机器学习课程:
https://yunpan.plus/t/29
参考资料:Taylor Pospisil,Minimally Sufficient,《LLM Classification Is Feature Engineering》
 发表于 3 天前
|
查看: 2|
回复: 0


