搜中文电子书的人都懂那种体验。书名后面加个 epub,前几页全是引流站,点进去先让你关注公众号,关注完甩一个网盘链接,下载下来解压还要密码,密码藏在他朋友圈广告里。半小时过去,书没找着,微信里多了几个随时会发广告的号。
GitHub 上有个开源项目叫 ebook-treasure-chest,中文名电子书下载宝库。它干的事很朴素,把散落各处的下载链接收拢、分好类,放进一个能搜的页面。这类 GitHub 上的热门项目,往往值得先做一轮数据审计再下结论。
— jbiaojerry/ebook-treasure-chest 的 GitHub 仓库页,右上角 Star 显示 19.1k
我把它那份数据文件整个扒下来数了一遍。它确实解决了真问题,但「2.4 万本」的成色未必如你所想。
本文看点
01 它不存书,只存一张能搜的表
02 先把 2.4 万这个数字拆开看看
03 搜索是它最值钱的部分,也是被高估的部分
它不存书,只存一张能搜的表
先说性质。仓库里没有书,装的是书目索引和下载链接。维护者从各电子书网站把链接收进来,给每本书打上分类标签。
— 电子书下载宝库的项目 logo
按项目自己的说法,覆盖帆书 app(原樊登读书)、微信读书、京东读书、喜马拉雅这几家平台的大部分电子书,《可复制的沟通力》这类书确实在库里。文学类 2711 本、历史类 1748 本,这两个大类的存量是实打实的。
先把 2.4 万这个数字拆开看看
在线页的统计卡片写着总书籍数 24,071 本、分类 1,000 个、语言 ZH、格式 EPUB / MOBI / AZW3。我把站点加载的 all-books.json 下载下来看了一遍,7.1 MB,24,071 条一条不差。
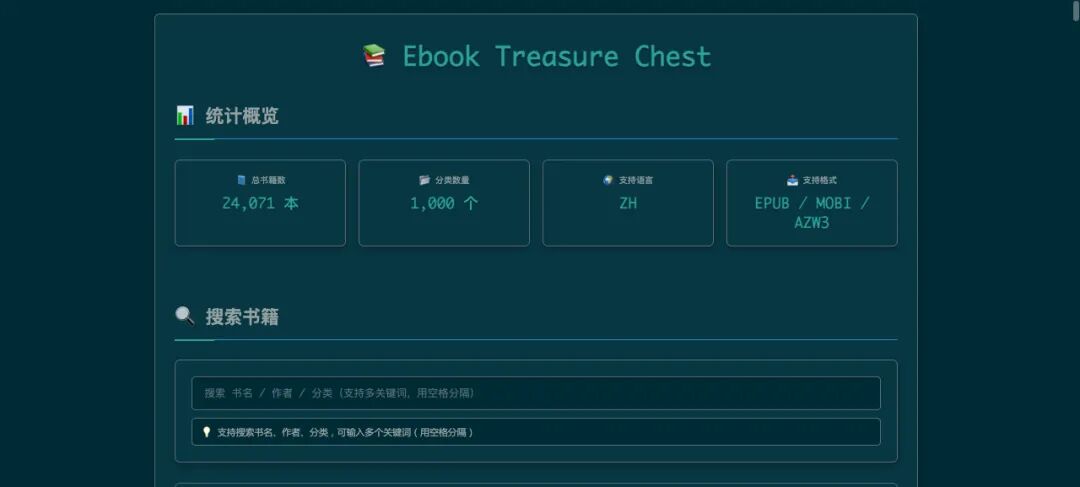
— 官方在线页的统计概览与搜索框
然后数字露出了另一面。同一组「书名加作者」的记录会重复出现,24,071 条按这个组合去重只剩 11,388 个,也就是 12,683 条重复收录,占 52.7%。《与机器赛跑》被收录 6 次,东野圭吾相关记录 83 条,去重后 63 个书名。
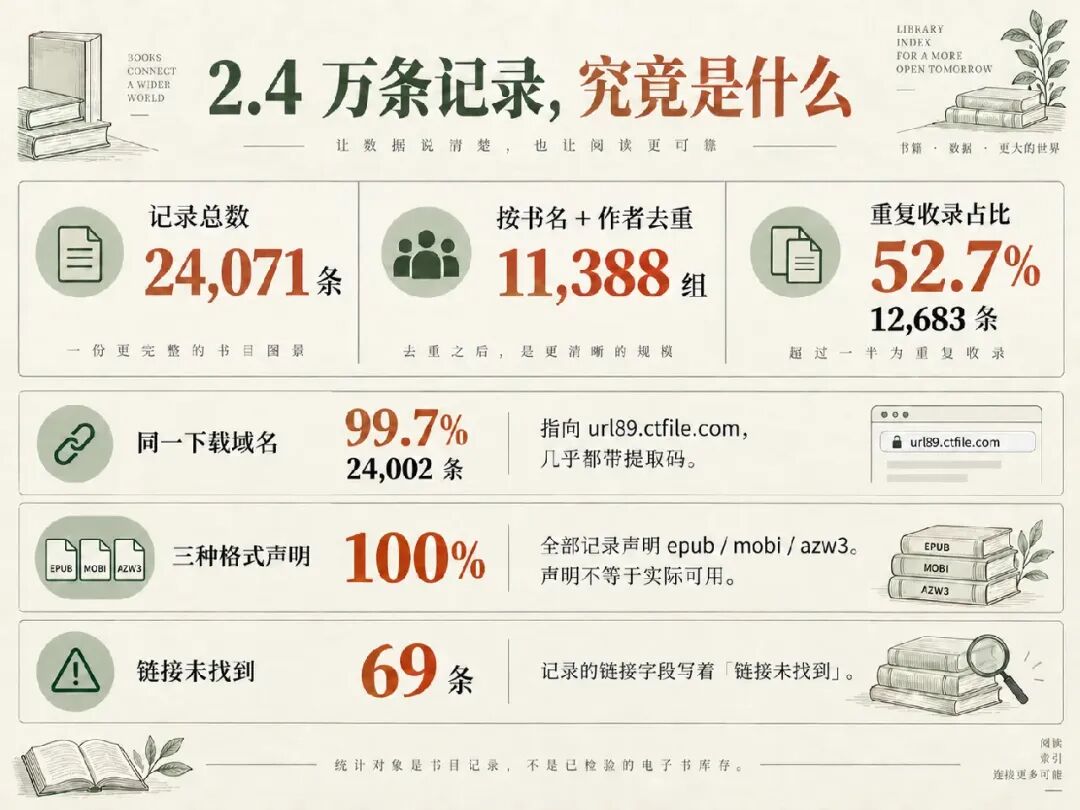
— 书库数据体检
所以「2.4 万本」是记录数,独立书目大约 1.1 万种。这也解释了为什么搜一本书会看到好几条几乎一样的结果。
搜索是它最值钱的部分,也是被高估的部分
在线搜索页是这个库最值钱的地方。两万四千多条记录靠 Ctrl+F 翻不现实,而它输入即出结果,不用回车不用点按钮。
实现比看上去简单。站点那份 search.js 里,匹配范围只有标题、作者、分类三个字段,多关键词是「每个词都要命中」的逻辑,「沟通 樊登 职场」能收成一条,是因为三个词分别落在书名、作者和分类上。这种前端搜索实现,本质上就是纯 JavaScript 的 DOM 过滤,没什么黑科技。
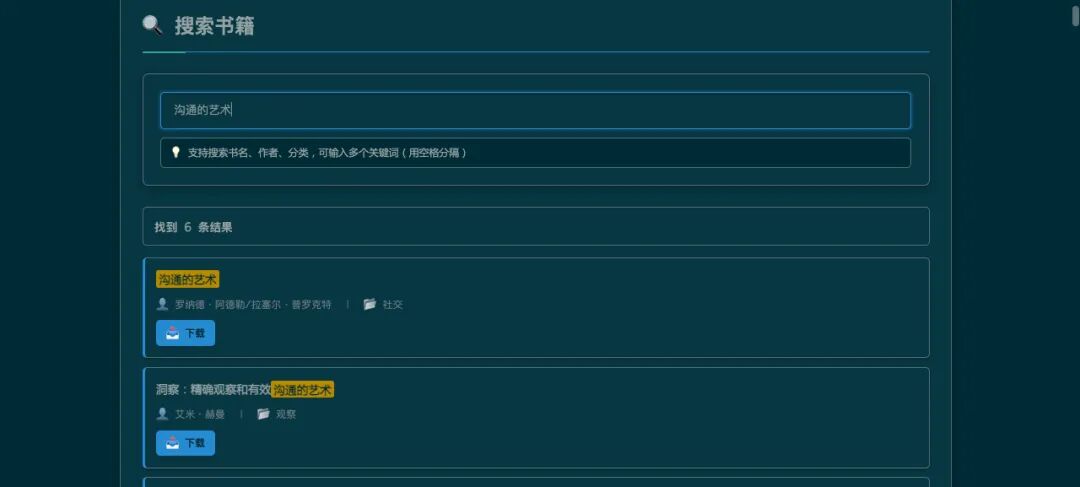
— 官方在线页的搜索结果
两个边界得知道。一是结果上限 100 条,超了只给前 100 条并标 100+,我实测搜「沟通」命中 128 条,你只看得到 100 条。二是它不搜简介也不搜正文,只记得情节忘了书名的找法不管用。
1000 个分类,中位数只有 3 本
分类数确实是 1,000 个,一个不多一个不少。
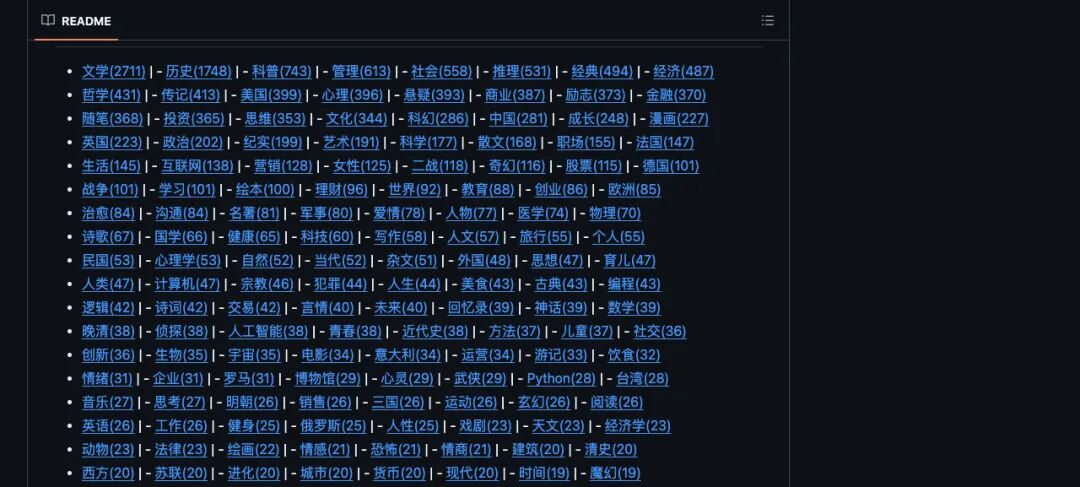
— 官方仓库 README 里的热门分类索引
但按收录量排一遍,结构就露出来了。最多的文学 2,711 本,中位数只有 3 本,只收 1 本书的分类 224 个,不超过 10 本的 775 个。
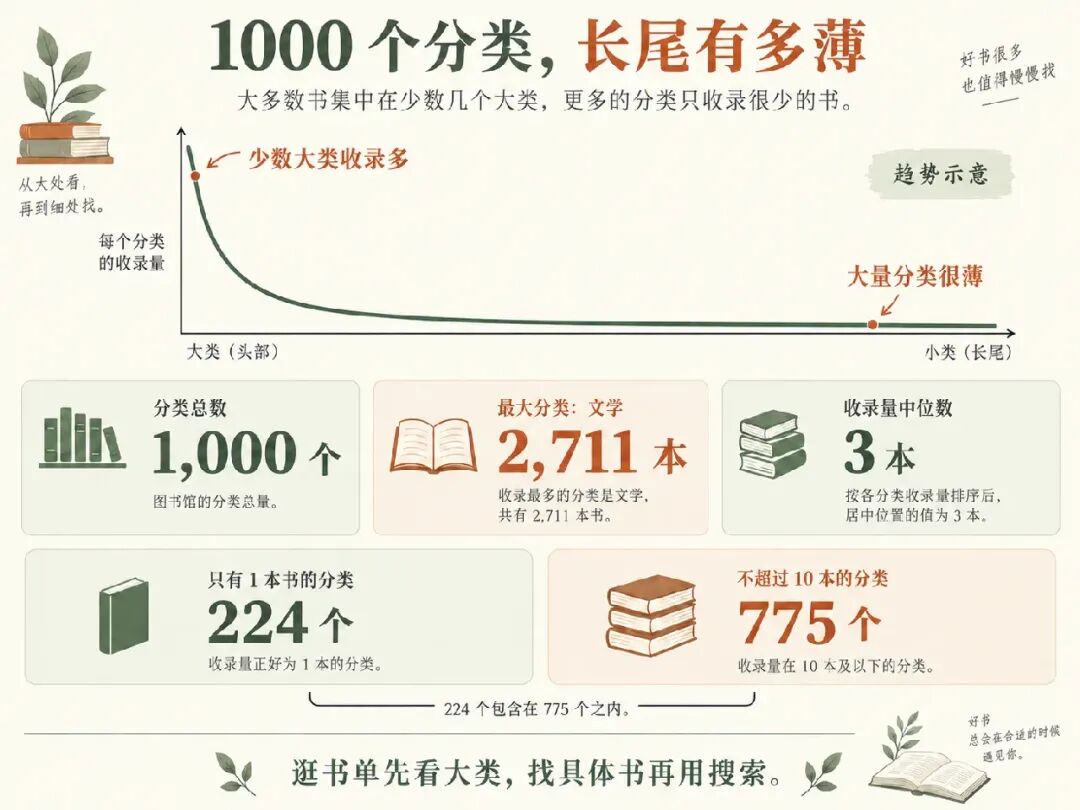
— 分类长尾分布
在线页只铺前 20 个热门分类、每类先列 10 本,剩下交给搜索,全铺开页面没法看,这个取舍合理。
能当书单逛的是前几十个大类,后面一大半标签更像给单本书挂的关键词。至于来源里点名的「敦煌」和「蜡烛图」,确实存在,各有 5 本和 2 本;同一句里提到的「烘焙」,在 24,071 条记录的标题、作者、分类字段里都搜不到,命中 0。
三种格式都写上了,不等于三种都有
数据里每条记录都声明了 epub、mobi、azw3,24,071 条,覆盖率 100%。epub 通用,手机阅读 App 基本都认,mobi 和 azw3 主要伺候 Kindle。
这个整齐得反常,逐本核验过的库存不会这么齐,更像统一写入的字段模板。
而最后一公里是这样的。99.7% 的链接指向同一个第三方网盘域名,几乎都带提取码。点下载之后还要打开网盘页面、输提取码、转存或下载,限速了还得等。24,071 条记录里已经有 69 条的链接字段写着「链接未找到」。
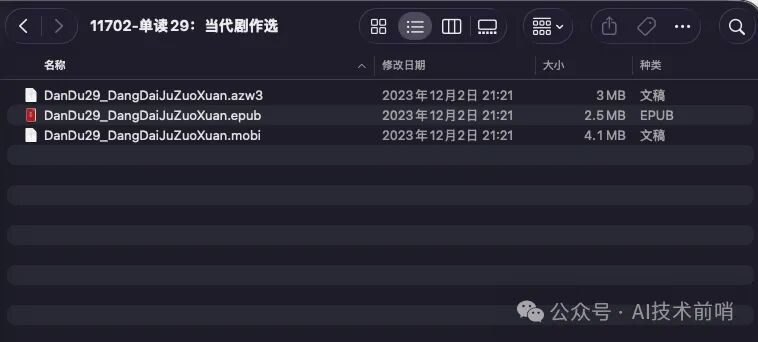
— 网盘里的三个格式文件,原图带公众号水印
两年多、68 次提交,攒出两万四千多条记录
仓库 2023 年 9 月建库,累计 68 次提交,攒出 24,071 条记录,摊下来每次提交带进三百多条。GitHub 上约 1.9 万 Star、2.7k Fork,说明这份索引确实有人用。
它不收钱,不要求关注,搜索页上没有广告位。对比那些先拉人进公众号再甩链接的站点,这个差别本身就是最大的诚意。
仓库在 GitHub 上完整公开,实时搜索页就是从仓库直接发布的,想改关键词范围或分类名字,翻一眼源码就知道在哪动。
同量级还有个反过来的选择。Calibre-Web 的 Star 数跟它几乎一样,但那条路要你囤书、整理、备份,换来的是不依赖任何第三方链接。怕麻烦就用索引,怕失效就自建。
版权那层更需要说清,书是作者一本一本写出来的,链接来自第三方站点,版权情况复杂。把它当试读和找书的工具没问题,真正读下来觉得好的书,还是去正版渠道开会员或买纸书。
什么人适合用,怎么用才不亏
适合四种人。手上有 Kindle 的,Kindle 商店中文书不全,这里三种格式一起给,省掉转格式;听过讲书想找原文细看的,直接搜书名;写东西要翻某本书的具体章节,先下下来确认对路再决定买不买纸书;不知道读什么的时候,把大类当书单逛,比算法推荐有意思。
不适合的也很明确。想找外文书的别抱期待,全库都是中文;想按情节搜书的,它只认书名、作者和分类;想要简介、书评、评分这些内容信息的,它只有书目字段。
用法上有一条能省不少事。搜的时候把书名和作者一起输进去,或者像「沟通 樊登 职场」那样用多个关键词压到几条,比翻一百条快得多。逛分类就从前几十个大类进,别指望只有一两本书的标签。
项目地址是 https://github.com/jbiaojerry/ebook-treasure-chest ,在线搜索页是 https://jbiaojerry.github.io/ebook-treasure-chest/ 。
它把找书这件事从评论区搬进一张能搜的表,可表里装的是别人的网盘,不是书。表能帮你少走半小时弯路,书得自己去拿。
 发表于 昨天 23:05
|
查看: 0|
回复: 0


