问一个架构问题,回答刷出来好几百行。你从上往下读,读到一半忘了前面,想回头对一下某段配置,又得往上翻。
这不全是你注意力的问题。Karpathy 有句话说得很准:AI 干的活越多,人跟不跟得上 AI 的输出反而成了难题。
有个叫 Answer me with HTML 的开源项目就冲着这件事来的。它在 GitHub 上开源两周多,Star 已经涨到三千六百多,MIT 许可。
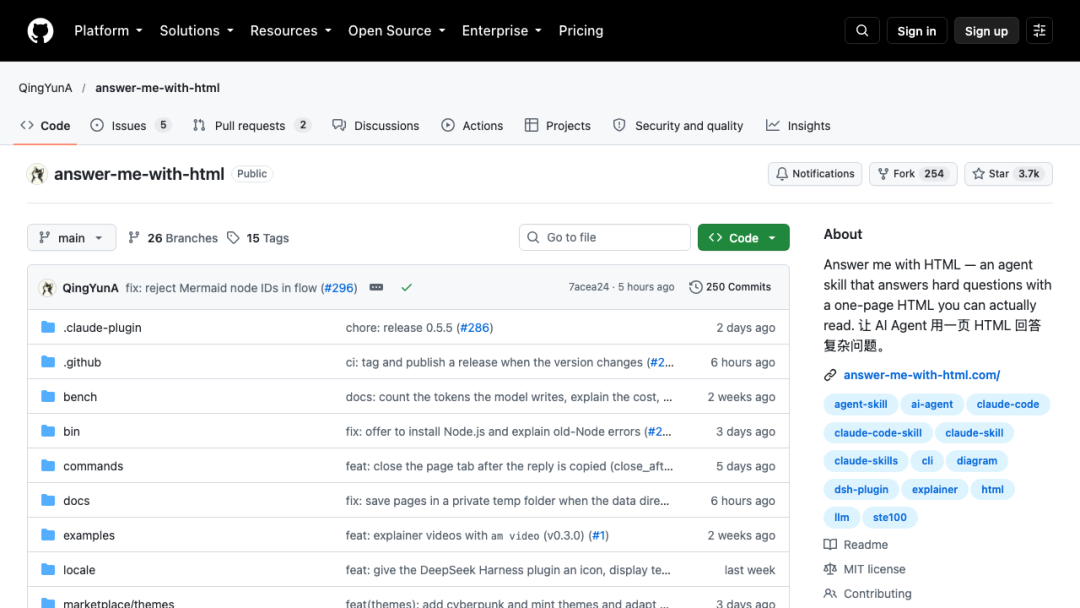
— 仓库首页实时截图,Star 与 Fork 计数同时可见
01 你被自己的 AI 回答淹没过吗
它做的事说破了很简单。你问一个麻烦点的问题,AI 除了回文字,还会顺手生成一页 HTML,把时序图、流程图、对比表画进去。页面在浏览器里打开,文件就在本机,断网了也能看。
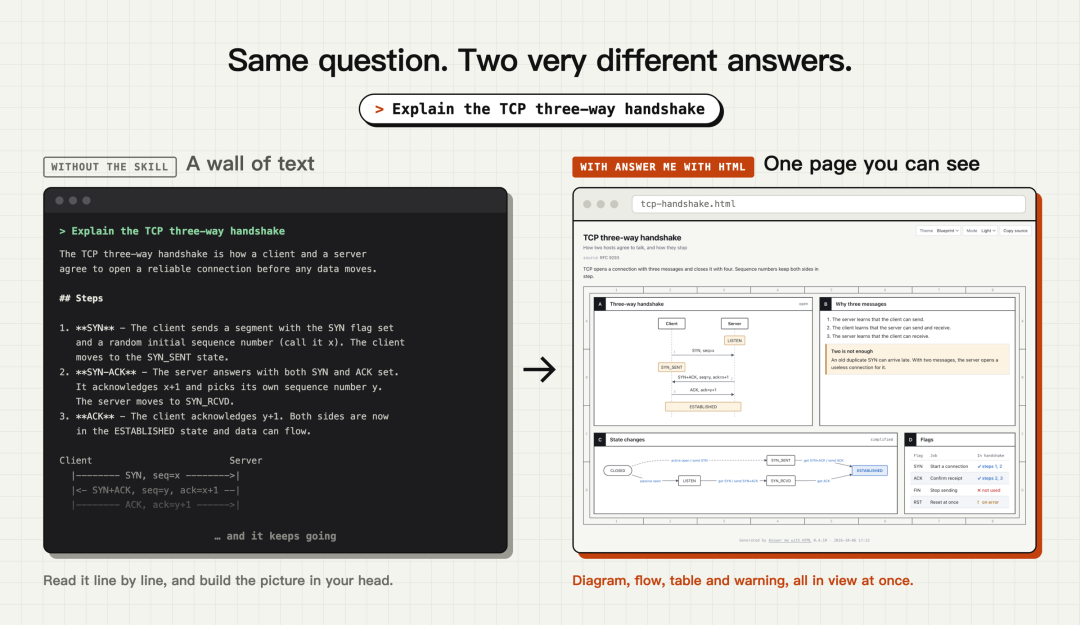
README 首页放了一张对照图:同一个 TCP 三次握手的问题,左边是没装 skill 的回答,一屏终端文字;右边是装了的,一页图上排着时序图、状态图、注意点和标志位表格。
— 同一个问题,两种截然不同的回答
同样的问题,两边的信息量其实差不多,区别在你怎么读它。
02 内容归模型,排版归程序
看到这儿你可能会问,现在模型自己写 HTML 也不差,干嘛还要装这个?
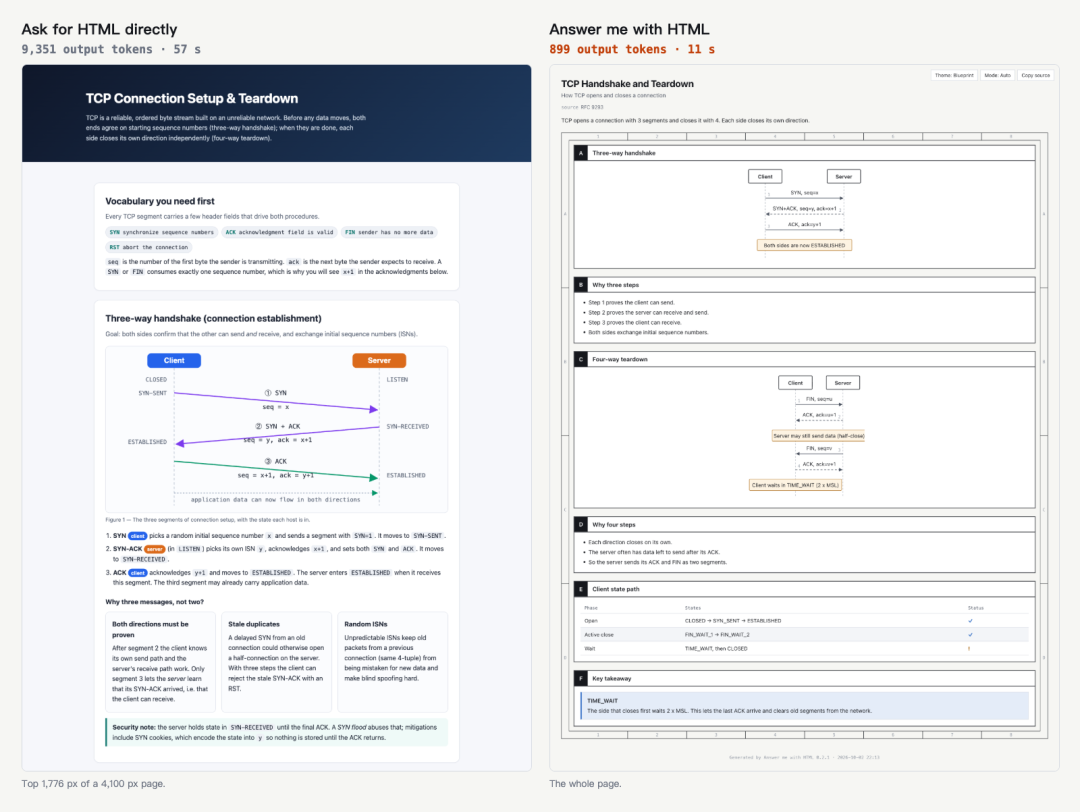
作者的答案藏在一笔账里。他们数了模型手写的 9 个页面,平均 4893 个 token。拆开看,SVG 图的坐标和路径占了 47%,CSS 占 15%,HTML 标签占 17%,真正的内容文本只剩 21%。
也就是说,模型写了十成的东西,只有两成是「话」,剩下八成是架子。
所以这个 skill 把活拆开了。模型只写一份 Markdown 草稿,几百个 token,内容写完就停。排版、配色、画图全交给 skill 自带的一个命令行程序,草稿扔进去,大概 50 毫秒页面就出来了。
— 项目 README 头部,一句话定位写在里面
内容归模型,排版归程序,这两件事分开之后,回答才既有料,又看得下去。
这个分工还顺带解决了一个老毛病。手写的时候,SVG 坐标是模型一个个算出来的,箭头指歪是常事。换成程序之后,流程图用布局算法排,时序图的间距按标签文字的实际宽度算,出来的图起码整整齐齐。
程序还会自己纠错。草稿写错了,它会返回行号、出错的组件名和一段正确示例,agent 一次就能改对。这条比省 token 更影响实际体验,因为少了很多来回。
03 省下来的不是内容,是排版
这笔账还能算得更细。
同一个问题,手写 HTML 平均输出 4893 个 token,等 31 秒;用这个 skill 是 612 个 token,12 秒。数字是官方测的,用的是 Claude Sonnet 5.5,换个 模型 跑出来会有出入,但量级差不太多。
— 两种方式输出的 token 和耗时对比
有意思的是钱。
作者自己在 README 里写明白了:token 省得多,账单省得少,实测账单只降了 15% 上下。因为每轮对话 AI 都要重新读系统提示词和聊天记录,这部分开销装不装 skill 都得花。省下来的那八分之七,省的是「写」,不是「读」。
我觉得这句比任何宣传语都可信。一个开源项目愿意把自己最不性感的数字写在首页,说明它是想让人用,不是想让人冲动下单。
04 它什么时候肯给你画一页
官方给了几个例子,基本能看出它的适用面。
| 你问什么 |
出来的页面 |
| 讲讲 TCP 三次握手 |
时序图、状态图、标志位表格 |
| 这个仓库的模块怎么组织 |
目录树、调用关系图 |
| Redis 和 Memcached 选哪个 |
对比表加结论 |
| 这段话哪里写得不好 |
逐句标注问题和改法 |
| Kubernetes 是怎么来的 |
时间线 |
| ls 怎么显示隐藏文件 |
不出页面,一行问题一行回答 |
最后一行是重点。它不乱出页面。
出不出它自己判断,问题里涉及多个概念、多个步骤或多个方案对比,一般就会出。想让它必须出,直接说一句「用 HTML 给我讲讲」就行。
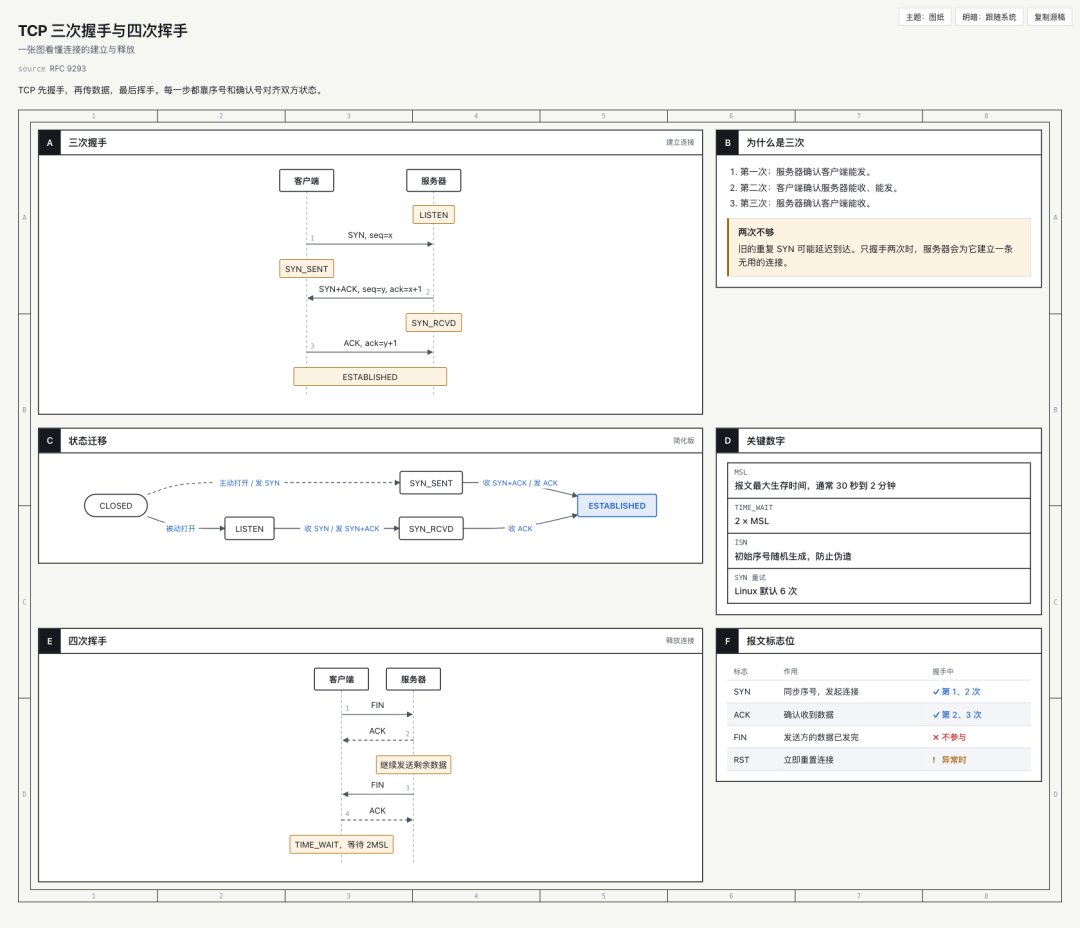
— TCP 三次握手的完整页面效果
页面都存在本地 ~/.answer-me-with-html/pages/ 目录下,一个页面一个文件。右上角有三个按钮,换主题、切明暗模式、复制这页的 Markdown 原文,都收在那里。
另有一个常开模式,默认是关的,但作者建议打开。打开之后,只要 AI 给出结论、总结、方案、对比,哪怕回答很短,也会顺手出一页两到四个面板的小页面,路径贴在回复最后,不弹窗打扰你。
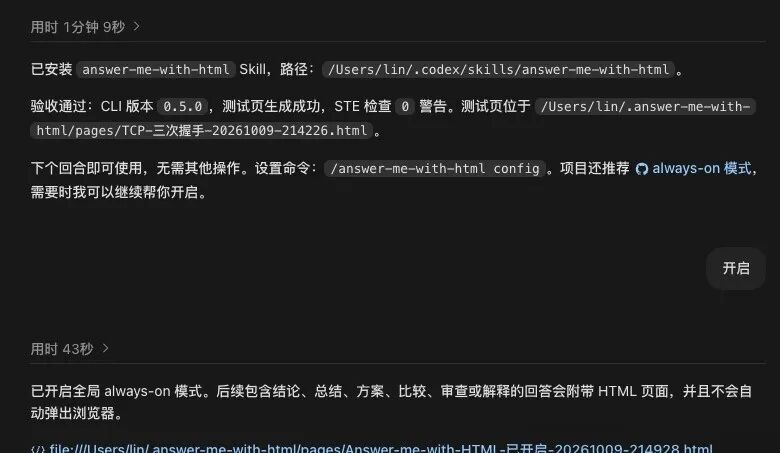
— 常开模式下的小页面
05 它还能把答案讲成一段视频
页面之外还有一条支线,把回答做成 3Blue1Brown 那种一格一格画出来的讲解视频。
做法和页面差不多,草稿里给每个画面配一句旁白就行。生成出来是一个播放器页面,图跟着旁白一步步画,有章节条可以跳着看,也能调倍速。配音是直接塞在页面文件里的,离线也能播。想存成视频文件,本机得有 ffmpeg。
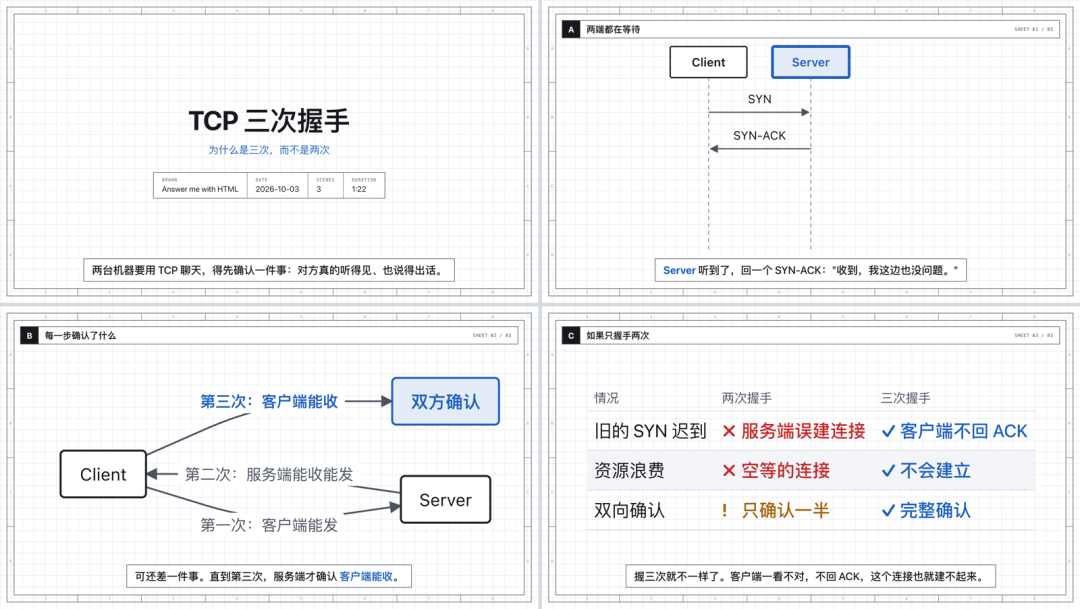
— 讲解视频的分镜效果
视频模式下输出 token 省得更多,官方的小测里是十八倍左右。道理也简单:一页图要写的结构信息,一段动画可以复用。
06 装起来四条路,最省事的是第一条
前提只有一个,电脑里得有 Node.js 20 以上。不用 npm install,命令行程序已经打包在 skill 里了。最省事的做法是把安装这事交给 agent,把下面这段原样贴给 Claude Code 或 Codex,它会自己读完说明、装好、生成一页测试页,然后跟你汇报:
帮我安装 Answer me with HTML 这个 skill:运行 npx -y skills add QingYunA/answer-me-with-html -g -y,用 -a 参数指定你自己这个 Agent
-a 这个参数别省。它就是告诉安装器你装的是哪个宿主,装错了目录,agent 是读不到的。
不想让 agent 动手的话,自己跑一条命令也能装上:
npx skills add QingYunA/answer-me-with-html
它会问你要装到哪个 Agent,这个安装器支持七十多种。
用 Claude Code 的话,还有插件市场这条路,两条命令连着敲:
/plugin marketplace add QingYunA/answer-me-with-html
/plugin install answer-me-with-html@answer-me-with-html
用 DeepSeek Harness 的话,在终端里给它加一个插件源就行:
dsh plugin --profile web add github:QingYunA/answer-me-with-html
装完不用配置,正常提问就行。想确认成不成,拿这两个问题试一遍。问「对比一下 Git 的 merge 和 rebase,分别什么场景用」,应该出一张对比表加结论;问「从输入网址到页面显示出来,中间发生了什么」,应该出一张完整流程图。
两条都出了页面,就说明通了。页面落在 ~/.answer-me-with-html/pages/ 里,页面攒多了用 am clean 收一下。
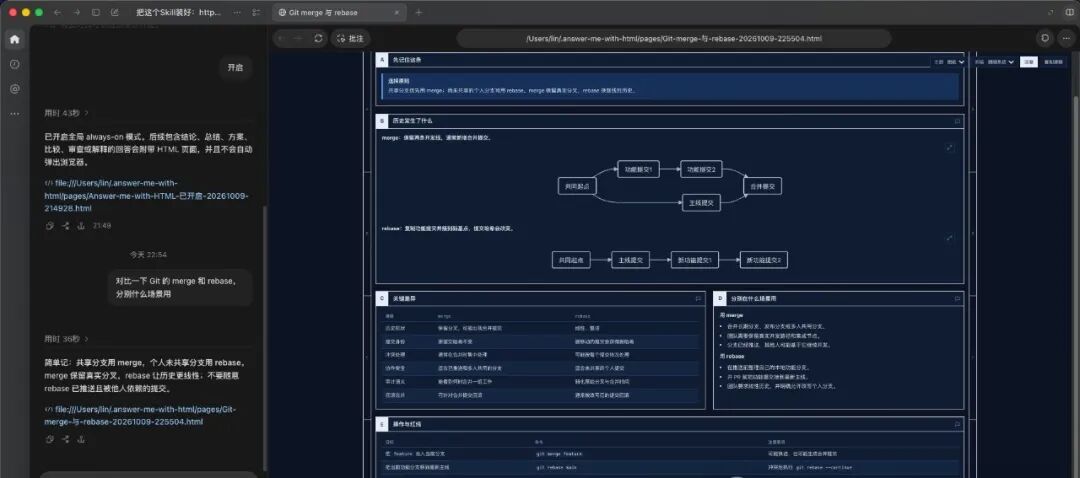
— Git merge 与 rebase 对比页面
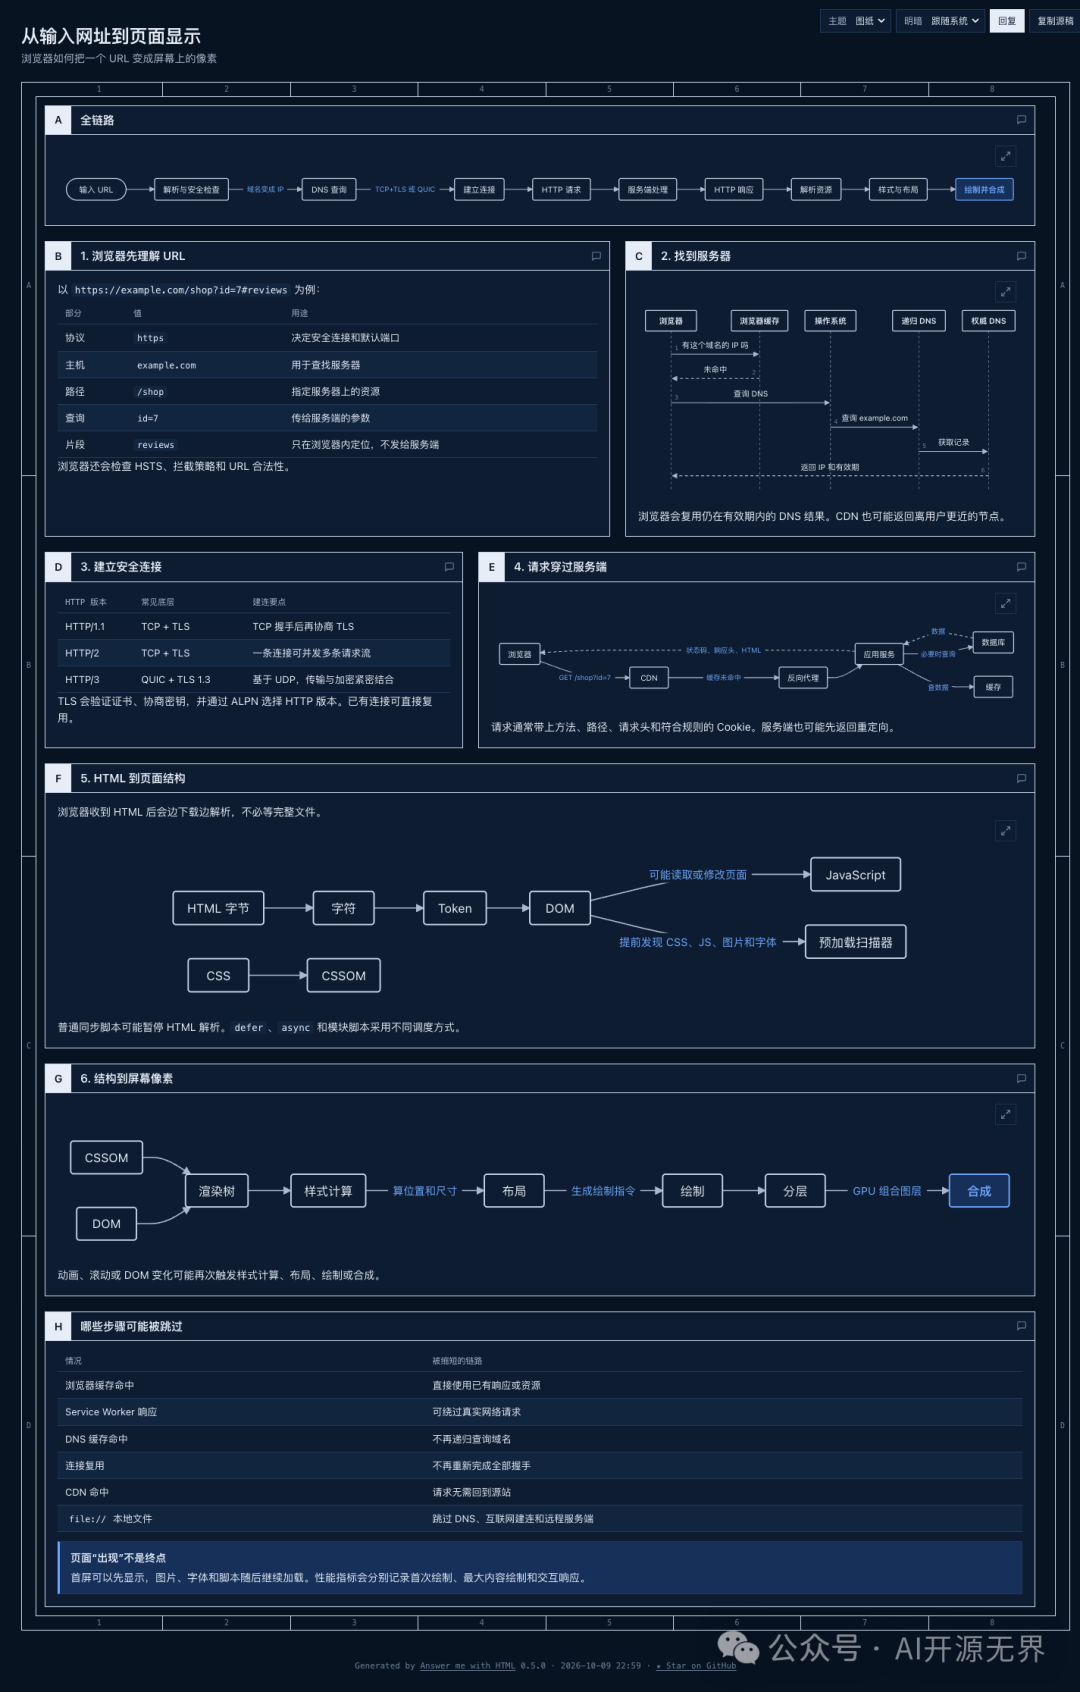
— 从输入网址到页面显示的流程图
07 它是更好的看法,不是更好的答案
用它用下来的感受是这样:它没让 AI 答得更对,内容还是那些,只是换了个看法。
解释、对比、流程这类问题,看一页图确实比看一屏字省劲。想把回答发给别人看的时候,发一个 HTML 文件也比截一长串聊天记录像样。
还有一个写作检查,规则是从 ASD-STE100 改的。那是航空业为了维修手册搞的一套受控英语,把能用的词和句式都限死了,让技术文档谁来读理解都一样。这个项目把它改成检查 AI 草稿的规则,中英文都查,啰嗦的句子、被动语态、套话都会被拎出来。默认只警告,要拦下来得手动开严格模式。
它是 MIT 协议,免费用。真要挑毛病的话,它换的是看的角度,不是思考的深度。你自己的判断力还是得留着。
开源地址是 https://github.com/QingYunA/answer-me-with-html 。如果你也在折腾这类 AI Agent 工具,欢迎到 云栈社区 交流使用经验。
 发表于 昨天 22:10
|
查看: 10|
回复: 0
 /1


