LLM 带火了 Agent,但当 Agent 开始看图、听声、看视频时,整个架构该怎么变?
马里兰大学、牛津、KAUST、NUS 这篇 60 页综述,首次以模态为中心的视角,系统梳理了多模态如何重塑 Agentic 框架的每一个模块——感知、推理、规划、记忆与行动。
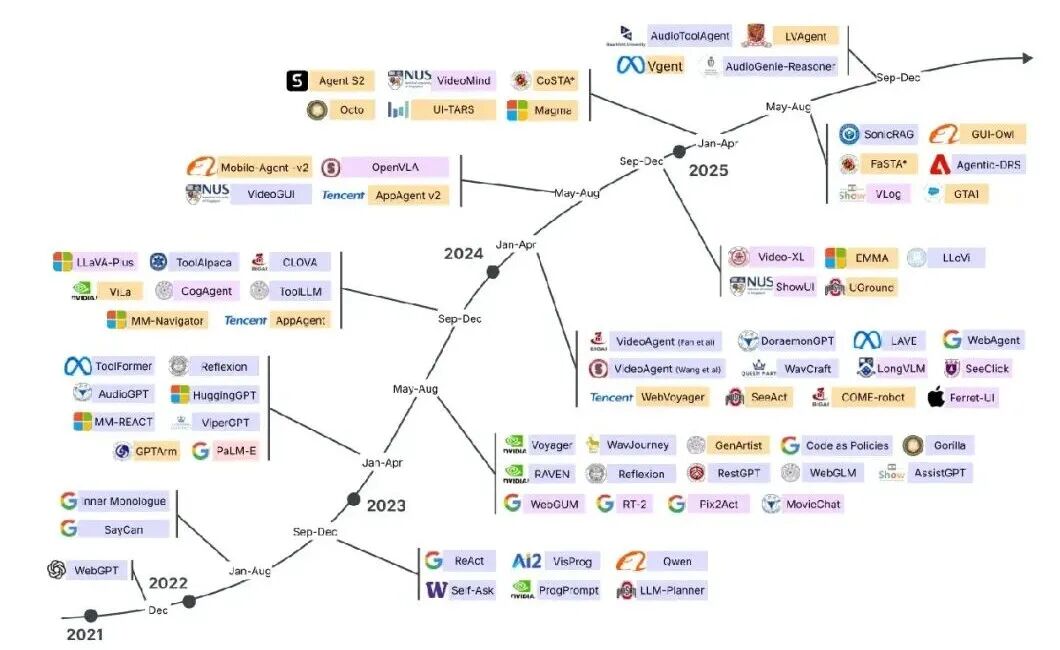
从 2021 年 WebGPT 起步,到 2025 年 early-fusion 一统江湖的趋势,演进路线一目了然。
认知闭环:Agent 的三件套
把现代 Agentic 框架抽象为一个仿生认知闭环:感知(Perception)→ 编排器(Orchestrator)→ 行动(Action)。
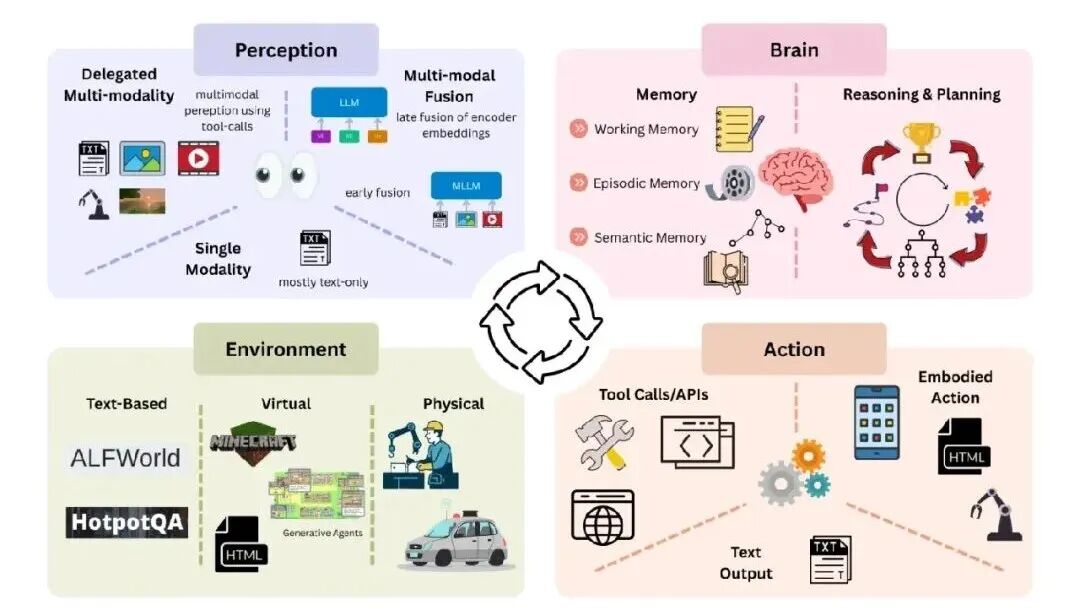
- 感知模块负责把原始多模态输入"翻译"为可推理的表征;
- 编排器是"大脑",承担 推理、规划与记忆管理(工作记忆、情景记忆、语义记忆三层);
- 行动模块通过工具调用、GUI 操作或物理执行与环境交互,并把结果写回记忆。
感知融合的三代范式
按多模态信息如何进入大脑,划分出三代感知策略:
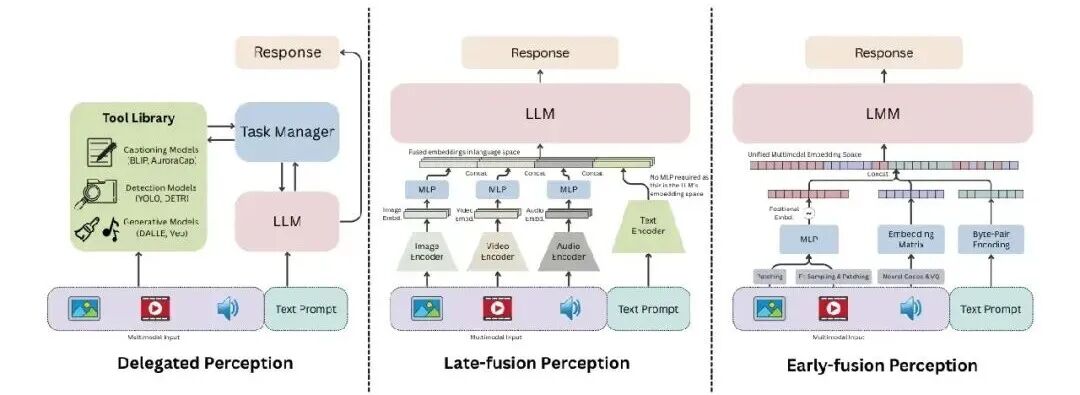
- 委托式(Delegated):纯文本 LLM 当指挥官,调用 CLIP、SAM、Whisper 等外部工具,把图像/音频转成文字再理解。模块化强,但"看图说话"必然丢失信息;
- 晚期融合(Late-fusion):用冻结的模态编码器 + 投影层,把视觉 token 注入 LLM 嵌入空间(LLaVA、Flamingo 路线),轻量、可本地部署;
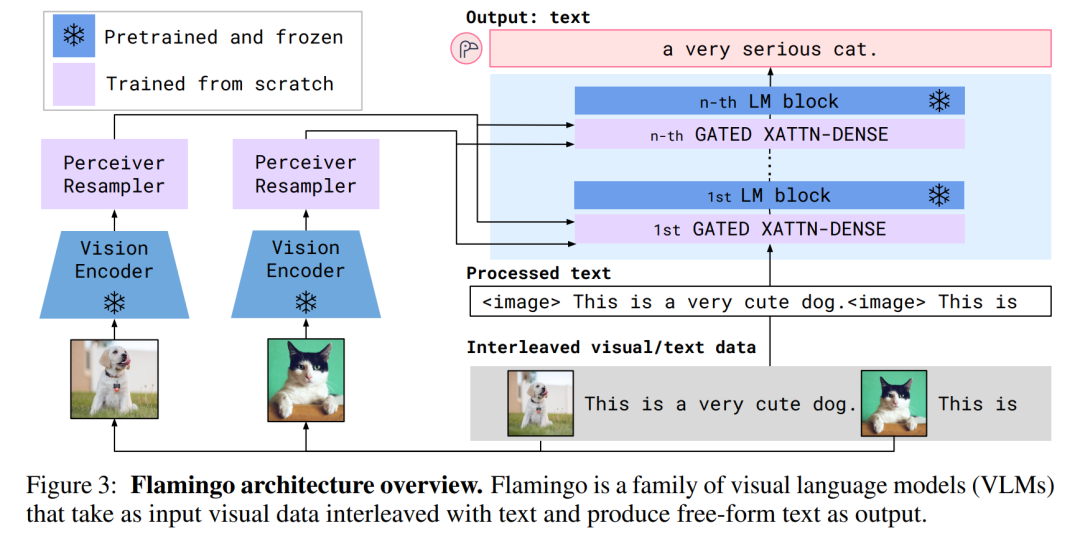
- 早期融合(Early-fusion):GPT-4o、Gemini 这类 原生多模态模型,所有模态统一分词、共享注意力,跨模态理解最深,但推理成本高。
融合多模态信息的框架,普遍优于以语言为中间表示的框架——文字转译是有损压缩。
多模态重塑五大模块
以此为轴,展开了一套模态中心的分类法:
- 推理规划:从纯语言的 CoT/ReAct,到视觉锚定推理(Set-of-Marks、坐标定位),再到 ImageBind 式的跨模态联想;
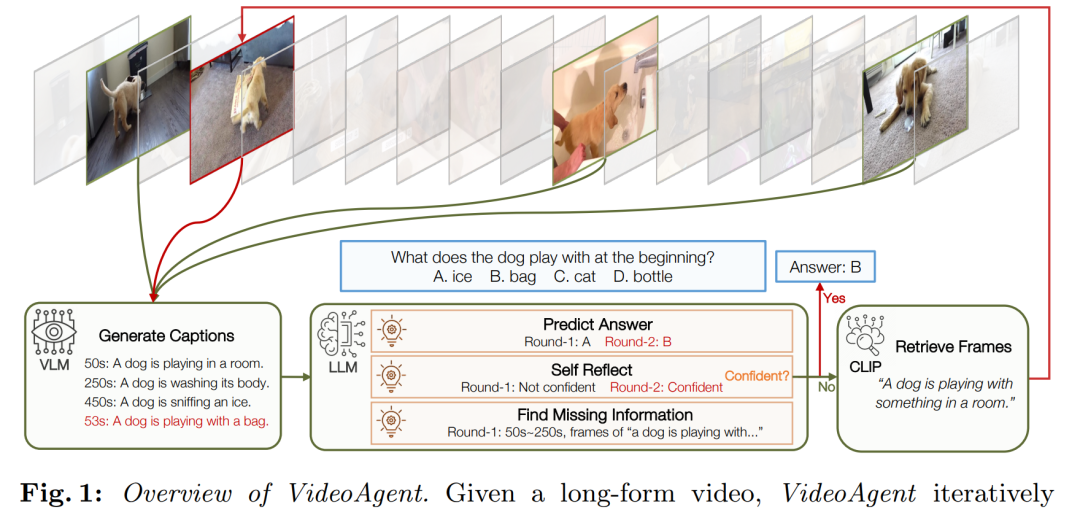
- 记忆:从"各模态分库存、文本做索引",走向统一嵌入空间的 跨模态检索(如 HM-RAG);同时必须处理上下文爆炸——VideoAgent 用稀疏检索把每查询帧数压到 8.4 帧,处理量降低 20 倍;
- 行动空间:从 JSON/API 调用,扩展到像素级点击(GUI Agent)与连续电机控制(VLA 模型如 RT-2、OpenVLA)。
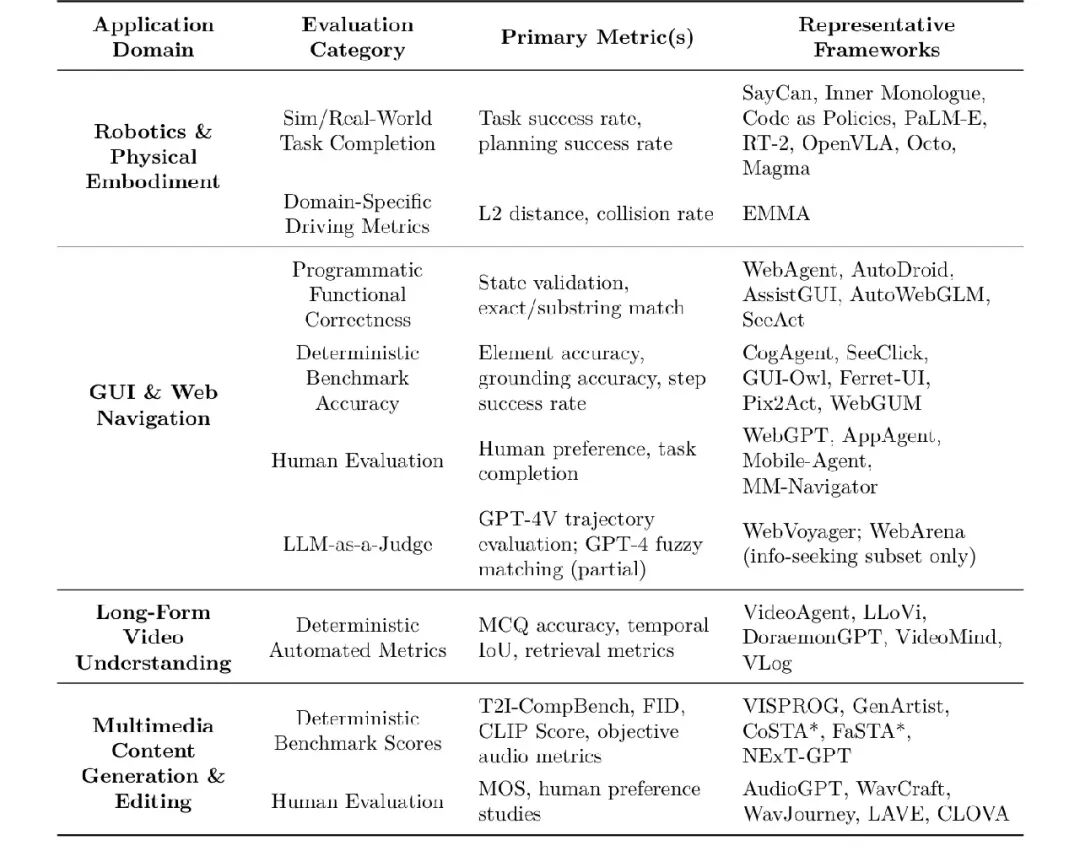
评估方式上有个反直觉发现:LLM-as-a-Judge 只占约 5%,且仅限于 GUI/Web 领域;机器人和视频理解几乎全部依赖任务成功率等确定性指标。
四大应用版图
论文将代表性框架归入四大战场:
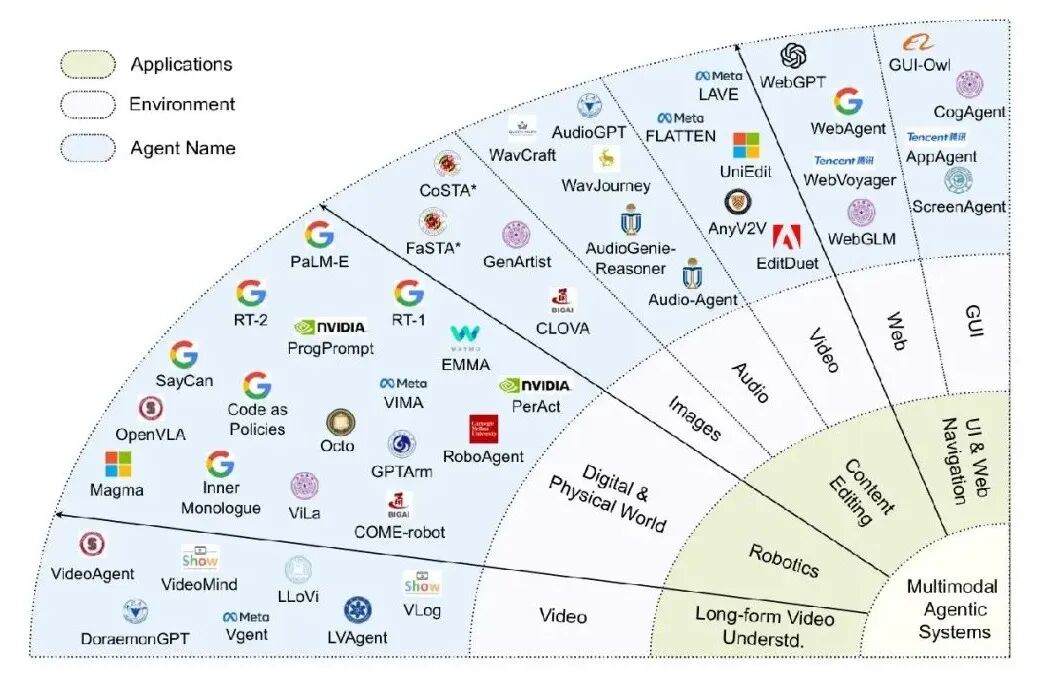
- 机器人与具身智能:从 SayCan 的"语义+物理可行性"双重打分,到端到端 VLA(RT-2、OpenVLA、π0.5、GR00T N1)直接输出动作 token;
- GUI 与网页导航:SeeAct、WebVoyager 靠视觉定位操作界面,但与人类仍有 60–70% 的差距(WebArena 等基准);
- 多媒体内容生成与编辑:GenArtist、AudioGPT 等编排生成工具链;
- 长视频理解与检索:VLog、VideoMind 等解决小时级视频的时序推理。
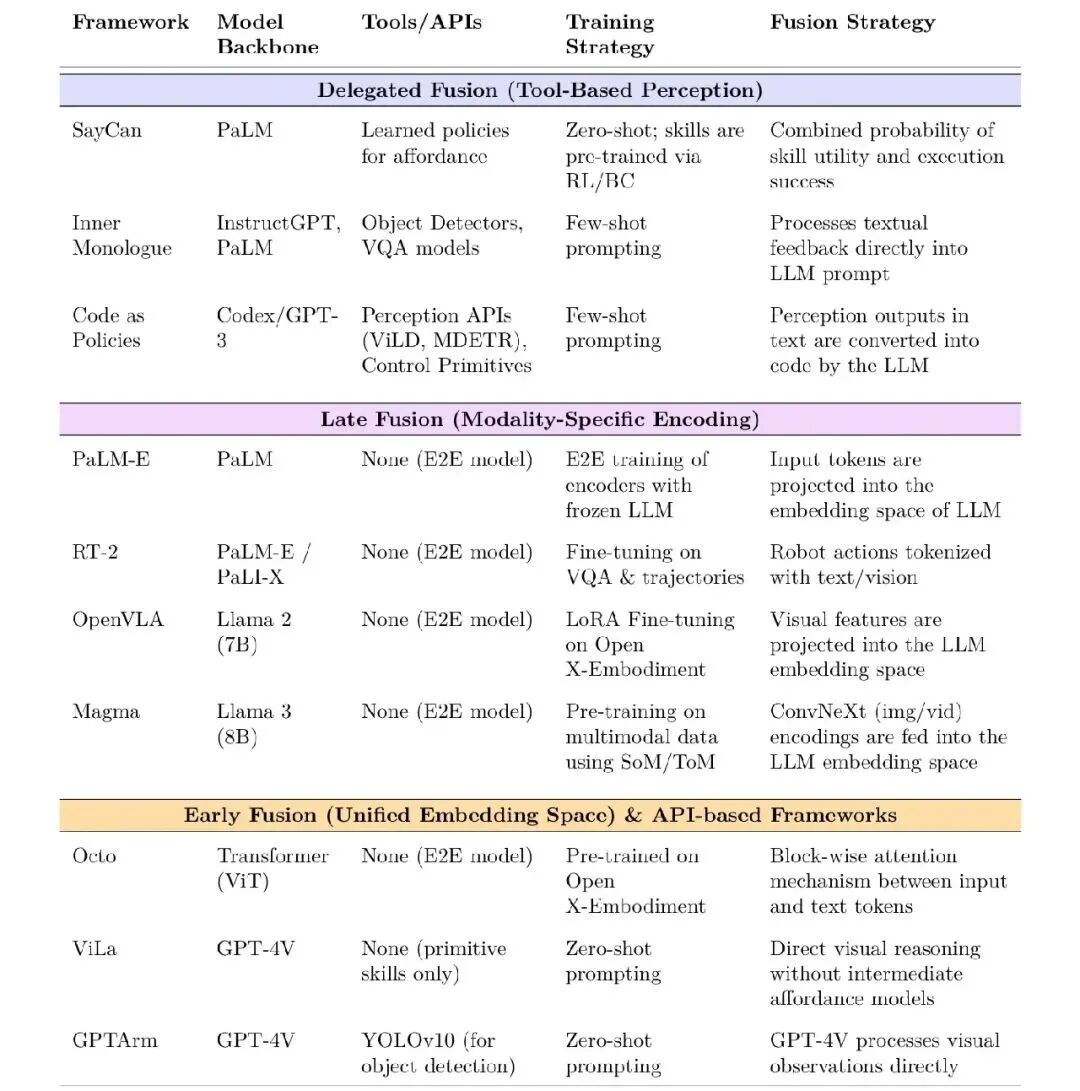
机器人领域的框架对比尤其能说明问题——可以清楚看到骨干模型、训练策略与融合方式的三代演进。
结语
这篇综述的价值不在于罗列了多少模型,而在于提供了一把"模态标尺":下次看到一个新 Agent 框架,先问三个问题——感知怎么融合?记忆怎么存?行动怎么接地? 答案基本就决定了它的能力上限与部署成本。对这类技术趋势解读感兴趣,也可以常来 云栈社区 逛逛,相关讨论和资源共享都在持续更新。
A Survey on Foundations and Frontiers of Multimodal Agentic Frameworks: Techniques and Applications
https://arxiv.org/pdf/2608.20379
|  发表于 昨天 19:28
|
查看: 14|
回复: 0
 /1


