开场
softmax 加交叉熵大概是深度学习里最“不值得怀疑”的组件了。所有主流框架——JAX、PyTorch、TensorFlow——的实现都遵循同一套教科书写法:先减去 logit 最大值防止溢出,再算指数归一化。这套写法早在 2002 年就写进了数值分析教材。
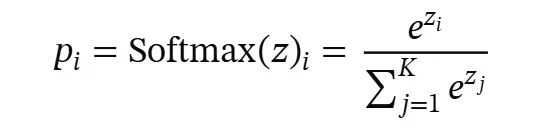
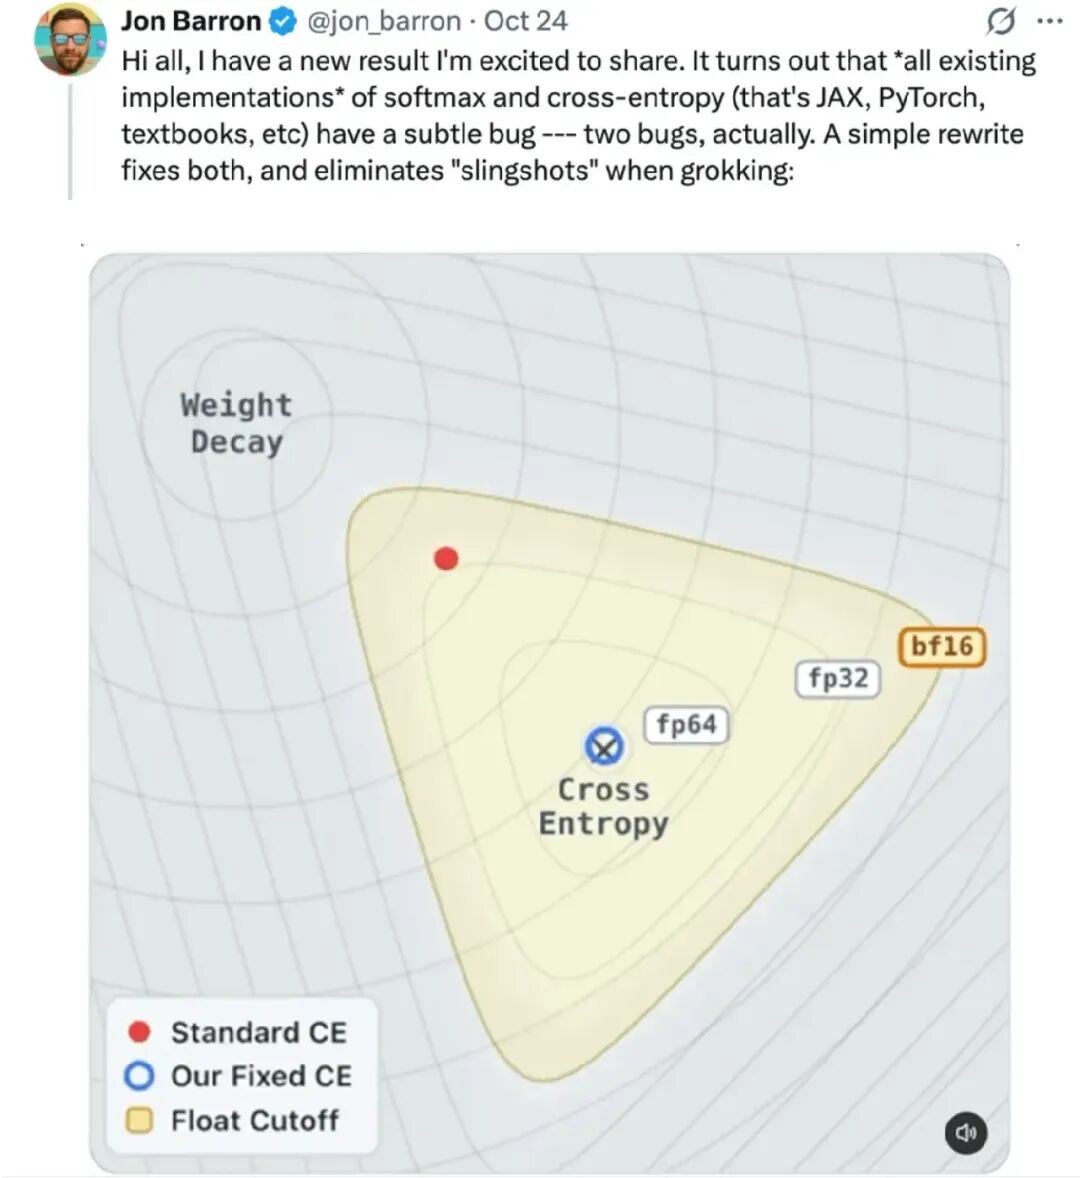
直到 Google DeepMind 发现:这套标准实现里藏着两个数值 bug,而 grokking 研究中困扰大家多年的 Slingshot 损失尖峰,正是 bug 的直接后果。
两个 bug:精度悬崖与相消误差
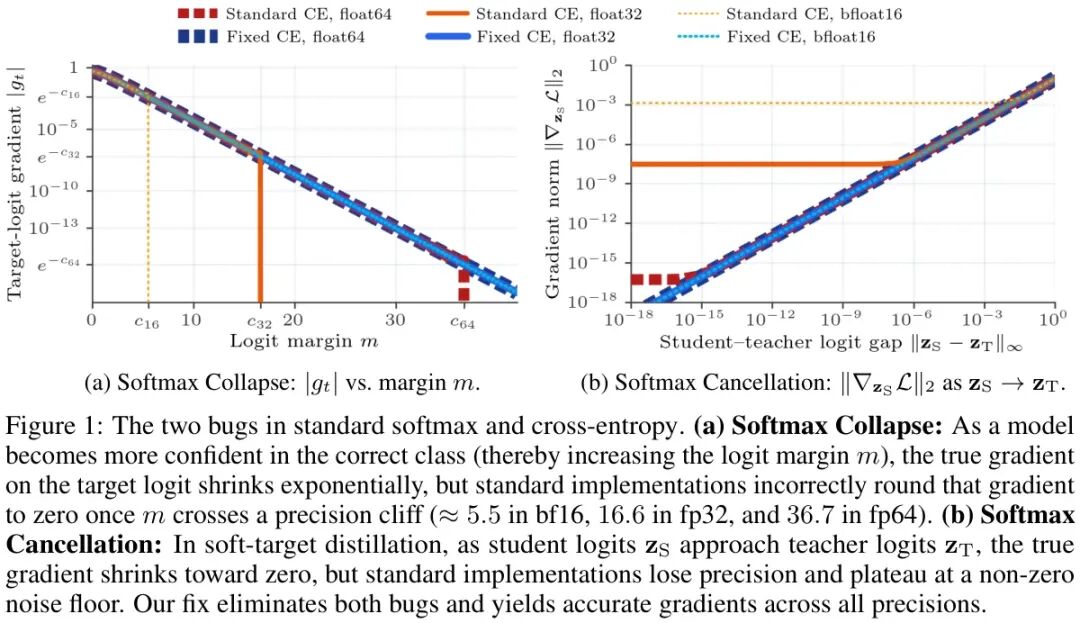
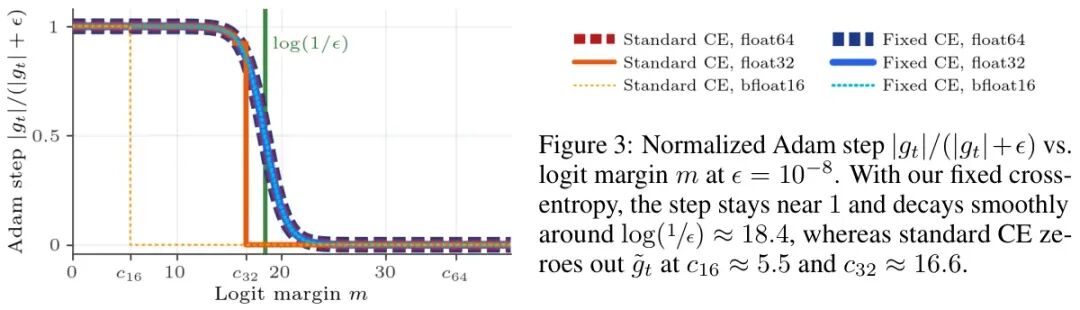
第一个 bug 叫 Softmax Collapse。 当模型对正确答案越来越自信(用 logit margin m 衡量自信程度),目标 logit 的梯度本应指数级缩小、但始终非零。可标准实现里,一旦 m 越过一道“精度悬崖”——bf16 约 5.5、fp32 约 16.6、fp64 约 36.7——这个梯度就被直接舍入成 0。
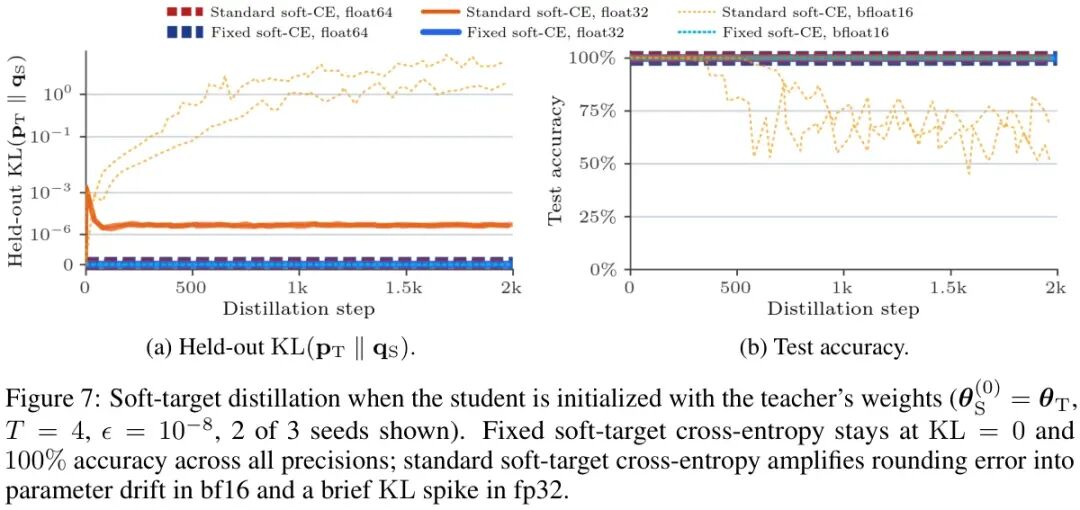
第二个 bug 叫 Softmax Cancellation,专坑蒸馏。 学生 logits 逼近教师 logits 时,标准实现分别算出 q 和 p 再相减。两个近乎相等的概率相减,精度大打折扣;更糟的是前向用 softmax、反向用 log-softmax,公式路径不同,即使学生与教师完全相等,梯度也不为零,留下一层甩不掉的噪声地板。
修复:核心就一句话
两个 bug 的修复思路出奇朴素:
- 永远别把 1 和 e^{-m} 直接相加。 把最大 logit 位精确置 0,用数值稳定的
softplus(−m) 替代 log(1+e^{-m}),autodiff 会自动推出“目标梯度 = 非目标梯度之和取负”,天然零和。
- 在 log 空间直接算 q − p。 借助
expm1 和 log1p 避开一切“减 1”操作,学生等于教师时梯度精确为 0。
不修精度、不做内部 cast,几行代码的 drop-in 替换,几乎没有额外开销。
如果你对 softmax 加交叉熵的底层实现感兴趣,可以看看深度学习必修课:进击算法工程师,其中系统讲解了从数学基础到 Transformer 的完整推导路径。
Slingshot 的真相:一场由舍入误差引发的循环
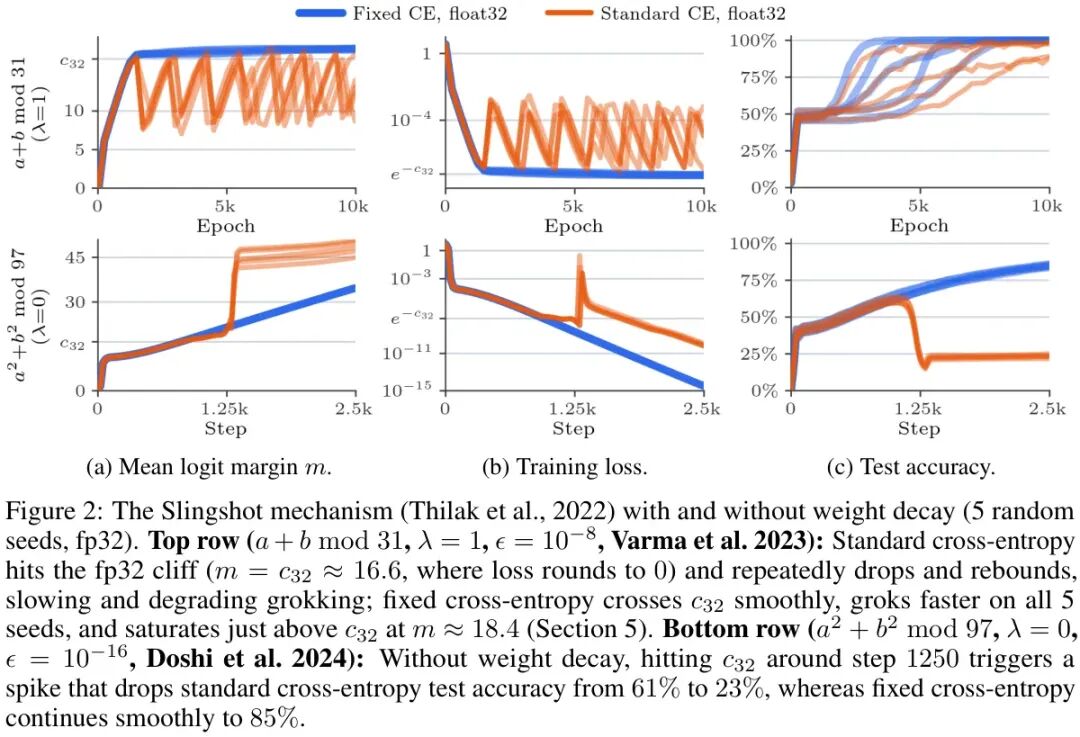
grokking 训练中,网络先火速记忆训练集,泛化姗姗来迟,期间损失曲线上反复出现诡异尖峰——这就是 Thilak 等人 2022 年记录的 Slingshot 现象。本文给出了一条完整的因果链:
margin 涨过精度悬崖 → 目标梯度被清零 → 参数梯度近乎消失 → Adam 的二阶矩 √v̂ 指数衰减 → 权重衰减把个别样本拖回悬崖之下 → 目标梯度突然恢复,而 Adam 此时要除以一个极小的 √v̂+ϵ → 一步巨大的参数更新 → 损失尖峰 → 周而复始。
修复后的交叉熵让梯度平滑穿过悬崖,尖峰彻底消失。上图两组实验很说明问题:有权重衰减时,修复版 5 个种子全部 grok 成功(100±0%,标准版 94±5%);无权重衰减时,标准版在约 1250 步撞崖,测试准确率从 61% 崩到 23%,修复版则平稳走到 85%。
关于 Adam 的二阶矩 √v̂ 指数衰减这一优化器行为,AI人工智能工程师:从入门到精通全栈实战课程中也从训练调优角度做了相关剖析,适合想深入理解优化器数值特性的读者。
一个漂亮的副产品:m* ≈ log(1/ϵ)
修复后还有一个耐人寻味的现象:margin 不再无限增长,而是停在 18.4 附近。这不是精度限制,而是权重衰减与 Adam 归一化步长的平衡点。当梯度 |g| 缩到远小于 ϵ 后,Adam 的归一化步长随 e^{-m} 衰减,与权重衰减 λθ 抵消时训练自锁,解出来就是 *m ≈ log(1/ϵ)**。
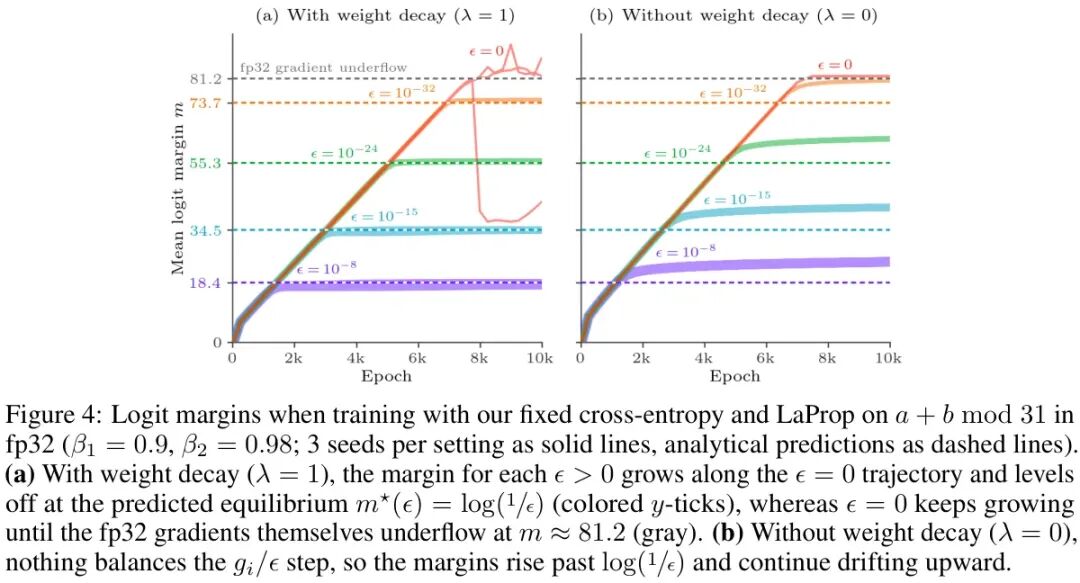
这个公式顺手解释了为什么默认配置必然中招:ϵ=10^{-8} 时平衡点在 18.4,恰好比 fp32 悬崖 16.6 高一点点——标准实现总是在到达平衡之前先撞崖。
作者用 LaProp 在 fp32 下验证了跨越多个数量级的 ϵ,实测平衡点与解析预测逐一吻合;ϵ=0 时 margin 则一路涨到梯度本身下溢(m≈81)才停。
实验:修复版全精度通关
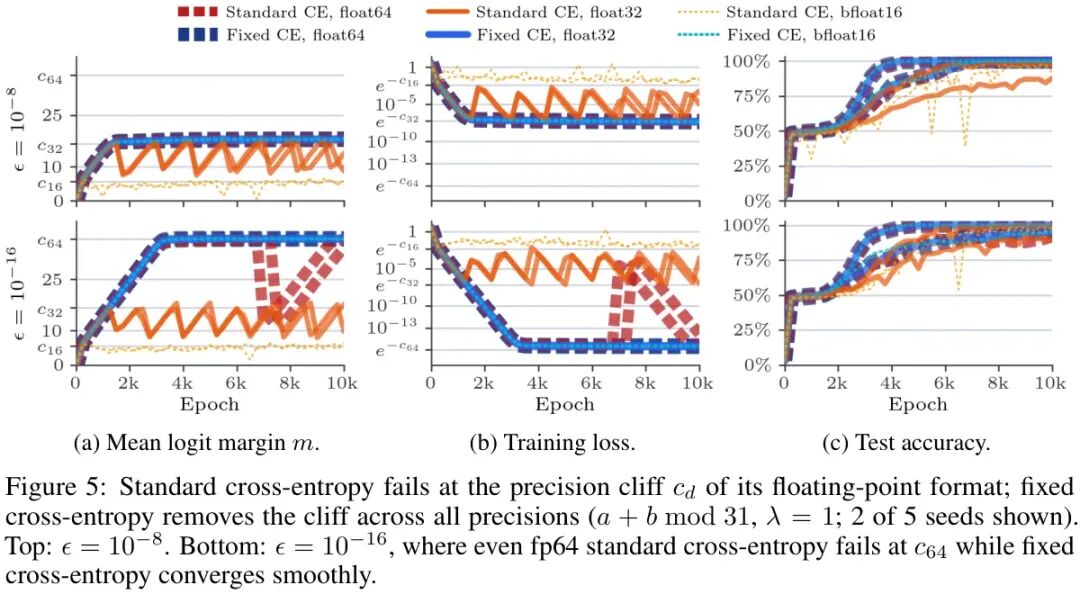
在 a+b mod 31 的 grokking 基准上,标准实现一路撞墙:bf16 在 m≈5.5 就停滞,fp32 在 16.6 反复尖峰;把 ϵ 降到 10^{-16} 后,连 fp64 都在自己的悬崖 36.7 处翻车。修复版则在三种精度下全部平滑收敛到 100% 测试准确率。
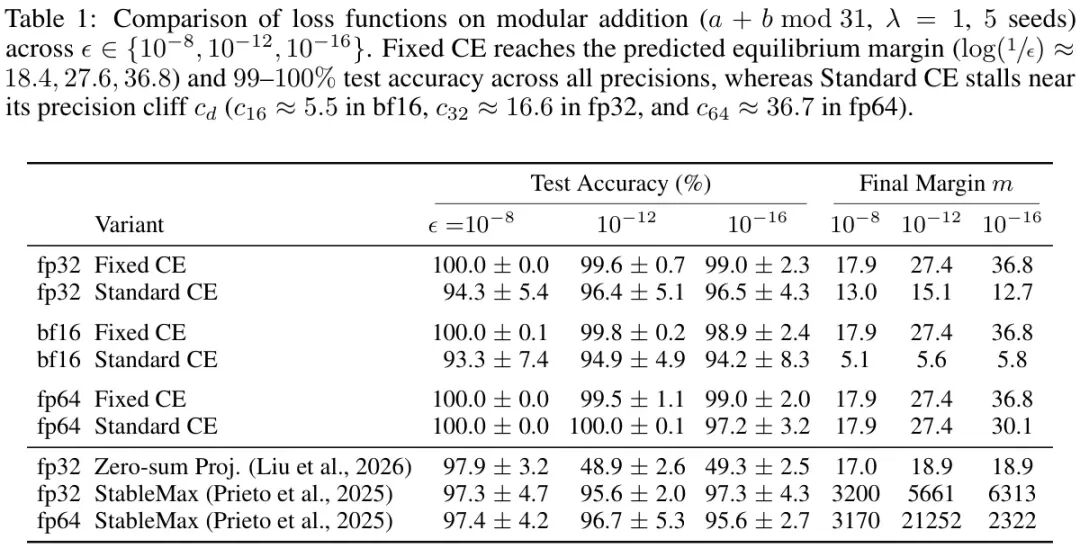
与两种近期改进方法相比,差距同样明显:Zero-sum Proj. 只给目标 logit 补回 −1/K 的梯度,margin 卡在 18 附近,ϵ≤10^{-12} 时准确率跌破 50%;StableMax 改用线性增长的替代函数,margin 失控膨胀到 10³–10⁴,准确率全面落后。
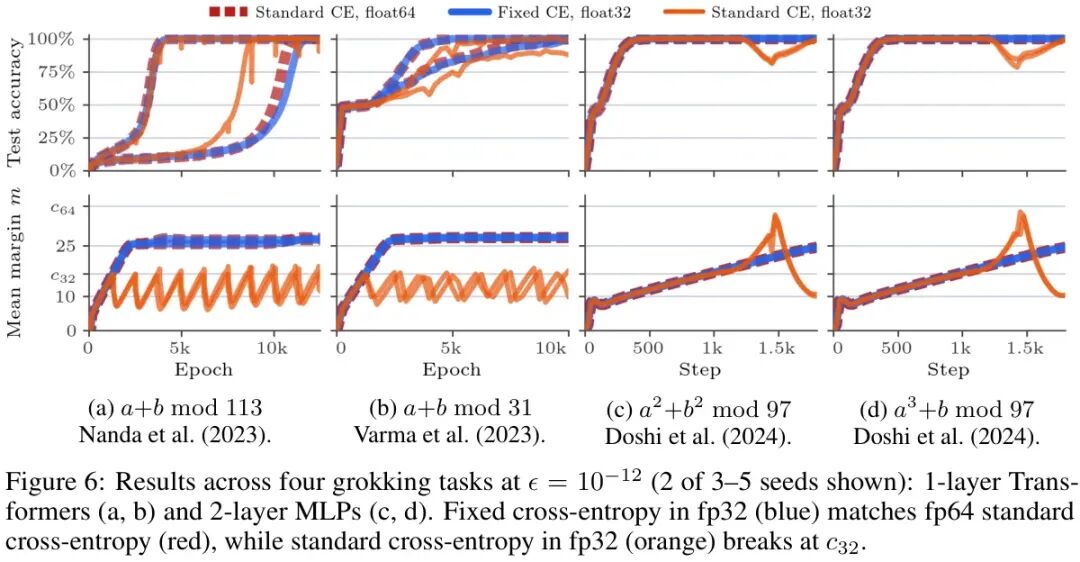
泛化性也站得住:文献中四个不同的 grokking 任务上,fp32 修复版的表现追平 fp64 标准版,而 fp32 标准版无一例外在悬崖处崩坏。
论文信息
论文标题:A Fix for Softmax and Cross-Entropy
论文地址:https://arxiv.org/abs/2610.31642
 发表于 昨天 20:01
|
查看: 21|
回复: 0
 /1


