10 月 21 日,谷歌宣布开源 TorchTPU。这是谷歌与 Meta PyTorch 团队共同开发的原生 TPU 软件栈,开发者只需做少量代码改动,就能把现有 PyTorch 模型部署到谷歌 TPU 上。
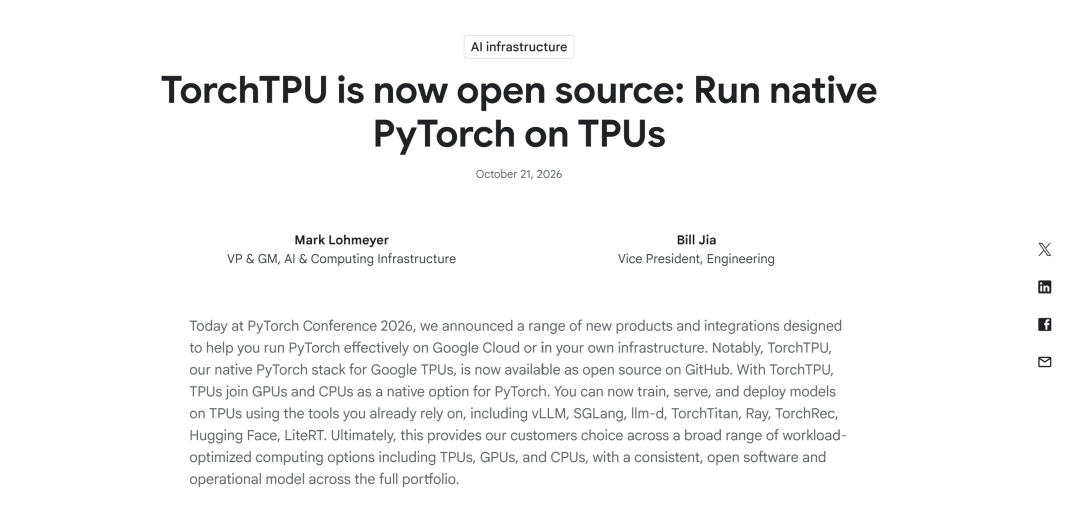
据 TechCrunch 报道,目前多数 AI 应用仍跑在英伟达 GPU 上,谷歌这次开源,被外界视为试图松动英伟达在 AI 基础设施领域的主导地位。
PyTorch 是用于开发和训练 AI 模型的开源深度学习框架,由 Facebook AI Research(现 Meta AI)团队于 2016 年启动开发,2017 年正式开源。如今,PyTorch 已经成为全球 AI 研究和应用开发中使用最广泛的框架之一,覆盖大语言模型、计算机视觉和生成式 AI 等领域。
围绕 TorchTPU,谷歌还将 TPU 接入 vLLM、SGLang、llm-d、TorchTitan、VeRL、Ray、Hugging Face 和 LiteRT 等工具,覆盖大模型训练、推理、强化学习、集群调度以及端侧部署等场景。
谷歌称,基于 TorchTPU 的训练方案已在最多 8000 颗 Ironwood TPU 上完成验证,在 Qwen3-8B 训练测试中实现最高 52% 的模型浮点运算利用率;在推理侧,印度 AI 模型公司 Zenteiq.ai 使用相关方案后,整体推理吞吐量提升超过 4 倍。
对开发者而言,已有的 PyTorch 模型可以更容易迁移到 TPU,常用的训练、推理和任务调度工具也能继续使用。开发者还可以根据模型规模、运行速度和成本,在 TPU、GPU 和 CPU 之间灵活选择。
TorchTPU 开源,PyTorch 模型可直接迁移至 TPU
TorchTPU 支持开发者使用标准 PyTorch API 在 TPU 上运行模型。开发者可以先通过 eager mode 调试模型,再使用 torch.compile 进行编译优化,从而提升 TPU 利用率并降低内存开销。
谷歌称,TorchTPU 还支持分布式计算和多种诊断工具,可以减少开发者针对不同硬件反复修改代码的工作量。
Meta PyTorch 工程总监贾娜·范·格鲁嫩(Jana van Greunen)表示:“Meta 需要在多种硬件架构上运行大模型、广告和推荐系统,TorchTPU 让 Meta 能够将 PyTorch 工作负载部署到谷歌 TPU 上,并直接向相关工程团队反馈使用情况。”
谷歌还与 Hugging Face 合作,让 Hugging Face Hub 上的热门开源模型原生运行在 TorchTPU 上。
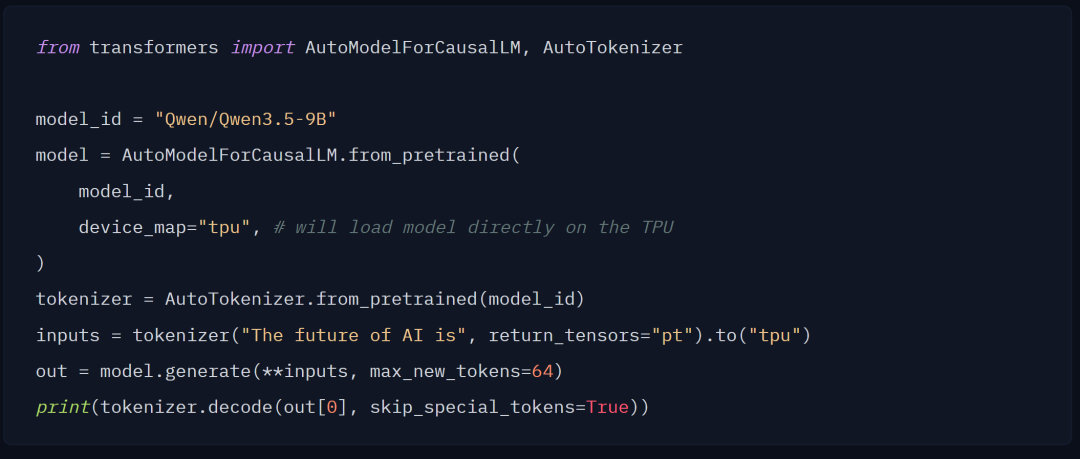
在大模型开发库 Transformers v5 中,开发者只需设置 device_map="tpu",即可将模型部署到 TPU。在扩散模型工具库 Diffusers 中,开发者可以使用 torch.compile 和张量并行,在多颗 TPU 上运行大型生成模型。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu",  # will load model directly on the TPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
开源地址:https://github.com/google-pytorch/torch_tpu
多款开源工具接入 TPU,降低大模型推理成本
随着推理模型和 Agent 模型规模扩大,推理成本与延迟逐渐成为生产环境中的主要瓶颈。谷歌已将 TorchTPU 接入多个开源推理框架,并通过 Kubernetes 集群管理系统的原生路由能力,帮助开发者在 TPU 和 GPU 之间调度工作负载。
此次谷歌重点围绕三类工具展开合作:vLLM 是用于高效部署大语言模型的推理引擎,SGLang 主要面向结构化生成和 Agent 工作负载,llm-d 则负责在大规模服务器集群中编排和调度推理服务。相关更新覆盖模型运行、请求处理和集群调度等环节。
谷歌已与 Inferact 合作,为 vLLM 推出基于 TorchTPU 的原生后端,支持连续批处理、量化和多芯片并行,同时保留 vLLM 原有的模型执行、请求调度和 API 服务架构,开发者无需大幅调整现有系统。
谷歌还与 RadixArk 合作,为 SGLang 开发 TorchTPU 后端。SGLang 可以复用不同请求之间的缓存,减少重复提示词的计算,并针对多步骤生成和 Agent 任务优化延迟与吞吐量。
此外,谷歌宣布与红帽、IBM 及超过 500 名贡献者、25 家机构共同发布 llm-d 1.0。该项目可以根据缓存情况分配请求,并将推理过程中的不同阶段拆分处理。1.0 版本新增多租户流量控制、高可用路由和面向 Agent 的会话路由。
在谷歌 Kubernetes Engine(GKE)上,开发者可以通过统一的 llm-d 端点,在 GPU 和 TPU 之间选择更适合具体工作负载的硬件。
据 AI 模型公司 Zenteiq.ai 创始人萨希库马尔·加内桑(Sashikumaar Ganesan)称,该公司使用基于 llm-d 的 GKE Inference Gateway 生成合成数据后,整体推理吞吐量提升超过 4 倍,在 1000 颗 TPU v6e 加速器上的日生成 Token 数从 14.7 亿提升至 59.7 亿。
支持 8000 颗 TPU 系统训练大模型,效率最高 52%
在训练侧,谷歌将 TorchTPU 接入 PyTorch 社区的训练、强化学习和编排框架。
TorchTitan 是 PyTorch 原生的可扩展分布式训练参考实现,目前已完成与 TorchTPU 的生产级集成。
TorchTitan 为多类模型提供了预训练配方,包括 Llama 3 70B 和 405B、Qwen3-8B 和 Qwen3-32B、MuseGlimmer 30B 等稠密模型,Qwen3-235B 等混合专家模型,以及 FLUX.1 系列 12B 等扩散 Transformer 模型。
谷歌称,TorchTitan 已在 8000 颗 Ironwood TPU(TPU v7x)上完成验证。在 Qwen3-8B 训练测试中,TorchTPU 训练路径实现最高 52% 的模型浮点运算利用率,并在最多 8192 颗 Ironwood TPU 上保持接近线性的扩展能力。
针对强化学习场景,谷歌向 VeRL 贡献了 TPU 后端和端到端参考配方。该方案基于训练器与采样器分离的架构,支持在数学推理数据集上运行 GRPO(群体相对策略优化),同时保留原有的硬件无关模型和算法代码。
谷歌也为 Ray 加入 TorchTPU 支持。开发者可以在同一套 Ray 工作流中调度 CPU、GPU 和 TPU 资源,用于数据处理、训练、强化学习和推理,并将不同阶段的任务分配到更适合的加速器上。
PyTorch 模型可运行在手机、电脑和物联网设备上
谷歌此次还宣布,LiteRT 正式加入 PyTorch 生态。LiteRT 原名 TensorFlow Lite,是谷歌面向端侧 AI 推理推出的高性能框架。
通过 LiteRT-Torch,开发者可以使用一次调用将 PyTorch 模型转换为 LiteRT 格式。该方案基于 Core ATen 算子构建,模型代码仍可保持在 PyTorch 体系内。
对于大语言模型,LiteRT-Torch 可以将 Hugging Face Transformers 模型导出到 LiteRT-LM,支持在 Android、iOS、macOS、Windows、Linux、Web 和物联网设备上运行。
在硬件支持方面,LiteRT 可通过 XNNPack 调用 CPU,通过开源 ML Drift 调用 GPU,并通过统一 API 适配主要芯片平台的 NPU。
谷歌还在 GitHub 上预览发布 TPU agent suite。该工具通过插件接入多种代码编排工具和模型组合,可协助开发者完成 PyTorch 模型在 TPU 上的部署、问题诊断、用户问答和推理性能调优。
结语:谷歌为 TPU 争取更多开发者
谷歌此次开源 TorchTPU,让开发者更容易把已有 PyTorch 模型迁移到 TPU 上,并继续使用熟悉的训练、推理和部署工具,由此可以降低开发者对单一硬件平台的依赖。
目前,英伟达 GPU 仍拥有成熟的软件生态和广泛的开发者基础,TorchTPU 很难在短期内改变这一格局。但如果谷歌能够持续完善 TPU 工具链,并在性能和价格上展现优势,TPU 有望在部分大模型训练和推理场景中获得更多应用。对开发者来说,这意味着多了一种可选的基础设施路线。相关动态和深度学习实践,也可以关注云栈社区的讨论。
来源:谷歌云、TechCrunch
 发表于 1 小时前
|
查看: 9|
回复: 0


