Intel、AMD这对老冤家虽然经常在市场上杀得刺刀见红,但其实更多是相爱相杀。必要的时候两家也会站到一起——毕竟同属 x86 阵营,时不时要面对共同的“敌人”。
早在 2024 年 10 月 16 日,Intel、AMD 就联合宣布共同成立 x86 生态系统顾问小组(x86 Ecosystem Advisory Group),拉上十大行业巨头,一起推动 x86 计算架构的未来。
根据官方介绍,x86 生态系统顾问小组的任务是:
汇集行业领导者,通过更统一的指令集和架构接口,推动开发者创新,提升 x86 产品间的兼容性、可预测性、一致性,推动创建统一、兼容的关键 x86 架构特性和编程模型,横跨数据中心、云、客户端、边缘、嵌入式等全领域。
翻译成大白话就是:共同消除在一些通用 x86 技术上的分歧和碎片化,促进 x86 生态的健康、快速发展。 这个目标听起来抽象,落到开发者身上却很实际——写一次代码,跑在两家 CPU 上都能有好性能,这谁不想要?
顾问小组的预期成果包括:
1、为客户在硬件和软件方面提供更多选择和更强的兼容性,使其更快地受益于全新的尖端功能带来的提升。
2、简化架构指南,以提升 Intel、AMD x86 产品系列在软件一致性和接口方面的表现。
3、使新功能能够更广泛、更高效地集成到操作系统、框架和应用程序中。
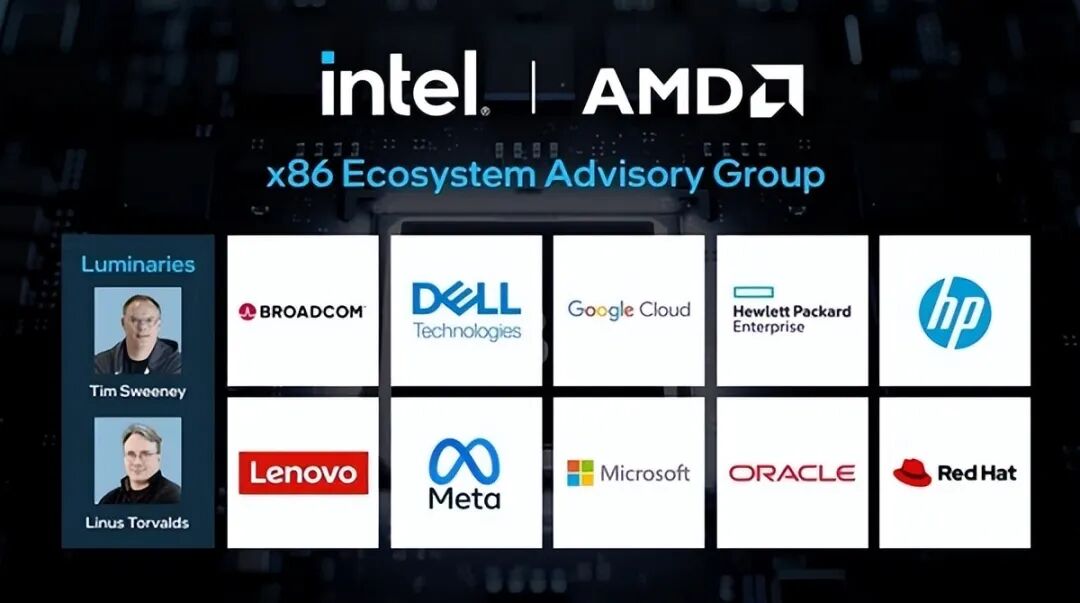
顾问小组的创始成员,个个都是响当当的行业巨头:博通、戴尔、谷歌、慧与(HPE)、惠普、联想、Meta、微软、甲骨文、红帽。
顾问小组还保持开放姿态,积极向 x86 硬件和软件社区征求关于核心功能和特性的技术意见。因此,Linux 系统内核之父 Linus Torvalds、虚幻引擎之父/Epic Games CEO Tim Sweeney 两位技术传奇大牛,都受邀加入。
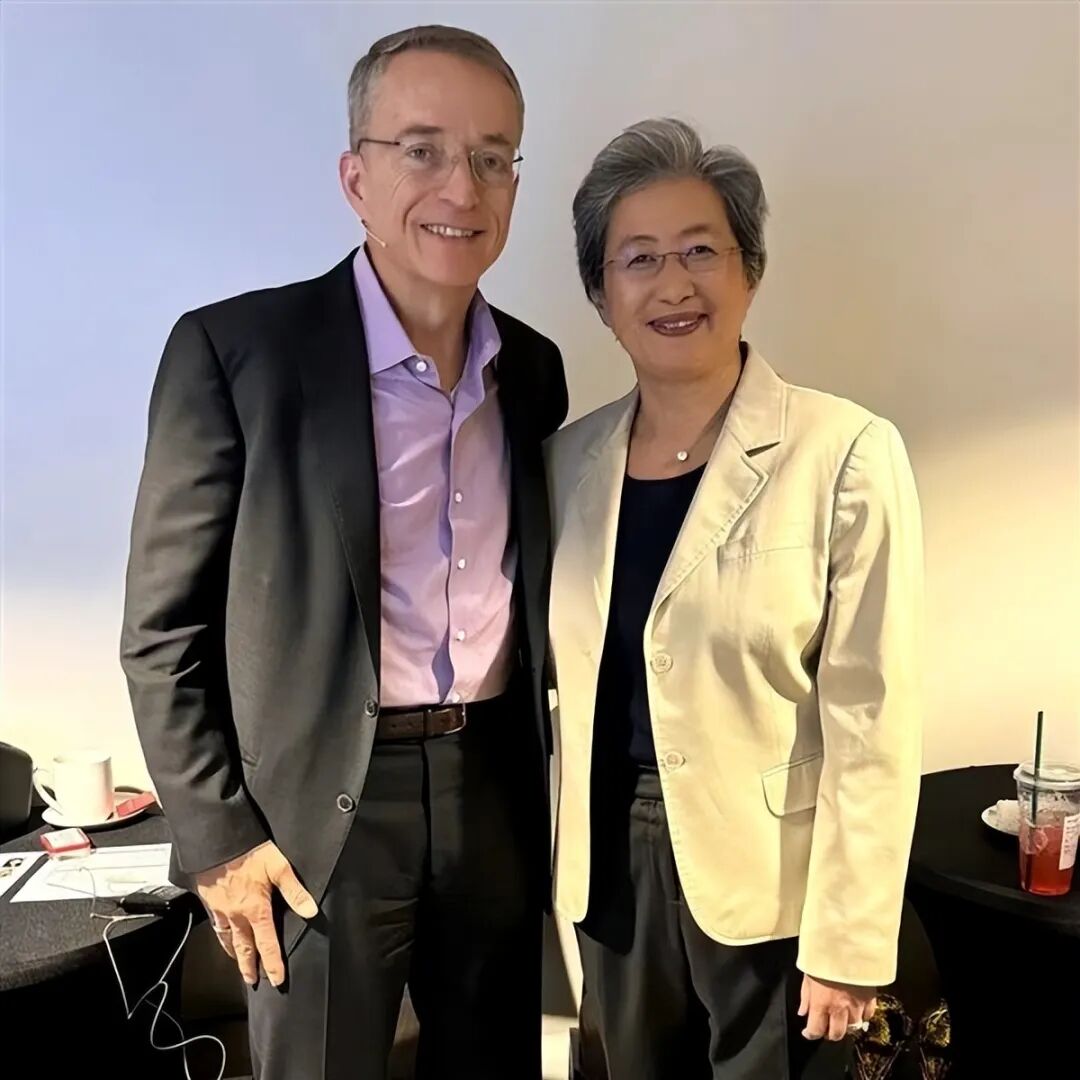
时任 Intel CEO 的帕特·基辛格,还和 AMD 董事长兼 CEO 苏姿丰合影留念。放在几年前,这画面怕是没几个人敢想。
成立两年来,x86 生态系统顾问小组在多个技术领域取得了实质性进展,推动了 x86 架构的标准化和技术创新。
2025 年 10 月,双方“在一起”一周年之际,就公布了一大批关键的技术突破里程碑:
FRED:
全称灵活返回与事件交付机制(Flexible Return and Event Delivery),是 Intel 设计的新一代 x86 底层中断与系统调用架构,属于对 x86 沿用数十年的中断/异常/系统调用切换机制的一次重构。
它统一了传统零散的事件切换路径——中断、异常、系统调用、虚拟化等所有事件共用一套入口和返回逻辑,同时大幅降低了内核切换开销,扩展性也更强,是提升低延迟性能的关键特性之一。从第一代酷睿 Ultra(Meteor Lake)、第四代至强可扩展(Sapphire Rapids)开始支持。
AVX10:
Intel 的新一代融合型矢量指令集,也是 AVX-512 的大一统继任者,彻底解决了 AVX-512 只有 P 大核才能支持的尴尬。
它分为两个档位:AVX10/256 全系标配,可在 256 位宽度下实现完整的 AVX-512 能力;AVX10/512 则仅支持高端 P 核,面向服务器、工作站的重负载场景。未来将在至强处理器上首先落地,然后下放至酷睿处理器。
ChkTag:
Intel、AMD 联合制定的 x86 统一内存安全硬件规范,用于硬件级内存标签防护,专门解决缓冲区溢出、释放后重用、野指针等经典内存安全漏洞。
因为是在硬件层原生支持,它的性能损耗极低,不会像软件校验那样引入明显开销。同时保持向下兼容,开启 ChkTag 的软件也可以在不支持的旧款 CPU 上正常运行,只是不启用安全防护。
ACE:
全称 AI 计算扩展(AI Compute Extensions),在 AVX10 的基础上针对 AI 方向做补充,是 x86 平台原生的 AI 矩阵加速指令集。它支持 AI 领域的主流精度标准,包括 BF16、INT8、OCP FP8、OCP MXFP8、OCP MXINT8 等等。
相比传统的 AVX10 乘加运算,ACE 的矩阵计算密度可提升最多 16 倍,能效更高,主打端侧大模型推理和 AI 工作负载加速,软件适配也在推进中。
到了两周年,x86 生态系统顾问小组又放出了最新成果:
将双方针对 PyTorch 框架的 x86 CPU 优化成果,共同整合到开源深度学习库 oneDNN,并由统一加速基金会(UXL)管理,从而提升 AI 工作负载在 Intel、AMD CPU 上的通用性和运行效率。
PyTorch 是 Meta AI 开发并开源的 Python 原生深度学习框架,核心优势是动态计算图、开发门槛低,支持 NVIDIA CUDA、AMD ROCm、x86/Arm CPU 等多硬件加速,是当前全球学术研究、工业落地最主流的 AI 开发框架之一,覆盖模型训练、推理、部署全流程。
Intel oneDNN 是 x86 生态里最主流的开源 CPU 深度学习加速库,具备跨硬件、跨厂商的特点,向上对接 PyTorch、TensorFlow 等主流框架,向下调度各类 x86 指令集做硬件加速。
AMD ZenDNN 则是基于 Intel oneDNN 二次开发的,专门针对 AMD 锐龙、EPYC 处理器的多核心、大缓存特性做深度调优,主打服务器端和端侧 CPU AI 推理。
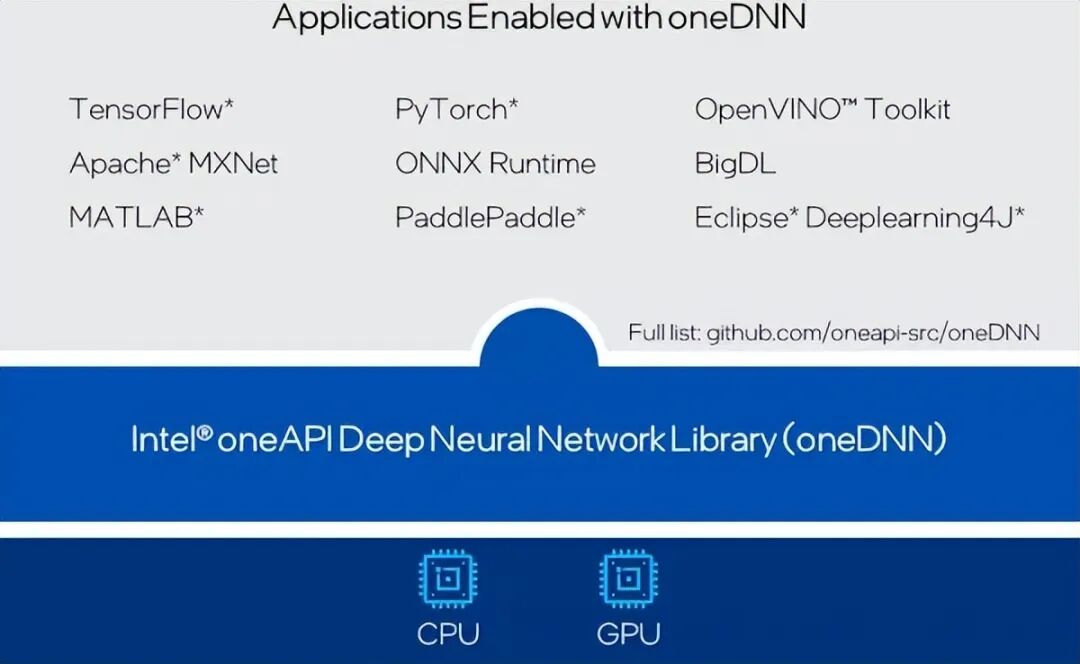
根据 x86 生态系统顾问小组的建议,Intel 和 AMD 已经就 oneDNN 达成一致,将其认定为 PyTorch x86 加速的默认开源库,AMD ZenDNN 的优化则会整合进入 oneDNN。
同时,AMD 以指导委员会成员的身份加入 UXL 基金会,通过开放协作推动这项工作的进一步落地。
对开发者而言,这次合并意味着可以通过一个统一入口,同时获得面向 Intel 和 AMD 处理器的 PyTorch CPU 优化,在不同的 x86 平台上获得一致的开发体验。PyTorch 应用在 x86 CPU 上的开发、维护和部署流程大幅简化,不必再为两套平台分别做优化、两次开发。
此外,Intel 和 AMD 正在 ACE 方面深入合作,未来它将通过 oneDNN 更新,进一步集成至 PyTorch。
顾问小组强调,Intel 和 AMD 围绕 oneDNN 的共同投入,减少了软件碎片化,为现有和未来的 x86 AI 能力提供更完善的支持,树立了新的合作典范。
红帽首席技术官办公室副总裁兼杰出工程师、PyTorch 大使 Stephen Watt 对这次合作评价很高。他说:“无缝、统一的开发和运维体验,是开源创新持续发展的重要基础。AMD 与 Intel 携手,通过 PyTorch 中的 oneDNN,让 x86 CPU 的优化标准化,这是减少生态碎片化的重要一步。作为 PyTorch 社区的一员,红帽很高兴看到这样的开放协作,它将帮助开发者更轻松地在不同 x86 架构上,以一致的方式构建、优化和部署 AI 工作负载。”
 发表于 1 小时前
|
查看: 8|
回复: 0


