导语
过去十年,单颗 GPU 的算力涨了大约 1000 倍,但真正拉开差距的,往往不是硬件本身,而是"怎么给芯片编程"。这篇文章想讲清楚一件并不反直觉的事:一个 AI 芯片的编程方式,其实是从它的硬件设计里"长"出来的,不是软件工程师拍脑袋决定的。 顺着这条线,你也能看懂国产 AI 芯片这些年最大的坎到底在哪。
一、方法论:编程模式从硬件"长"出来
先给整篇文章一张地图。一个芯片的编程方式,可以看作这样一条推导链:
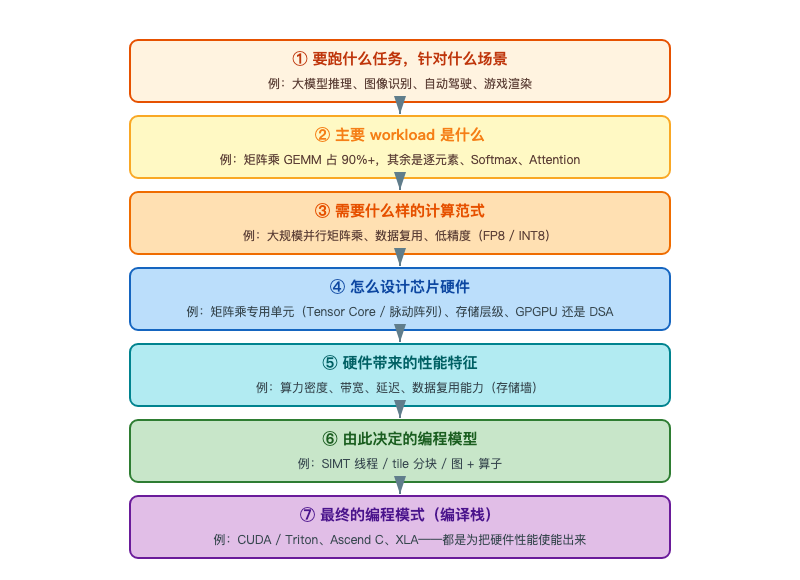
记住这条链,后面所有内容都是它的展开——硬件长什么样,决定了程序员怎么给它写代码。 而这一切背后有一个最高优先级的目标:把芯片的硬件性能发挥出来——从这个角度看,编程模式本质上是为硬件服务的。
二、AI 芯片怎么设计硬件
要理解"编程模式为什么长这样",先得理解"硬件为什么长这样"。这一章讲硬件设计的三个基本问题。
2.1 一个核心:矩阵乘
AI 算法这几十年的演进,算力需求越来越收敛到一个东西——矩阵乘。回头看三个阶段:
阶段一:传统机器学习(2012 年前)。 主流是各种数学 / 统计挖掘算法——决策树、随机森林、SVM、逻辑回归、K-means、XGBoost 等。这些算法计算模式各异,没有统一的「矩阵乘」主导,算力需求不高,普通 CPU 就够跑。
阶段二:深度神经网络(2012 年后)。 2012 年 AlexNet 在图像识别上大获成功,深度学习成为主流。神经网络的核心计算——卷积层、全连接层——本质都是矩阵乘(卷积可通过 im2col 转化成矩阵乘)。算力需求暴涨,GPU 加 CUDA 成为标配。
阶段三:Transformer(2017 年至今)。 2017 年 Google 提出 Transformer(「Attention is All You Need」),此后 GPT、Llama、DeepSeek 等几乎所有大模型都是 Transformer 架构。它的核心算子——QKV 投影、Attention、FFN——几乎全是矩阵乘。
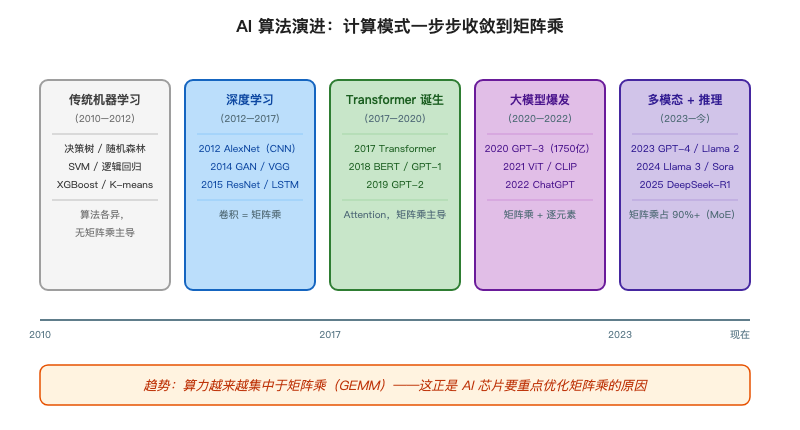
结论很清晰:AI 算法演进几十年,算力越来越集中于矩阵乘(GEMM)。 到 Transformer 时代,矩阵乘占据了算力的绝对大头——这也是为什么设计 AI 芯片,第一件事永远是「矩阵乘单元怎么做」。
以 DeepSeek(Transformer 架构的大模型)为例,看一个 Transformer 层里各算子的算力占比(占比为经验估算,不同配置有差异):
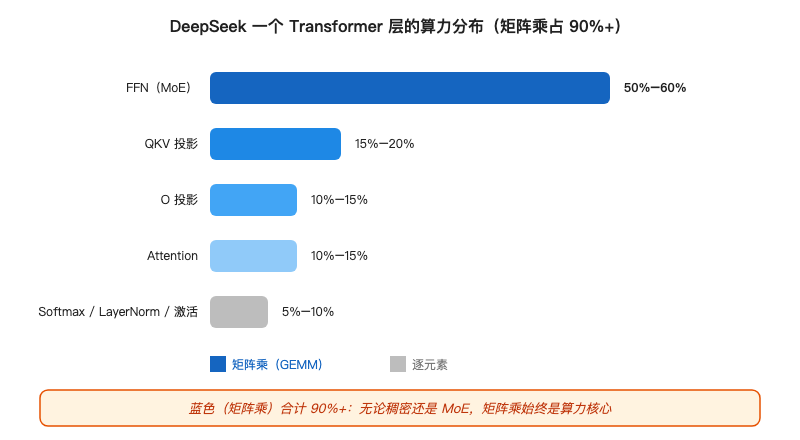
矩阵乘类算子合计占 90% 以上。注意:DeepSeek 是 MoE(混合专家)架构,FFN 部分参数巨大,所以 FFN 的矩阵乘占比尤其高——这恰好说明,无论架构怎么变(稠密还是稀疏、MoE 还是 Dense),矩阵乘始终是算力的绝对核心。
2.2 两种哲学:GPGPU vs DSA
既然矩阵乘是核心,那「矩阵乘单元怎么做」就成了芯片设计的分水岭。行业分成两大流派:
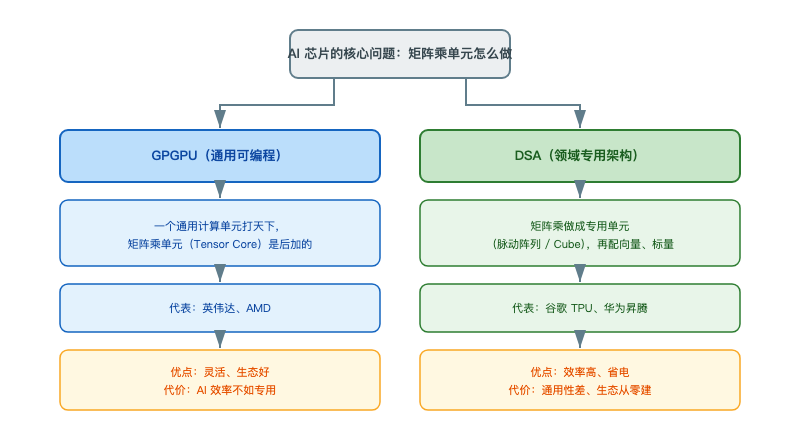
两个术语的出处:GPGPU 和 DSA 这两个词,来自 2018 年图灵奖得主 David Patterson 和 John Hennessy 的著名论述——他们在摩尔定律放缓后提出,「领域专用架构」(DSA) 将成为新的性能来源。历史脉络上,GPGPU 是「从图形计算顺带发展出通用计算」的产物(英伟达的根是游戏显卡),而 DSA 是「专门为某个领域从零设计」的新思路(谷歌 TPU 就是为自家 AI 需求专门做的)。
2.3 一条存储铁律:数据复用决定一切
无论哪种哲学,都逃不开一条铁律:越靠近计算的存储越快、越小、越贵(寄存器 → 片上 SRAM → L2 → 内存/显存)。因为矩阵乘的数据会被反复使用,能不能让数据"尽量留在片上复用、少去慢速内存里读",直接决定了算力能不能跑满——这就是后面反复出现的"tile 分块"和"存储墙"的由来。
而数据复用之所以如此关键,根源在于数据搬运本身极其昂贵,它有三个成本:
- 一是耗时——从慢速内存读一次数据要几十到几百个时钟周期,算力只能干等;
- 二是耗能——业界公认的量级对比是,从 DRAM 搬一个字节数据消耗的能量,是片上做一次乘加运算的成百上千倍,搬数据的能耗远大于算的能耗;
- 三是带宽有限——内存带宽是硬瓶颈,搬得越多越容易成为性能天花板。
所以 AI 芯片性能优化的第一原则,是尽量把数据留在片上复用、少搬运——这比优化计算本身更重要,也是「tile 分块」和「存储墙」问题的真正来源。
三、三家芯片怎么落地:硬件决定编程模式
有了第二章的原则,再看三家代表芯片——它们的硬件选了哪种哲学,编程模式就长成什么样。
3.1 英伟达:GPGPU 路线,一套线程吃所有计算
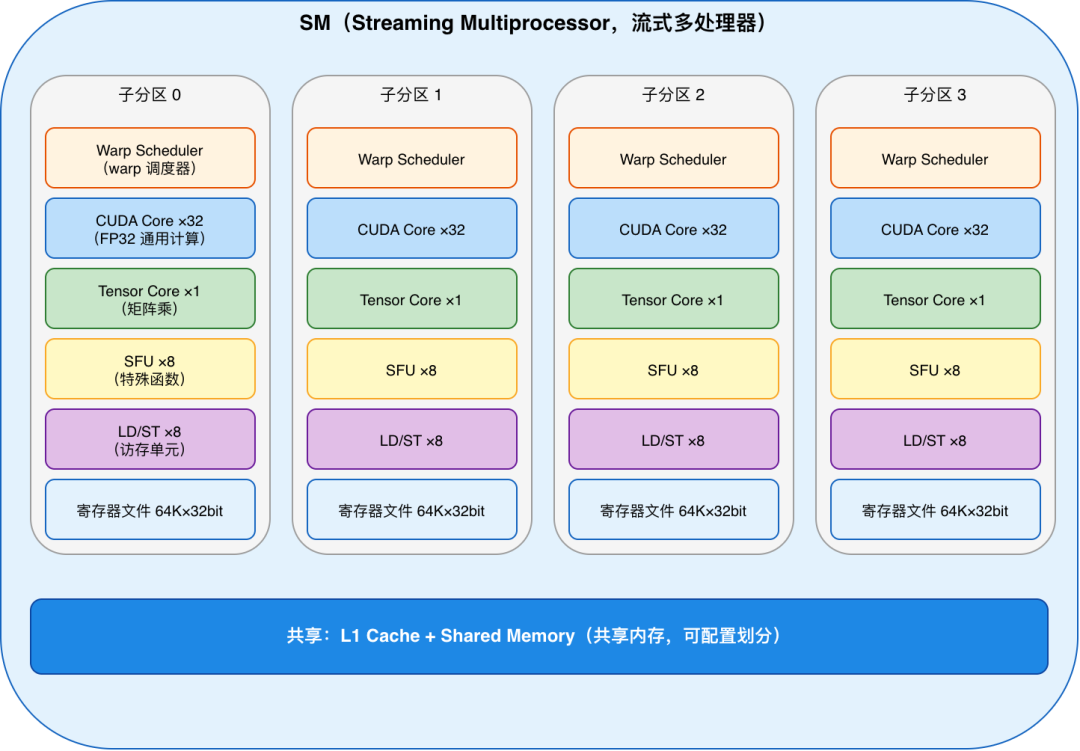
硬件: GPU 由几十上百个 SM(流式多处理器) 组成,一个 SM 里同时住着 CUDA Core(通用计算) 和 Tensor Core(矩阵乘专用)——典型的 GPGPU:通用单元打天下,矩阵乘单元是后加的。
AI 芯片要干的活,本质上分三类:标量计算(一个数一个数算,如地址偏移、循环计数)、向量计算(一组数并行算,如逐元素加、激活函数)、矩阵计算(矩阵乘,算力大头,占 90%+)。
硬件上,标量 / 向量走 CUDA Core(通用单元),矩阵走 Tensor Core(专用单元)。但编程模型上,英伟达把它们统一成了一种写法——线程。看两个伪代码:
//向量 / 标量计算:走 CUDA Core
__global__ void vec_add(float* A, float* B, float* C) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;  // 每个线程一个索引
    C[i] = A[i] + B[i];   // 逐元素:线程各算一个元素,走 CUDA Core
}
//矩阵计算:走 Tensor Core
__global__ void matmul(half* A, half* B, float* C) {
    wmma::mma_sync(c_frag, a_frag, b_frag, c_frag); // 一条 MMA 指令,warp 协作算 16×16 tile
}
关键对比:两个都是 __global__ kernel、都用线程号定位数据,写法范式完全一样,区别只是「逐元素算」还是「调一条 MMA 指令」。标量、向量、矩阵,统统变成「线程 + 同一段代码」。
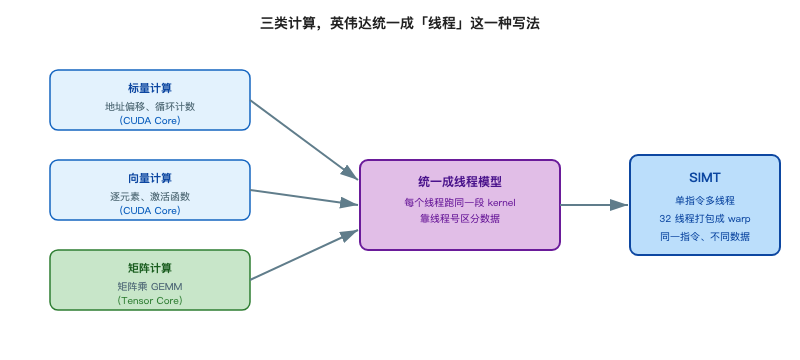
这就是 SIMT(Single Instruction, Multiple Threads,单指令多线程):把任务拆成海量线程,所有线程跑同一段代码,靠线程号区分数据;硬件把 32 个线程打包成一个 warp,同一时刻执行同一条指令。英伟达的「统一」哲学就在这——一套线程抽象,吃下标量、向量、矩阵所有计算。
高性能的秘密:tile 分块。 先看硬件的一个事实——存储分层,越靠近计算越快、越小:寄存器(KB 级、最快)→ 片上 SRAM(MB 级)→ 片外 HBM(GB 级、最慢)。矩阵乘有两个特性,让 tile 分块成了必需:
-
容量放不下: 大矩阵(如 4096×4096)数据量动辄几百 MB,远超片上 SRAM 的容量,不切成小块根本放不进片上,只能分批搬。这正好回应「不分块是不是算不了」——对,大矩阵不分块,片上根本装不下。
-
复用不够就慢: 矩阵乘每个数据会被反复用很多次(A 的一个元素被 B 的 N 列复用)。不 tile 时,每个线程直接从片外 HBM 读数据,复用靠缓存兜底,缓存一满就失效,数据反复从慢速 HBM 读——算力大部分时间在等数据。
tile 分块同时解决这两个问题:把大矩阵切成小块,分批搬进片上 SRAM,在片上反复复用、算完再搬下一块——既「放得下」,又把数据复用从慢速 HBM 搬到了快速 SRAM。
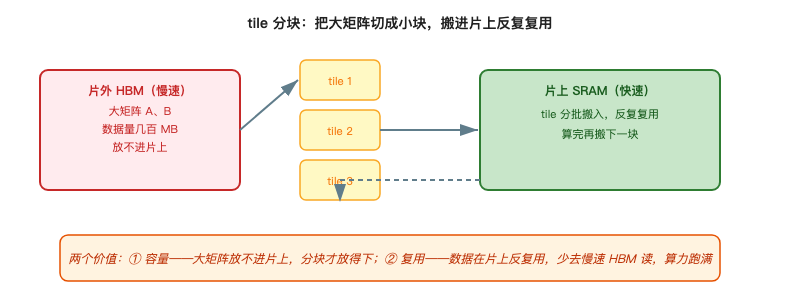
算一笔账:旗舰 GPU 算力 989 TFLOPS、内存带宽 3.35 TB/s。要让算力跑满,每搬 1 字节数据得换来约 295 次计算;不分块时每字节只能换来约 1 次——等于 99.7% 的算力在空等数据。tile 分块后,这个数字提到上百,算力才真正用满。
tile 编程的抽象工具(CUTLASS、Triton、cuTile、Tile IR 等),英伟达在上面做了层层演进,让「写高性能 tile 算子」越来越容易,还能换来跨代兼容——这部分详见第四章「英伟达的标杆」。
3.2 谷歌 TPU:DSA 路线,把编程交给编译器
硬件: 核心是 MXU(脉动阵列)——一颗专门做矩阵乘的 ASIC,不是通用计算单元。这是 DSA 路线的极端代表。
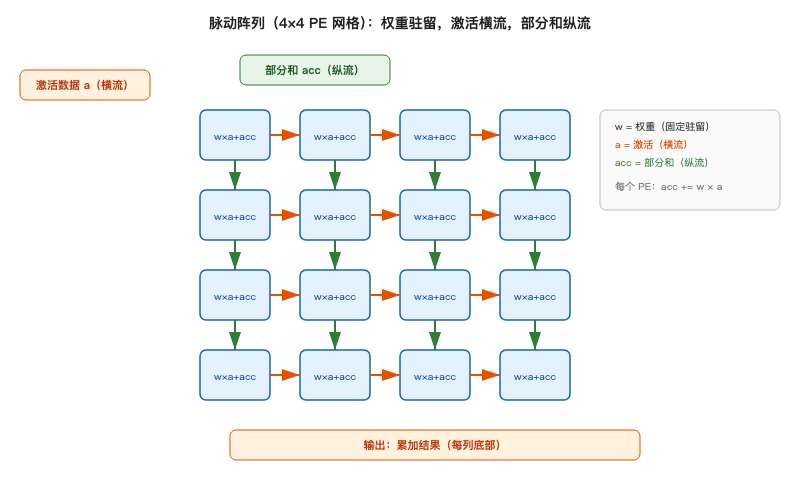
脉动阵列的原理:权重固定在网格里,数据像波一样斜着流过,每个单元做一次乘加,"权重常驻、数据流动",极其省电。但它有个天生短板:做不了向量、标量运算(没有独立的向量寄存器、标量 ALU)。
编程模型:不暴露线程,暴露算子。 矩阵乘就是一个基本算子,程序员写高层图,编译器把图编译成算子、自动调度。因为脉动阵列只能做矩阵乘,TPU 必须额外配向量、标量单元,由编译器精确调度几个异构单元怎么配合——于是编程这件事,从"程序员控制线程"变成了"编译器调度算子"。
这个「不暴露线程、只调算子」的编程模型,为什么能这么简单?因为 TPU 本质上只能做矩阵乘——它没有线程、没有 tile、没有寄存器这些需要程序员操心配置的东西。你写一个矩阵乘,XLA 编译器自动调度到 MXU;你写一个向量加,编译器自动调度到向量单元。程序员完全不碰硬件细节——这就是「专用硬件」带来的「编程极简」。
但这也带出一个问题:脉动阵列只能做矩阵乘,那标量、向量计算怎么办?TPU 靠「一代代补」来解决:
-
TPU v1(2015): 只有 MXU,纯矩阵乘。激活函数(ReLU / Sigmoid / 池化)靠「激活单元」——这也是硬化好的专用硬件,不是可编程单元;其他杂活(归一化、数据整理)靠 host CPU 兜底。所以 v1 是「极纯」的:矩阵乘 + 几个写死的激活,剩下全丢给 host。
-
TPU v2(2017)起: 补上 VPU(向量处理单元)+ 标量单元,变成「MXU + VPU + Scalar」三件套。为什么补?因为 v1 跑下来发现,大量算子不是矩阵乘(softmax、layer norm、embedding、各种 element-wise),光靠 host 兜底太慢,必须在片上配可编程的向量 / 标量单元。
-
v3 之后: 持续演进——加稀疏核心(SparseCore)处理稀疏矩阵、内存从 8GB DRAM 一路扩到 192GB HBM、互联从 PCIe 换成 OCS 光互连。
所以 TPU 的完整形态,最终也是「矩阵 + 向量 + 标量」三件套——这和后面华为昇腾的「Cube + Vector + Scalar」是同一个思路:专用硬件每个单元只做一类事,那就把每一类都单独做一块硬件。
3.3 华为昇腾:DSA 的完整版,异构三核
硬件: 华为昇腾(Ascend)的达芬奇架构,是 DSA 路线里做得最完整的一家,把芯片拆成三个各司其职的单元:
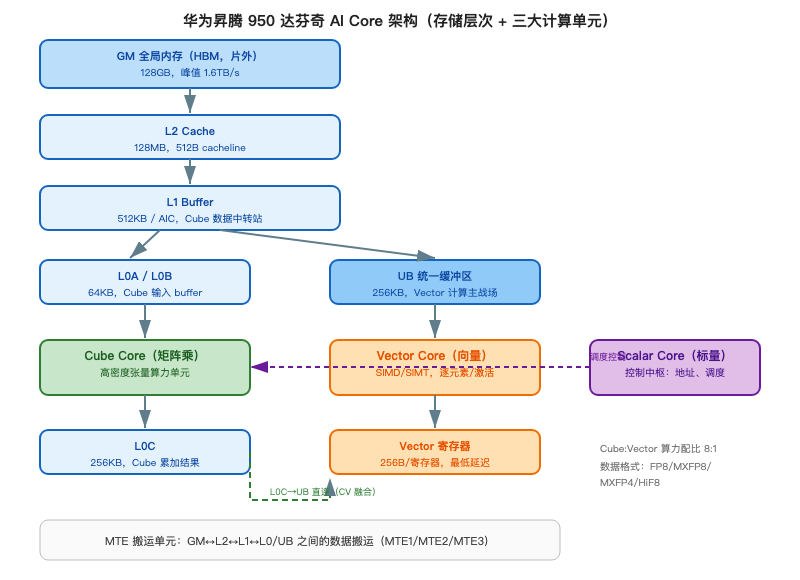
这是谷歌 TPU 那条专用路线的「完整版」——它还用显式 buffer(L0/UB)让编译器精确控制数据搬运。
编程模型层层演进:Ascend C(SIMD 算子语言)→ PTO(tile 虚拟 ISA,跨代兼容)→ PyPTO(Python 绑定)→ CANNBot(AI 写算子)。 这条链的巧思是:用"tile ISA + AI 辅助",同时解决了"专用硬件开发门槛高"和"跨代兼容"两个难题。
光念语言名字没意义,关键是 Ascend C 的编程本质——它是「显式异构编程」:程序员要明确知道「这段代码走 Cube、这段走 Vector、这段走 Scalar、数据怎么搬」。看一个「矩阵乘 + 激活」的简化算子:
#include <kernel_operator.h>

__aicore__ void MatMulAdd(GM_ADDR A, GM_ADDR B, GM_ADDR C) {
    GlobalTensor<half>  A_gm, B_gm, C_gm;   // 片外全局内存 GM
    LocalTensor<half>   A_ub, B_ub;          // 片上 UB
    LocalTensor<half>   A_l0, B_l0;          // Cube 输入 L0A/L0B
    LocalTensor<float>  C_l0, C_ub;          // Cube 输出 L0C / UB

    DataCopy(A_ub, A_gm, tile_size);          // ① 搬运:GM→UB,走 MTE 引擎
    DataCopy(B_ub, B_gm, tile_size);
    Load2d(A_l0, A_ub);                       // ② 搬运:UB→L0A,喂给 Cube
    Load2d(B_l0, B_ub);
    MMAD(C_l0, A_l0, B_l0, M, N, K);          // ③ 矩阵:一条 MMAD,走 Cube 单元
    Relu(C_ub, C_l0, element_num);            // ④ 向量:逐元素激活,走 Vector 单元
    DataCopy(C_gm, C_ub, tile_size);          // ⑤ 搬运:UB→GM,写回
}
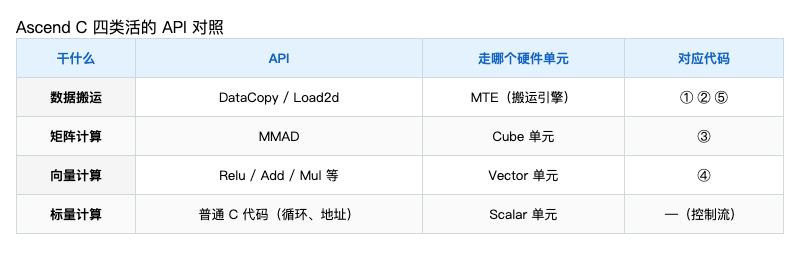
对照这个代码,四类「活」各有各的 API,程序员是显式地分别调它们:
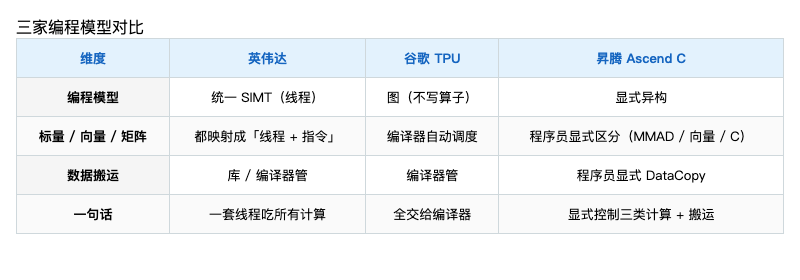
和三家的编程模型放一起看,差异就清楚了:
最后解释一个现实限制:昇腾的毕昇编译器(CCE Compiler)后端没有开源——前端(Ascend C → IR)开源了,但从 IR 到 NPU 微指令这一层是闭源的。所以更底层的硬件细节(微指令、调度)外界看不到,只能通过 Ascend C 的这套编程范式(DataCopy / MMAD / 向量指令) 来反推硬件是怎么工作的。这也是为什么聊昇腾,讲到底都绕不开 Ascend C。
昇腾这套编程模式,不是一步到位,而是「踩坑改」出来的。它的演进主线是:不断降低算子开发门槛,同时保留性能上限。 回头看几个关键阶段,每一步都对应一个明确的痛点:
-
CANN 1.0(2018,接近汇编级): 开发者要直接接触底层指令,门槛极高——生态几乎起不来。痛点:门槛太高。
-
TIK(Python 动态编程框架): 用 Python 写算子,但还是要手工控制数据搬运、缓冲、流水线。灵活、性能好,可门槛还是高,得是专家。痛点:仍需专家手工调。
-
TBE(2020): 基于 TVM,做「高层 DSL + 底层 TIK」双模式——普通开发者用高层 DSL,专家用底层 TIK 抠性能。解决:分层,两类人各取所需。
-
Ascend C(原生 C/C++ 算子语言): SIMD + SIMT 双模型,编译器自动插入同步(PipeBarrier)做隐式调度。解决:统一成主流 C/C++ 写法,再降门槛。
-
PTO 虚拟 ISA + PyPTO(2025): tile 级虚拟 ISA(90+ 条),把 910→950 的硬件差异屏蔽掉,实现跨代兼容。解决:硬件换代,算子不重写。
-
CANNBot(AI 写算子,最新): 用 AI 智能体自动写算子,把「写代码」变成「描述意图」。解决:最后一道开发效率的门槛。
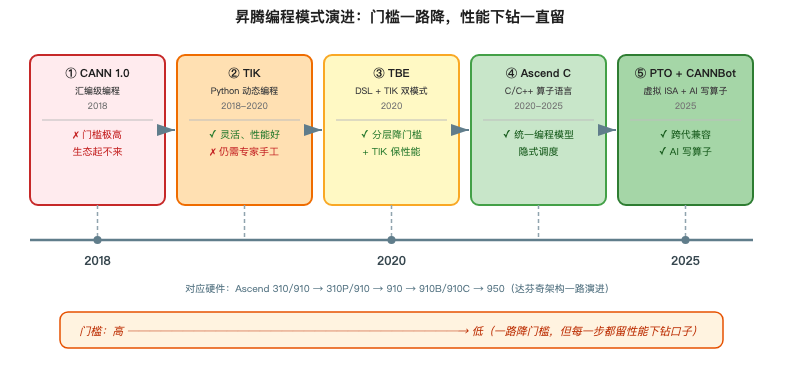
一句话总结这条演进:门槛一路降(汇编 → Python → DSL → C/C++ → AI),但每一步都留了「性能下钻」的口子(TIK、PyPTO 的显式调度)——因为专用硬件的性能上限,必须有人能抠到。
顺带说一句华为在这件事上的实力:昇腾这套编译栈,从 2018 年的「接近汇编级」一路改到 2025 年的「AI 写算子」,几乎每一代都把上一代的编程模型推倒重来——CANN 1.0 的汇编、TIK 的 Python、TBE 的双模式、Ascend C 的 C/C++、再到 PTO 和 CANNBot。这种「发现问题、果断换道、再发现问题、再换道」的迭代节奏,背后是真正的「大象跳舞」:昇腾的业务盘子已经很大(几十万开发者、庞大硬件矩阵、海量算子),却能在每一代都把软件栈整体换掉、还保证存量业务平滑迁移。国产 AI 芯片里,昇腾是少数真正把「硬件 + 软件栈」两边都啃下来的玩家,这本身就值得敬佩。
四、编译栈:硬件之上的软件生态
前面几章都在讲「编程模式怎么把硬件性能发挥出来」,但这里要补一个同样重要的维度——用户易用性,也就是生态。 芯片做得再好,如果开发者不愿意来写代码、迁移成本高,性能也兑现不了。这,就是「生态」的分量。
而在这个赛道上,英伟达是事实标准——CUDA 生态统治了十几年,几乎所有框架、库、教程都默认英伟达。所以后来者只有两条路可走:
-
兼容英伟达: 源码级兼容 CUDA,让开发者几乎不用改代码就能迁移。代表是摩尔线程(MUSA)、沐曦(MXMACA)、壁仞(BIRENSUPA)、海光(DCU / ROCm)、天数智芯等——好处是迁移成本低、生态冷启动快;代价是受制于 CUDA 的 thread 级语义,难针对自家硬件深度优化。
-
自立门户: 从零自研 DSL + 编译栈,和 CUDA 彻底解耦。代表是华为(Ascend C / CANN)、寒武纪(BangC)、燧原(驭算)——好处是性能可控、自主可控;代价是生态从零起步、迁移成本高。
后面 4.1 讲「英伟达这个标杆自己怎么做」,4.2 讲「其他家在这两条路上怎么选」。
4.1 英伟达的标杆:层层抽象
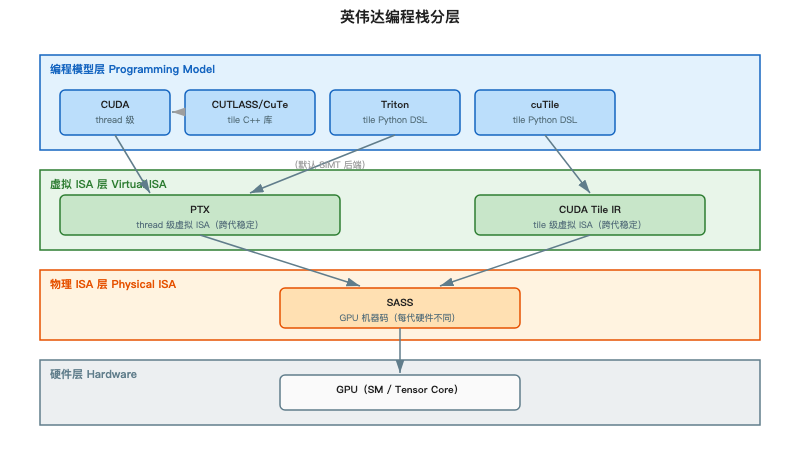
英伟达能一统江湖,靠的是一套层次分明的编程栈:
-
CUDA → PTX → SASS: 程序员写 CUDA(thread 级),编译器先翻成 PTX(虚拟 ISA,跨代稳定),再汇编成 SASS(真实机器码,每代硬件都不同)。
-
tile 靠库抽象: 高性能矩阵乘由 CUTLASS 这类库用 tile 抽象表达,编译期再"打散"成 thread 级;近年还推出了 cuTile + Tile IR,把 tile 抽象也做成了正式的一层。
-
Triton 是第三方生态: OpenAI 的 tile 级 DSL,让普通开发者用 Python 写高性能算子,进一步降低了门槛。
这套分层的意义在于:开发者有多个入口(CUDA / Triton / cuTile),但底层殊途同归到同一套硬件——这就是生态的护城河:不管你怎么写,都能跑到英伟达的芯片上,且性能可控。
4.2 其他家怎么选:全栈自研 vs 兼容 CUDA
英伟达这个标杆立在那里,其他 AI 芯片公司建编译栈,逃不开一个二选一:
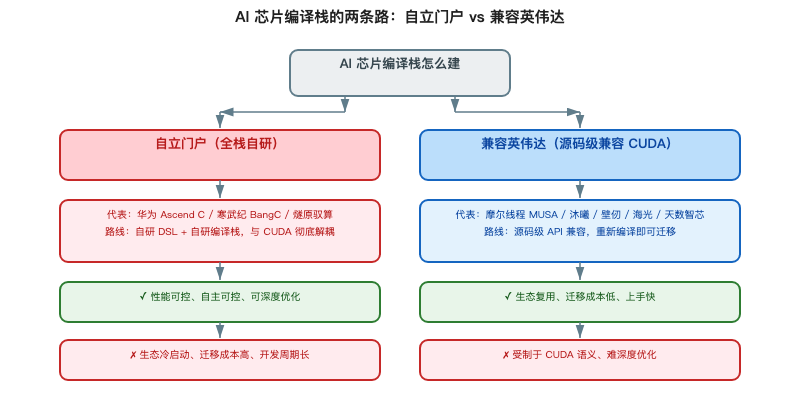
两条路线的差别,最直观地体现在代码层面。看同一个「向量加法」:
全栈自研(华为 Ascend C)——必须用全新 DSL 重写:
#include <kernel_operator.h>

__aicore__ void VecAdd(GM_ADDR x, GM_ADDR y, GM_ADDR z, uint32_t n) {
    GlobalTensor<float> xGm, yGm, zGm;   // 全局内存 tensor
    LocalTensor<float>  xLt, yLt, zLt;    // 片上 buffer tensor
    DataCopy(xLt, xGm, n);               // 全局内存 → 片上,显式搬
    DataCopy(yLt, yGm, n);
    Add(zLt, xLt, yLt, n);               // 自研向量指令,CUDA 里没有
    DataCopy(zGm, zLt, n);               // 片上 → 全局内存
}
兼容 CUDA(摩尔线程 MUSA 等)——几乎就是标准 CUDA,换头文件即可:
#include <mxcuda_runtime.h>  // 原来是 <cuda_runtime.h>

__global__ void vecAdd(float *a, float *b, float *c, int n) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;  // thread 语义与 CUDA 完全一致
    if (i < n) c[i] = a[i] + b[i];
}
// 调用侧:cudaMalloc → mxMalloc,<<<grid, block>>> 语法原样保留
对比一目了然:全栈自研能拿到性能上限和自主权,但开发者要学全新 DSL、重写代码;兼容 CUDA 迁移成本低、上手快,但受制于 CUDA 的 thread 级语义,是性能天花板。 这里要澄清一个常见误解——兼容 CUDA 不是"二进制兼容"(编译好的 .so 无法直接跑,因为绑死了英伟达的硬件指令),而是"源码级 API 兼容"(代码基本不用改,用厂商工具链重新编译一次)。
五、结论:编译栈设计是「性能 vs 生态」的走钢丝
前面四章其实是一条线:硬件决定编程模式,编程模式的最高优先级是「把硬件性能挖掘出来」(第一章就定了这个目标)。但第四章又引入了一个新维度——易用性、生态。这两个目标,恰恰是有张力的。
想要极致性能,就得显式控制硬件——像华为 Ascend C 那样显式调 DataCopy / MMAD / 向量指令,像 CUTLASS 那样手写 tile 分块——但门槛高、生态差;想要易用,就得抽象——像英伟达统一 SIMT、谷歌 TPU 图编译——但可能损失性能上限、或牺牲显式控制。这正是编译栈设计最难的地方:一边是「把自家硬件性能适配、挖掘出来」,另一边是「易用性、用户友好性、生态」,两头都要顾,世界上的每一家 AI 芯片公司,都在这个张力里反复权衡。
三家厂商,就是在这个钢丝上各自找平衡点:
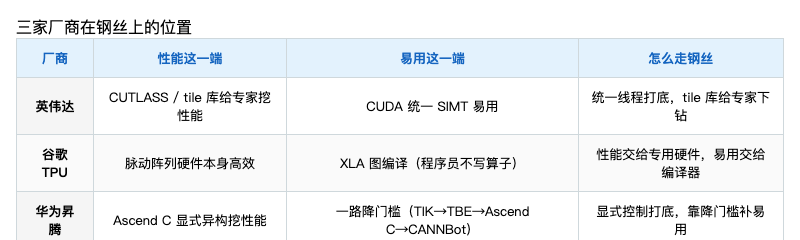
所以编译栈设计的本质,是走钢丝——太偏性能,生态冷启动;太偏易用,性能上限丢。每家都在钢丝上找自己的位置,没有标准答案:英伟达用「统一线程 + tile 库」两头兼顾,谷歌用「专用硬件 + 图编译」把易用做到极致,华为用「显式异构 + 一路降门槛」在性能前提下补易用。
如果只看「性能」这一端,还是能提炼出几个共性要素:
- Tile 抽象: 把计算和数据按块组织,匹配片上存储的容量与层级。
- 显式数据搬运: 块在内存↔片上之间的搬运是显式的,配合异步隐藏延迟。
- 矩阵乘原语: 暴露一个「矩阵乘指令」抽象,匹配专用矩阵乘单元。
- 调度抽象二选一: 硬件是「GPGPU」就用 SIMT 线程;硬件是「DSA」就用图 + 编译器调度。
一句话总结:编译栈设计 = 在「性能挖掘」和「易用性 / 生态」之间走钢丝。 性能最优的编程模式(tile + 显式搬运 + 矩阵乘原语)只是钢丝「性能」那一端;而最终能不能被开发者用起来,取决于「易用」那一端找没找到平衡。看懂了这个,你就理解了 AI 芯片最核心的分歧——而这一切,都是从底层硬件一步步「长」出来的。想继续深入探讨的朋友,也欢迎来 云栈社区 与更多开发者交流。
 发表于 2 小时前
|
查看: 12|
回复: 0


