今年 2 月,三星宣布量产 HBM4。HBM4 将接口宽度从 1024 位提升至 2048 位,带宽提升幅度相当可观,但这也让底部的接口逻辑、供电和信号管理变得更加复杂。此外,三星已经开始采用 4nm 逻辑制程制造 HBM4 基底芯片,原本位于 GPU 内部的部分内存控制功能,现在可以转移到这颗芯片上。
一颗原本负责连接和管理存储单元的基底芯片,正在承担越来越多的系统级功能。这不仅改变了 HBM 自身的设计方式,也让 GPU 与内存之间的架构分工出现新的可能。
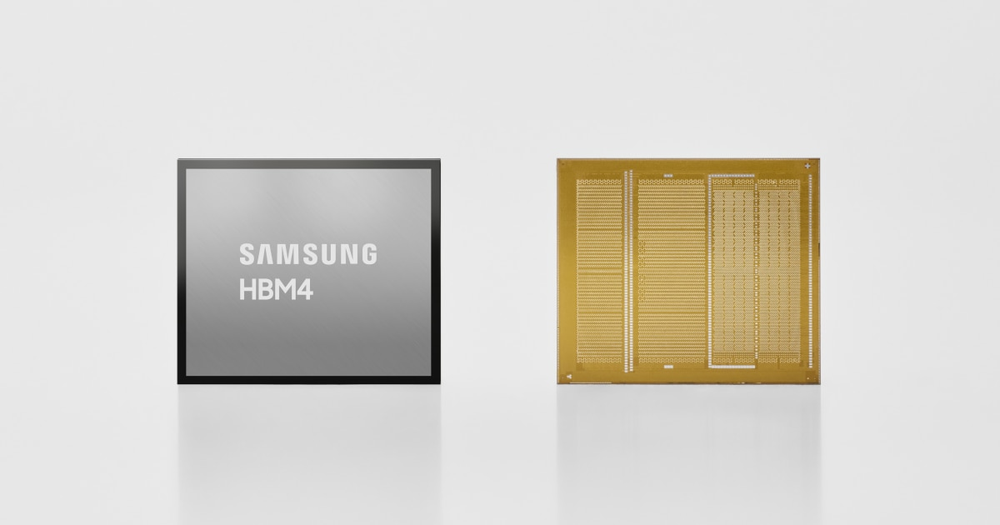
三星 HBM4 官方产品图(正面与背面),来源:三星新闻稿(2026 年 2 月)
一、HBM4的带宽翻倍,压力落到了基底芯片
传统 HBM 通过 TSV(硅通孔)将多层 DRAM 垂直连接,再利用硅中介层与 GPU 并排集成。相比普通 DDR,HBM 依靠大量并行信号通道,在较低工作频率下实现高带宽。
HBM4 把这条路线进一步推向极限。
按照三星公布的产品规格,HBM4 的接口宽度由 HBM3E 的1024位扩大到2048位,量产产品传输速率达到 11.7Gbps,并具备最高 13Gbps 的能力。单堆栈峰值带宽可达3.3TB/s,约为上一代产品的2.7倍。
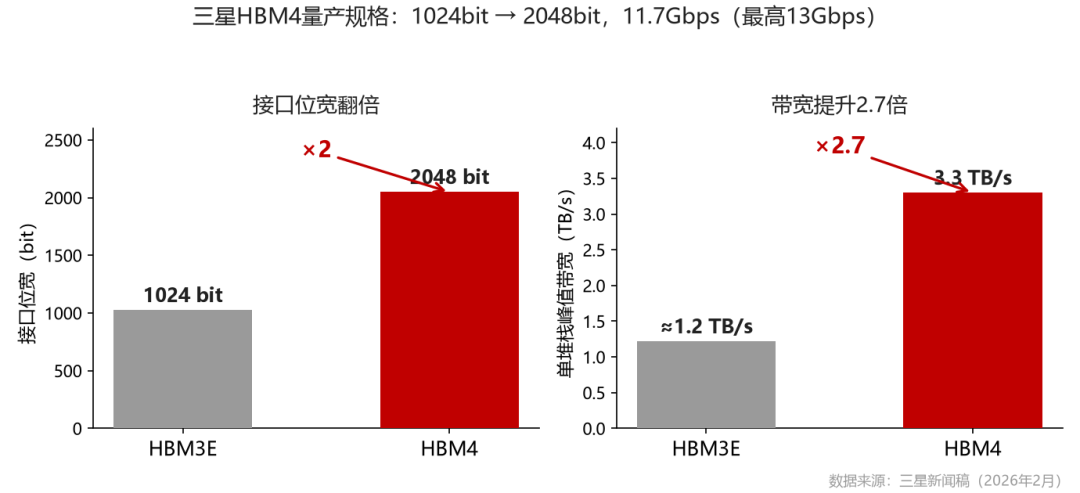
HBM3E 与 HBM4 接口位宽与单堆栈带宽对比。数据来源:三星新闻稿(2026 年 2 月),本文绘制
带宽提升的代价,是更复杂的信号传输、供电与时序管理。HBM 底部的 Base Die 负责连接上方 DRAM 核心与外部处理器,承担接口、控制辅助、测试等功能。随着接口规模扩大,它所面对的设计约束也在迅速增加。
这正是先进逻辑制程进入 HBM 的背景。
二、为什么一颗存储芯片需要4nm?
HBM 堆栈中有两种性质不同的芯片:上方的 Core Die 负责存储数据,底部的 Base Die 负责连接与管理。
DRAM 制造工艺围绕存储单元密度优化,逻辑工艺则更适合实现复杂控制电路、高速接口和精细的功耗管理。因此,HBM4 的基底芯片采用先进逻辑制程,并不意味着整颗 HBM 都使用 4nm 制造。
三星 HBM4 采用第六代 10nm 级 DRAM 工艺(1c)制造存储核心,同时以4nm 逻辑工艺制造基底芯片。这种分工让存储密度与逻辑性能能够分别优化。
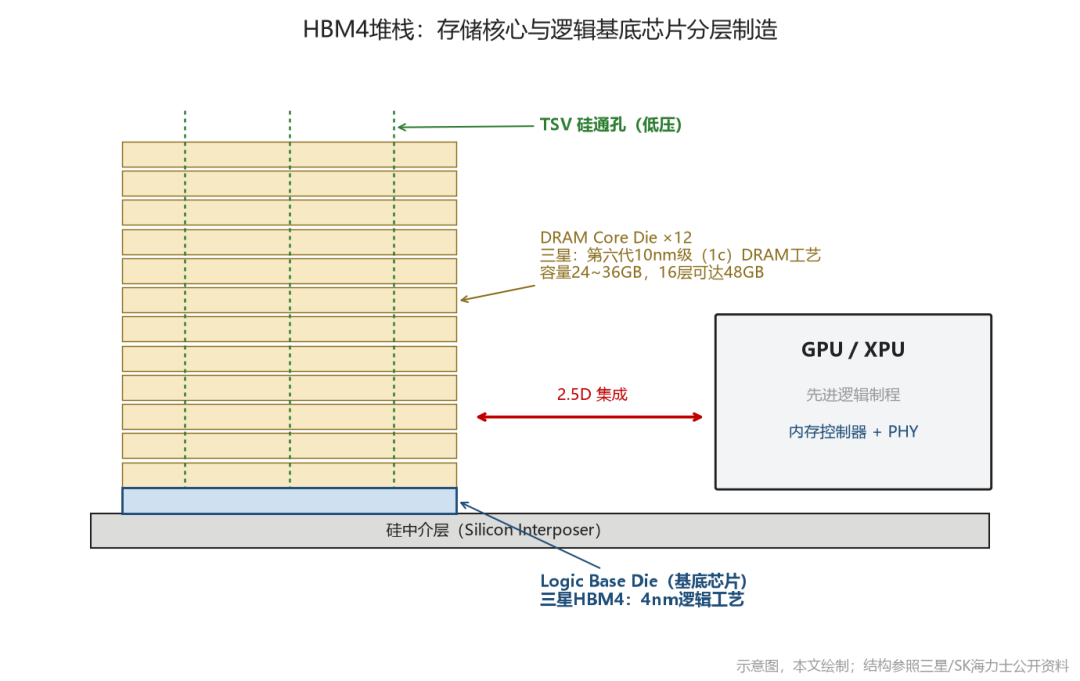
HBM 堆叠结构示意(DRAM Core Die、Logic Base Die、TSV 与 GPU 的连接关系)。本文绘制,结构参照三星/SK 海力士公开资料
三星还披露,通过低电压 TSV、供电网络优化以及存储核心中的低功耗设计,HBM4 相对 HBM3E 实现了40%的能效改善。这里的收益来自多项设计改进,不能简单归因于 4nm 制程本身。
更重要的是,先进逻辑制程让基底芯片有条件承载更多功能。
例如,过去位于 GPU 内部的部分内存控制与接口逻辑,未来可以考虑转移到 HBM 基底芯片中。这将直接影响 GPU 的芯片面积、功耗和封装互连方式。
三、内存控制器搬家,GPU能得到什么?
在标准 HBM 架构中,GPU 内部需要配置内存控制器及对应的 PHY(物理接口)电路,用于管理内存访问和驱动芯片间的高速信号。
这些电路占据宝贵的先进制程芯片面积。随着 HBM 堆栈数量和接口宽度增加,GPU 边缘可用于布置信号连接的空间也越来越紧张。
定制 HBM 提出了一种新的分工方式:把部分内存控制功能移入 HBM 基底芯片,同时重新设计 GPU 与 HBM 之间的接口。
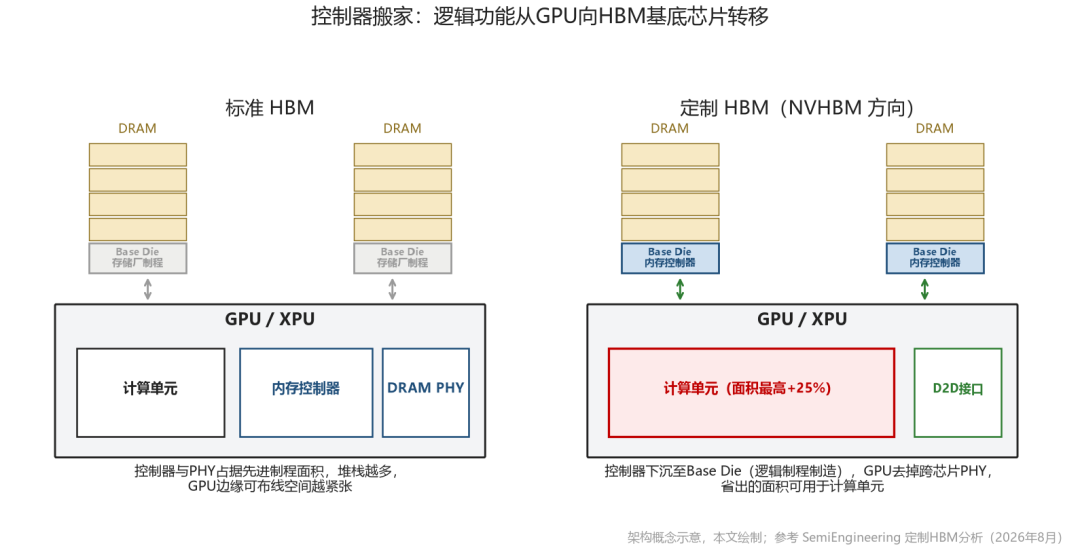
标准 HBM 与定制 HBM 架构概念对比(示意)。本文绘制,参考 SemiEngineering 定制 HBM 技术分析(2026 年 8 月)
控制器迁移能够减少 GPU 侧的接口电路与连接资源需求,并为计算逻辑释放面积。相关方案提出,GPU 计算芯片可获得最高约 25% 的额外面积空间,但具体收益取决于接口和芯片设计。
对于面积昂贵的先进制程 GPU 而言,这些空间可以用于增加计算单元、缓存,或者改善布线与供电设计。更少的外部信号驱动,也有机会降低数据传输功耗。
这项变化的核心价值,是重新分配计算芯片与存储芯片之间的逻辑功能,让有限的先进制程面积更多用于计算。
四、NVHBM让基底芯片进入GPU架构设计
2026 年 8 月,NVIDIA 提出 NVHBM 定制内存方向,让这种架构调整的产业价值变得更加清晰。
根据 10 月 9 日 TrendForce 整理的产业报道,NVIDIA 提出的 NVHBM 方案,相比标准 HBM4E,目标是实现最高30%的带宽提升、15%的 HBM 功耗降低,并为 XPU 计算芯片释放最多25%的面积。
这些是针对特定定制架构提出的指标,不能直接套用到所有 HBM4 产品。NVHBM 的变化也影响了产业分工。
以往存储厂商主要负责 DRAM 及基底芯片设计制造。进入定制 HBM 阶段,GPU 或 ASIC 设计方可能参与基底芯片架构定义,晶圆代工厂负责先进逻辑制造,存储厂商则提供 DRAM 核心、TSV 接口与堆叠集成能力。
SK 海力士已经确认与台积电合作,将先进逻辑制程应用于 HBM4 基底芯片。三星也在研究根据客户需求采用不同晶圆代工资源的定制 HBM 路线。
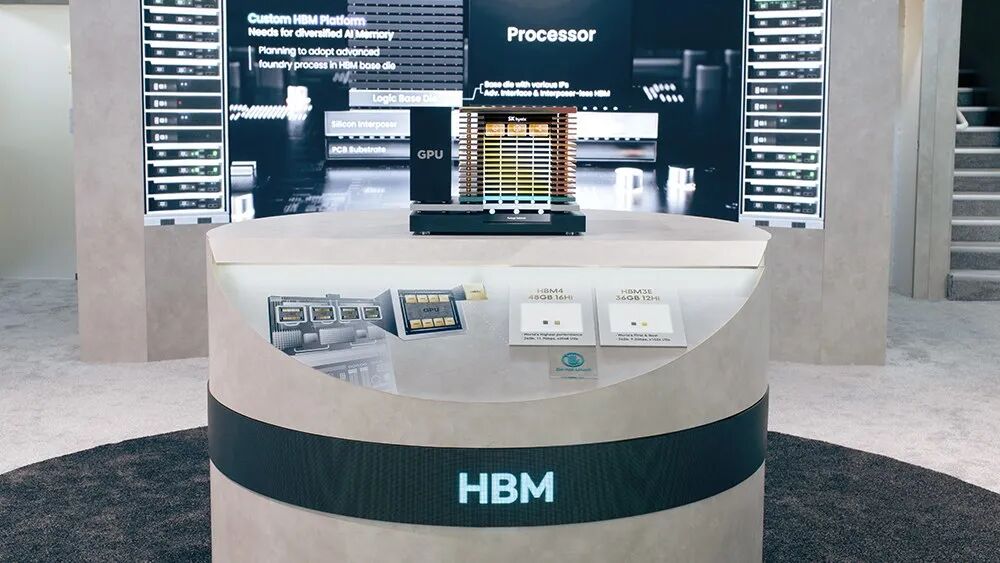
SK 海力士 MWC 2026 展台的 HBM 展示区,背景屏幕为定制 HBM 平台与逻辑基底芯片方案。来源:SK 海力士新闻室
不过,定制化并非没有代价。控制器位置变化之后,接口协议、测试、可靠性管理和系统验证都需要重新划分责任。每一种定制方案还必须达到足够的出货规模,才能分摊额外设计成本。
因此,标准 HBM 与定制 HBM 很可能长期并存。
五、下一代HBM,竞争开始进入逻辑层
HBM4 让存储厂商面临一道新的设计题:在增加带宽和容量的同时,如何管理更宽接口带来的供电、散热和信号完整性问题。而定制 HBM 进一步把问题扩展到了整个 AI 加速器系统:哪些逻辑留在 GPU,哪些功能适合下沉到存储基底芯片,以及两者之间应该采用什么接口?
这也让 HBM 产业的竞争从 DRAM 工艺、堆叠层数与封装能力,延伸到逻辑 IP、先进制程、内存控制器和系统级协同设计。对于 GPU 和 AI ASIC 厂商,HBM 将越来越难被当作一颗规格固定、可以直接替换的存储器件。
当内存基底芯片开始参与计算系统的架构分工,HBM 的设计边界就不再止于存储本身。
关于 HBM4 基底芯片的角色转变,以及 GPU 与内存协同设计的后续走向,云栈社区也会持续关注。
 发表于 1 小时前
|
查看: 3|
回复: 0


