你要是干过运维,或者被云账单吓过,这个项目你会看得心里发毛。它把云架构拆成了游戏,26 个服务摆在工具栏里,你得自己连起来、自己扛流量、自己算成本。
今天这个项目叫 Server Survival,作者 pshenok,GitHub 上 6.4 千星。一句话说清楚:用塔防游戏的壳,讲云架构。不是那种点点鼠标、看着数字往上涨的模拟经营。这个是真会破产的。
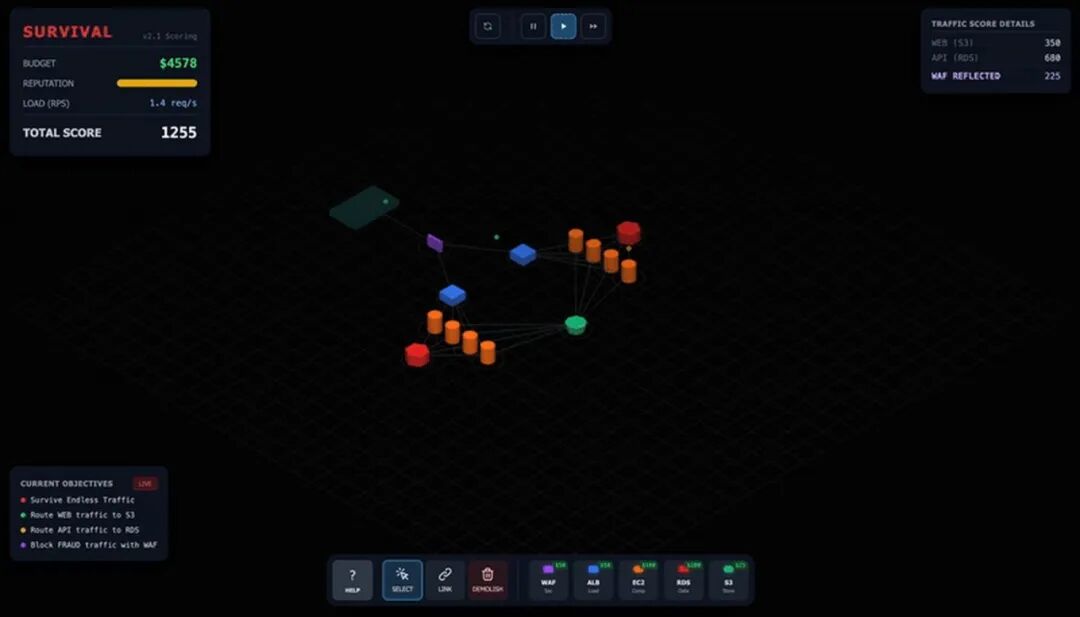
01 它到底是游戏还是课件:项目定位
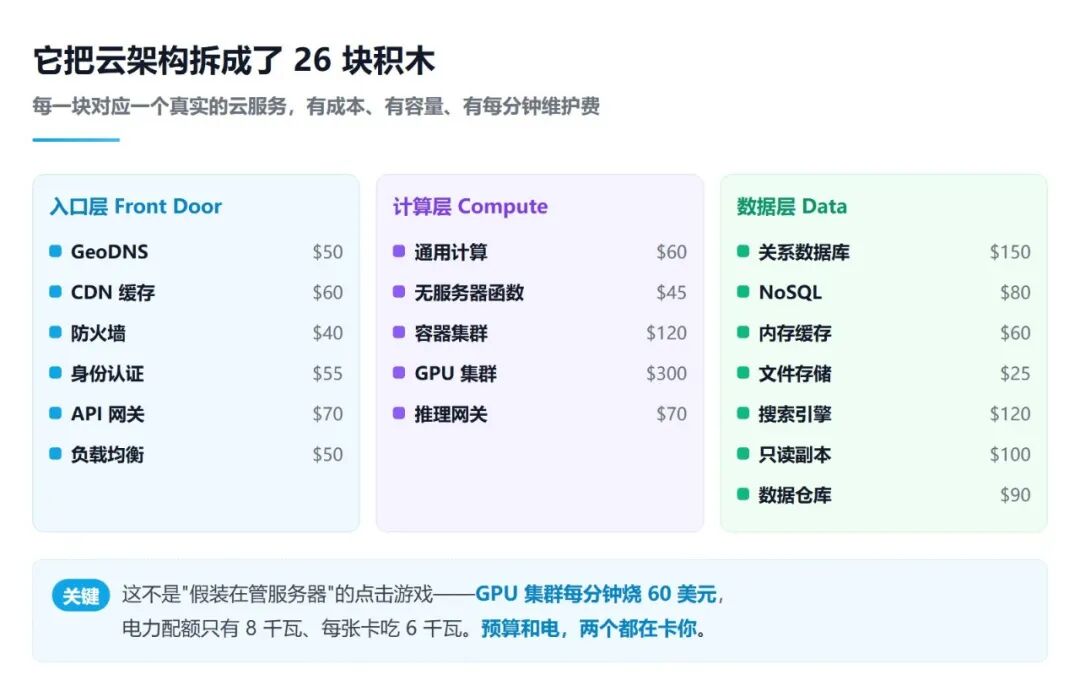
先说明白它长什么样。你面前是一张 3D 等距视角的空白板子,左边工具栏里摆着 26 个云服务,前端入口 6 个、计算 5 个、数据 7 个、异步 6 个、运维 2 个。你要做的事,跟真实的架构师一模一样:
GeoDNS 放到最前面:一个入口分流量。它是整个站点的门面,把流量按地区切到不同的区域栈里。你不放它,流量就没有路径可走,请求会在 Internet 那一头直接丢掉。
防火墙紧跟其后:恶意流量必须挡在这里。每漏一次攻击,声誉掉 5 个点,还要赔 50 美元的入侵费用。声誉掉到 0 就结束。这是全局最狠的一笔惩罚。
负载均衡接在中间:一台机器扛不住就分出去。它把流量分给后面多台计算节点。你只有一台 Compute 的时候它能用,但流量一上来,一台就顶不住了。
连错了会怎样?请求就在半路掉下去,那台节点上随即弹出一个红色的失败徽章,告诉你为什么丢:没有路由、容量打满、副本是只读的、这个索引只能搜不能读。
这个徽章是整个游戏里我最喜欢的设计。它把「排查故障」这件事从抽象的日志里拎出来,直接贴在你画的图上。
02 钱和电,两个都在卡你:经济系统
云架构最反直觉的一点是:它不是技术问题,是钱的问题。这个游戏把这件事做得很老实。
GPU 集群:每分钟烧 60 美元。买它要 300 美元,之后每分钟扣 60。整个 26 个服务里,没有第二个这么贵的。它是用来跑 AI 推理的,你放下去那一刻就开始流血。
电力是硬上限:全场只有 8 千瓦。每张 GPU 吃 6 千瓦。也就是说,你不加变电站,全场只能塞一张卡。想再要一张?先花 150 美元买个 Substation。
维护费还会涨:十分钟内翻倍。所有服务的每分钟维护费,会在这十分钟里从 1 倍慢慢爬到 2 倍。你前期铺得越猛,后面被拖垮得越快。
我算了一下这笔账:一张满负荷的 GPU 集群,把推理请求凑成批一起算,是赚钱的;但半空的 GPU 就是在纯亏。它每分钟照扣 60 美元,不管你有没有活给它干。这个模型太真实了,真实到有点疼。
对方也给了三条命脉,任何一条断了都结束:预算跌破 -1000 美元、声誉掉到 0、服务健康度扛不住。
03 流量不止一种:七种请求
新手最常见的误区,是把流量当成一坨。不是的。这个游戏里分了 七种流量,每种该去的地方都不一样。
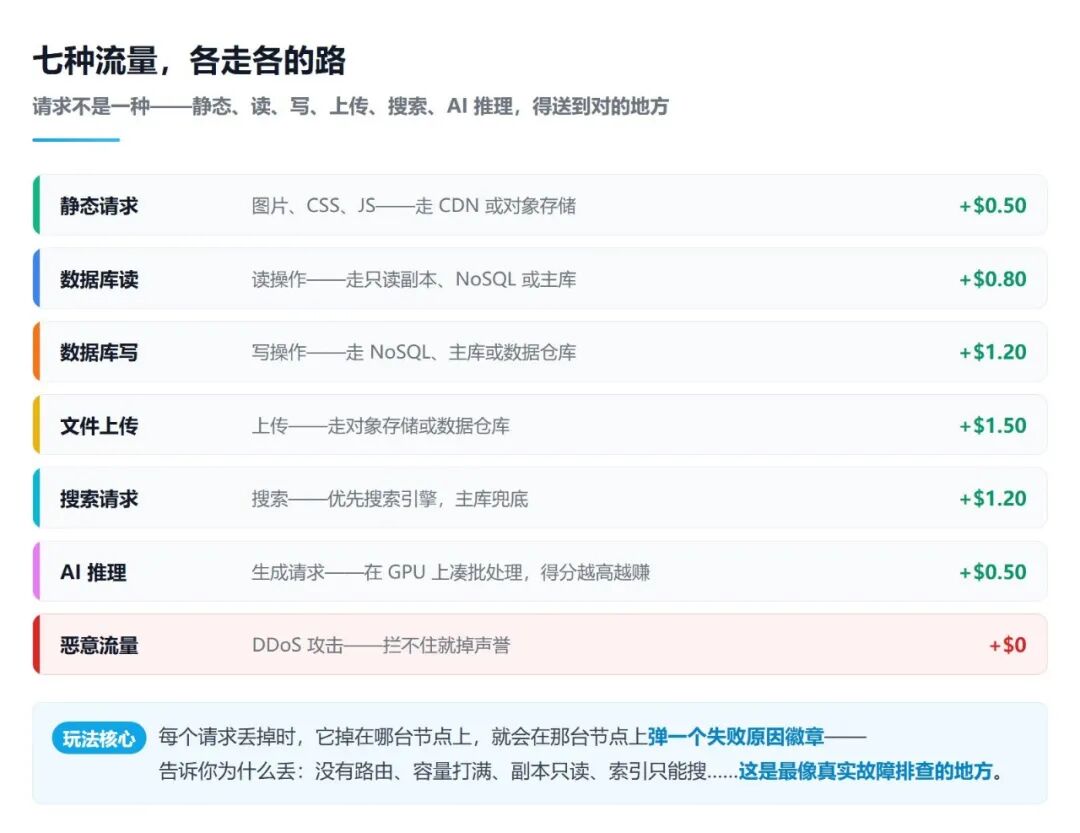
静态请求走 CDN 或对象存储,一次赚 5 毛。数据库读 8 毛,数据库写 1 块 2,文件上传 1 块 5,搜索查询 1 块 2,AI 推理 5 毛。恶意流量一分不赚,你唯一的任务就是把它挡掉。
搜索要走专门的引擎:比数据库快三倍。搜索查询是七种流量里最重的一种,权重是别的 2.5 倍。交给搜索引擎处理,速度是丢给关系数据库的三倍。你要是全甩给数据库,它会先垮。
读和写也该分开:别让主库两头挨打。READ 和 WRITE 都可以走 NoSQL,它更快也更便宜。关系数据库留给搜索和需要强一致的写入就行。
缓存能省一半命:命中一次多赚两成。内存缓存把响应存下来,命中之后奖励翻 20%。它挡住的那部分请求,数据库就不用管了。
它连「优雅降级」都做进去了。这个细节一般游戏不会有:API 网关有限流功能。限流掉的请求,声誉只掉 0.2;而一条请求真的失败了,声誉掉 1。差了五倍。意思是流量洪峰来的时候,你宁可把一部分请求掐掉,也别让它们冲进去把后面的服务打崩。这是真实的工程取舍,不是什么数值平衡。
04 它是怎么教你这些东西的:三种玩法
它给了三个模式,难度和目的完全不同。
生存模式:看你多久破产。流量会按时间点翻倍,1 分钟 ×1.3,到 10 分钟就是 ×4。中间每 15 到 45 秒随机来一个事件:成本飙升、容量暴跌、流量暴涨、服务宕机。每 45 秒来一波 DDoS,占掉一半流量。这个模式就是逼你手忙脚乱。
战役模式:25 关,五章。从最基础的「放第一台服务器」开始,到缓存、队列、读扩展、限流、无服务器。后面几章开始讲可观测性、自动扩缩容、宕机恢复、两区域容灾,收尾那一章叫「AI 浪潮」,讲 GPU 推理的冷启动、批处理经济学、SLO 时限和那堵电力墙。每一关都配好了初始架构和一个课后小结。
沙箱模式:随便折腾,不会结束。预算自己填,流量比例自己调,七种流量各占多少都能单独拉。0 到 1 万的预算滑杆,你想试试 100 以上的 RPS 也拦不住你。
05 我想重点说说收尾那一章:AI 时代的架构
很多云架构教程讲到缓存和队列就停了。这个项目往后多走了一步,它把 AI 推理 当成一种基础设施来讲。有几个点我觉得写得比很多正经文章还清楚:
模型冷启动要等:12 到 30 秒。GPU 装上模型之前不能干活。你放上去那一刻,它先加载 12 到 30 秒,这段时间它一分钱不赚但一直在烧。每次升级档位,还得重新加载一遍。
批处理决定生死:凑满一车才划算。推理请求会被凑批一起算,一次最多 8、12、16 个。凑得越满,那笔固定的批处理成本摊得越薄。满批赚钱,半批亏钱。
回答质量也是成本:答错要扣声誉。模型档位越高,答得越好。小的答错率 10%,中的 4%,大的 1%。每答错一次,声誉掉 0.5。
有 6 秒的时限:过期的直接作废。推理网关会缓冲那些在预热或者忙不过来的 GPU,但超过 6 秒的请求它直接判失败。宁可诚实地失败,也不给你一个过期的结果。
我个人最喜欢「电力上限」这个设定。它把一个抽象的事实摆到台面上:GPU 的天花板,不是用钱买的,是用瓦特买的。你先得买到电,才轮得到买卡。
06 说点实在的:说点实话
第一:它不用装,打开网页就能玩。官方网站就是 GitHub Pages 托管的,不用装东西、不用注册。整个项目没有构建步骤,原生 ES 模块直接跑。
第二:它对手机也做了适配。单指拖动摆服务,双指缩放平移,竖屏横屏都能用。就是旋转视角和俯视切换还得用键盘。
第三:想本地跑得用服务器。它是原生 ES 模块,浏览器按 CORS 方式加载,你双击 index.html 只能看到一个空画布。得用 python3 -m http.server 8000 起个静态服务才行。文档里直接写了这点,挺实在。
第四:它还有个姊妹篇。作者后来又做了一个 Datacenter Survival,讲的是云下面那层物理设施:供电链路、散热、冷却、PUE。这个讲逻辑层,那个讲物理层,俩凑一对。
07 收个尾:收尾的话
我为什么想讲它。学云架构最容易卡住的地方,是你看不见钱在哪儿流走。文档给你讲一堆概念,概念之间没有摩擦力,你记不住。
这个项目把摩擦力加回来了。你放一台 GPU,看着钱一分钟一分钟掉;你不放防火墙,声誉就是止不住地往下掉;你队列不给够,流量洪峰一来请求成片地丢。等你真的因为它破产过一次,那些概念就不用背了,它们长在你手上了。类似这样能把云架构讲透的实战项目,在 云栈社区 里也常有人分享。
 发表于 半小时前
|
查看: 4|
回复: 0


