关键词:AI Infra、量化分析、LLM 推理、KV 缓存、训练系统
李博杰在 GitHub 上 50k+ Star 的《深入理解 AI Agent》之后,又开源了姊妹篇《深入理解 AI Infra:量化分析与系统设计》。前一本讲怎么用模型,这一本讲模型跑在什么上面:算子、显存、互联、调度——那些决定一次生成要几毫秒还是几秒、一张卡够不够、成本差一个数量级的底层问题。
《深入理解 AI Infra》这本书的出发点是一个判断:AI Infra 领域缺一本像《计算机体系结构:量化研究方法》那样的书,从硬件约束和模型架构出发,用数量级估算把系统设计推导出来。作者的理由很直接:延迟差几倍,产品体验就完全不同;成本差一个数量级,能支撑的商业模式就跟着改变。用他的话说,"模型是 LLM 时代的操作系统,AI Infra 是 LLM 时代的计算机体系结构"。
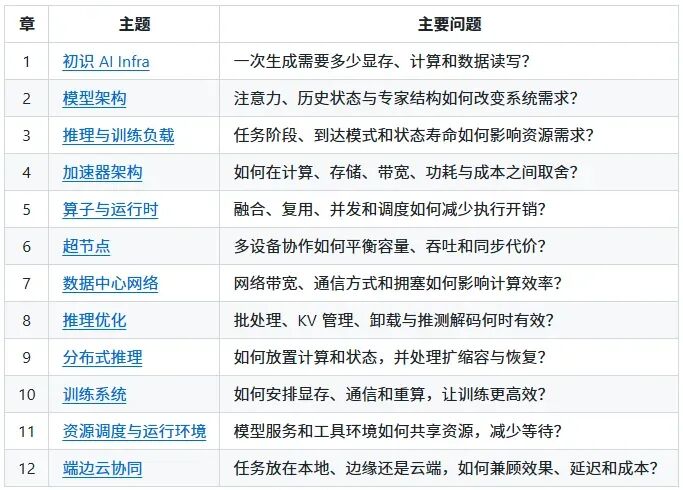
书稿共十二章,正文、配图脚本、计算工具、实验记录全部开源,Apache 2.0 许可,英文、繁中、俄文译本由社区完成。
下面,本文按书的脉络,介绍它的方法论和各章内容。
本文目录
- 一、方法论:从约束推导设计
- 二、第一章:一次生成背后的数字
- 三、第二章:模型架构如何决定系统需求
- 四、第四到七章:硬件与互联
- 五、第八到十二章:推理、训练与部署
- 六、配套工具、实验与 Skill
- 结语
一、方法论:从约束推导设计
1.1 先算上限,再看实测
全书的方法可以概括成一句话:先明确任务与质量要求,列出计算、存储、通信和依赖关系,再对照硬件的容量、带宽和算力做数量级估算。
这个习惯来自作者读博时导师张霖涛的要求:优化要做到物理所允许的极限。落实到书里,就是先用第一性原理算出硬件允许的上限,再看实测离上限有多远。差距要么说明估算漏了项,要么说明系统里有可以去掉的开销。
书里列举了估算最常见的几类错误:只算权重读取忘了 KV 缓存,按峰值算力推速度却不查带宽能否供给,把工作平分给多张卡却遗漏卡间通信😅。漏掉任何一项,结论可能偏离几倍甚至几个数量级。
1.2 数据搬移五问
作者从 FPGA 加速 Bing 搜索排序、昇腾 AKG 算子生成到 UB 万卡互联的经历中,提炼出一条线索:数据搬移。全书反复追问五个问题——搬什么、搬多少、搬几次、经过哪里、谁必须等它。
这五问可以当作性能分析的通用检查清单。
- 一次 decode 慢,是权重多读了几遍,还是 KV 经过了不该经过的链路?
- 一次集合通信拖尾,是带宽不够,还是某个节点被迫等待?
把系统问题翻译成搬移问题,是全书反复使用的基本功。
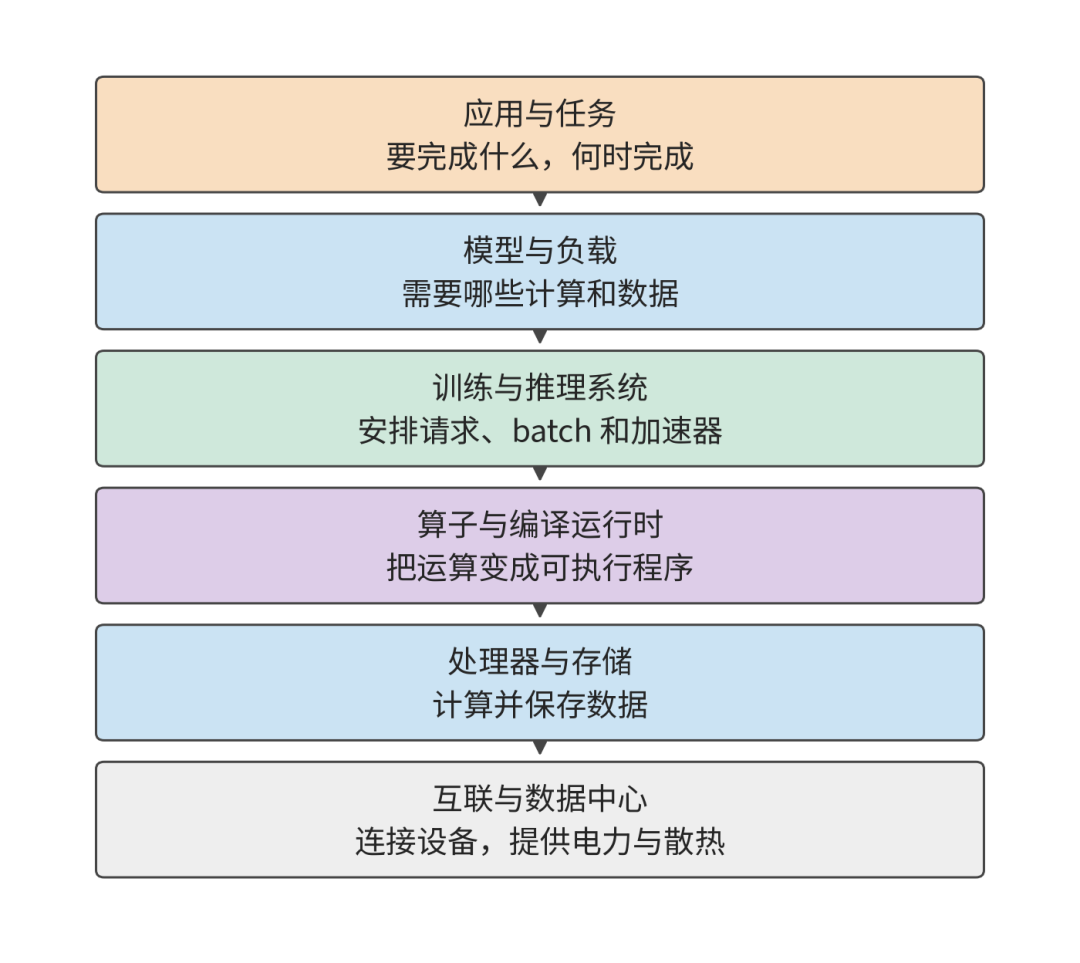
作为全书全景图,其展示了 AI 系统自顶向下的分层栈结构,共六层。最上层是应用与任务,明确业务目标与交付时限;往下是模型与负载,确定所需计算和数据;接着是训练与推理系统,负责调度请求、批次与硬件加速器;再下层为算子与编译运行时,将数学运算转化为可执行程序;然后是处理器与存储层,完成计算和数据保存;最底层是互联与数据中心,负责设备互联、供电与散热。整套层次清晰呈现从 AI 业务需求到底层物理基础设施的完整链路。
二、第一章:一次生成背后的数字
第一章回答一个具体问题:一次生成需要多少显存、计算和数据读写。书里沿一次请求的处理过程,把系统分成六层——应用与任务、模型与负载、训练与推理系统、算子与运行时、处理器与存储、互联与数据中心,后文各章分别对应这些层次。
方法上,第一章引入两类工具。
- 一类是 Jeff Dean 那张著名的延迟数量级表,配合 Amdahl 定律:被加速的部分占总时间越多,优化收益越大,局部速度的提升要放回完整任务中衡量。
- 另一类是三个基本估算式:容量约束、计算时间下界、读写时间下界。
书里还定义了两个贯穿全书的指标——MFU(模型算力利用率)和 MBU(带宽利用率),用来回答"设计离硬件物理极限还有多远"。
这些内容都落在真实硬件和真实模型上。
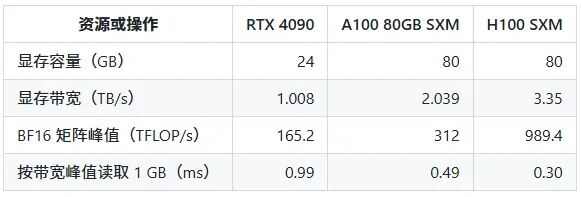
该表格对比 RTX 4090、A100 80GB SXM 与 H100 SXM 三款 GPU 的硬件指标。RTX 4090 显存仅 24GB,显存带宽与 BF16 矩阵算力最低,读取 1GB 耗时最长;A100 与 H100 显存同为 80GB,但 H100 显存带宽达 3.35TB/s,BF16 矩阵峰值算力大幅领先,读取 1GB 数据耗时最短。整体呈现从消费级卡到高端 AI 加速卡,显存容量、访存带宽、矩阵计算能力逐步提升,数据读取延迟持续下降的特点,体现面向大模型训练推理的硬件升级方向。
书里给出 RTX 4090、A100、H100 SXM 的资源速查表如上,然后用 DeepSeek-R1-Distill-Llama-70B 做完整算例:BF16 权重约 141.11 GB,一张 80 GB 的 H100 放不下;分组 8 比特量化后约 73.73 GB,可以放进一张卡,但 8192 token 请求的 KV 缓存加工作区还要再占约 4.8 GB,如下图所示。
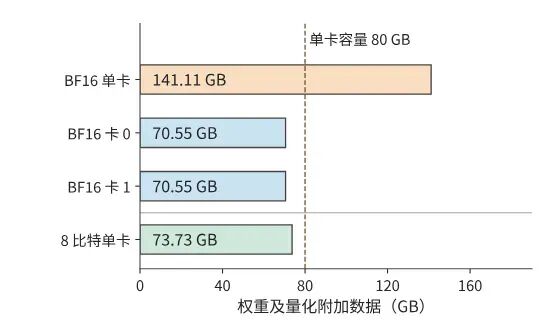
图 1-7 DeepSeek-R1-Distill-Llama-70B:该柱状图对比不同精度下模型权重与量化附加数据占用显存大小,虚线代表单卡 80GB 显存上限。BF16 精度单卡加载需 141.11GB,远超 80GB 上限,无法单卡部署;采用张量并行拆分到两张卡后,每张卡仅占用 70.55GB,可在 80GB 卡上运行。8 比特量化单卡占用 73.73GB,低于显存上限,支持单卡部署。可见量化或张量并行,能够降低大模型显存需求,适配 80GB 显卡。
第一章的例题接着问:这张卡能否在 10 ms 内生成一个 token?算出来的结果是,单步仅读取权重就需约 20.90 ms,而矩阵计算只需约 0.14 ms——读取是计算的 148 倍,decode 阶段的瓶颈在带宽。
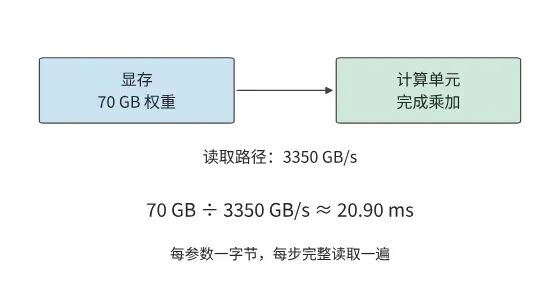
图 1-8 大模型推理时显存读取的算力瓶颈。模型 70GB 权重存于显存,推理每一步都要完整读取全部权重,通过带宽 3350GB/s 的传输通路送入计算单元做乘加运算。经计算,读取耗时约 20.90ms。这个场景下,GPU 的计算单元算力充足,但权重数据从显存读取的速度限制了推理速度,属于典型的显存带宽受限场景,也就是访存瓶颈。
沿着这个结论,书里比较了三种对策:算力翻倍对总时间几乎无效,带宽翻倍或权重减半才能把读取压到约 10.45 ms;让 8 个请求共享一次权重读取,吞吐从约 47.9 token/s 提到约 383 token/s,如下图所示。
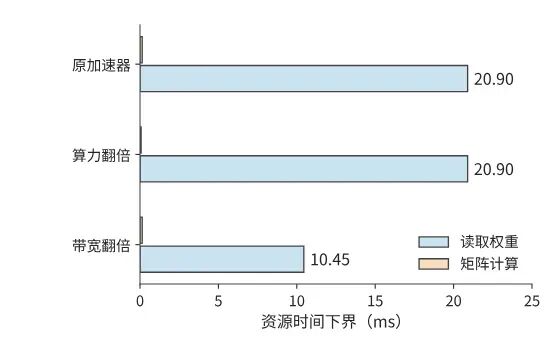
图 1-9 保持运算量与读取量不变,分别把算力或带宽翻倍。蓝条是权重读取下界,橙条是矩阵计算下界;较长的读取项决定这组条件下的优化方向。原加速器与算力翻倍场景,读取权重耗时均为 20.90ms,推理耗时没有变化,说明此时瓶颈不在计算能力。当显存带宽翻倍后,读取权重耗时降至 10.45ms,推理延迟明显下降。这表明该场景属于显存带宽瓶颈,单纯提升 GPU 算力无法优化推理速度,只有提高显存带宽才能减少权重读取耗时,提升推理性能。
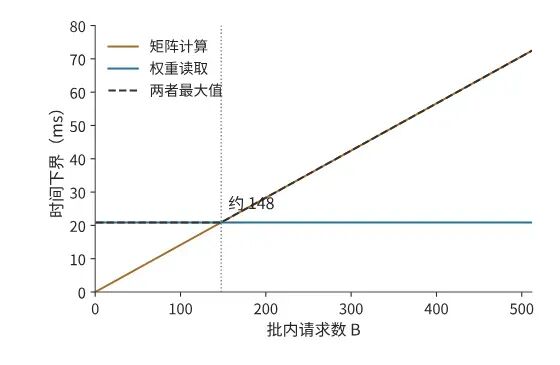
图 1-11 批内请求增加时,矩阵运算量按批内请求数增长,权重读取保持每批 70 GB。蓝色水平线代表权重读取耗时,基本固定不变;橙色斜线代表矩阵计算耗时,随批请求数增加线性上升。虚线为两者耗时的最大值,也就是整体推理时间下限。当批请求数约 148 时两条线相交:小于该值时权重读取是瓶颈,大于该值时矩阵计算成为瓶颈。这说明增大 batch 会把推理瓶颈从显存访存切换到 GPU 算力。
batch 增大到约 148 时计算才追平读取,这就是后面第四章 Roofline 模型的出发点。估算之外还有实测:第一章末用 vLLM 在 RTX PRO 6000 Blackwell 上跑了 Qwen3-8B 的 batch 扫描,验证"吞吐随 batch 增长、整批时间受权重读取限制"这两条预测趋势。
第一章还埋了一条贯穿全书的真实案例线:DeepSeek V4 与 V4.1。V4.1 Flash 采用因果编码器—解码器(CED)架构,输入 token 不必全部经过解码器主体,模型因此能针对 Agent 任务"输入多、输出少"的负载形状重新分配计算。后续各章会反复回到这条线,检验模型与系统如何共同改变。
三、第二章:模型架构如何决定系统需求
第二章从一个 token 的数值表示出发,沿 Qwen3-8B 的 36 层网络推导每一项资源需求:投影和 FFN 的运算量随输入 token 数线性增长,注意力的查询—键配对数随上下文长度平方增长,两者要分开计量。
书里给出 Qwen3-8B 单层 FFN 约 1.51 亿参数、占主要投影参数约 78% 这样的细分账,再推导 KV 缓存的容量公式:每 token 144 KiB,8192 token 就是 1.125 GiB。
这一章的重点是模型结构对系统需求的改变。GQA 让四个查询头共享一组 KV,存储量直接减半;MLA 把上下文压缩成低维潜变量保存,利用矩阵乘法结合律把上投影从"每个上下文 token 一次"挪到"每个新查询一次",Kimi K3 的 24 层 MLA 存 8192 token 只需 216 MiB,展开保存则要约 11.25 GiB;DeepSeek V4-Flash 的 CSA 按压缩比 4 保存上下文并维护索引,HCA 按压缩比 128 保存粗粒度条目,43 层合计在 8K 上下文下只占约 70.8 MiB。
每种机制的节省都来自具体的结构选择,书里逐项给出存储量、读取量和新增的选择开销,不省略筛选索引本身要读多少数据这类容易漏算的项。
第二章还有一组有趣的对比。
- 同一条 Qwen3-8B 请求:prefill 处理 8192 个输入 token 共需 133.6 TFLOPs;已有 8192 token 上下文、再补入一个新 token 的 decode 只需 20.0 GFLOPs——相差近七千倍,因为缓存省掉了旧 token 的投影和 FFN 重算。
- 再看累计效应:8192 token 输入、生成 1025 个 token 的一条请求,结束时保存的 KV 约 1.27 GiB,但生成期间累计读取旧上下文约 1224 GiB,接近存储量的一千倍。早进入上下文的 token,后面每一步 decode 都要再读一遍,这个平方级的累计关系决定了长输出任务的成本结构。
第三章把静态的模型变成动态的负载:请求的到达模式、prefill 与 decode 的比例、上下文状态的寿命,如何改变资源需求随时间的形状。Agent 负载是这里的重点场景——多轮工具调用让上下文持续增长,恢复前缀与新增输入的成本要分开核算。
四、第四到七章:硬件与互联
第四章讲加速器架构,回答容量、带宽、算力、功耗、成本之间的取舍。Roofline 模型在这里正式登场:算术强度低于算力带宽比时受带宽限制,高于时受算力限制,第一章的 148 倍差距在这里得到图形化解释。
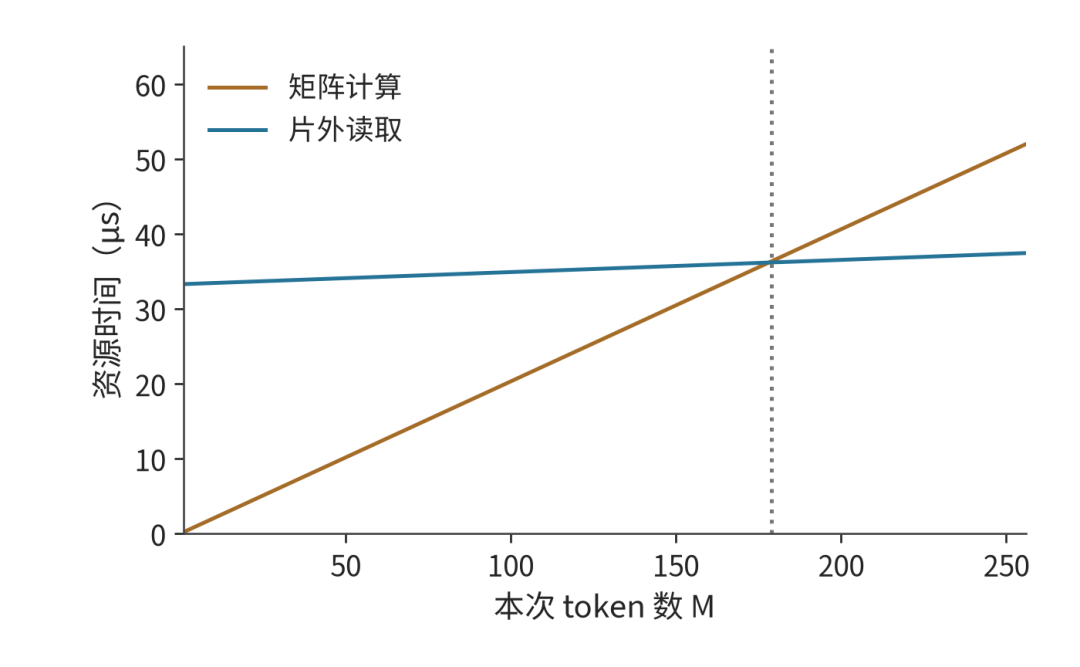
Roofline 模型,该折线图展示大模型推理时,本次 token 数 M 变化对矩阵计算、片外读取两类资源耗时(单位微秒)的影响。棕色矩阵计算耗时随 token 数量增加呈线性增长;蓝色片外读取耗时增长平缓,基本维持稳定。两条曲线存在交点,交点左侧片外读取耗时更高,访存是性能瓶颈;交点右侧矩阵计算耗时超过片外读取,计算成为瓶颈。这反映大模型推理会随 token 长度变化,在访存受限和计算受限两种状态间切换。
- 第五章讲算子与运行时:分块如何让一份权重在片上复用更多次,算子融合如何让中间结果不出寄存器,FlashAttention 式的分块如何把评分、归一化和汇总接在一起,减少显存读写。
- 第六章把单卡内的分块逻辑推广到多卡:张量并行、流水并行、专家并行本质上是同一个问题——先确定每块由谁计算,再安排输入到达与结果汇合,区别只在块之间跨越的是片内存储、显存还是网络。
- 第七章继续向外推到数据中心网络,讨论带宽、拥塞与故障如何影响计算效率。
五、第八到十二章:推理、训练与部署
第八、九章是推理侧的核心。批处理何时有效、KV 如何管理和共享、卸载与推测解码各自在什么条件下成立——书里延续了前文的算账方式。注:很多细节我们这里一笔带过,感兴趣可以读读在线版本:bojieli.github.io/ai-infra-book/。
- 例如第二章已经算出,8192 token 上下文下 batch 超过 13,各请求的 KV 读取量就会超过共享权重的读取量,权重复用的收益到此为止;
- 第八章的批处理讨论正是建立在这类边界上。
- 第九章处理分布式推理:计算和状态放在哪里,扩缩容和故障恢复时状态如何迁移。
- 第十章讲训练系统:显存里要同时放下权重、梯度、优化器状态和激活,通信与重算如何取舍,检查点的间隔怎么定。
- 第十一、十二章把视野拉宽:模型服务与 Agent 的工具环境如何共享资源,任务放在端、边还是云,如何同时满足效果、延迟和成本约束。
六、配套工具、实验与 Skill
这本书的数字都可以复算模型的细节参数。在 calculations/ 目录下有一个纯 Python 标准库的计算工具,不需要 GPU 和模型权重:
python3 calculations/calc.py models
python3 calculations/calc.py forward --model qwen3-8b --tokens 8192 --format md
configs/models/ 里保存 DeepSeek-V3、Kimi K3、Qwen3 等模型的真实配置文件,每个都带 Hugging Face 的 commit 版本锁定。src/infra_calc/topics/ 下有上百个主题模块,每个对应书中的一个算例,输出与正文引用保持一致。不同意某个结论,可以换一组模型和硬件重新算。experiments/ 按章节存放真实实验记录,附带运行方法、输入条件和结果说明。
拿一个实验来说,下面是文中实验 1-1 的 Agent 循环工作流:图片展示了一段 Qwen3-8B 六轮工具调用的轨迹,六轮模型生成合计 18.94 秒,工具子进程 16.37 秒,整个循环 35.42 秒。
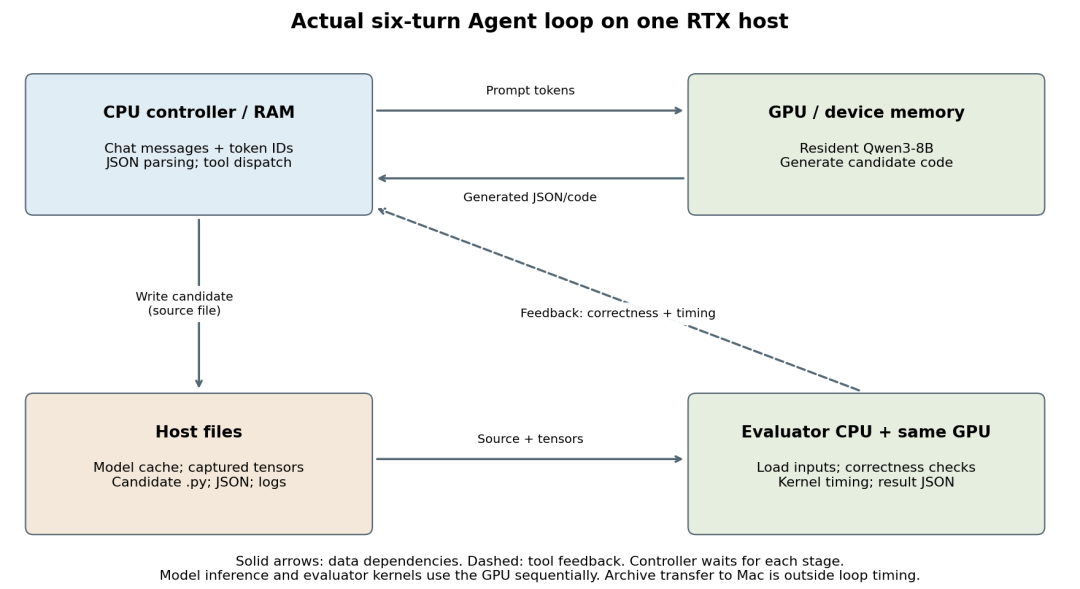
实验 1-1 单台 RTX 主机上六轮 Agent 循环的工作流程。CPU 控制器把对话消息、token 序列打包成提示词发给 GPU,GPU 加载 Qwen3-8B 模型生成候选代码并回传 JSON 结果。CPU 将候选代码写入主机文件,文件再向评估器提供源码与张量;评估器在同 GPU 上完成正确性校验、内核计时,把反馈信息传回 CPU 控制器。实线代表数据依赖,虚线为工具反馈,模型推理与评估内核串行占用 GPU,控制器等待各阶段依次完成。
skills/ 目录把十二章的方法整理成十二个 Skill,复制到 Codex 或 Claude Code 的 skills 目录即可使用。
例如 resource-budget 把第一章的估算流程固化为操作序列:先写清任务目标与假设,再分别估算容量、运算量、读写量,先检验容量约束,再算时间下界,最后沿依赖关系画关键路径。
作者也在文中贴心提醒❤️:Skill 里的数字要随模型和硬件重新核算,不能把原书算例当作当前硬件基准。
结语
模型为什么慢,一张卡能承载多少请求,增加设备后能缩短多少等待,这些问题都需要结合具体条件计算。《深入理解 AI Infra》提供了一条分析路径:从模型结构出发,列清容量、计算与读写需求,再沿着执行过程检查通信、同步和排队。
书稿之外,配套工具与实验记录让读者可以继续核对这些推导。选一个熟悉的模型,换成自己的上下文长度、并发数和硬件配置,先做估算,再与实测比较。两者之间的差距,往往就是下一步需要追查的地方。
搬什么、搬多少、搬几次、经过哪里、谁必须等它。 这五个问题贯穿全书,也可以留在日常开发的检查清单里。
读完一章,复算一个例子,再回头看正在运行的系统:哪些数据反复读取,哪些状态持续占用显存,哪些等待可以减少。 对系统设计的理解,就从这些具体问题中逐步积累。
 发表于 3 小时前
|
查看: 4|
回复: 0


