碎片化架构的"边境税"与GPU的重心崛起
在边缘计算与大模型融合的浪潮下,芯片行业正经历一场深刻的架构变革。长期以来,为了应对图像渲染、语音识别、计算机视觉及神经网络推理等多元化任务,芯片厂商往往倾向于在 SoC 中不断叠加专用的加速模块——CPU、GPU、DSP 与 NPU 各司其职。
但问题也由此产生。"每一个加速器都能很好地解决一个问题,但每一个加速器也会创造一个依赖。"
在 Imagination Technologies 日前举行的媒体开放日活动上,公司 CEO Markus Mosen 将这种代价形象地称为一笔 "边境税":不同计算单元像一座座孤岛,数据要不断经过外部内存在 GPU、NPU、DSP、CPU 之间搬运,每跨过一次边界,都要同时付出三种成本——能耗、时延,以及工程师的开发和维护时间。
对此,Imagination 想做"减法"——让 GPU 从单纯的图形处理器,进一步成为图形、通用计算和 AI 之间的"融合加速器"。近日,Imagination 正式公布其最新的 E 系列 GPU IP 的计算性能数据,显著的性能提升进一步强化了其 GPU-First 的战略。E 系列采用一颗处理器、一套架构和一套软件栈,同时处理图形、计算和 AI 工作负载。
从终端用户的角度看,一部手机、一辆汽车、一个机器人或者一台工业摄像机,其实并不会把"感知、建模、推理、决策、渲染"看成五件毫不相关的事情。它们发生在同一条数据链路里,面对同一个响应时间,共享同一块电池,也共享同一个内存和功耗预算。
现在的问题是,工作负载已经融合,硅片架构却没有完全跟上。
传统异构 SoC 往往由 CPU、GPU、NPU 和 DSP 分别承担不同任务,每个处理器又拥有自己的本地存储和软件环境。中间结果不得不反复进出 DRAM。Markus 认为,这些"边界"本身就是成本。
数据搬运消耗的是纳焦耳,任务切换增加的是毫秒,而驱动、工具链、安全模型和软件维护最终消耗的,则是以"工程师年"来计算的研发资源。Imagination 因此提出,与其不断增加新的专用计算岛,不如尽可能建立一个共享、可编程的计算中心。
融合已经在发生,谁最适合成为这个计算重心?Imagination 的判断是 GPU。
理由并不只是 GPU 算力高,而是它同时具备几个已经存在的基础:高度可编程、大规模部署、成熟的驱动和工具链、标准 API 以及庞大的开发者生态。更重要的是,对于手机、PC 和数字座舱等视觉设备来说,GPU 本来就是无法被拿掉的处理器。
按照 Markus 所说:"计算的重心正在往 GPU 转移,图形和 AI 靠得更近,需要统一内存、统一调度、统一软件栈。"这一切归根到底就是两个字——效率,既是客户开发的效率,也是产品跑起来的效率。要最好地解决效率,方向就是 GPU。
E系列:把AI真正嵌进GPU
"GPU 是用户体验的核心",Imagination 首席营收官 Jake Kochnowicz 先抛出了这样一个判断。
无论手机、平板、PC 还是数字座舱,只要设备拥有屏幕,最终呈现在用户眼前的每一个像素,几乎都绕不开 GPU。与此同时,经过几十年的发展,GPU 已经从单纯的图形处理器变成高度可编程的并行计算平台。DirectX、Vulkan、OpenCL 等行业标准,以及围绕 GPU 形成的驱动、工具链和开发者生态,也早已相对成熟。
因此,在 Jake 看来,当 AI 开始越来越深地介入用户体验,GPU 其实是最自然的承载者之一。图像超分、神经渲染、生成式 AI、语音助手、生产力工具乃至本地大模型,都需要大量并行计算。而在很多 SoC 中,GPU 本身已经是面积和计算能力最大的处理单元之一。
过去给 SoC 增加 AI 能力,一个很直接的办法是再加入一个 NPU。虽然每个处理器都能在自己的领域获得更高效率,但代价是芯片内部形成越来越多的"计算孤岛":GPU 处理图形,NPU 处理 AI,CPU 负责调度,不同计算单元拥有不同的数据路径和软件环境。
E 系列选择的是另一条路——不是继续增加新的计算岛,而是把 AI 矩阵计算能力直接融入 GPU 原有的数据路径。
E 系列最核心的一项架构变化,是矩阵加速能力与 GPU 执行单元的深度耦合。Jake 介绍,E 系列将矩阵乘法能力直接放进 GPU 内部,紧邻现有图形计算单元。"这意味着 AI 能把 GPU 现成的一整套东西都用上:寄存器、控制、缓存、固件、驱动、工具链,还有围绕 GPU 的整个生态,这是对既有投资极高的杠杆利用。"
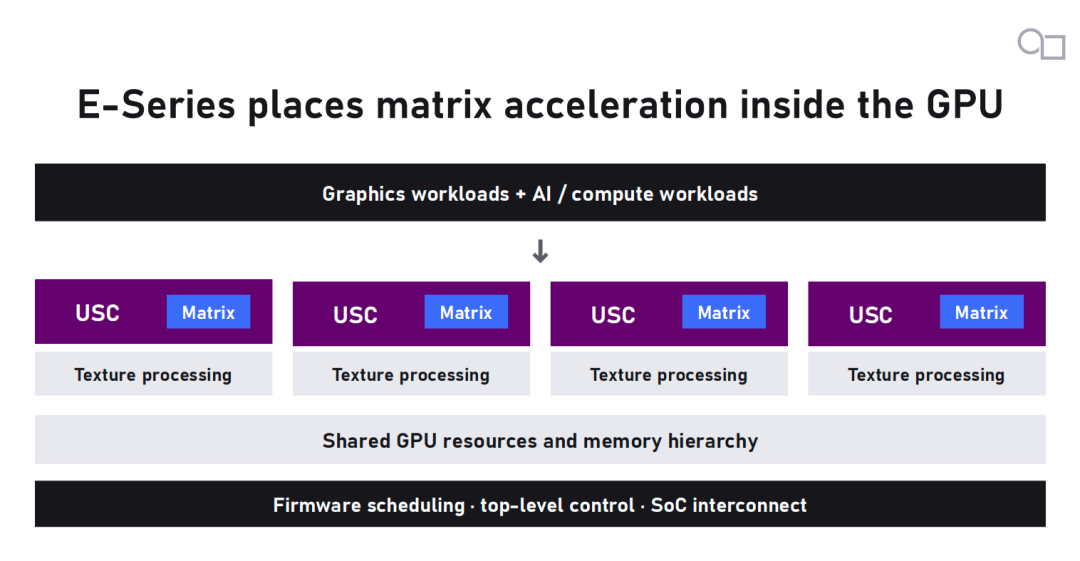
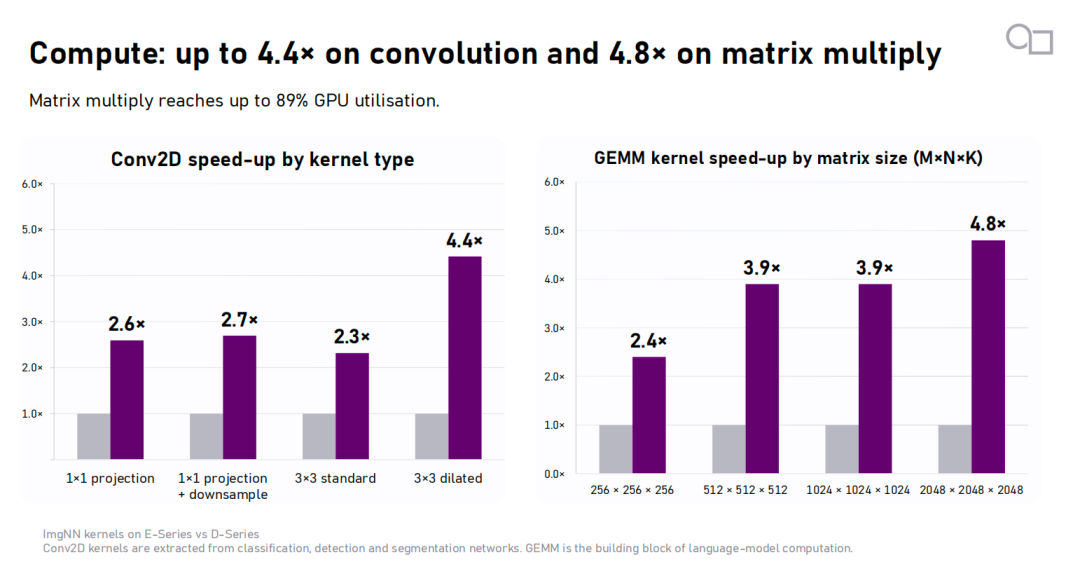
从性能上来看,在 1GHz 下,E 系列单核心 FP32 算力达到 2 TFLOPS;矩阵计算方面,FP16/BF16 可达到 16 TFLOPS,INT8/FP8 达到 32 TOPS。最大四核配置下,FP16 矩阵性能超过 100 TFLOPS,FP8 则超过 200 TFLOPS,相比 D 系列提升超过 4 倍。
但 Imagination 反复强调,GPU 不能只看 TOPS 和 FLOPS,它还得能塞进真实系统,给系统设计者留足选择。E 系列核心从单核到四核可扩展,峰值配置下可寻址内存 1TB,峰值读带宽 768GB/s,通过 AXI 能接 HBM、LPDDR、GDDR 或者统一内存任意一种。不同产品规模可以变化,但背后使用的仍然是同一套 IP 和软件栈。
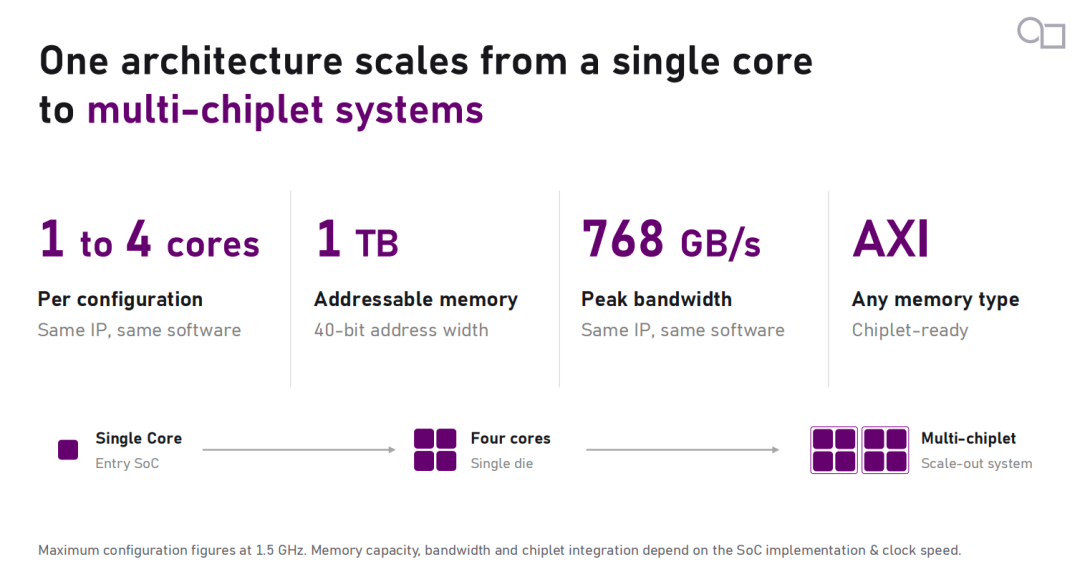
这或许也是 Imagination 所谓"融合"的真正含义:并不是所有任务都必须由 GPU 完成,而是尽可能让不同任务共享同一套底层计算资源和软件基础。
图形与AI的融合典范:神经超分辨率NSR
此次媒体开放日中发布的 NSR 神经超分辨率,最能体现这种融合价值的一个应用。
今天 AI 超分已经不是新鲜概念。英伟达有 DLSS,AMD 有 FSR,移动 GPU 厂商也在陆续把 AI 引入图形渲染。
但 Imagination 给 NSR 找到的切入口并不是单纯追求更高画质,而是数据搬运效率。
传统 GPU+NPU 方案中,GPU 先完成渲染,再把结果写入 DDR;NPU 重新读取数据完成超分,然后再写回内存。Jake 强调到,在任何设备里去内存取数都可能极贵,数据搬得越远越耗时越耗电。神经渲染就是展示这种距离成本,以及"融合"为什么有价值的最好例子。
E 系列的做法则是将图形 Shader 和矩阵计算放得足够近,使图形与 AI 可以在同一套 GPU 执行环境里完成。这与 Imagination 长期采用的 TBDR(分块延迟渲染)架构也形成了结合:不是等完整一帧图像全部生成后再处理,而是以 Tile 为单位进行渲染和计算。
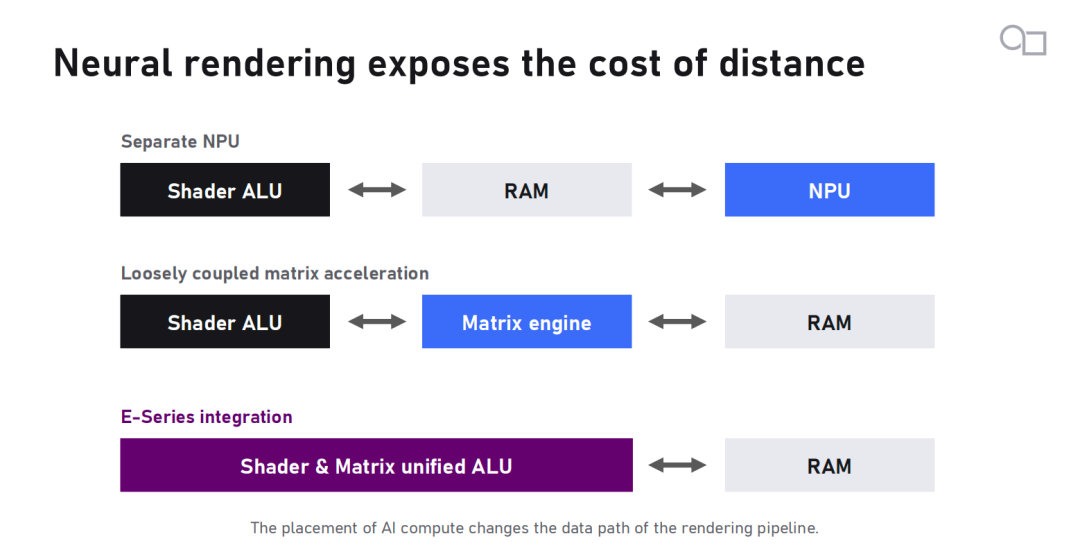
这非常符合移动和边缘设备的特点。因为与拥有独立显存和巨大显存带宽的桌面 GPU 不同,手机、汽车、机器人 SoC 上的 GPU 往往需要和 CPU、ISP 等模块共享系统内存,每一次额外的数据搬运都更加昂贵。
NSR 采用单次处理网络,并结合 Imagination 的网络自压缩技术,可移除约 65% 的冗余权重。在 1GHz 单核 E 系列 GPU 上,将 540p 画面提升至 1080p 仅需 2.3 毫秒;从 1080p 提升至 4K 时,带宽消耗最高可降低 54%,帧率提升 2.5 倍。
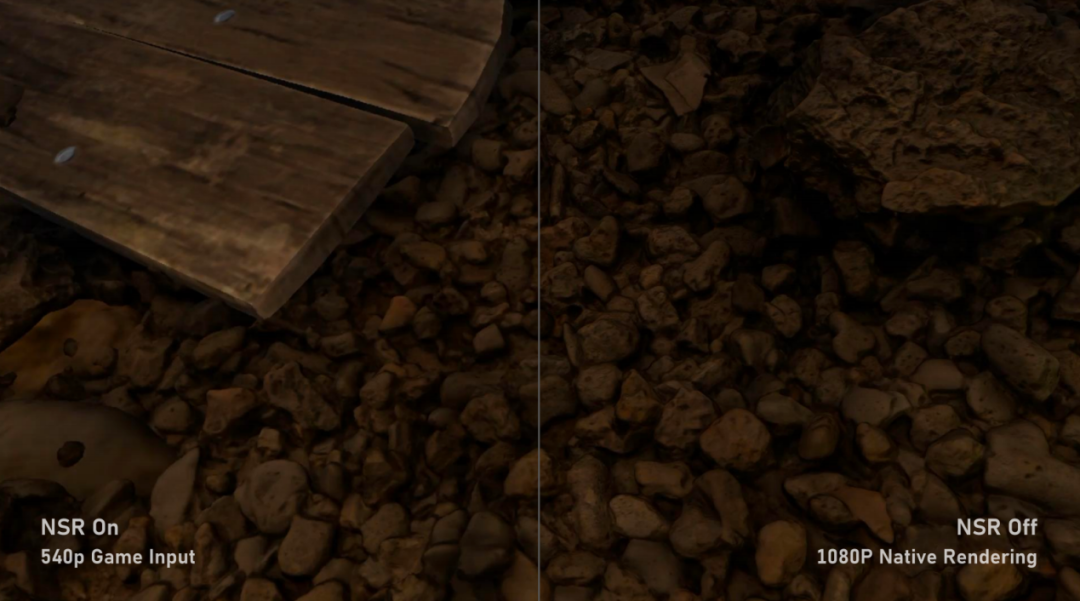
现场 demo 对比了 1080p 原生和 540p 超分到 1080p 的画面,画质呈现完全没有损失。
向 AI 扩展,并不意味着 Imagination 放弃 GPU 最传统的图形能力。图形仍是基本盘。
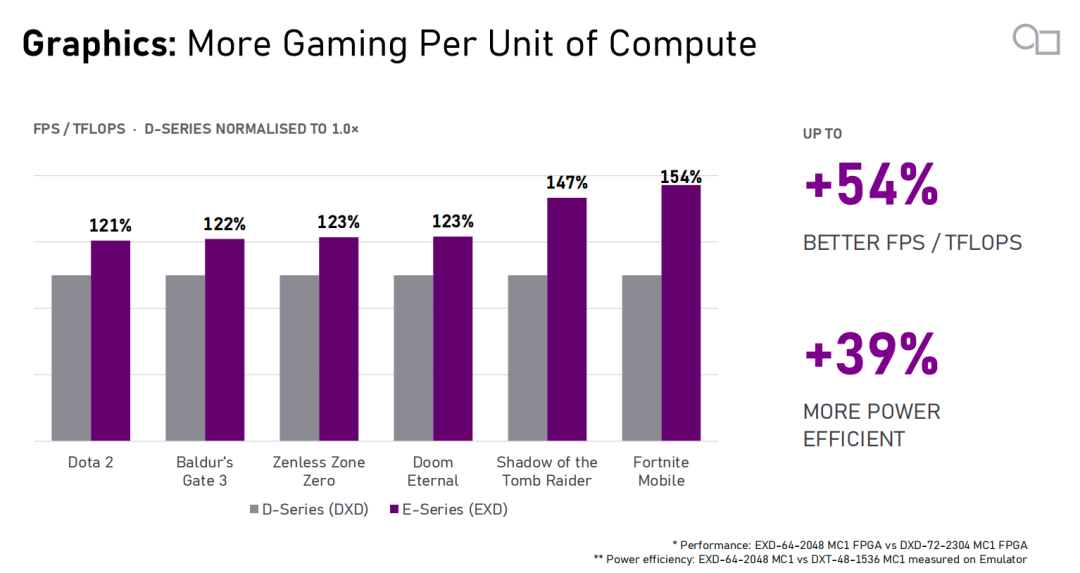
E 系列也在明显向更高性能的图形市场扩张。按照 Imagination 公布的数据,四核 E 系列运行《博德之门3》时可以超过 60fps,《古墓丽影:暗影》《毁灭战士:永恒》等 PC 游戏也已完成展示。相比上一代 D 系列,其每 TFLOPS 对应的帧率最高提升 54%,能效最高改善 39%。这一提升的核心之一,同样是减少无效的数据移动和提高计算资源利用率。
E 系列里集成了 Imagination 自研的高性能 RISC-V 固件处理器,在 GPU 架构上把图形和计算工作并行调度。底层最多支持 4 核、16 台虚拟机,带高质量服务、工作负载优先级和内存隔离,云游戏、云桌面这类场景都能撑住。
从神经渲染走向端侧大模型,全栈AI推理优化
图形只是第一步。从神经渲染继续向前,E 系列瞄准的是更广泛的端侧 AI,并重点强化了两类基础计算:矩阵乘法和卷积。
Jake 表示:"如果矩阵乘法代表推理和思考,那么卷积就是感知。"
E 系列矩阵乘法性能最高提升 4.8 倍,卷积性能最高提升 4.4 倍,分别对应语言模型和视觉感知等不同 AI 工作负载。
到了大语言模型,Imagination 将 LLM 推理拆成两个阶段:prefill(预填充,就是"问")和 decode(解码,就是"答")。从工作负载复杂度和用户体验看,最难、最重要的是 prefill——要在尽量短的时间里给大模型处理海量数据,衡量指标是 time to first token(TTFT),也就是处理器听懂你的问题、开始吐第一个 token 要多久。E 系列把 prefill 性能提升了 4.7 倍,这对好几个场景都很关键:手机上让大模型做摘要,你希望几乎秒回;车或者机器人看到数据,必须以足够高的帧率处理图像。
Decode 阶段(每秒多少 token)则取决于系统带宽,也就是片上内存给的带宽,每个 token 都要搬数据、重载权重。我们在工具和软件上投入,帮客户把模型量化到低位宽还保住精度。但要说清楚,AI 不只是看 TOPS——系统带宽受限时,更多 TOPS 解决不了系统问题。E 系列的目标,是把开发者需要的算力给足,让系统集成商能专心去做他们终端产品的整套系统。
实际测试中,车机行程规划可实现约 0.2 秒 TTFT、150 tokens/s;智能眼镜环境描述约 0.25 秒、153 tokens/s;邮件解读和摘要约 0.86 秒、126 tokens/s。对于轻量化端侧模型而言,首 Token 时间已经可以压到 1 秒以内。
这种能力在 Agentic AI 时代尤为重要。现场 Demo 通过 Llama.cpp 连接 OpenCode 智能体框架,模型在输出第一个 Token 之前,需要先完成工具调用、数据收集和推理。对于代码 Agent 等长上下文场景,文件越多、工具调用越复杂,对 Prefill 性能的要求也越高。与此同时,端侧运行还能降低云端调用成本,并减少代码、数据等敏感信息离开设备的风险。
除了算力,E 系列也在数据精度上进一步向 AI 靠拢,支持 BF16、mxFP8、mxFP4 等格式。不同场景可以在精度、带宽和模型容量之间进行取舍:自动驾驶等场景更强调高精度,而消费级边缘设备受内存和带宽限制,更低精度的数据格式则有助于降低资源占用。
从矩阵计算、卷积,到 Prefill、Decode,再到数据精度和软件栈,Imagination 试图做的并不是单纯给 GPU 增加 AI 算力,而是围绕端侧 AI 推理进行一整套系统级优化。
统一软件栈的重要性
对于 GPU 而言,硬件性能只是基础,真正决定能力能否落地的,很大一部分还在软件。
Imagination 在图形侧支持 DirectX 12、OpenCL、Vulkan,可运行于 Linux、Android 和 Windows;AI 与计算侧则进一步支持 ONNX、PyTorch,并持续向 Llama.cpp 等开源项目贡献优化。同时,公司还提供自有计算库、开发工具和分析器,帮助开发者完成从开发、优化到部署的完整流程。
Jake 特别强调,E 系列始终构建在统一的软件栈上。客户针对某一代 GPU 所做的软件优化,不会因 GPU 产品换代而付诸东流,而是能够一代一代、持续沿用。
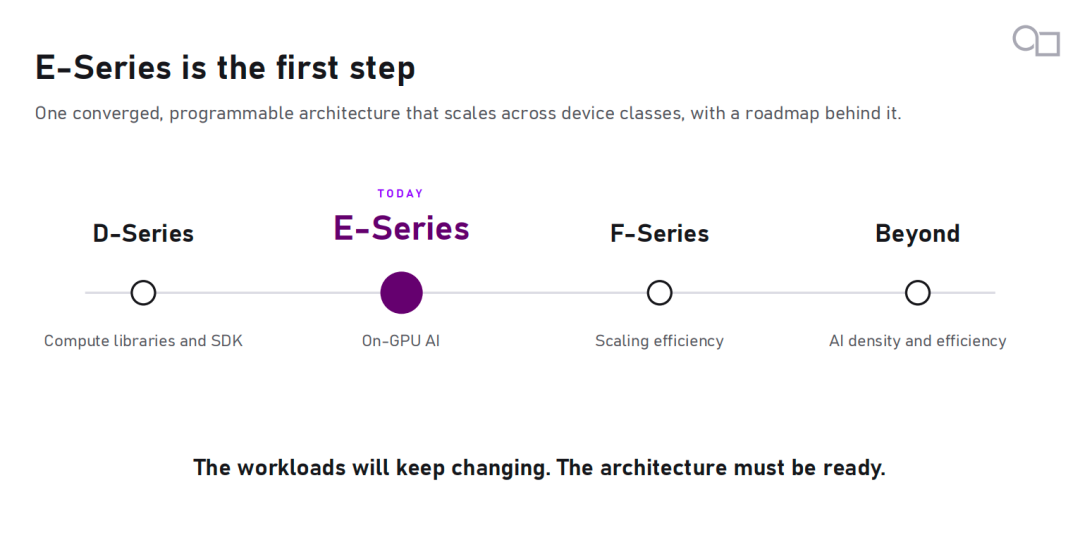
E 系列也只是第一步。Imagination 给出的路线图是:D 系列开始构建计算库和 SDK;E 系列正式把 AI 计算引入 GPU;下一代 F 系列继续提升规模扩展效率;再往后的产品,则进一步提高 AI 计算密度和能效。
中国市场:从重要客户市场走向共同创新
近期,Imagination 完成中国区管理团队调整,任命谢巍出任执行副总裁兼中国区总经理,宣雄文出任中国区销售副总裁,并继续强化北京、上海、深圳等地的客户支持和销售网络。
这一调整背后,也与中国市场对 GPU 能力提出的更高要求有关。Jake Kochnowicz 在媒体问答中表示,相比部分海外市场更侧重汽车等深度嵌入式应用,中国客户对于更高性能、更完整功能集以及图形与计算融合能力的需求更加突出,而且往往出现得更早。"中国对图形和计算的需求非常强,现在跟中国客户的互动,正在帮助我们创新,把 GPU IP 的能力边界继续往前推。"
从业务进展来看,Imagination 也在进一步加码中国市场。Markus Mosen 透露,公司今年已经获得国内重要战略客户的授权;未来还希望与中国客户建立更紧密的合作关系,包括探索联合实验室等模式。不过现阶段的重点,仍是持续加强研发和本地支持,把更先进的 GPU IP 带给中国客户。
谢巍则表示:"中国一直是 Imagination 非常核心的战略市场,中国的开发生态和出货量这几年都在飞速发展。"并透露确认今年中国桌面级市场相关出货正在接近百万台量级。
在他看来,下一阶段的机会也不仅限于桌面 GPU。随着 AI 智能体和边缘 AI 发展,E 系列 GPU IP 将面向汽车、边缘计算、具身智能机器人等场景。Imagination 希望通过更深入的客户走访、更完善的本地技术支持和开放的软件生态,把中国市场的需求更快反馈到产品和技术路线中。
中国对于 Imagination 的价值正在发生变化:不仅是一个规模庞大的 GPU 市场,也开始成为高性能 GPU 需求、AI 应用创新以及产品路线演进的重要推动力。
写在最后
回顾芯片发展史,计算架构一直在"专用化"和"通用化"之间摆动。早期 PC 时代,大量 2D、视频等专用功能最终被更可编程的 GPU 逐步吸收。今天,边缘 AI 似乎又来到类似节点。
E 系列的意义,就在于尝试把一部分 AI 计算重新收拢到 GPU 内部,让图形、计算和 AI 共享更统一的数据路径和软件基础,从而降低那笔"边境税"。
这不意味着 GPU 会取代 CPU 或 NPU。AI 系统设计没有唯一正确的答案,而 Imagination 认为,E 系列在所有方案中都能胜任:可以采用 GPU-only,也可以采用 GPU+NPU、NPU+GPU,或者两者相对均衡的架构。但随着神经渲染、端侧大模型和 Agentic AI 不断进入终端,几类处理器之间原本清晰的边界正在变得越来越模糊。
E 系列并不只是 Imagination 的一次 GPU 升级,更代表了它对未来端侧 AI 架构方向的一次押注。
 发表于 1 小时前
|
查看: 3|
回复: 0


