一千多亿参数的大模型,能不能跑在你自己那台游戏电脑上?之前我的判断很直接:这种体量的模型,要么租云、要么上服务器,个人电脑基本没戏。直到看到 Strata 这个项目——它把 1250 亿参数的模型 塞进了一块 12GB 显存的消费级显卡里。
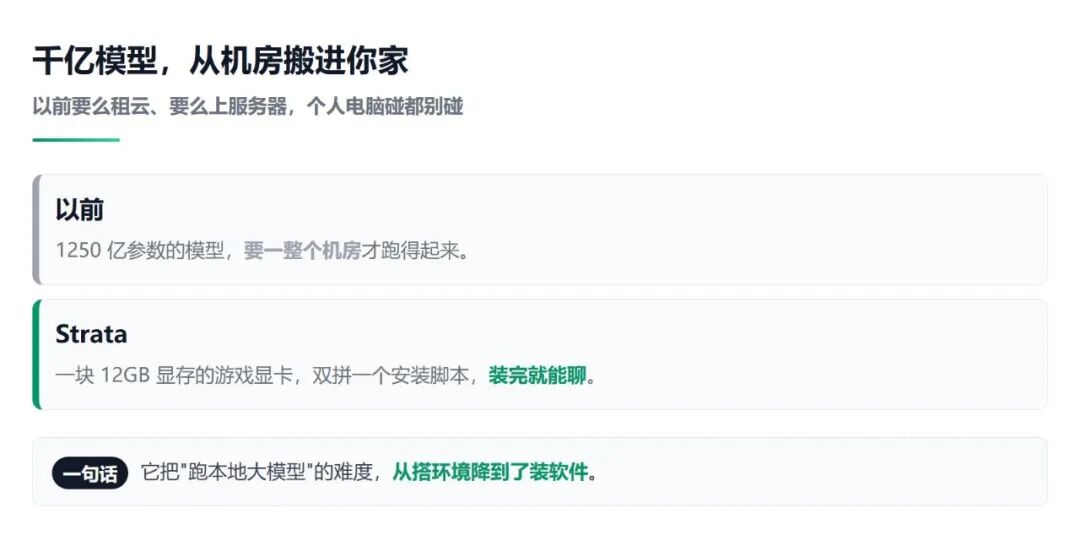
它是 C++ 写的,MIT 协议。官方演示片里那句提示词,在 RTX 5070 上生成了一个体素风格的宝塔庭院。能把千亿模型塞进普通电脑,靠的是把整套东西打包成了安装包。“在本地跑大模型”这件事,它想从折腾变成安装。
01 它跑的是哪个模型
跑的是阿里开源的 Qwen3.8-Flash-Next,官方标“flash”,就是往快和轻里做的那种。
有意思的是它的做法:同一个模型提供好几个压缩档位。压得越狠越快,压得越松越聪明,怎么选你自己挑。
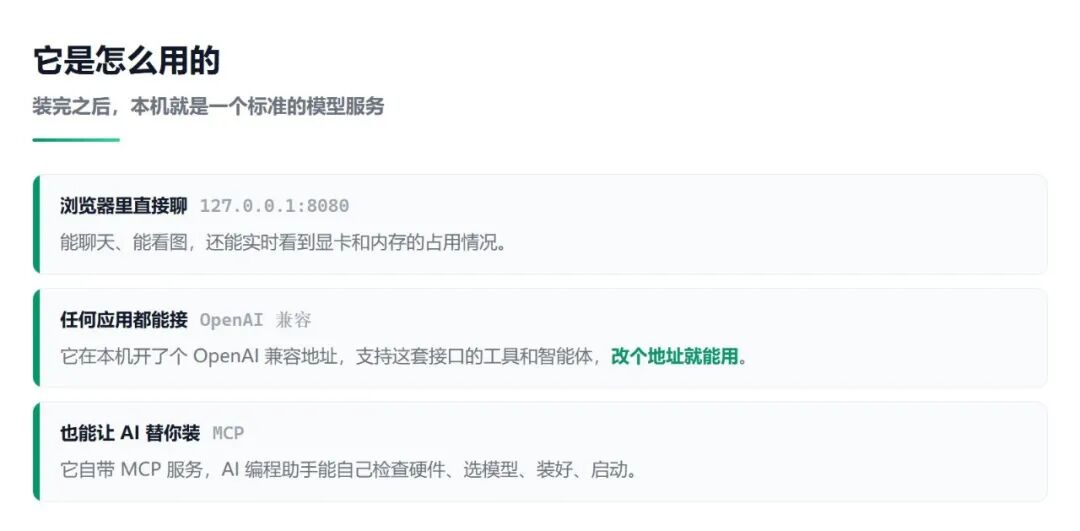
- 装完就用,不折腾环境:Windows 双击一个 bat,Linux 跑一个脚本。安装器自己认你的显卡,选好引擎和档位,然后开始下载。
- 浏览器里就是界面,开箱能聊:装完浏览器自动打开本地地址,能聊天、能看图,还能实时看到显卡和内存占用。
- 对外是个标准接口,什么都能接:它在本机开了个 OpenAI 兼容 的地址,任何支持这套接口的应用和编程工具,改个地址就能用。
02 到底快到什么程度
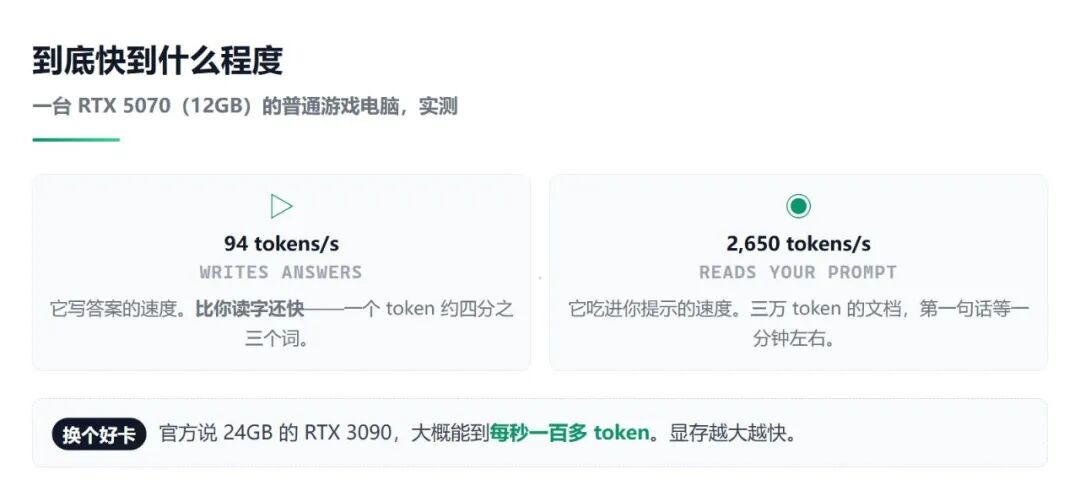
看到速度表的时候,说实话有点意外。测试用的是两台挺普通的游戏电脑,一台 NVIDIA、一台 AMD。
- 输出速度,快过你阅读:低压缩档位下每秒 94 个 token。一个 token 差不多四分之三个词,也就是说它写字比你读字快。
- 读取速度,长文档不卡:丢给它一份三万 token 的代码或文档,它吃进去能到每秒两千多 token,第一句话等一分钟左右。
- 换个更好的卡,还能翻倍:官方说 24GB 的 RTX 3090 大概能到每秒一百多 token。
03 对比一下
- 对云端 API:数据不出门。你说的话、贴的代码、传的图,全程在本机。断网也能用。
- 对 Ollama 这类本地工具:专为一个大模型调。通用工具什么模型都装着跑,它只伺候这一个千亿模型,所以能把压缩、显存、速度整套专门调透。
- 对“自己编译量化”:复杂度收进安装器。卡怎么选、档位怎么挑、上下文开多大,它一路问你,按回车就行,不用啃参数。
落到一句话:它把“跑本地大模型”的难度,从搭环境降到了装软件。
04 门槛在哪
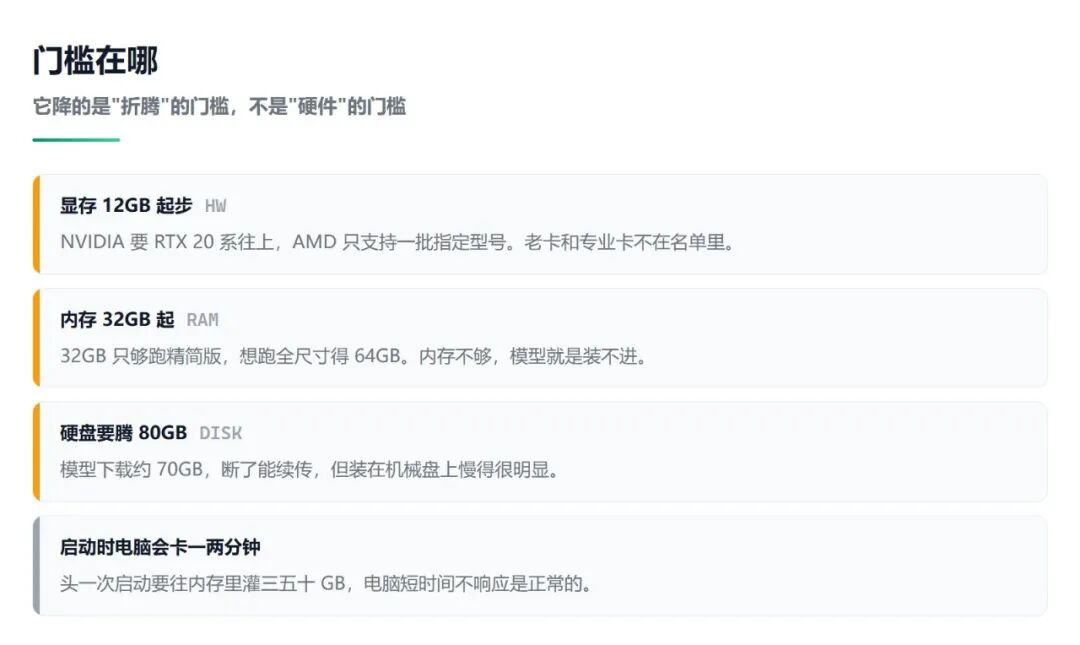
- 显存 12GB 起步,卡有讲究。NVIDIA 要 RTX 20 系往上,AMD 只支持一批指定型号。老卡和一些专业卡不在名单里。
- 内存 32GB 起,直接决定你能跑哪档。32GB 只够跑精简版,想跑全尺寸得 64GB。内存不够,模型就是装不进。
- 硬盘要腾 80GB,最好在固态上。模型下载大概 70GB,断了能续传,但装在机械盘上慢得很明显。
- 启动时电脑会卡,心里要有数。头一次启动要往内存里灌三五十 GB,电脑可能有一到三分钟不太响应,这是正常的。
还有个小遗憾:AMD 的看图功能在 Linux 上能通过处理器跑,Windows 上暂时不行。
说到底,它降的是“折腾”的门槛,不是“硬件”的门槛。手上没有一张 12GB 以上的卡,它帮不了你。
05 为什么值得关注
“在本地跑模型”这件事,价值不只是省钱。它真正的价值是:你不用再决定哪些数据可以给别人。以前你得在“好用”和“放心”之间选,现在这两个可以不冲突。
它的产品思路也挺有意思。市面上不少本地方案走的是极客路线——自己编译、自己调参、自己排错。Strata 反过来了,把这些复杂全收进了一个安装器。
一个千亿模型,装完就能用,速度还比你读字快,数据一步不出门。搁两年前这是实验室的事。
项目 9 月下旬才建库,十几天涨到六千多星,MIT 协议,用的是阿里的开源模型,商用没有额外门槛。
这类能让硬件门槛往下掉的项目,确实值得记录。要是你也有台带独显的机器,不妨试试。 |  发表于 16 小时前
|
查看: 9|
回复: 0


