在 Kubernetes 上搭过 AI 训练平台的人,大概都经历过这个难受劲:配额排队要装 Kueue,分布式训练要上 KubeRay,GPU 健康检测又要 Node Problem Detector 和 DCGM,监控还得铺一套 Prometheus。单个组件装起来并不难,难的是把它们揉成一套能协同工作的统一平台。中间还横着一堆自研胶水代码:提交脚本、队列封装、健康检查、结果拉取,每一样都得自己写,各种边界异常也要小心翼翼处理。
于是,一个只想跑训练任务的研究员,不仅要啃 Kubernetes,还得被迫学习一大堆生态项目;真出了问题,常常连从哪儿查起都没头绪。
TauGrid 就是想把这一堆组件收拢起来,并且整套系统完全开源。它把几类核心能力收进一套 Kubernetes 原生栈:tau CLI、Kueue 队列、KubeRay 编排、GPU 健康监控与可观测性,再加上面向平台团队和研究员的 Web Portal。从数据准备、模型训练到推理服务,一整套 AI Stack 都可以统一管理。
过去这些组件要一个个搭,集成逻辑也得自己维护;现在,一条 tau 命令就能搞定。平台团队有了统一入口,研究员则只需要一个 CLI:提交任务、查看进度、从失败中恢复、拉回结果,不用再直接碰 Kubernetes 和一堆内部组件。
TauGrid 是什么
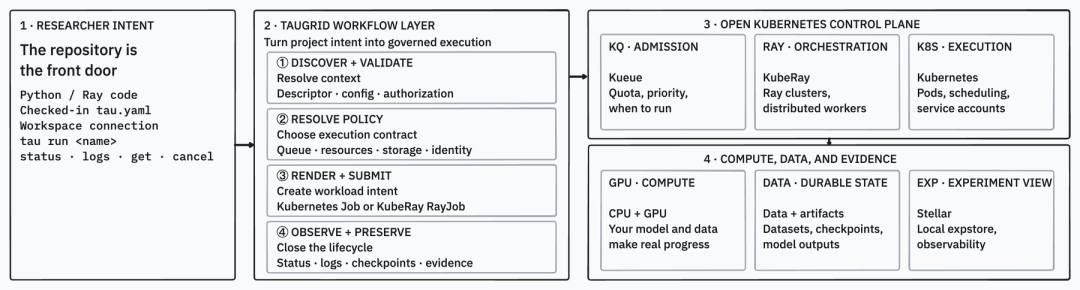
简单说,TauGrid 把托管 AI 平台该有的能力搬到你自己的集群里。任务提交、分布式计算、GPU 共享、实验追踪、运维管控,都在同一个平台完成。TauGrid 是完全开源的,你可以自托管,也可以部署到自己管理的云或数据中心。
它让研究员和平台团队各管各的:研究员从代码仓库和 tau CLI 出发,平台团队负责配置工作区、队列、GPU 资源、存储、身份和可观测性。TauGrid 负责把底层组件和配置串起来,训练、微调、批量推理、模型服务都能覆盖。
有了 TauGrid,平台团队不用再维护开头那多套系统,研究员的上手门槛也会低很多。
工作原理
只需要一个 tau.yaml,就可以把工作负载描述清楚。下面这个例子是在单张 A100 上跑 PyTorch 训练:
schema_version: 1
name: aks-gpu-quickstart

run:
  entrypoint: train.py
  workload_kind: rayjob

compute:
  gpus: 1
  workers: 1
  cpus: 16
  memory: 64Gi

runtime:
  image: mcr.microsoft.com/aks/ai-runtime/ray:py3.12-ray2.56.0-cuda13.0
  pip:
    - torch>=2.4.0
有了配置之后,执行 tau run 提交任务。它会先解析平台策略,渲染成 KubeRay 的 RayJob,再交给 Kueue 排队。整个过程里,TauGrid 会一直盯着状态、日志、checkpoint 和 evidence。evidence record 会把元数据、配置、日志、指标、checkpoint、执行历史全部保存到持久化存储中,后续的复现、排查、审计也就有了充分的数据依据。
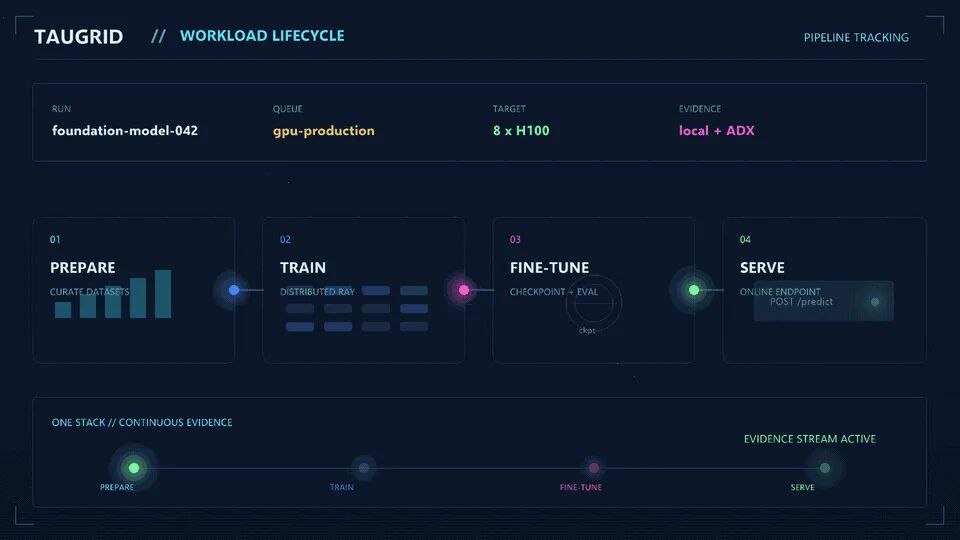
这一整套覆盖了 GPU 工作负载从头到尾的生命周期。下面这个动画是一个工作负载从数据准备到分布式训练、微调,再到推理端点就绪的全过程,整个过程只保留一份记录:
每个阶段 TauGrid 具体做什么,一张表说清楚:
| 阶段 |
TauGrid 做的事 |
| 提交 |
校验配置,渲染成 Kubernetes Job 或 KubeRay RayJob |
| 排队 |
通过 Kueue 管理配额准入和优先级 |
| 执行 |
在 Kubernetes 上启动和管理分布式 Ray 工作负载 |
| 监控 |
全程跟踪状态、日志和 GPU 健康指标 |
| 恢复 |
支持重试、从 checkpoint 恢复和故障诊断 |
| Evidence |
保留工作负载历史、指标和产物,保证可复现 |
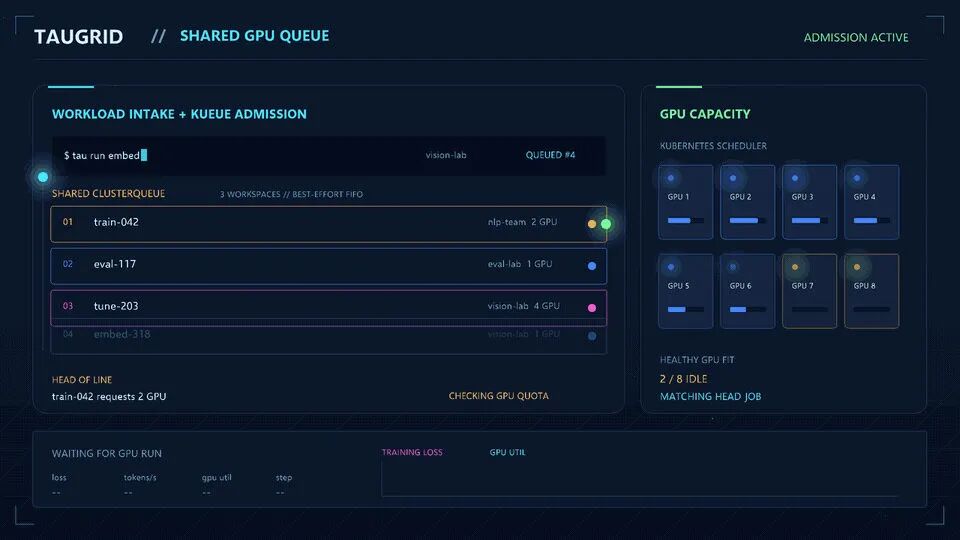
多个团队共用一个集群的时候,各自的工作负载进同一个 Kueue ClusterQueue。Kueue 按配额和优先级决定谁先运行,Kubernetes 再把任务放到健康的 GPU 上。
有一点需要说明的是:TauGrid 会一直聚焦在 AI 训练工作流和工作负载生命周期这一层。集群创建、Pod 调度、配额管控这些 Kubernetes 和 Kueue 已经做好的事,还有框架内部实现和模型代码,仍然使用大家熟悉的开源生态项目来实现。
快速上手
你需要一个 Kubernetes 1.30 以上的集群,外加 kubectl、Helm 3 和 Git。先安装 Tau CLI:
curl -fsSL https://github.com/Azure/taugrid/releases/latest/download/install.sh | sh
export PATH="$HOME/.local/bin:$PATH"
tau version --short
把 TauGrid 安装到集群上:
tau cluster install
tau cluster validate installation
创建一个工作区,并等待它 Ready:
tau workspace create "taugrid-default" --apply

kubectl wait \
  --for=jsonpath='{.status.phase}'=Ready \
  workspaces.tau.azure.com/taugrid-default \
  --namespace tau-system \
  --timeout=5m
运行第一个工作负载:
git clone https://github.com/Azure/taugrid.git
cd taugrid
tau run --config examples/cpu-multi-interest-ray/tau.yaml
tau run status cpu-multi-interest-ray --watch
tau run logs cpu-multi-interest-ray -f
这个例子跑的是 CPU 任务,不需要 GPU 节点。集群准备、工作区配置、GPU 任务以及交接给研究员的一整套分步指南,都在 Getting Started on Kubernetes 里。
仓库里还有几个可以直接跑的例子:
| 示例 |
演示内容 |
| CPU 队列 |
Kueue 准入、pending 状态和团队间借用,不需要 GPU |
| GPU Ray Tune |
单 GPU 上的超参搜索,带确定性验证 |
| 实验 evidence |
持久化指标、Stellar 可视化和 evidence 验证 |
| 完整集群 |
Terraform 创建的 AKS 集群,带 GPU 节点,端到端验证 |
更多示例和详细演练都在仓库的 examples 里。
后续规划
TauGrid 现在还在快速迭代,完整的 roadmap 都放在仓库里。大方向有这么几个:
多租户这块,后续会支持多个工作区,按工作区隔离的身份、权限和配额,再加一个交互式门户,可以直接在上面提交和管理工作负载。
分布式训练这块,会补上 PyTorch DDP、FSDP、DeepSpeed 和 Hugging Face LoRA/QLoRA 的端到端示例,再加上完整的数据集生命周期:获取、暂存、校验、分词、注册。
推理方面,vLLM、SGLang、TensorRT-LLM 的服务示例都会补上。多集群和多云这块,支持跨云执行工作负载,数据、checkpoint 和产物可移植,再加上不锁定云厂商的可观测性和成本归因。
下一步
TauGrid 刚开源,要做的事还很多。我们想在开放环境下把它做好,你的反馈对我们很重要。欢迎安装尝试,遇到任何问题都可以提 issue,更欢迎提 PR 一起增强完善这个项目;觉得哪里设计得不对,也请直接告诉我们。
相关链接:
如果你也在做 AI Infra 相关的工作,欢迎到 云栈社区 一起交流分享,把踩过的坑和实战经验沉淀下来。
 发表于 1 小时前
|
查看: 6|
回复: 0


