来源:量子位(QbitAI)
DeepSeek 的“神鬼二象性”,被字节 Seed 团队逮住了。
同一道题,别的都不改,只是在前面多塞几个无关紧要的字符,模型突然就不会了?
而且也不是偶尔抽风。
Seed 的研究人员发现,DeepSeek-V4 的表现会随着信息出现的位置变化,每隔 4 个 Token 周期性波动。
这是什么意思?模型能不能记住一件事,还得看这件事站在输入里的哪个位置?
前面多两个 Token,答案可能从错变对;再多两个,又给你改回去。好家伙,模型答题也开始讲究站位了。
在 128K 长上下文检索测试里,研究人员发现,同一条信息只是换了个位置,DeepSeek-V4 系列模型的检索准确率最高能拉开 40.2 个百分点。
团队进一步发现,这个问题与 DeepSeek-V4 采用的一项长上下文优化技术有关——分块KV Cache压缩。
这项技术本意是让模型处理长文本时更省内存、更高效,没想到压缩之后,反而让模型开始“时神时鬼”。
多两个Token,DeepSeek突然就答对了
字节 Seed 研究人员最初拿 DeepSeek 自己的代码做了个实验,测试对象是 DeepSeek-V4-Flash-Base。
他们从 DeepSeek-V4 官方推理代码里截取了一段 FP8 量化函数,让模型补全最后一个 Token。任务的正确回答应该是 8,因为这段代码需要完成 FP8 相关的类型转换。但模型常常觉得该补 32。
为了弄明白到底怎么回事,研究人员在代码前面加了一段装饰性文档字符串,里面放了些重复的等号,然后开始调整等号数量。
代码没改、补全位置没改、正确答案也没变,唯一变化的,就是前面多了几个没什么实际意义的 Token。结果,DeepSeek 的答案开始来回横跳。
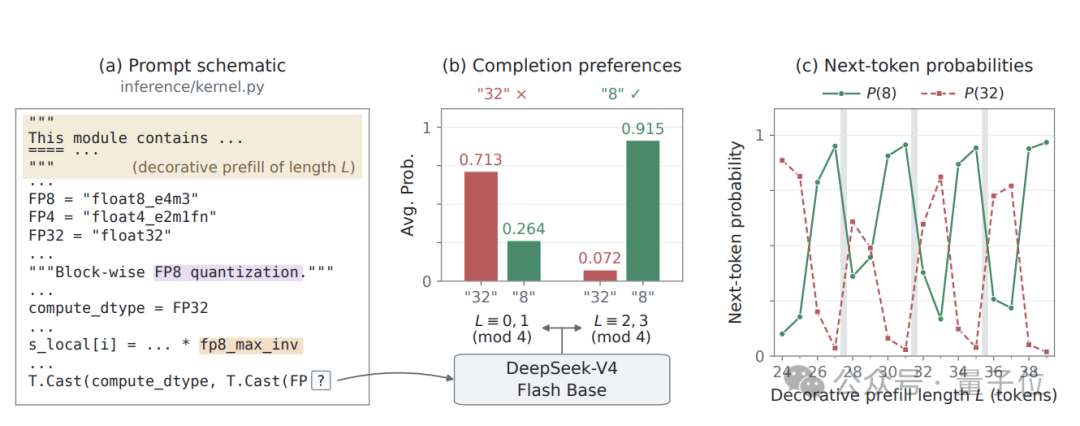
当填充长度落入某些位置时,模型更倾向于回答错误的 32;往前挪一两个 Token,又倾向于正确的 8;再继续挪,错误答案又回来了。
整个过程以 4 个 Token 为周期重复。更具体地说,在论文测试的 16 种填充长度中,当长度模 4 的余数为 0 或 1 时,模型偏向错误的 32;余数为 2 或 3 时,则偏向正确的 8。
研究人员还统计了模型给两个候选答案分配的概率:在一组位置上,错误答案 32 的平均概率达到 71.3%,正确答案 8 只有 26.4%;换到另一组位置,情况直接反过来——正确答案 8 的平均概率升到 91.5%,错误答案 32 只剩 7.2%。
也就是说,前面几个无关字符的长度变化,足以让模型对同一道题产生截然不同的判断。这就有点难评了。
程序员调试代码,通常先看逻辑、变量和依赖。现在看来,可能还得顺手检查一下,前面是不是多打了两个等号。
单个代码补全案例还不够有说服力。于是 Seed 团队继续扩大测试,盯上了大模型长上下文能力里很经典的“大海捞针”任务。
他们构造了一段长达 128K Token 的上下文,里面放了大约 1.6 万个键值对,比如 K1 对应 V1、K2 对应 V2……然后让模型从中找出指定 Key 对应的 Value。
测试过程中,键值关系不变、问题不变、上下文总长度也保持一致,研究人员重点调整的是目标信息相对于压缩窗口边界的位置。
结果发现,DeepSeek-V4 系列的准确率曲线呈现出非常明显的周期性起伏。
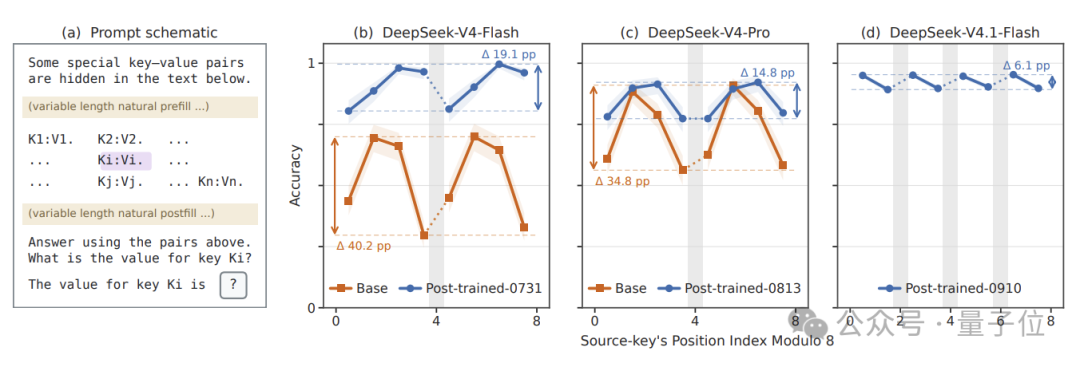
其中 DeepSeek-V4-Flash-Base 在不同位置之间的最大准确率差距达到 40.2 个百分点,DeepSeek-V4-Pro-Base 也达到 34.8 个百分点。
经过后训练后,情况有所改善:DeepSeek-V4-Flash-0731 的差距缩小到 19.1 个百分点,DeepSeek-V4-Pro-0813 缩小到 14.8 个百分点;更新的 DeepSeek-V4.1-Flash-0910 进一步降到 6.1 个百分点。但周期性差异依然存在。
再看具体数字:DeepSeek-V4 的波动周期是 4 个 Token,DeepSeek-V4.1 则变成 2 个 Token。研究人员发现,这恰好对应两代模型各自采用的 KV Cache 压缩步长。
好嘛,连答题表现的起伏周期,都和底层压缩配置对上了。
问题出在KV Cache压缩?
那我们就来说说 KV Cache 压缩。
大模型处理长上下文时,需要保存大量历史 Token 对应的 Key 和 Value 信息,供后续注意力计算使用。上下文越长,这部分缓存占用的内存和计算开销就越大。尤其在动辄几十万、上百万 Token 的长任务里,KV Cache 很容易成为推理效率的瓶颈。
所以 DeepSeek-V4 采用了分块 KV Cache 压缩:思路是把连续 Token 分成一个个窗口,再把窗口内的信息压缩成更少的缓存条目。这样模型就不用为每个历史 Token 保留同样规模的缓存,既省内存,也能降低长上下文注意力计算的成本。
但 Seed 团队发现,DeepSeek 这种“神鬼二象性”的根源,很可能就藏在这个分块过程里。
假设每 4 个 Token 构成一个压缩步长,那么同一条信息出现在窗口里的第 1、第 2、第 3 或第 4 个位置时,压缩时所处的条件就可能不同。论文把这种相对于压缩窗口边界的位置称为 Phase(相位)。
研究人员发现,模型对不同相位的信息,检索能力存在系统性差异。他们把这种现象命名为 Phase Sensitivity,即相位敏感性。
打个比方,同样一份资料交给模型:第一种排版,关键数字恰好落在模型容易保留的位置;第二种排版,只是在前面多加几个字,关键数字相对于压缩窗口的位置变了。资料还是那份资料,但模型之后能不能把它找出来,可能就有明显差别。
更关键的是,这种问题不能简单归结为“信息刚好被切在两个窗口之间”。研究人员发现,即使 Key 和 Value 落在同一个压缩窗口里,不同位置的检索准确率也能相差很大。这说明问题还涉及模型如何把信息写入压缩缓存,以及之后如何从缓存中读取。
为了进一步确认,Seed 团队干脆自己从头训练了一批模型。他们以 Qwen3-0.6B 架构为基础,构造了多种 KV Cache 压缩方案,并设置没有分块压缩的全注意力模型作为对照,重点只改变压缩机制,看看周期性波动会不会跟着出现。
结果,所有接受测试的分块压缩模型,都出现了与压缩步长对应的周期性变化;反过来,全注意力基线模型没有出现同等程度的周期性。
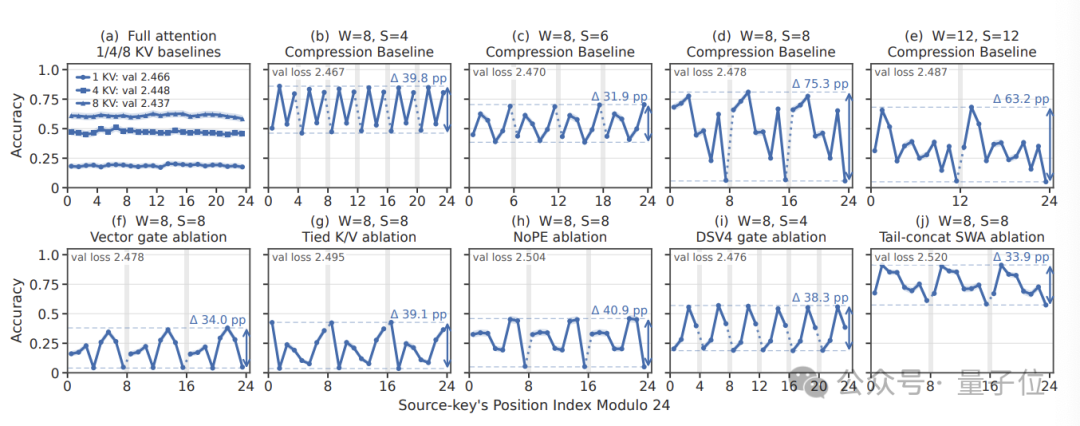
研究人员还分别调整了窗口大小和压缩步长,发现周期主要跟着压缩步长变化:步长为 4,表现就以约 4 个 Token 为周期起伏;步长为 6,周期也跟着变成约 6 个 Token;步长为 8,同样如此。
甚至不使用 RoPE 位置编码,或者把可学习的压缩权重换成简单平均,这种现象依然存在。也就是说,问题并不是某个位置编码或某个特殊模块单独造成的——分块压缩这种设计本身,就可能引入周期性的检索弱点。
Seed 团队进一步对注意力头进行干预,观察移除不同组件后,模型在各个相位上的检索能力如何变化。结果发现,不同注意力头对不同相位的贡献并不一样。
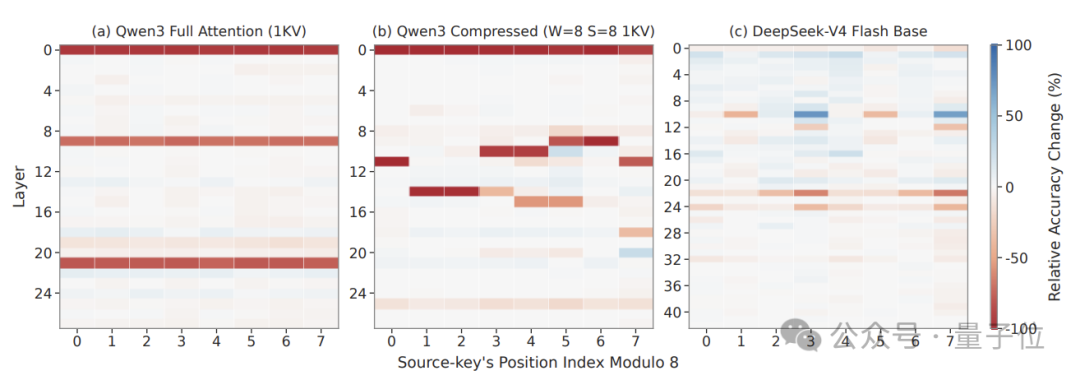
有些头更擅长处理某些位置的信息,另一些头则在其他位置上发挥更大作用。研究人员将其称为 Phase Specialization,即相位专门化。
也就是说,模型内部似乎形成了一种分工:不同注意力组件,对压缩窗口里的不同位置产生了偏好。
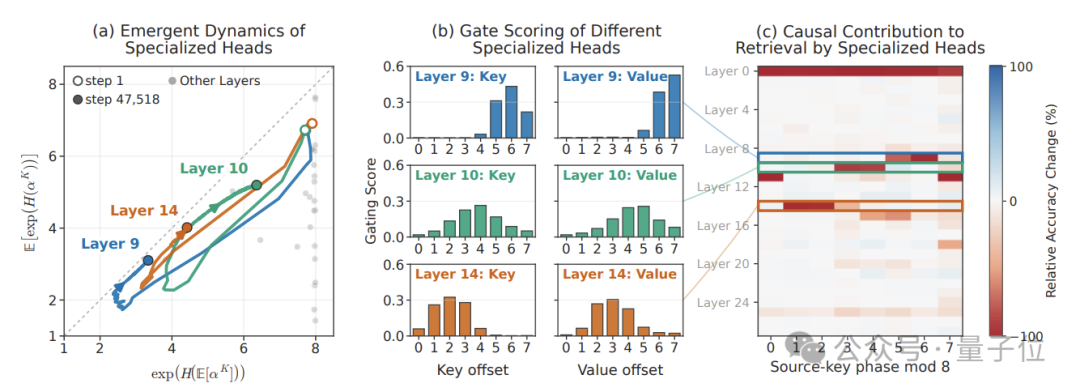
这种分工可以帮助模型完成信息检索,却也可能让某些位置成为相对薄弱的环节。
论文还通过简化理论模型分析了训练过程,发现梯度流可能推动压缩模块形成稳定的位置偏好。这也解释了为什么这种周期性并不是简单的随机噪声,而可能是模型在学习如何压缩信息时,自然而然形成的结果。
不过,这类问题未必能从普通 Benchmark 里直接看出来,因为常规评测通常会把大量测试结果汇总成一个平均分。假设模型在某些位置表现很好,在另一些位置明显掉队,最后算出来的平均成绩可能依然不错。
所以 Seed 团队提出,评估采用分块 KV Cache压缩 的模型时,不能只看整体检索准确率,还得把同一条信息放到不同压缩相位上分别测一遍。
可即便存在这种由位置带来的性能偏差,长上下文推理的内存和计算成本毕竟摆在那里,压缩仍然有很现实的价值。只是节省缓存之后,模型对不同位置的信息,可能不再一视同仁。
当然,从这次的实验结果看,后训练和架构迭代确实能明显缩小这种差距。
论文地址:https://arxiv.org/pdf/2609.36322
 发表于 2 小时前
|
查看: 4|
回复: 0


