就在国庆节前一天,DeepSeek 按“惯例”做了一次节前发布,开源了面向华为昇腾算力平台的基础设施组件,重点就是 TileLang。它原本主要适配 Nvidia GPU,相当于 CUDA 的高级语言,现在可以适配华为的 Ascend NPU 了。
DeepSeek 特别提到了一点:“此次开源的所有组件与此前面向英伟达平台的开源组件一一对应”。这句话说明这个项目是生产级别的,不是简单的 Demo,而且可能是近乎完美的实现。更具体一点来说,DeepSeek 目前在训练中用到的每一个 TileLang 算子,在昇腾上都有对应的高性能实现。
这次开源的行业意义很明显:TileLang 将成为 CUDA 更强劲的竞争对手。当然,这里说的不再仅是易用性方面——开发者现在甚至可以在用 TileLang 给 GPU 编程的背景下,轻松地从 GPU 迁移到 Ascend。这对于大模型的国产化适配无疑是一大利器。
所以虽然在大众间反响一般,但仍有行内人称这次发布的意义“和 DeepSeek R1 相当”。
这个领域非常小众,但知危还是想用比较朴素的语言,来科普一下这个领域的一些基础知识,帮助大家更好地理解 TileLang 的核心作用和开源事件本身。
首先,一个自然的问题是:TileLang 为什么能够同时支持 NVIDIA GPU、AMD GPU、Apple 芯片上的 GPU,以及华为昇腾 NPU?
因为它将 AI 的底层计算中通用又足够高级的那一层,也就是 Tile,给抽象了出来。
那 Tile 又是什么呢?
它其实是大模型背后核心训练机制——深度学习中最重要、也最密集的计算步骤,也就是矩阵乘法的核心构成。
矩阵乘法这个东西相信学理工科的朋友们都比较熟悉,简单来表达就是:$C = A \times B$,也就是用 A 的每一行和 B 的每一列做点积,来算出 C 的每一个元素。
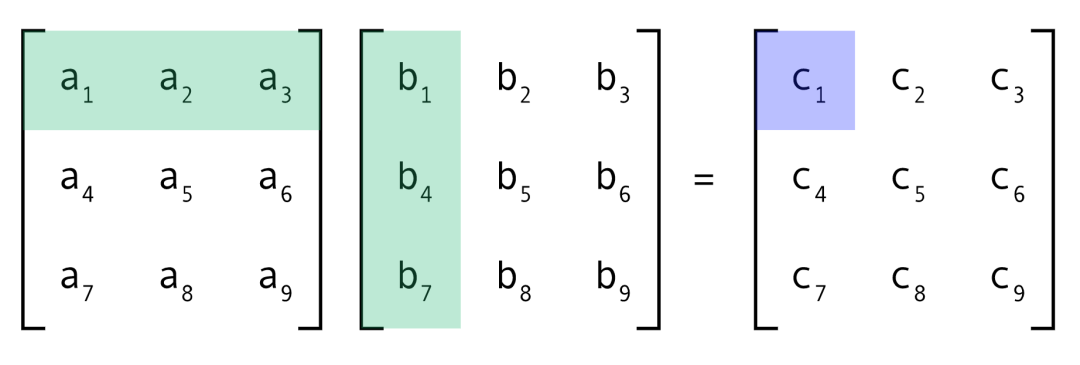
对于非理工科的朋友们,矩阵概念可能看起来很抽象,我们简单解释一下:在其相乘过程中,实际上是做加权求和,把元素之间的关系串联或者说具象出来。
在实际运用中,举个不严谨但好理解的例子:大模型预测下一个字的过程,本质上就是矩阵乘法。比如输入“今天干了好多活,所以我晚上好…”,这句话会先被拆成一个个字(token),每个字对应一个向量,整句话就是一串向量组成的矩阵。模型经过内部层层计算后,会得到一个代表当前语境的向量,用它与输出权重矩阵相乘,每个候选字都会得到一个分数:可能是“吃”、“冷”、“热”、“累”等等。分数经过归一化就变成了概率,结合上下文,“累”字的概率最高,于是模型选择输出“累”。
总之,大量的矩阵运算,给模型注入了灵魂。但是如果我们直接用 GPU 中容量大但访问速度最慢的全局内存来算,会造成极大算力浪费。
比如一位名为 Simon Boehm 的开发者曾在他的博客《How to Optimize a CUDA Matmul Kernel for cuBLAS-like Performance: a Worklog》里写道,用 Nvidia A6000 芯片来计算 4092 维的方形矩阵的相乘(如此大的矩阵在大模型中也很常见),如果用全局内存来传输数据,吞吐量只能达到峰值约 1%,也就是需要 100 倍的计算时长,这种浪费肯定是无法被接受的。
所以,很自然地,矩阵乘法需要加速。接下来的部分文字可能存在理解困难的情况,但不理解也没关系,划到红字部分即可大概理解 TileLang 的意义。
关键就在于如何拆分矩阵。具体来说,需要把矩阵拆分出来的小数据块放到更快的存储介质(通常容量也会更小,因为成本更高)中,并尽可能让它不与其它小数据块存在依赖关系。小数据块内部计算有大量复用,因为复用时访问的是更快的存储介质,所以能节省大量访问时间。
在矩阵乘法中,每一个元素都是要多次复用的,比如 A 的每一行都要和 B 的每一列相乘一次。如果 A 的行和 B 的列维度过高,还要进一步做拆分。
但矩阵乘法还有另一种相对更直观的拆解方式,就是基于外积。比如用 A 的每一列和 B 的每一行进行外积,分别得到一个子矩阵,再累加这些子矩阵,结果是一样的,但 A 的每一列或 B 的每一行都只需要使用一次。
比如下方这个例子:
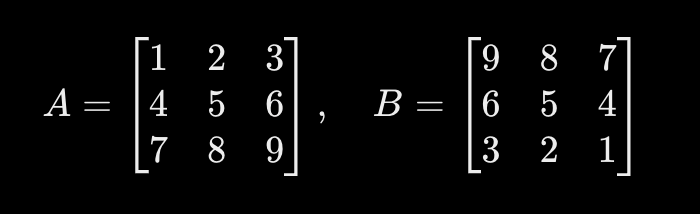
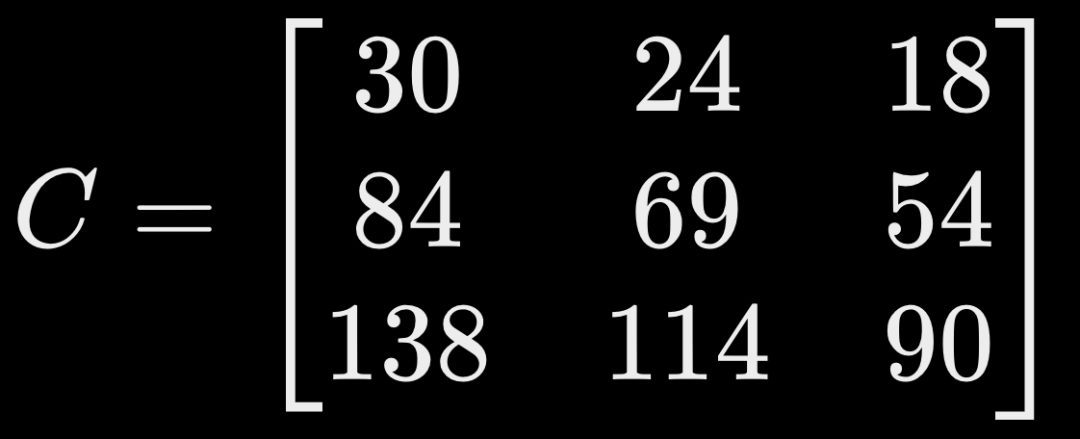
它们相乘得到的结果是:
如果先用外积再累加,结果没有变化。
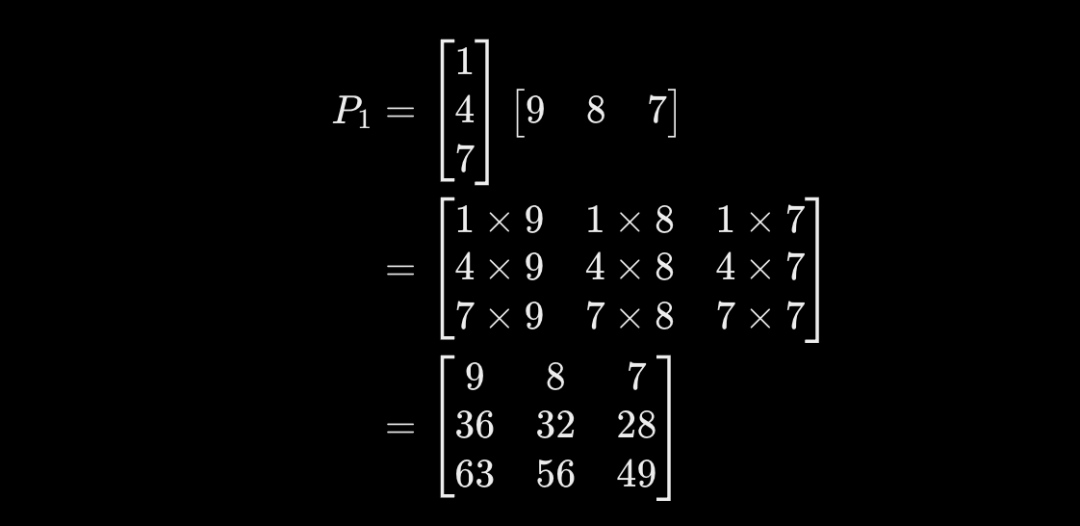
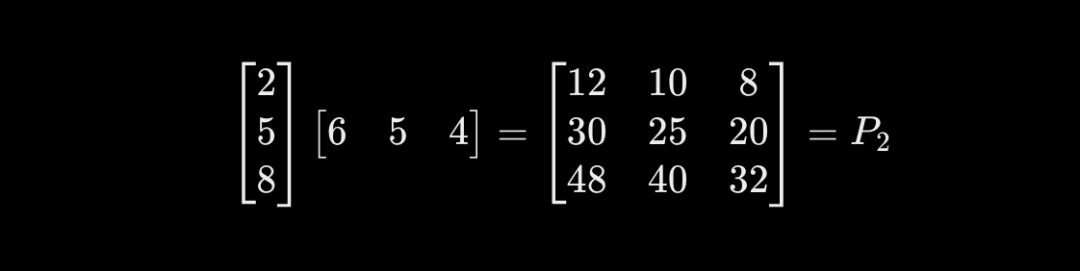
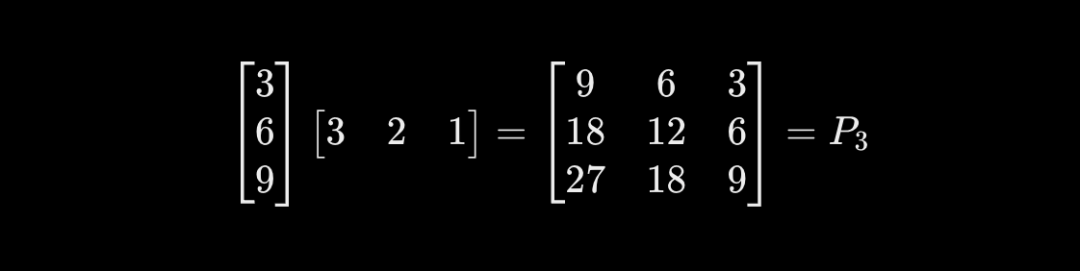
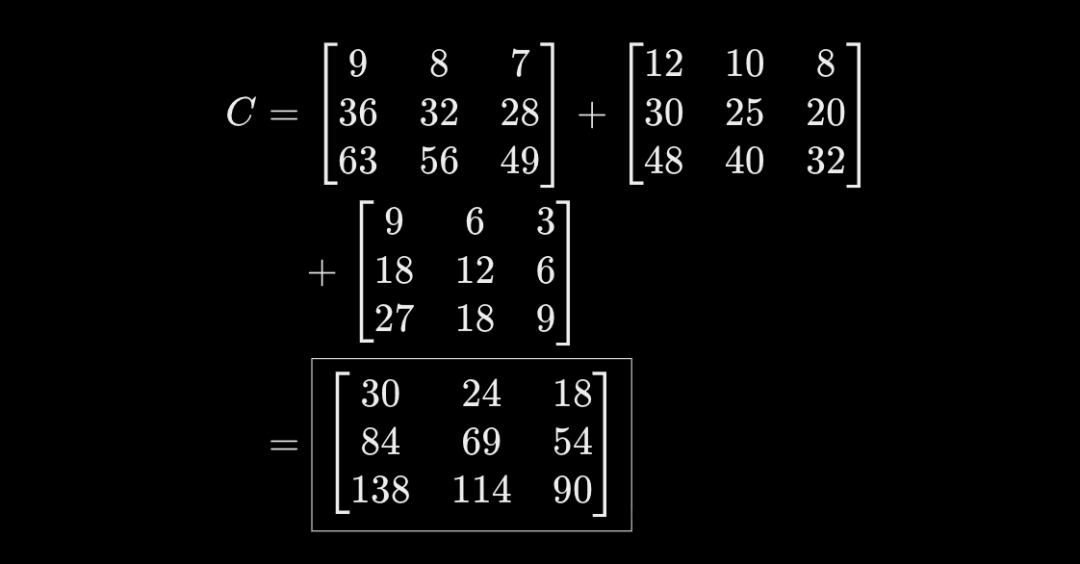
原理上不难理解,下图展示了矩阵乘法的基本公式。普通方法即行列法就是固定 i、j 来计算每个位置对应的 $C_{ij}$ 求和,而外积法就是固定 k 来同时计算所有 i、j 各自对应的一项 $A_{ik}B_{kj}$(这一步因为没有互相依赖所以可以继续从方阵上拆分),得到子矩阵,然后累加。
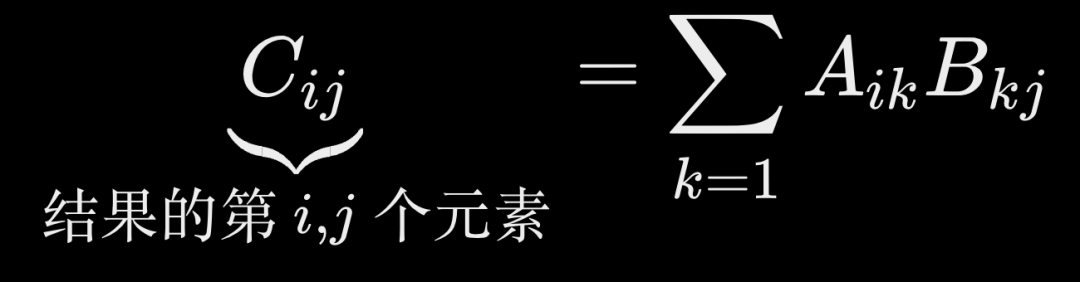
我们甚至可以把 A 的每一列(或 B 的每一行)再继续拆分下去,拆分出来后仅外积 C 的局部的子矩阵,最后累加结果也是一样的。
如下图所示,我们可以将拆分出 A 的一个部分列(图中粉色细长条),和 B 的一个部分行(图中黄色细长条),用来外积 C 的局部子矩阵(图中绿色方框),最后再累加。
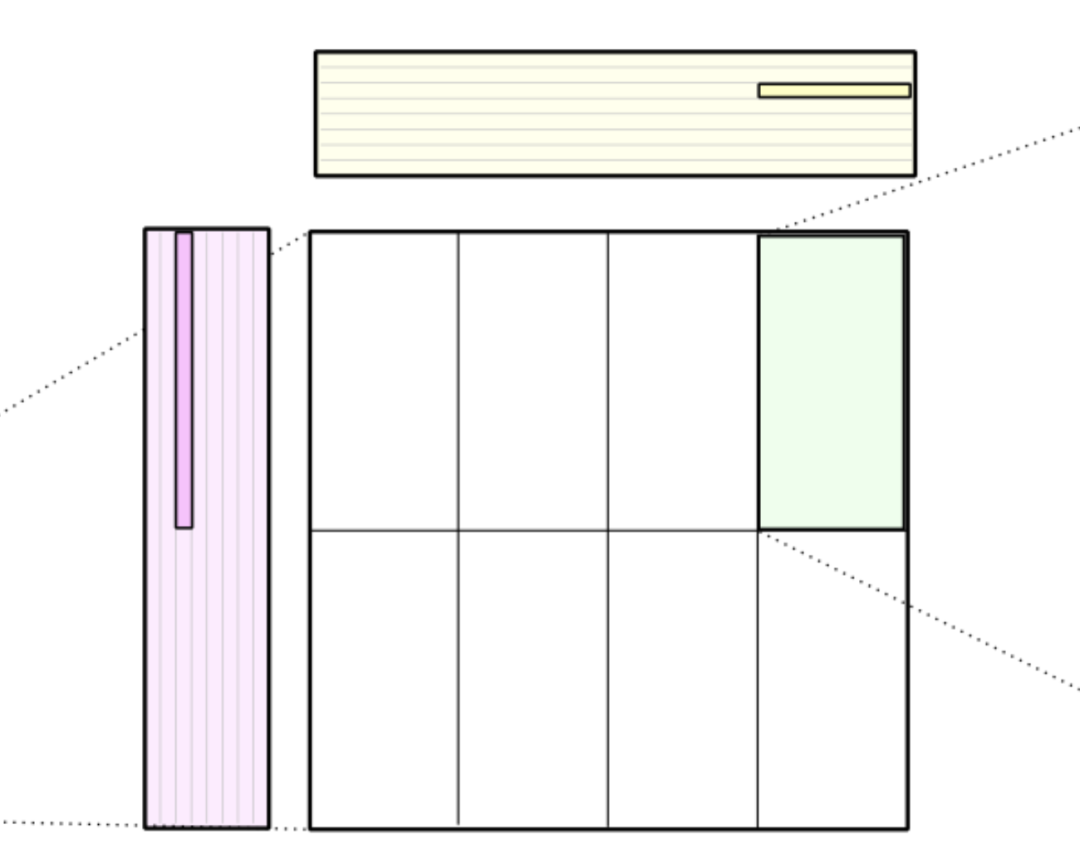
这些部分列、部分行和局部子矩阵,都可以看作不同形状的数据块,也就是 TileLang 的 Tile 思想的一种具体体现。
不过,Tile 并不局限于矩阵乘法中的这些数据块。更一般地说,它是 TileLang 编程模型中的基本对象,用来表示和操作具有特定形状的数据区域。开发者可以围绕这些数据块组织计算、控制数据存放的位置,并安排不同阶段的执行。
当然,即便是用外积,计算过程中也是存在数据复用的,比如下图例子中,$a_{00}$ 要参与两个结果元素的计算。
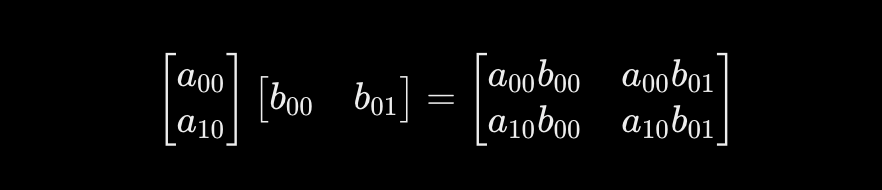
所以,基于外积拆分矩阵并加速矩阵乘法的原理就是:从全局内存加载原始矩阵之后,可以比较自由地划分矩阵而不担心依赖关系的约束,把包含内部数据复用的外积过程放在更快的存储介质中。
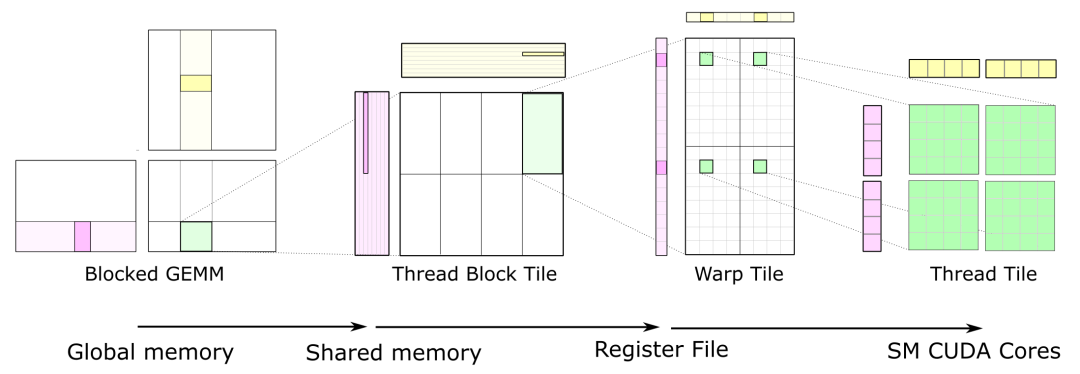
如果把这个拆分逻辑扩展到 GPU 的内存架构,则是下图所展示的样子。
图源:https://developer.nvidia.com/blog/cutlass-linear-algebra-cuda/
具体来说,在外积计算过程中,我们需要用一些中间存储单元,来分别存储 A 的部分列、B 的部分行,以及 C 的局部子矩阵,这就涉及到 Nvidia GPU 的典型存储架构了。上图来自英伟达的官方博客,展示了多层级的内存架构。
全局内存负责存放大部分原始矩阵,共享内存帮助同一个线程块里的多个线程复用数据,寄存器则保存每个线程即将参与计算的数据和计算过程中的中间结果。
通俗来说,可以把它们想象成一个厨房:
- 全局内存(Global Memory):仓库,容量大,但取货相对慢。
- 共享内存(Shared Memory):厨房里的备菜台,把一批原料提前搬进来,供多个厨师取用。
- 寄存器文件(Register File):每个厨师手边的小工作台,容量有限,但能让厨师快速拿到自己正在使用的原料和中间结果。
- 计算单元(SM CUDA Cores):厨师真正进行烹饪的地方。(计算指令通常从寄存器中取得操作数,再把计算结果写回寄存器。)
总体来看,相比全局内存,共享内存和寄存器文件在不同层次上减少了数据移动的成本。共享内存的作用不必和外积强绑定,广义上来说,把矩阵块加载到共享内存,就是为了加速重复的输入数据传输。
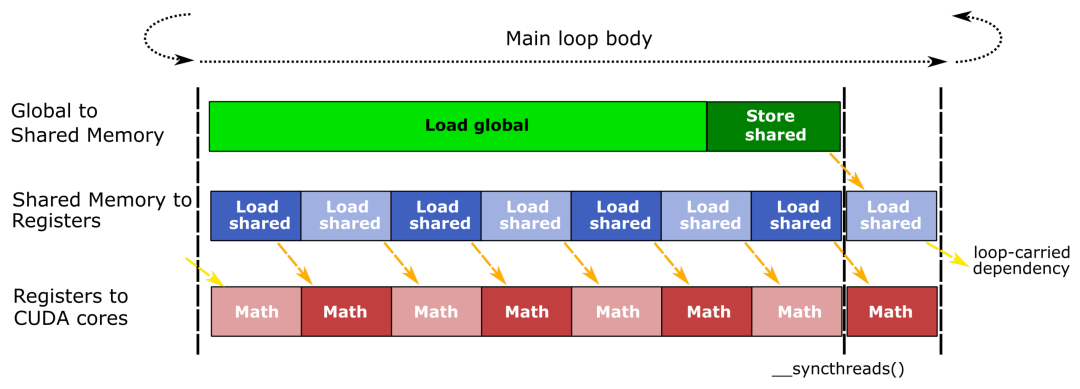
不过,直接按照上述流水线并行地去推进数据块的计算,对存储空间的需求较高,且存在占用空档。比如当输入数据都从共享内存转移到寄存器时,共享内存本身就相当于空转了,这也是一种资源浪费。
为此,如下图所示,可以在将一个部分的输入数据从共享内存传输到寄存器时,将另一部分输入数据同时传输到共享内存中,这样就隐藏了一部分传输延迟。其它流水线阶段也是类似的重叠方式。
图源:https://developer.nvidia.com/blog/cutlass-linear-algebra-cuda/
以上是矩阵乘法加速中最基本的一些方法,在 TileLang 中它们作为一个个基本算子被实现。
看到这里你可能已经懵了,但是恭喜你,你通过前面这些抽象的语句,大概能明白 TileLang 解决了什么程度的问题。因为开发者甚至都不需要接触这些细节。在具体应用中,也可以直接使用 DeepGEMM 这样的高性能矩阵计算库。
这也是 TileLang 的核心特点,也就是易用性,并且不丢失专业性。TileLang 本身提供了三种不同的编程接口,分别面向初学者、开发者和专家用户,它们分别展开不同层级的细节。TileLang 甚至还允许开发者混合使用这些接口,从而能够根据自身需求选择最合适的抽象层级。
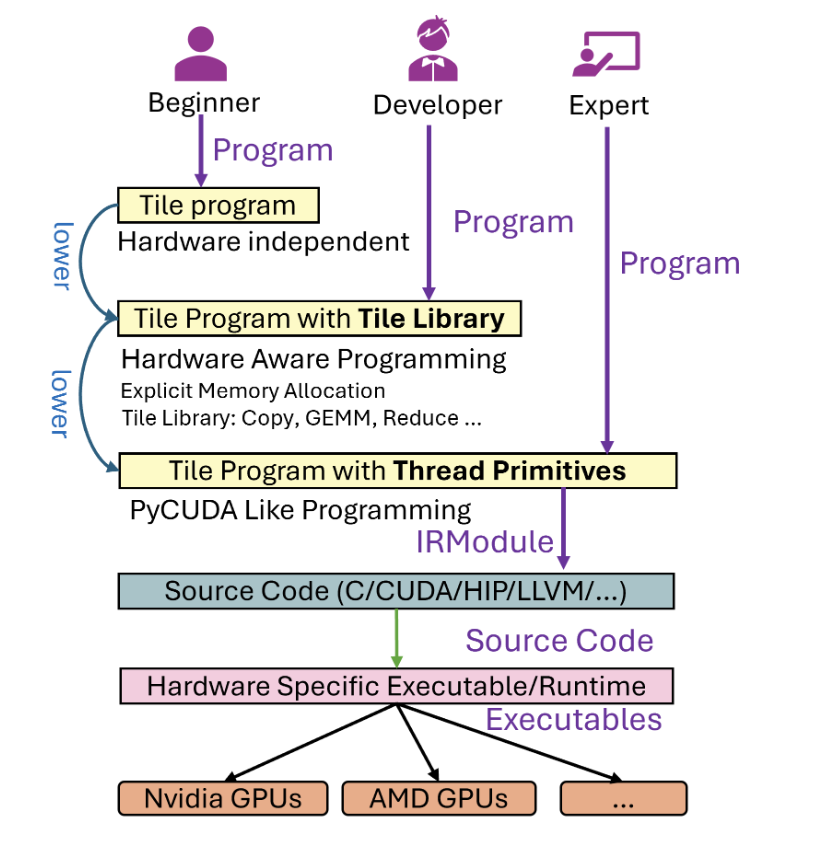
TileLang 编译流程概览。图源:https://tilelang.com/get_started/overview.html
不过在解释上述算子时,并没有提到具体的参数。实际上,一个矩阵应该怎么拆分(比如按 5×1 还是 2×2 的输入 Tile 来拆),一个线程负责 5×5 还是 8×8 的输出 Tile 的结果,流水线要分成多少个阶段,没有很明确的规律可循。
这背后都是大量的多因素权衡:拆分的太细,可能导致内存访问次数过多;拆分的太粗,可能导致占用率上不去。大量的参数组合中存在一个最优区间。
一般来说,要找到这个最优区间,需要手动一一去尝试,但这可能涉及数百个组合,并且过程是非常枯燥无聊的。
但 TileLang 可以把这部分工作都帮你做了。它有一个内置的自动调优器,会在配置空间中搜索性能最佳的参数,自动编译、验证和做基准测试,还能将最佳结果缓存,以后可以重复使用。
关于 TileLang 本身不再做过多展开,接下来我们转到 TileLang 的昇腾版本。
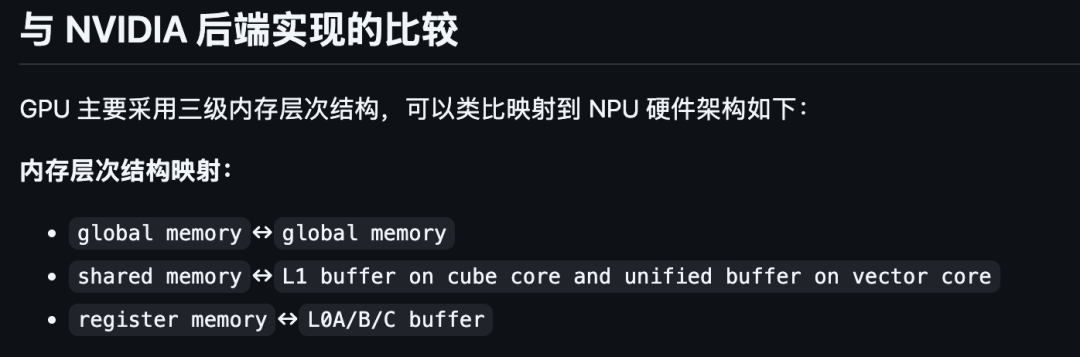
Ascend NPU 的硬件和编程语言的设计和英伟达有很大不同。比如下图来自 TileLang-Ascend 的 GitHub,对 Nvidia GPU 和 Ascend NPU 的内存架构进行了类比。但要注意,这种类比仅仅是为了帮助理解,不代表实际代码中可以完全等同。
其它基本差异还包括:Nvidia GPU 的计算是通过线程使用通用计算与矩阵指令,而昇腾 950 通过 Cube 承担矩阵计算,通过 Vector 承担向量计算。知友“歪睿老哥”甚至基于 TileLang-Ascend 的代码尝试推测昇腾 950 的内部结构。看看下图,光从数据流向的整体框架也能直观感受到差别。
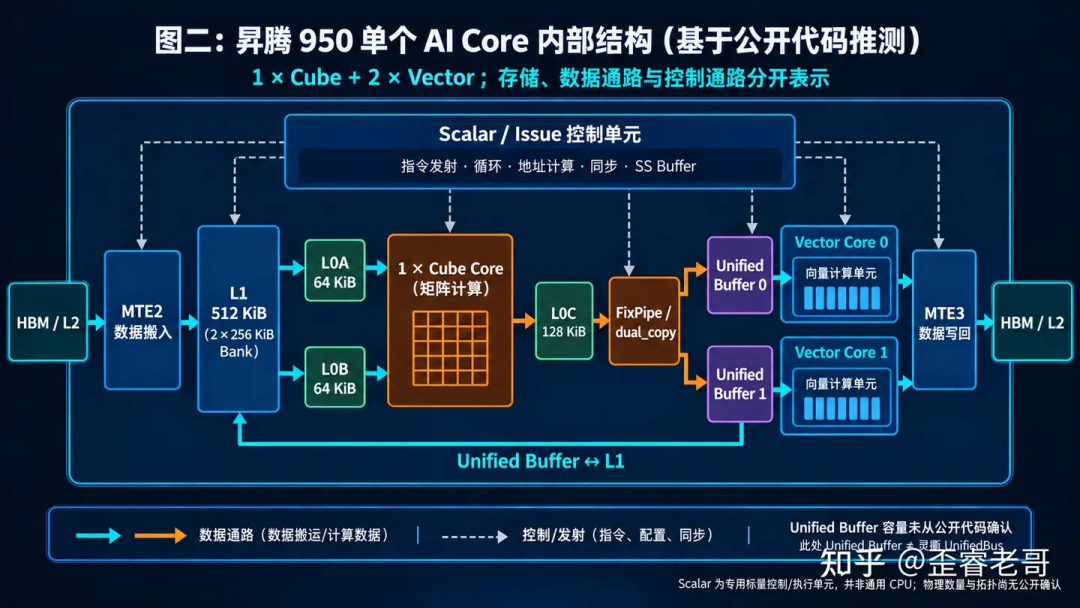
图源:https://www.zhihu.com/question/2088571879514714724/answer/2089123814449877380
但 TileLang 最终还是完美适配了昇腾,并且没有牺牲性能。比如下图展示的矩阵乘法性能对比,TileLang 和官方的 Ascend C 在计算耗时上几乎没有差别(基于昇腾 A2/A3)。最重要的是,程序员也依然是围绕 Tile 和数据流来写程序。要达到这些目标,DeepSeek 肯定付出了巨大心血。
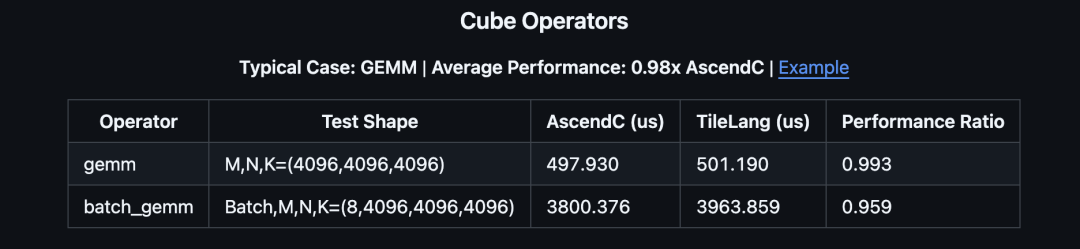
图源:https://github.com/tile-ai/tilelang-mlir-ascend/blob/main/README.md
到此,科普部分就差不多了。
本文主要是帮助读者更好地理解 DeepSeek 开源 TileLang-Ascend 事件中那些复杂的官方陈述和社区讨论,从而更好地理解事件本身的意义。
而除了我们前面提到的行业意义,从更长远的角度看,TileLang 的技术潜力在于降低 AI 软件与特定硬件之间的耦合。随着跨硬件编译、自动调优和底层执行模型逐渐成熟,开发者有机会在更多硬件之间复用上层计算逻辑,同时把针对不同芯片的优化交给专门的后端完成。
它未必能够彻底消除软硬件之间的联系,却有机会让这种联系更加灵活。
参考:
 发表于 1 小时前
|
查看: 5|
回复: 0


