经常在云栈社区的技术讨论里看到大家聊 DeepSeek harness,但很多人还是没搞懂大模型和 harness 到底啥关系,为啥 DeepSeek 要专门搞一套 harness?最近看到一篇文章把这个话题讲得挺透彻,整理出来分享。
harness 相对于大模型,有点像人体四肢和器官相对于大脑的关系。大模型负责思考,但它本身没法直接干活。读文件、写代码、跑命令行、测试、debug,这些实操动作都得靠 harness 去完成。harness 干完活再把结果丢回给大模型,大模型才好继续给出下一步指令。
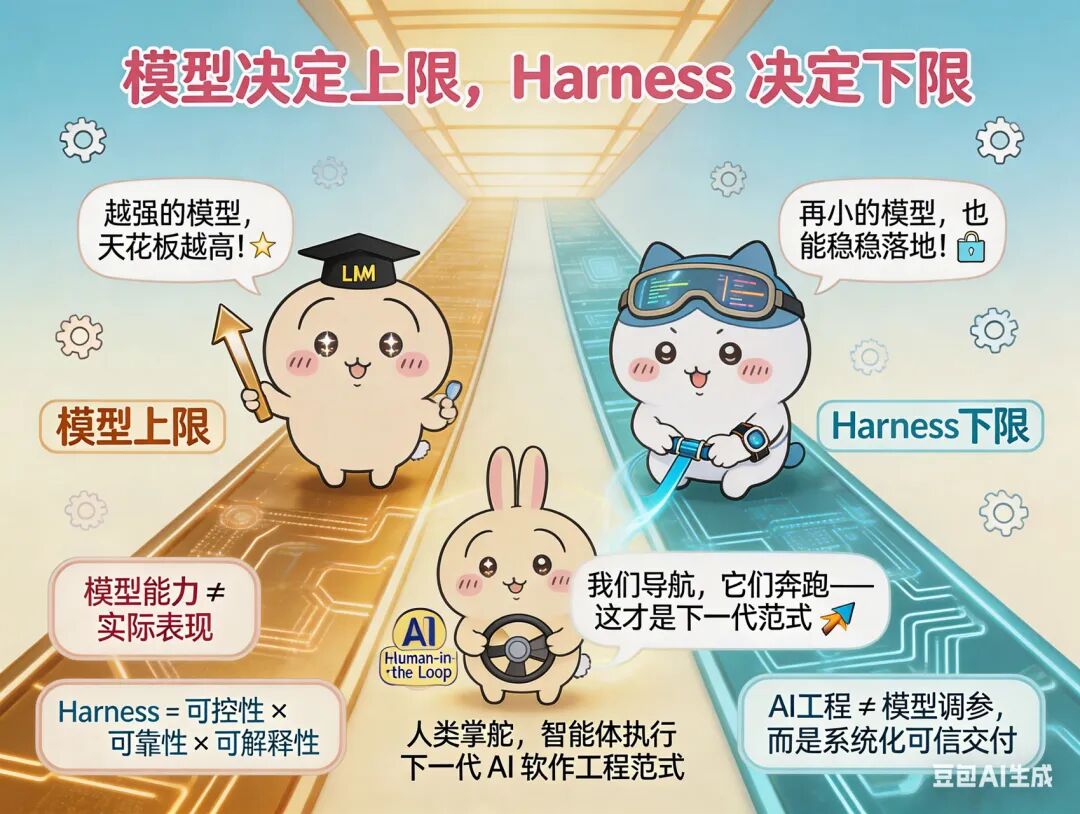
现在 AI 行业在模型性能上卷得越来越没劲了,边际效应递减得很明显。新模型多跑几个百分点,实际意义已经不大了。真正能抢占用户、拉开差距的反而成了 harness。几乎没什么悬念:谁不做 harness,谁就会先退场。
Codex、Claude Code、WorkBuddy 这几个就是典型的 harness,几乎吃掉了今年最主要的用户时间和收益。原因很直接:它们能干活、能创收,是实打实的生产力工具。豆包靠聊天狂揽了近 2 亿用户,但聊天不挣钱,用户粘性也差不少,所以现在也不得不推豆包工作,往 harness 这边靠。
Harness 的六个核心组成
这篇文章把一个完整的 harness 拆成了 6 块。
首先是 tools,它非常重要,是一组大模型可以识别的函数,用来找工具组件、执行代码任务,等于干活的家伙。
然后是 loop和memory。这俩货一个负责把工作流串起来,另一个负责保存和管理历史对话。就像你把大象放进冰箱,动作包括:打开冰箱、放进大象、检查、关上冰箱,有严格的步骤,还得记得自己之前做过什么。
再者是 Context,管理上下文。现在 AI 基本百万上下文起步,每次任务都塞满百万 token 显然不现实,所以得对上下文做合理管理,控制输入输出。
紧接着是 Sandbox,也就是隔离环境。每个任务有独立的系统、存储、依赖环境,互不干扰,清清爽爽,不容易犯错,也能让大模型更省心地管理,节约成本。
最后是明确目标 + 验证。这里需要你明确验收标准,比如自己写 AGENTS.md / CLAUDE.md,或者让 harness 调用大模型来生成这些文件。这一步直接决定了产出物的质量。
除此之外,权限管理、日志管理、evals 测试也都是 harness 的重要组成要素。
上面这些不是纸上谈兵。DeepSeek harness、Codex 这些 harness 每天在做的事,目标都指向同一个方向:让 harness 更稳定、更扎实、更好用。
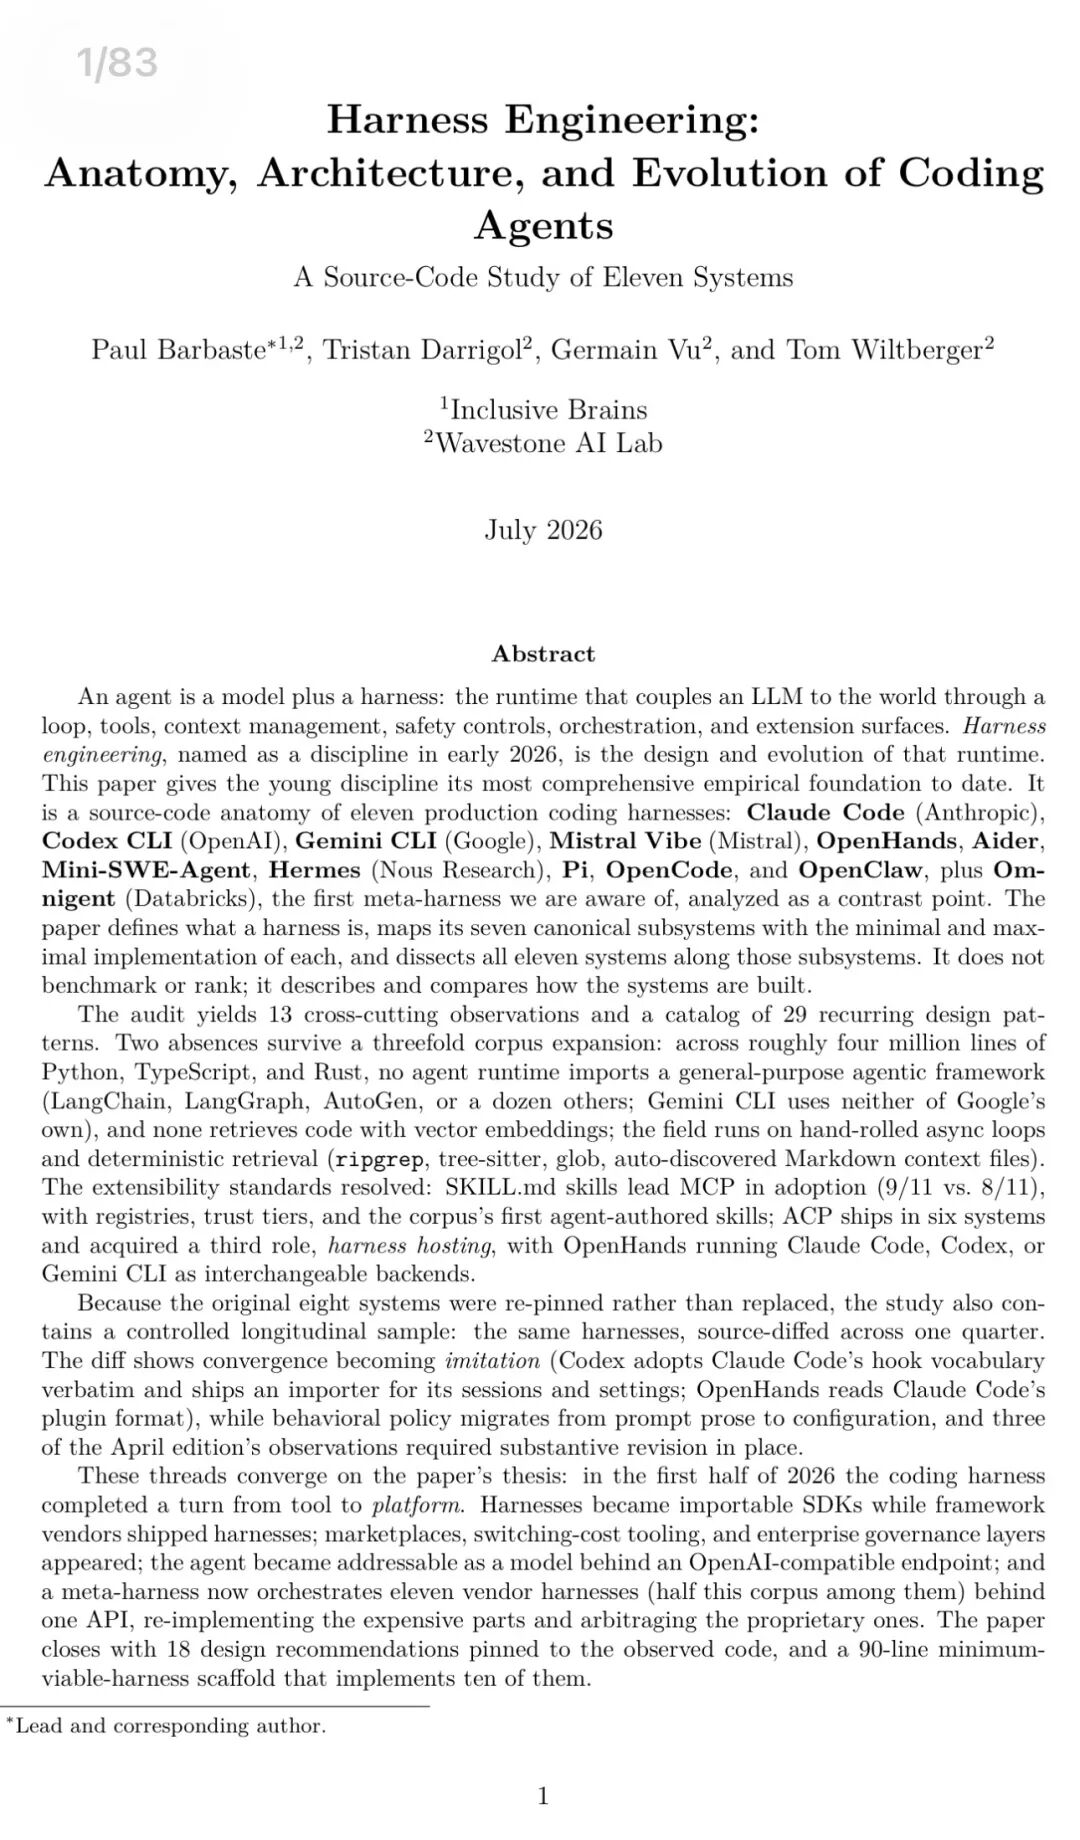
论文:Agent = 大模型 + Harness
这篇论文值得看看:
Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents
论文地址:
- 摘要网页: https://arxiv.org/abs/2609.00006
- 直接 PDF 下载: https://arxiv.org/pdf/2609.00006.pdf
- HTML 在线阅读版: https://arxiv.org/html/2609.00006v1
它扒了 11 个市面上主流的写代码 AI Agent(编码智能体),提出了一个新概念:Agent = 大模型 + Harness。
很多人以为代码 Agent 的差距全在大模型本身,这篇论文给出了否定答案。真正决定 Agent 能不能稳定干活、能不能装插件、能不能在企业落地的,是外面这套叫 Harness 的运行框架。
OpenAI 怎么看 Codex
还有一篇 OpenAI 写的文章:Harness 工程:在智能体优先的世界中利用 Codex。
里面关于 Codex 的解读很有意思。Codex 目前算得上是世界上最强的 harness,搞明白它的工作原理,对理解整个编码智能体的演进方向很有帮助。
 发表于 17 小时前
|
查看: 5|
回复: 0


