英特尔和 AMD 在 10 月 20 日共同宣布,oneDNN 正式成为 PyTorch 在 x86 CPU 上的默认开源加速库。AMD 把自家 ZenDNN 的优化成果并入了 oneDNN,同时加入管理该项目的 UXL 基金会,担任指导成员。这意味着以后无论用锐龙、霄龙还是酷睿、至强跑 PyTorch,走的都是同一套底层库。
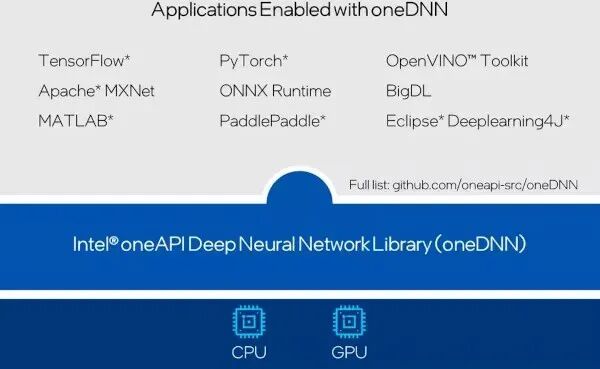
这两套库原本干的是同一件事。PyTorch 在 CPU 上做矩阵乘、卷积这类运算,需要借助底层加速库去调度处理器的指令。oneDNN 是英特尔发起的开源深度学习库,目前由 UXL 基金会维护,对英特尔自家芯片的调优最为细致。AMD 则单独维护 ZenDNN,接口与 oneDNN 兼容,内核针对 Zen 架构重写,今年 7 月刚发布 6.0 版,时间点卡在 Zen 6 上市之前。
以前想在 AMD 处理器上获得这些优化,得额外安装一个名为 zentorch 的 PyTorch 插件,再在 torch.compile 中把后端指定为 zentorch。这个插件主要面向霄龙服务器场景,重点优化推荐系统和大语言模型推理。如果一家公司的机房里同时部署了英特尔和 AMD 服务器,就得按硬件平台分别准备两套软件环境。
这次官方的做法,是把 ZenDNN 针对 Zen 架构的优化代码合并进 oneDNN 主干。英特尔数据中心战略项目副总裁杰夫·麦克维表示,开发者不应该为了发挥 x86 CPU 的最佳性能,还要去考虑不同的软件路径。将 oneDNN 设为 PyTorch 在 x86 平台上的默认加速库,是 x86 生态顾问组提出的建议,双方均已同意。
AMD 加入 UXL 基金会担任指导成员,身份从单纯的代码贡献者,转变为可以参与技术方向决策的一方。红帽首席技术官办公室副总裁斯蒂芬·瓦特也公开表态,认为两家在 PyTorch 中统一 x86 CPU 的优化路径,是消除生态碎片化的重要一步。
再往底层看,指令集层面也在协同推进。x86 生态顾问组由两家公司于 2024 年 10 月牵头成立,第一年就敲定了 AVX10、FRED 中断模型、ChkTag 内存标记,以及统一矩阵乘法的 ACE 方案。英特尔这次透露,双方正在共同推动 ACE 这套加速矩阵乘法的新指令,后续它在 PyTorch 中的支持会跟随 oneDNN 的更新一并接入,一次适配即可,不用两家各自实现一遍。
对在个人电脑上用 CPU 跑模型的用户来说,最直接的好处就是省事。机箱里无论是锐龙还是酷睿,PyTorch 默认都走 oneDNN,等 AMD 的 Zen 架构优化合并完成,锐龙用户就彻底不用单独装 zentorch 插件了。
你在自己的电脑上用 CPU 跑过 PyTorch 或者本地大模型吗?用的是锐龙还是酷睿?评论区聊聊你的实际体验。 |  发表于 前天 03:29
|
查看: 6|
回复: 0


