这项工作的核心议题只有一个:把高带宽闪存(HBF)放进大语言模型(LLM)推理场景里,仿真评估它作为 GPU 主存时到底能带来哪些收益,又会撞上哪些现实瓶颈。
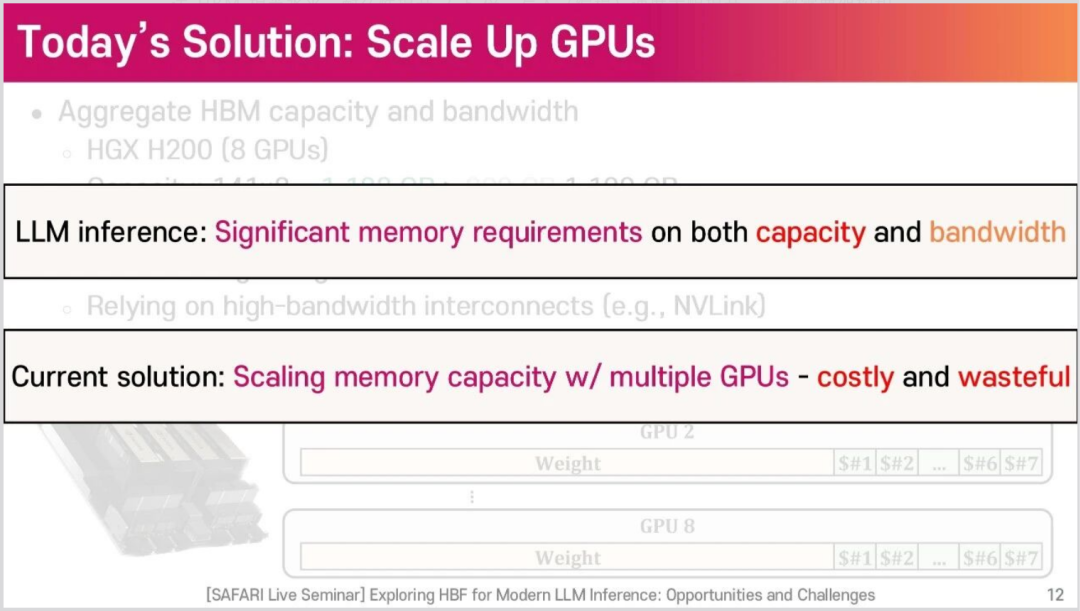
大模型推理通常分为 Prefill(预填充)与 Decode(解码)两个阶段。模型权重本身就是一笔大开销,随上下文长度不断膨胀的 KV 缓存 又带来第二重内存压力。以 Llama3 405B 为例,推理过程至少需要 800GB 以上的内存容量,同时带宽要跑到 8TB/s 以上,才能维持可接受的单 token 输出延迟。
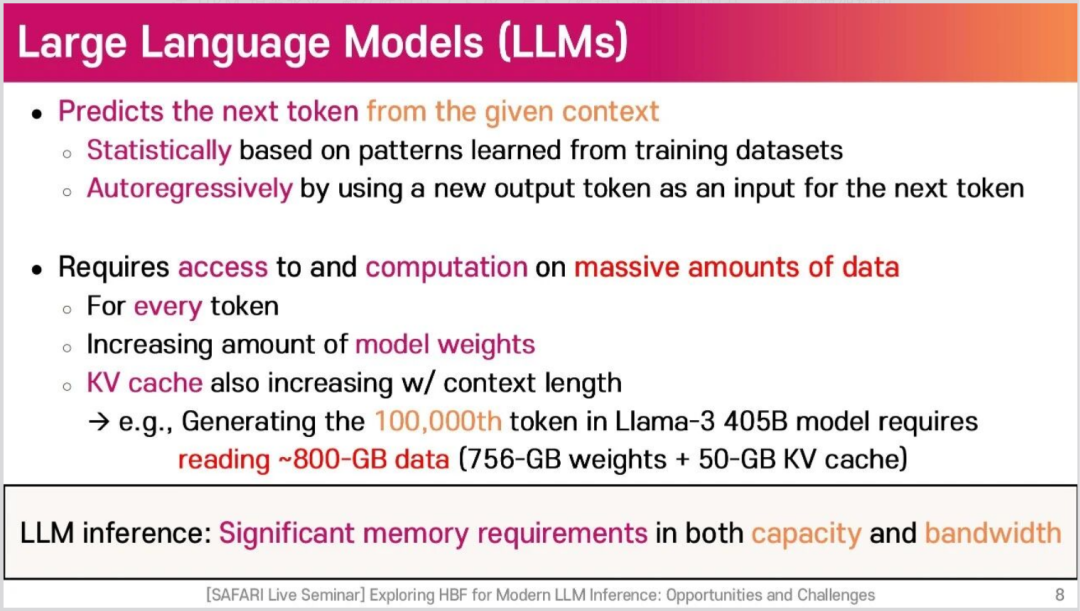
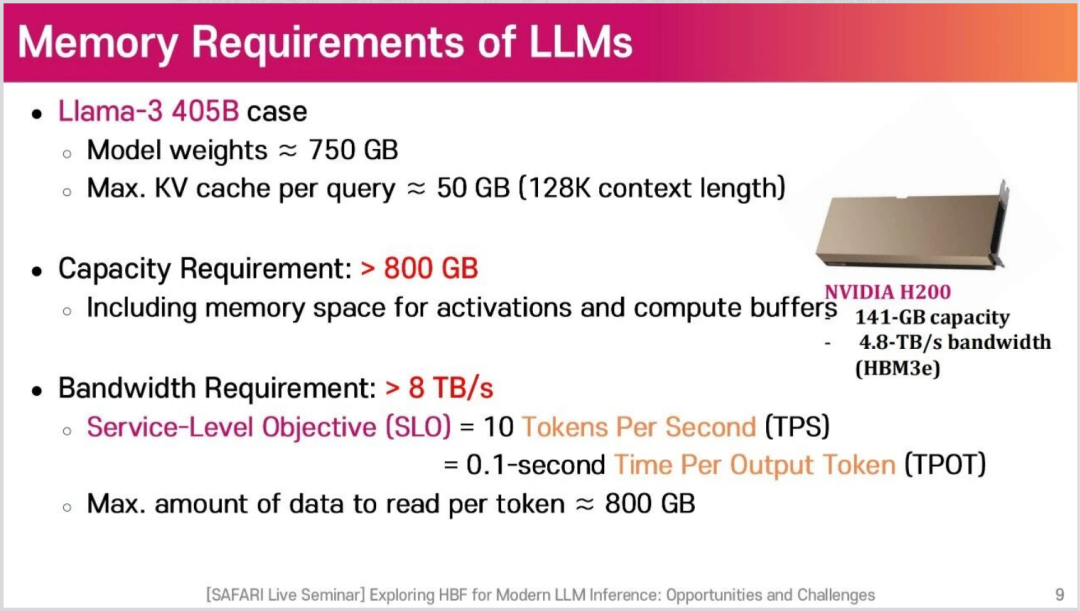
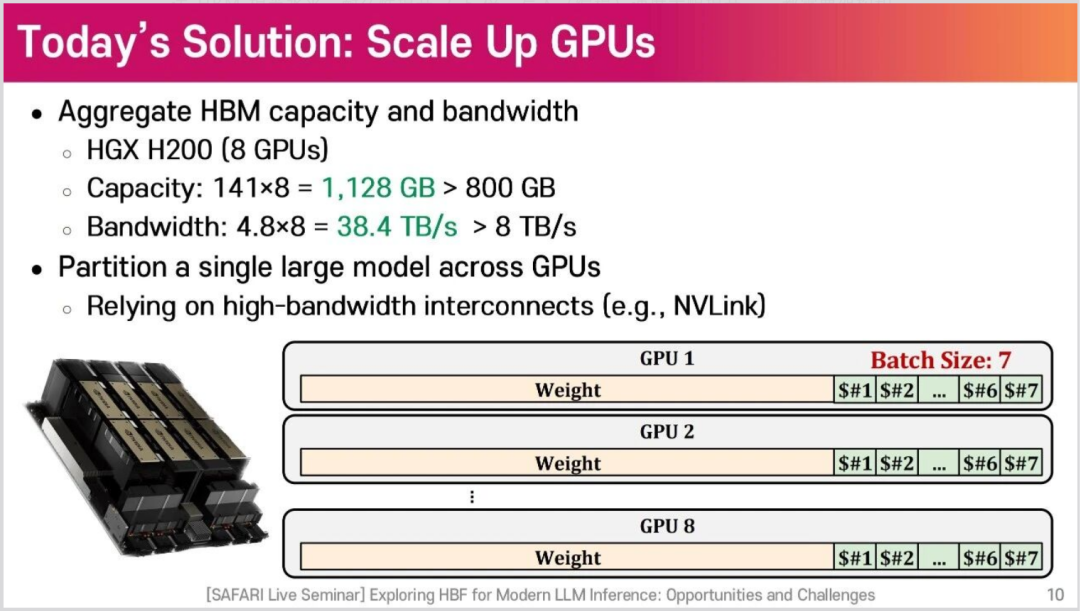
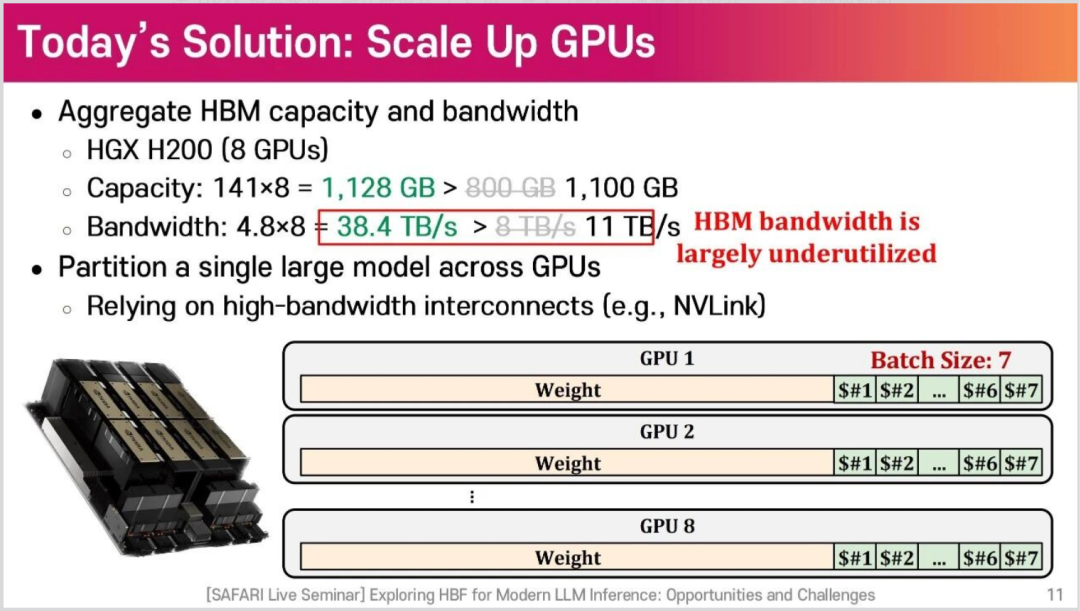
当前行业的主流做法是靠多 GPU 叠 HBM 高带宽内存,通过多卡聚合容量与带宽来满足这类大模型的需求。问题也很直接:成本居高不下,而且 HBM 的带宽在很多场景里并没有被打满。如果单卡就能同时放下模型权重和大容量 KV 缓存,部署门槛会完全不一样。
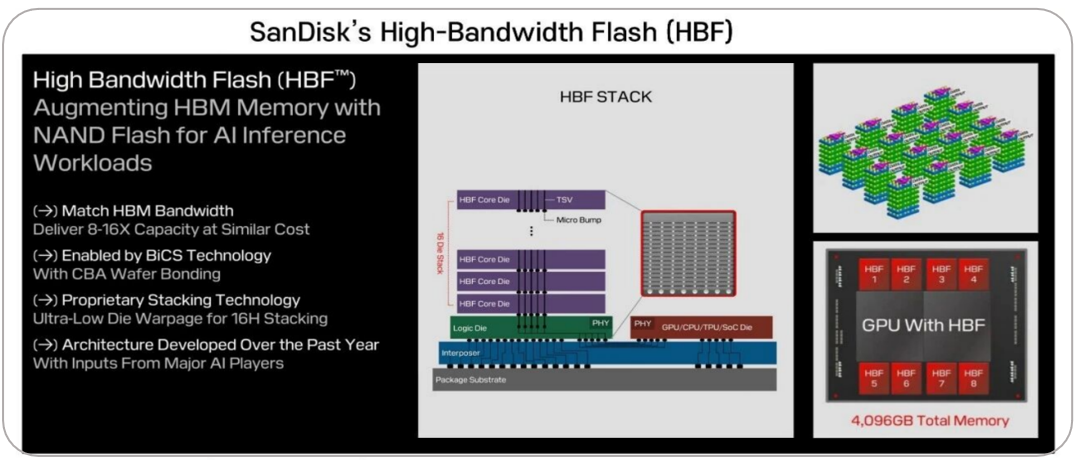
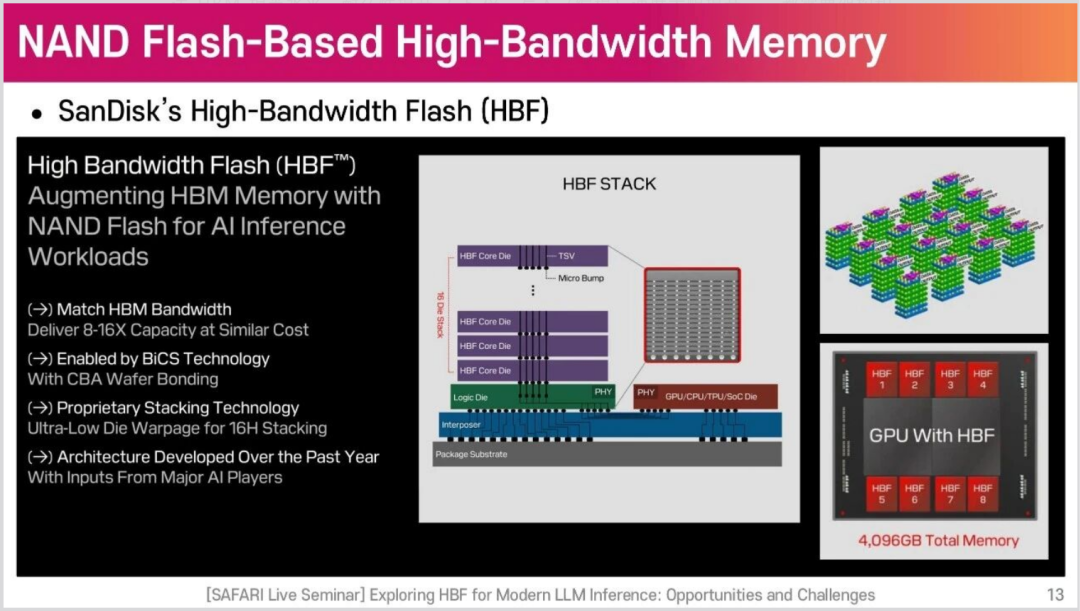
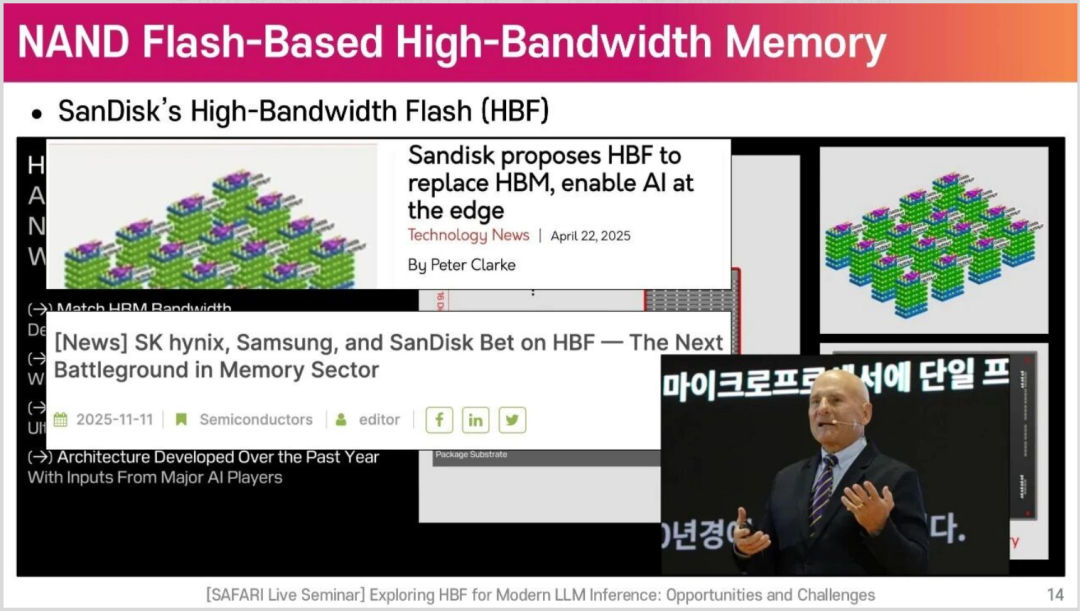
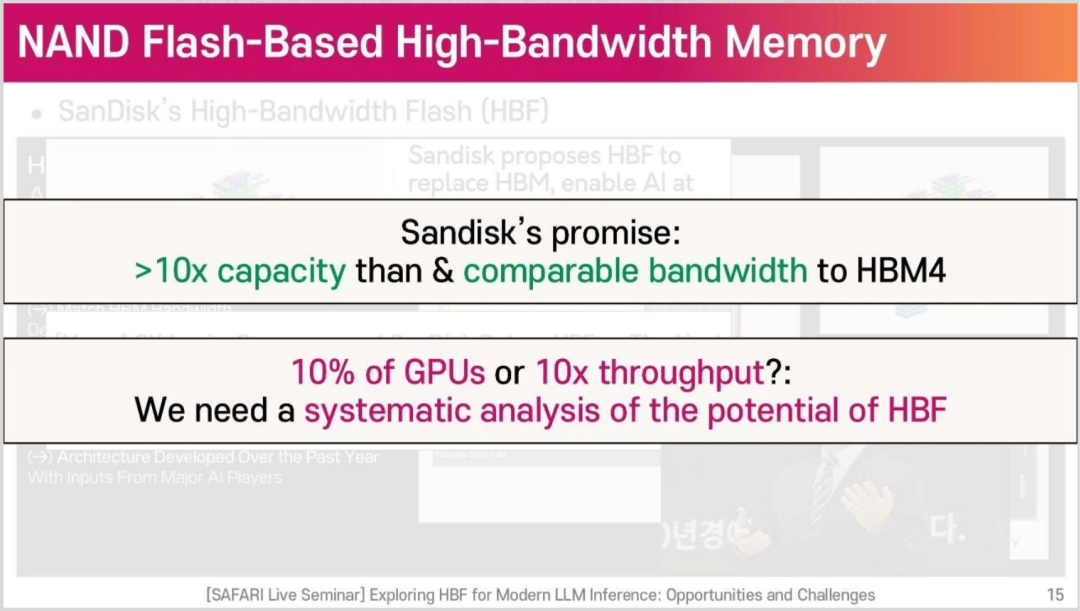
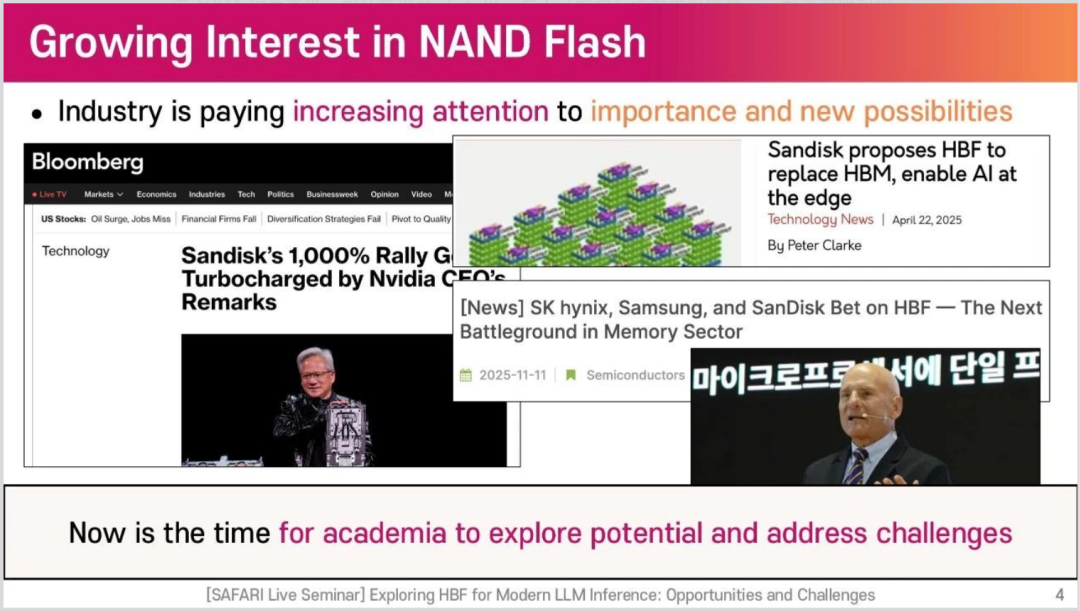
闪迪提出的 HBF(High-Bandwidth Flash)正是朝这个方向发力的。HBF 借鉴了 HBM 的堆叠思路,但基底换成了 NAND 闪存,目标是读带宽尽量看齐 HBM,容量则能做到 HBM 的 8–16 倍。三星、SK 海力士也陆续入局这条赛道,HBF 因此被不少人看作破解 AI 推理内存墙的候选方案。不过,业界此前一直缺少系统性的量化评估。
1、实验方案设计
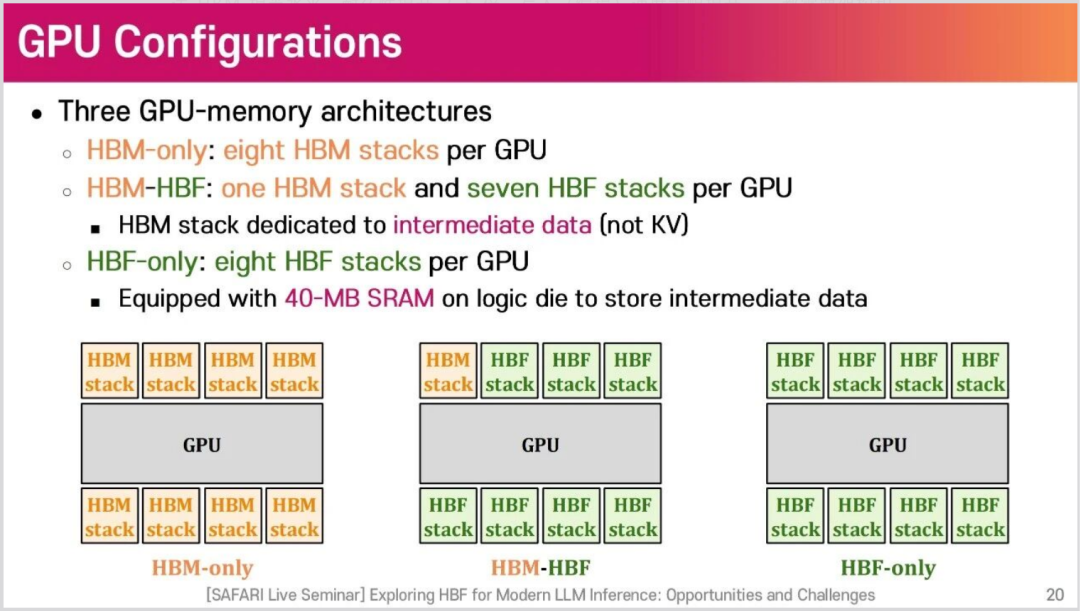
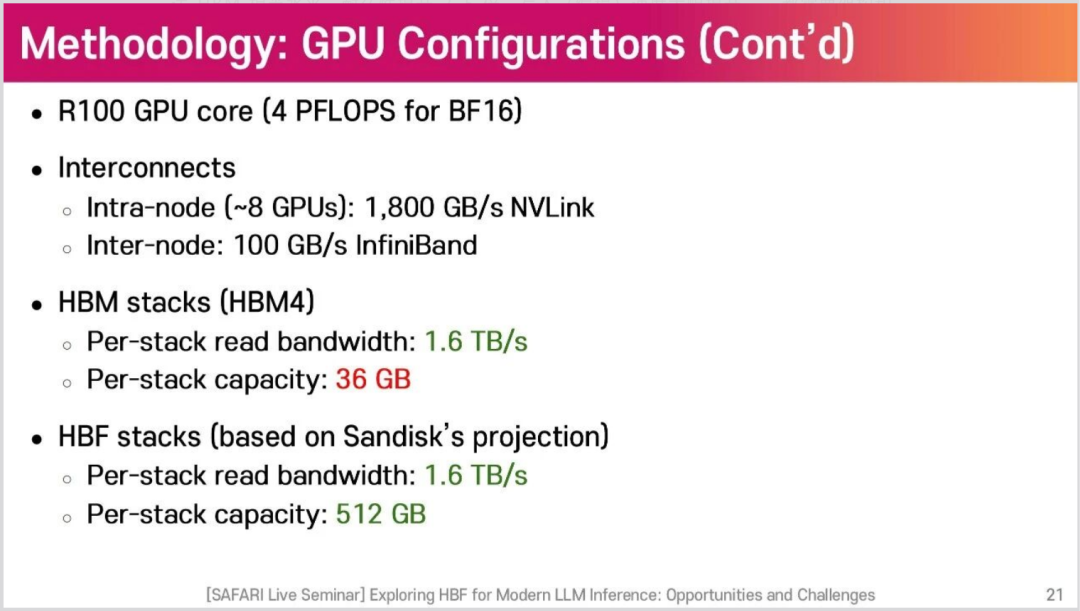
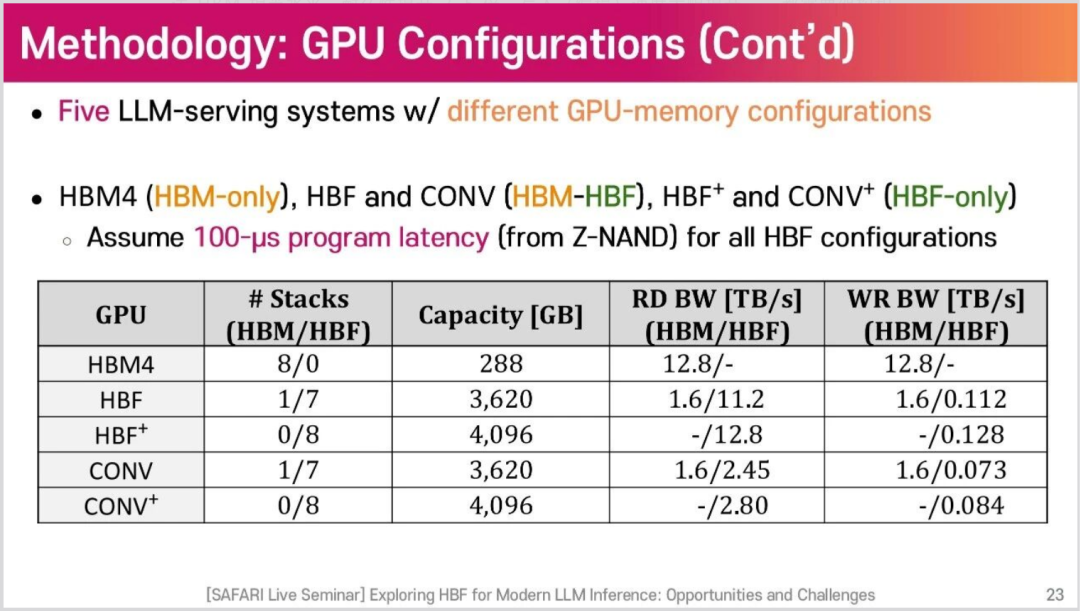
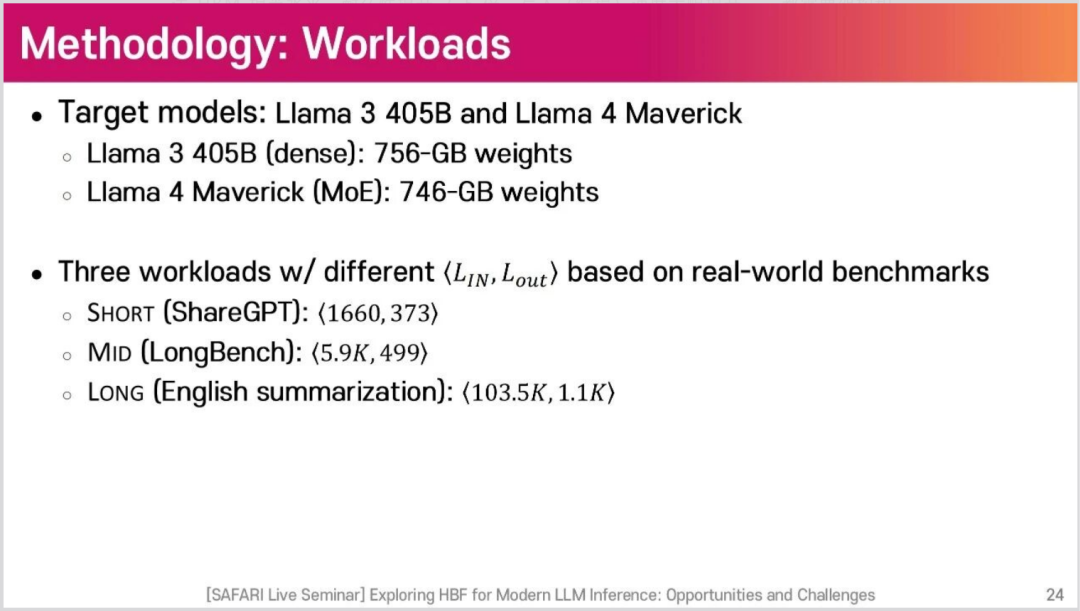
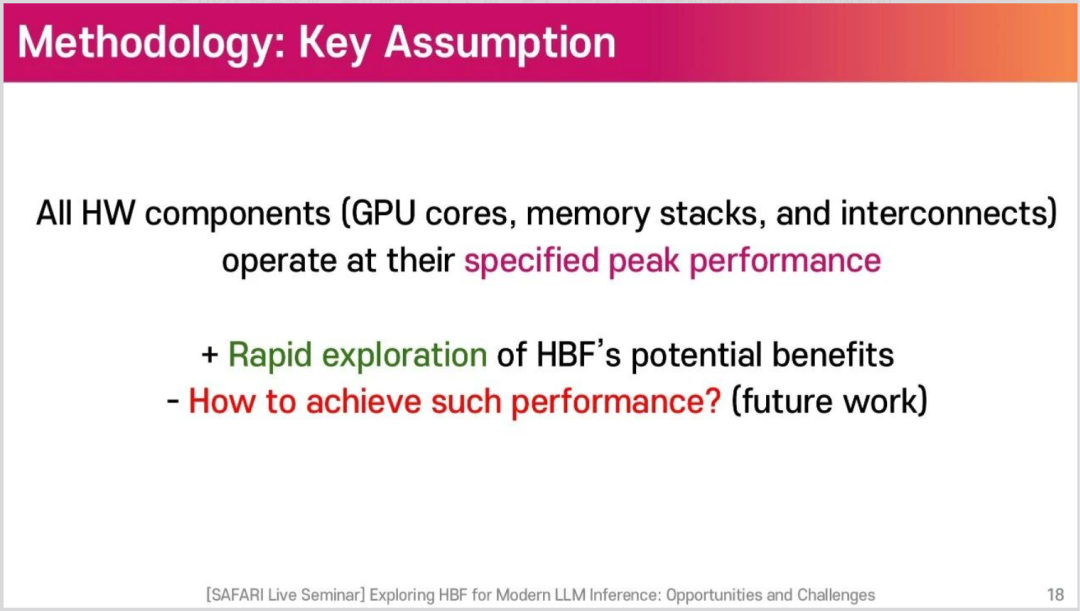
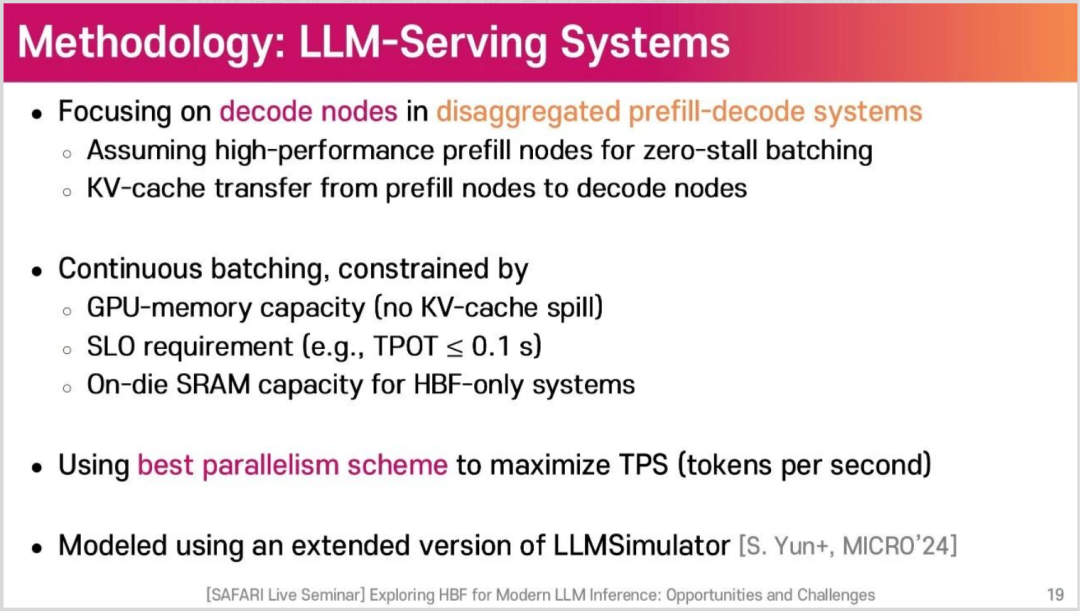
报告搭了三类 GPU 内存架构进行对比:纯 HBM、HBM+HBF 混合、纯 HBF。模型选取 Llama3 405B(稠密)和 Llama4 Maverick(MoE 混合专家)两款;负载设计为短、中、长三种不同上下文长度的真实业务场景。仿真基于 LLMSimulator 工具,SLO 服务质量约束设为 0.1 秒 TPOT,也就是单个 token 输出时延必须压在这个门槛以内。
2、核心仿真结论:HBF 带来的收益
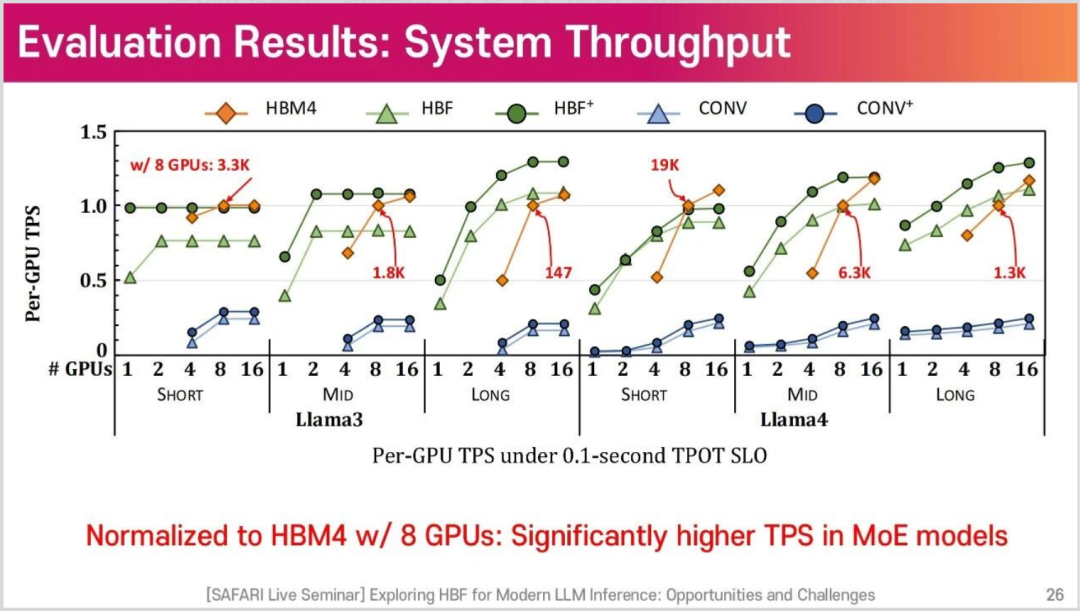
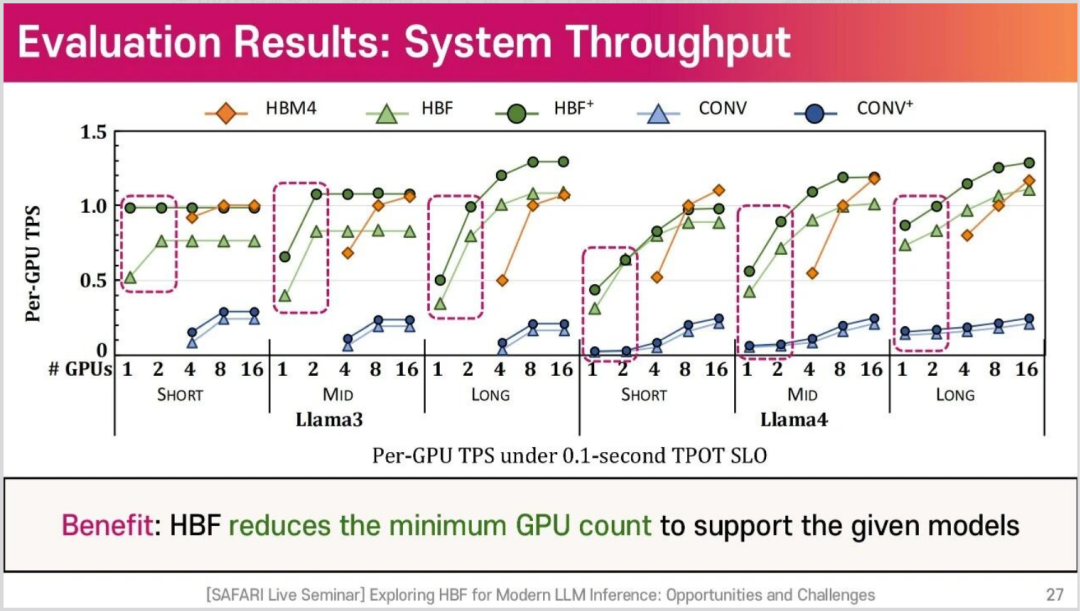
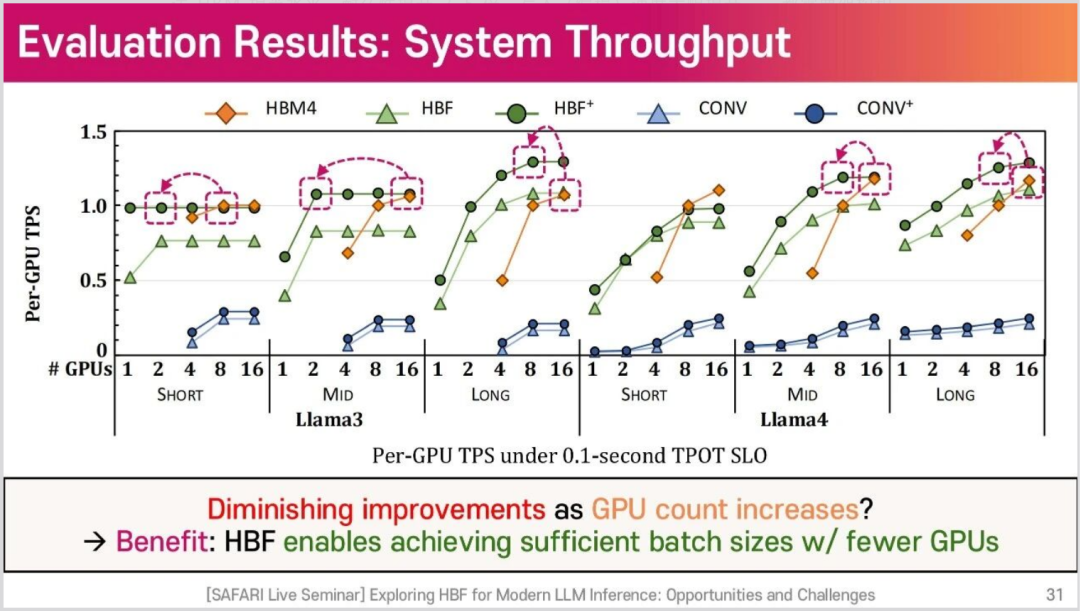
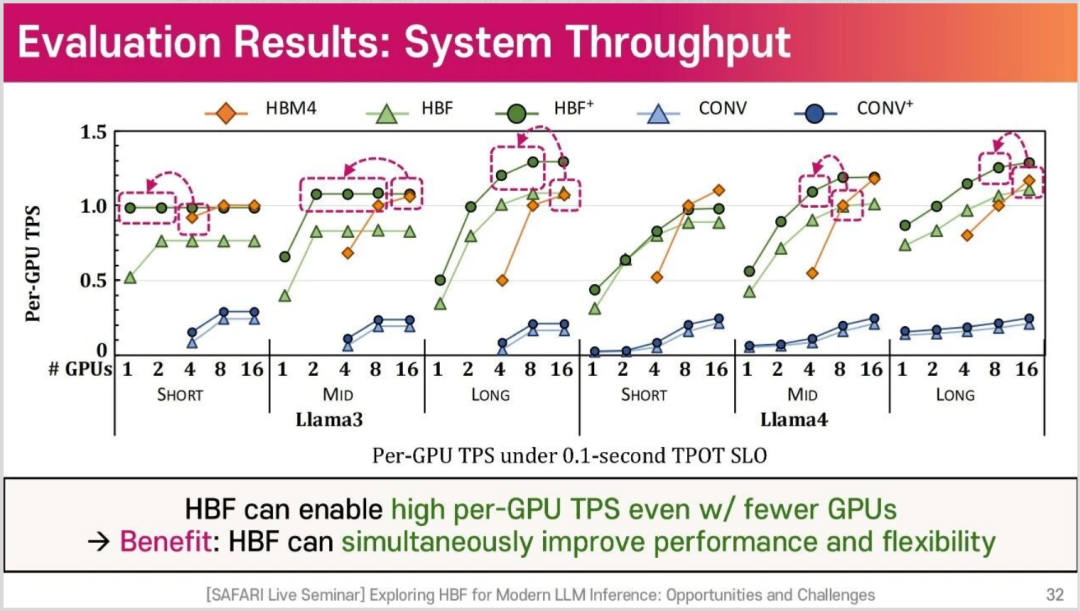
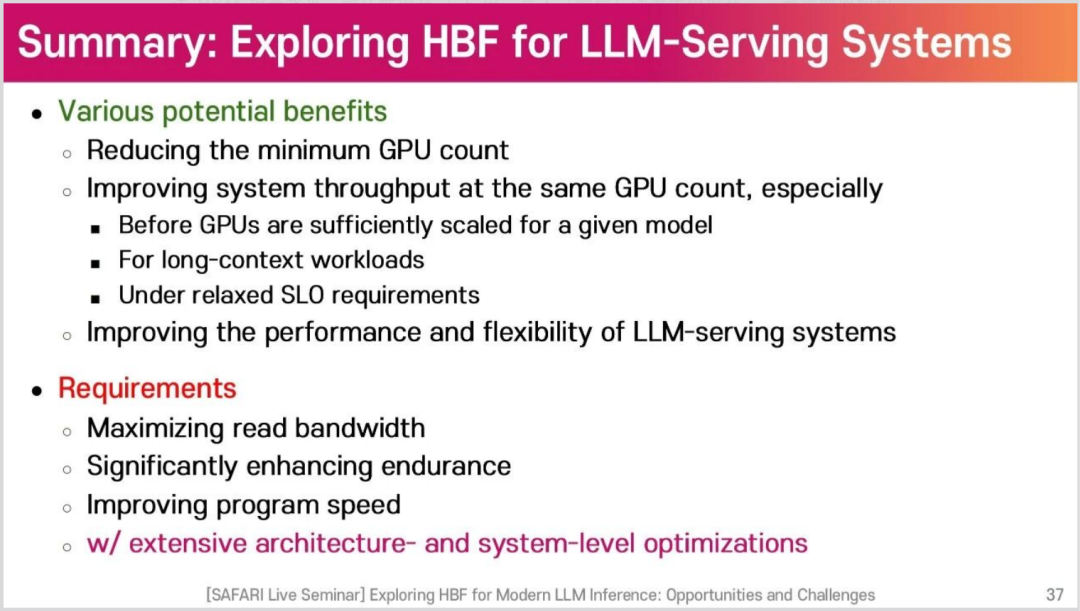
- 降低最低 GPU 硬件门槛:在同等业务 SLO 约束下,HBF 的超大容量可以用更少的 GPU 卡支撑大模型,集群规模得以明显缩小。
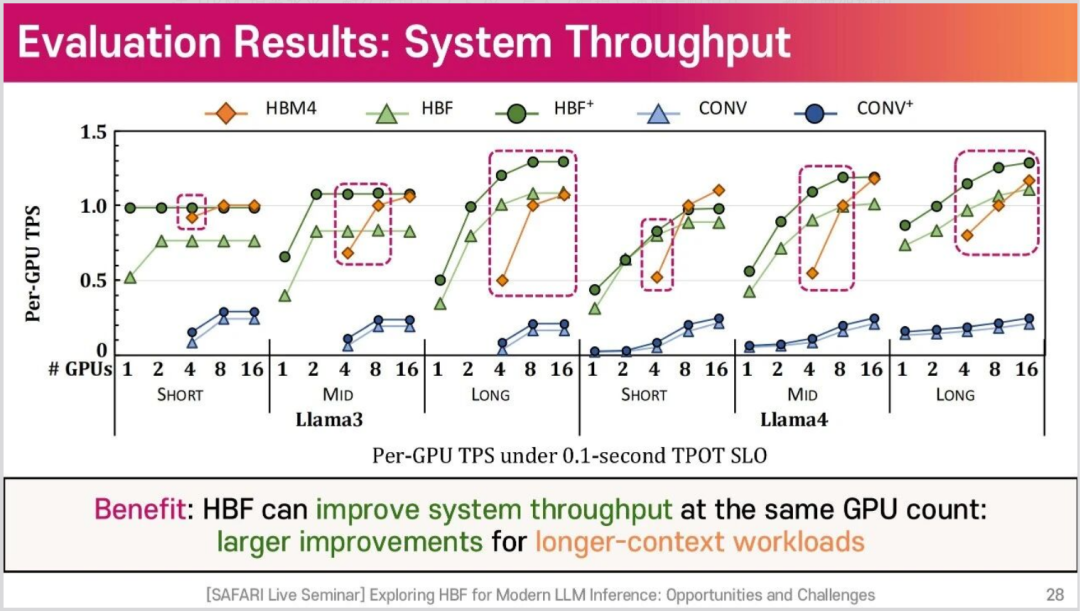
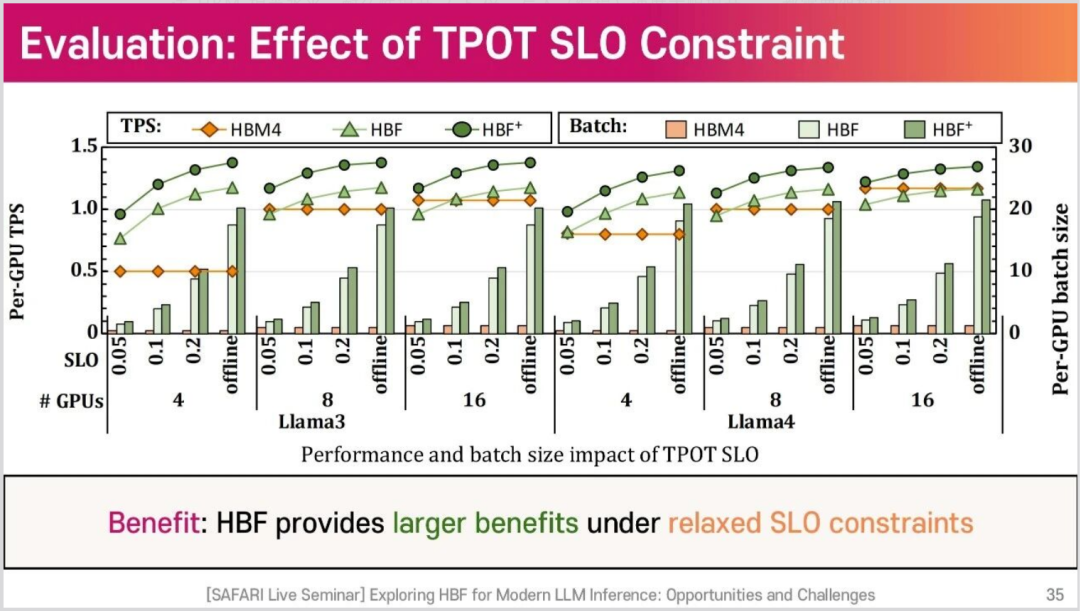
- 提升系统吞吐 TPS 与批处理规模:长上下文场景的收益尤其明显;MoE 专家模型下的增益会更加突出。
- 增强系统灵活性:当放宽 SLO 时延约束后,HBF 的性能优势还会进一步放大。
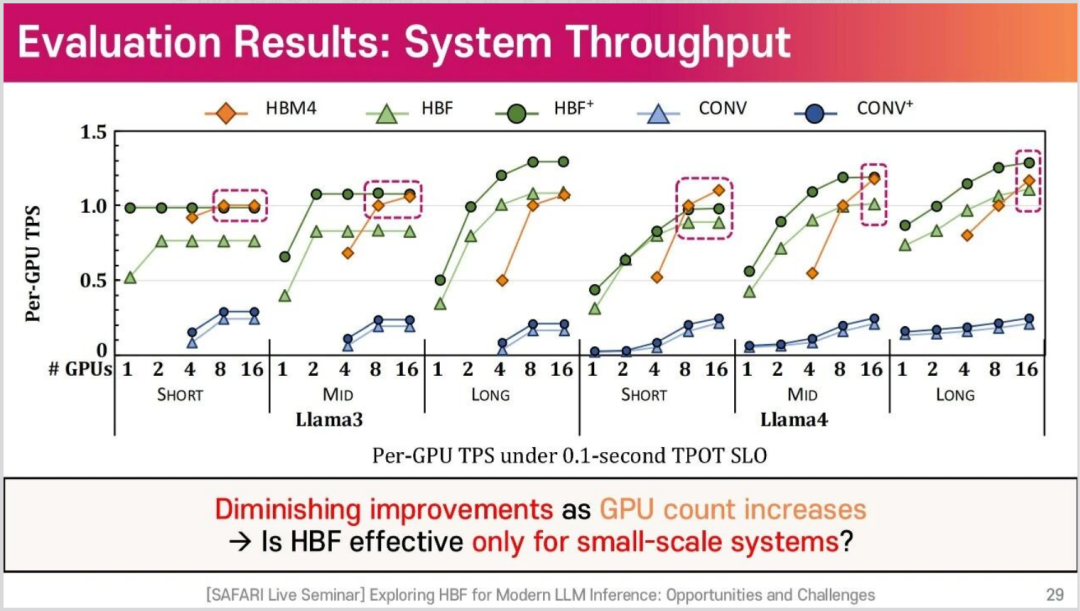
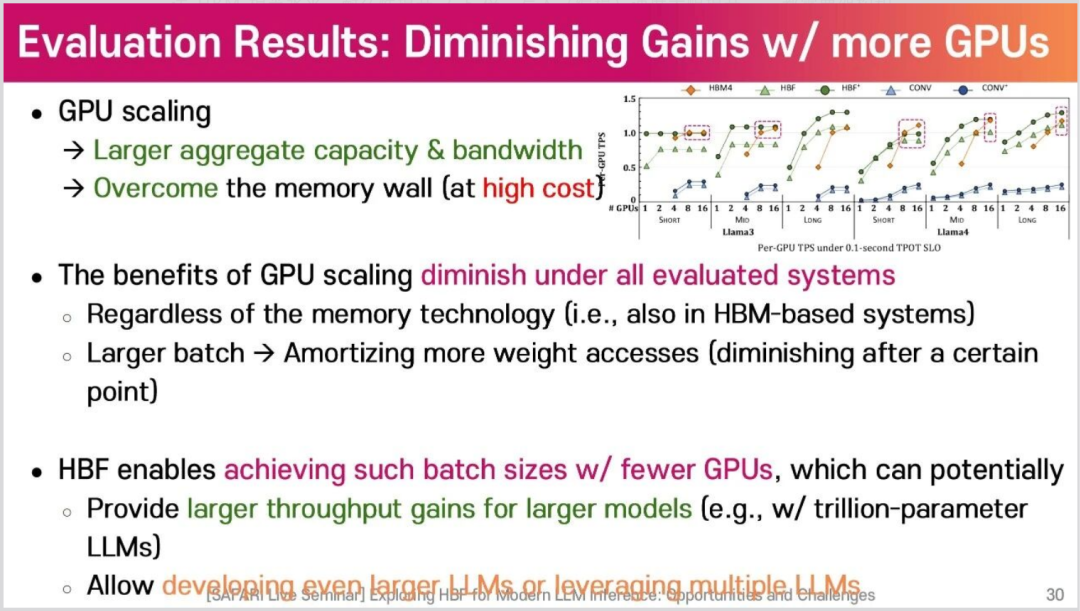
- 收益随 GPU 数量增加而边际递减:各类架构都会遵循这一规律,HBF 的价值更多体现在中小规模集群。
3、必须攻克的硬性技术条件(仅靠大容量不够)
HBF 能带来收益,但容量大只是起点。要让这些优势真正落地,至少还有三道硬约束:
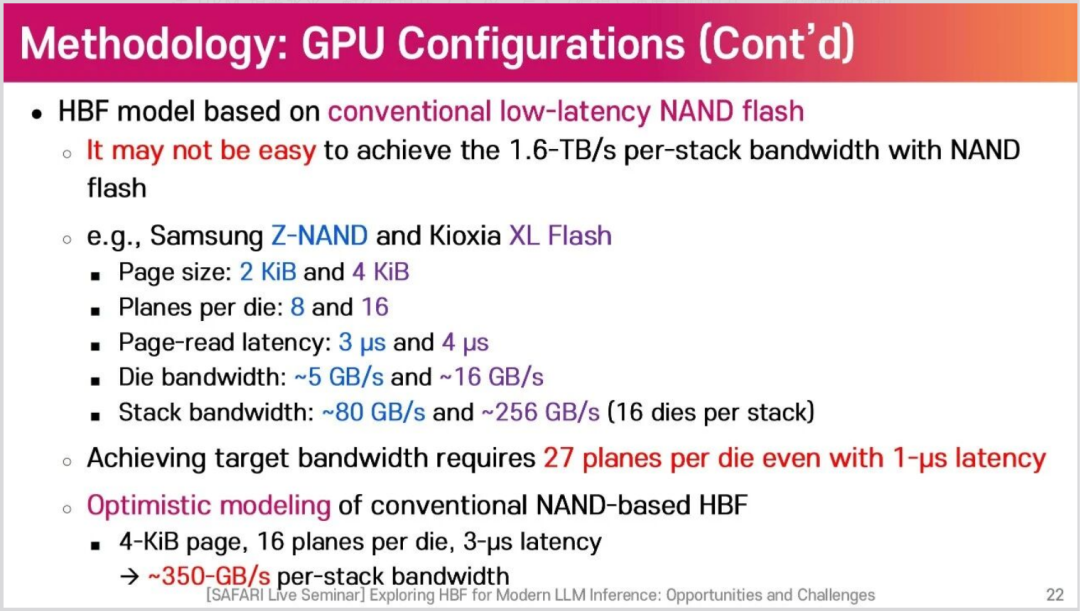
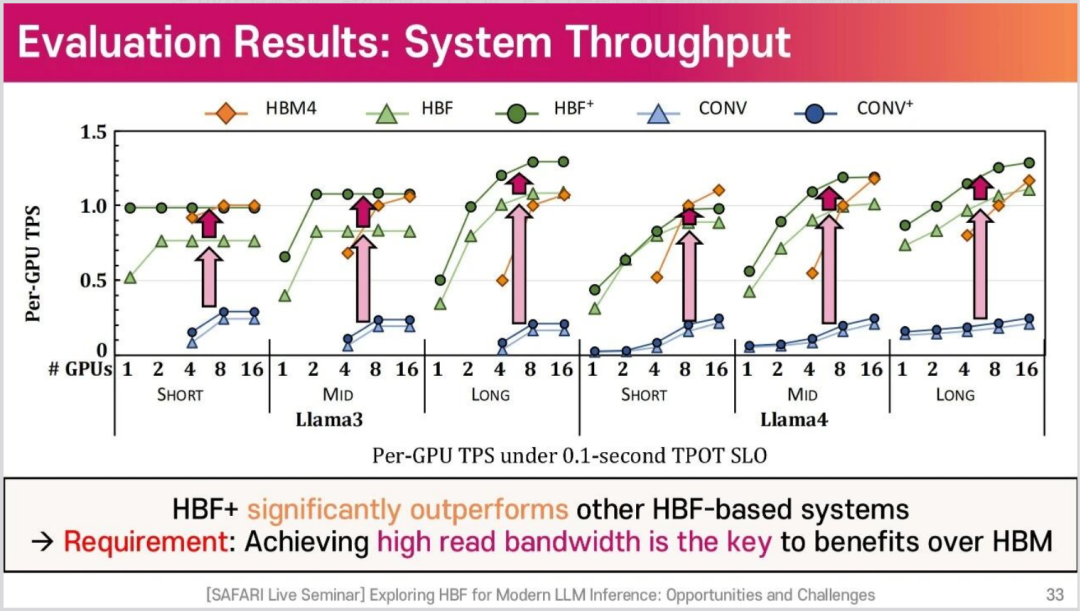
- 读带宽必须看齐 HBM:如果采用传统 NAND 架构做 HBF(即 CONV 系列),带宽会明显不足,性能表现很差。只有把读带宽做到 HBM 同级,前面提到的吞吐提升才会成立。
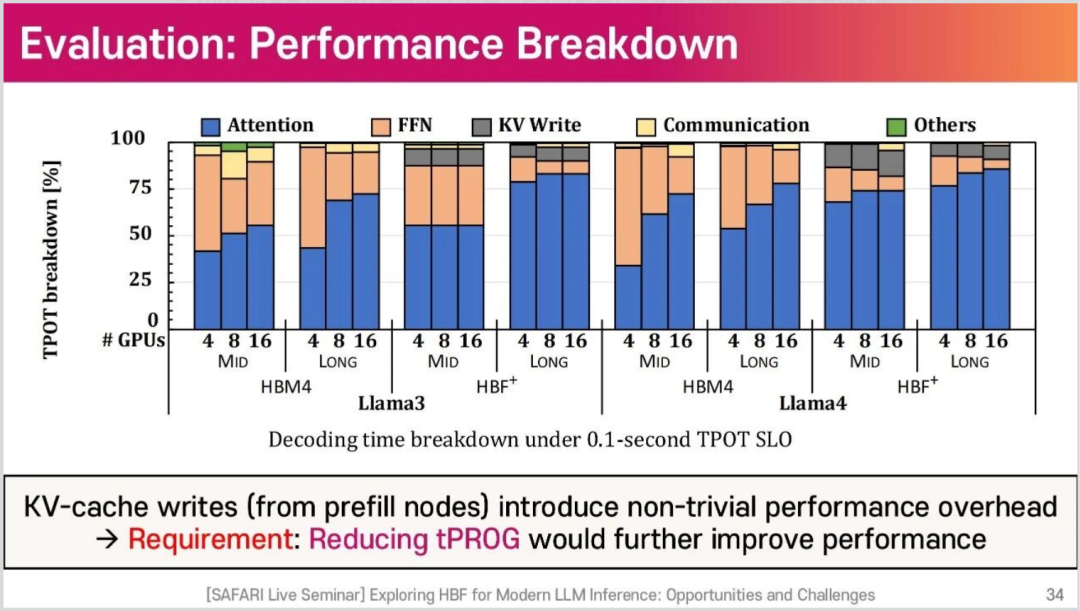
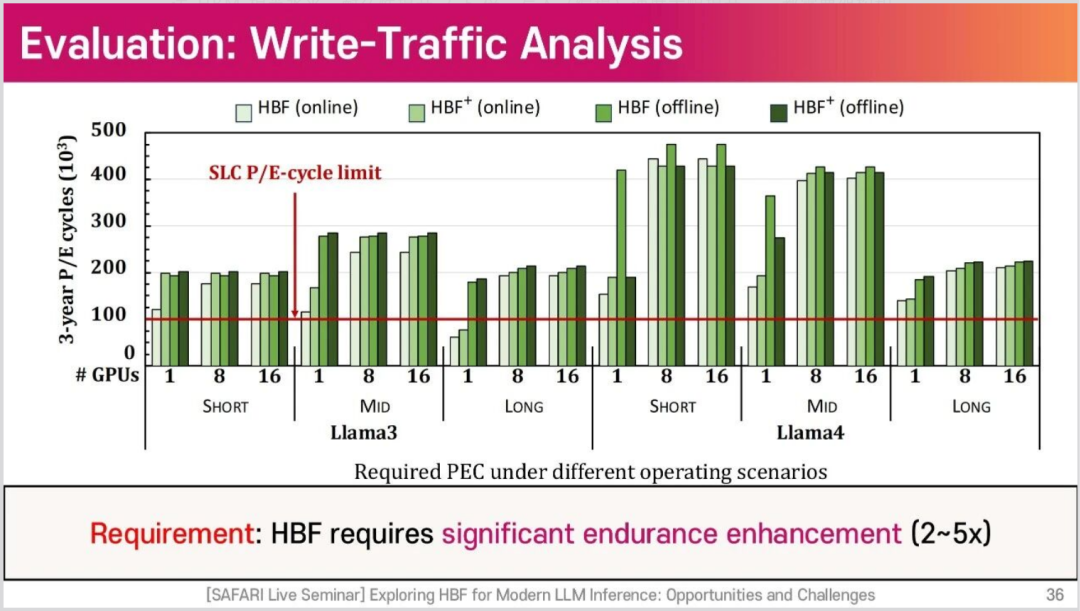
- 闪存耐久度需要提升 2–5 倍:KV 缓存会产生大量写流量,仿真结果显示,现有 SLC 擦写循环上限无法满足业务长期运行,写耐久是绕不过去的障碍。
- 编程写入速度要加快:KV 缓存写入带来的性能开销不可忽略,写延迟过高会直接拖慢解码阶段的整体吞吐。
HBF 能直接替换 HBM 吗?至少从当前仿真结论看,答案是否定的。它凭借 NAND 带来的超大容量,有潜力成为 HBM 的补充方案,改善 LLM 推理系统的硬件成本、批处理能力与部署门槛,但还不足以简单替代 HBM。落地不是只靠堆叠更大容量,读带宽、写入速度、闪存耐久这三大硬件问题必须先解决,同时还要配合架构层与系统软件层的协同优化。
比较现实的落地路径是混合架构:保留少量 HBM 存放高频动态数据,让 HBF 承担模型权重以及大容量 KV 缓存。这样既能压住成本,又不至于在延迟和耐久性上翻车。
更多关于大模型推理、内存体系结构的技术讨论,也欢迎到 云栈社区 交流。 |  发表于 昨天 23:24
|
查看: 14|
回复: 0


