朋友们好,这里是云栈社区。
昨天,梁圣把自家的印钞机开源了——适用于 v4.1f 的推理框架,可以跑在英伟达和华为生态上。公开数据看,单卡每小时收入 38 美元,按租卡价格算,利润率达到 500%。
如果从 kvcache 缓存成本考虑,在 SSD 上存 3 天也完全可行。
梁圣这波操作,算是对美国禁令最直接的回击。老美转头一看,本土机房全在部署 DeepSeek。
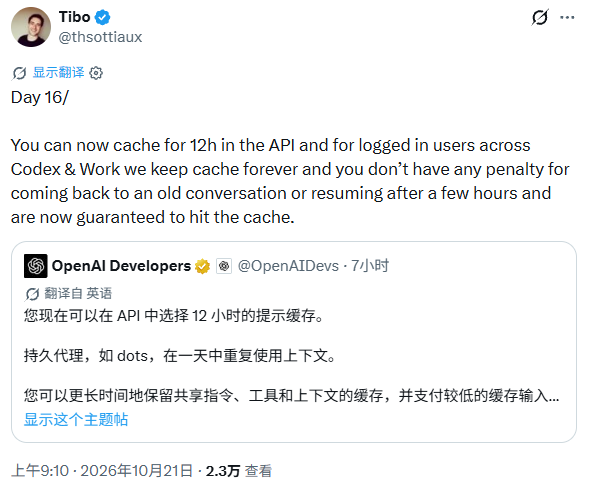
今天 Tibo 宣布的 Day16 更新,居然是——缓存命中永不过期???
现在 API 的缓存时长可达 12 小时;对于 Codex 和 Work 的登录用户,平台会永久保留缓存。也就是说,回到旧对话或隔几个小时再继续时不会受惩罚,而且保证能命中缓存。
不是哥们,昨天 DeepSeek 刚公布缓存优化,今天 Tibo 就宣布跟进?刚开源一天就被 OpenAI 偷师了?
永久缓存这件事确实离谱。DeepSeek v4.1 Flash 每个 token 的 KV 已经做得非常小,跟别的模型差了十几倍,大概是 890B。如果 OpenAI 真的把这些 cache 永久存在 SSD 上,成本得直接爆炸。
所以更大概率还是 OpenAI 自己买单。设定一个缓存窗口,窗口之后即使重新计算,也按命中计费。这算是最近比较 nice 的更新了——当然,前提是不暗地里砍额度。
不过 OpenAI 最近也确实没掏出啥像样的更新,频繁重置。明显感觉身边朋友都没以前那么期待重置了,额度也蹬不完。但说实话,从这周开始,额度明显没以前耐用了。
关于“降智”和限流
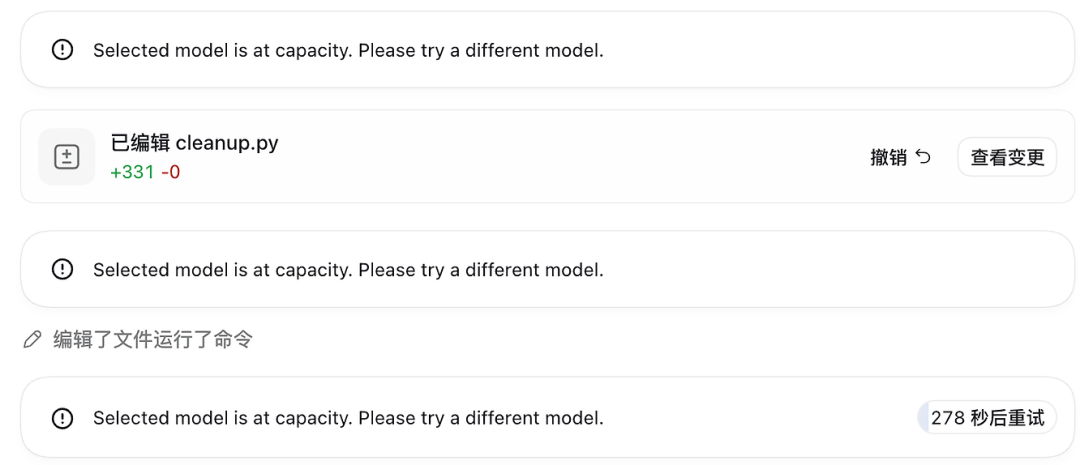
很多朋友吐槽的 GPT 降智问题,包括限流、满屏的 selected model is at capacity,好像就是纯粹的账号封控。我换成美区账号一个月,基本没怎么再出现过这个提醒。
梁叔叔把作业都摆出来了,这波真是给 Claude 和 Anthropic 它们吃上好的了。可能过几天的改进,就是把 200 tps 推理速度也抄走,然后再反过来指责咱偷窃他们的技术。 |  发表于 1 小时前
|
查看: 9|
回复: 0


