这段时间,Claude Code 的封号问题实在让人头疼。我也被封了,后来开通了 Codex。
换个工具继续干活,我能接受。可之前跟 Claude Code 商量过的方案、试过没走通的路,到了 Codex 这边,怎么接着用?总不能每换一次工具,就重新交代一遍项目。
带着这个问题,我去看了 ai-memory。它的 README 开头写的就是这个场景:退出 Claude Code,在同一目录打开 Codex,继续之前没做完的事。我想知道,这份交接到底能带走多少东西。
项目说明里,通常没有刚才那次讨论
项目目录还在,代码也还在,Codex 可以重新读。但有些事情,光看代码未必看得出来。
比如,某个写法为什么被放弃了,哪个报错已经查过,这次准备改到什么程度就停。这些细节可能只留在对话里。
CLAUDE.md、AGENTS.md 这类项目记忆文件适合放长期约定:怎么构建、怎么测试、目录怎么用。把每次讨论都往里面塞,很快就会变成一本没人愿意翻的流水账。
ai-memory 的做法是另外记。接入助手后,它通过钩子记录提示和工具调用。钩子就是在会话开始、结束等时刻自动运行的小程序,不用每次都提醒它“把这件事记下来”。
会话结束后,记录会被整理成 Markdown 页面,供后续搜索。按项目说明,Markdown 文件是记忆的原本,SQLite 数据库负责建索引;默认用法不要求额外配置大模型 API 密钥。
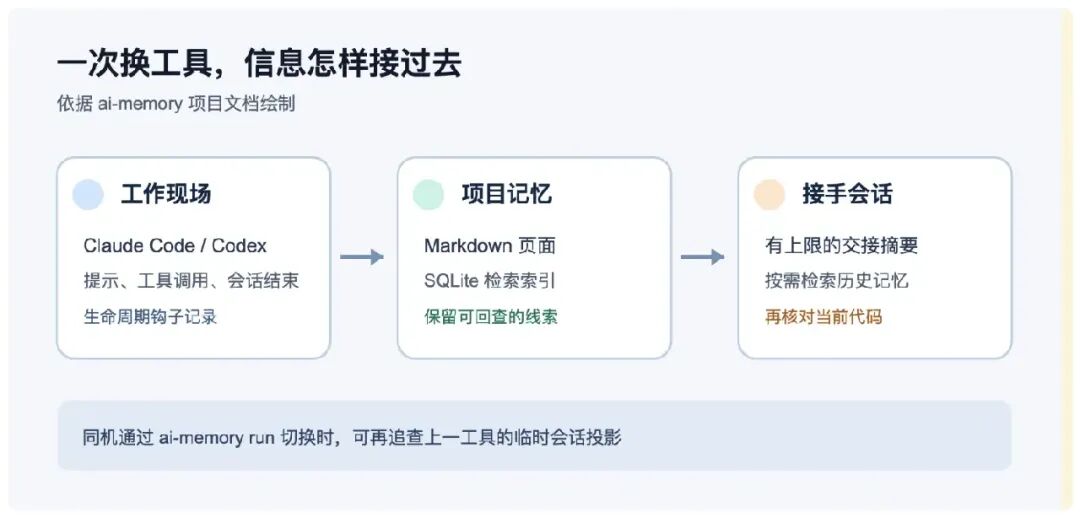
图 1:ai-memory 怎样把会话记录交给下一位助手,据项目文档绘制。
新助手先收到一份交接,需要时再查细节
装好钩子后,上一段会话结束时留下交接,下一段会话启动时接收。做到哪了、还卡着什么问题,新助手先看这份材料。
不过,交接摘要有长度上限。之前讨论过的一句话、某次工具输出,不一定会出现在里面。
我继续翻文档,看到它还提供了 ai-memory run 这种启动方式。在同一台机器上通过它切换工具时,可以把上一工具可读取的原生会话记录整理为临时文件,让接手的助手回头查。
如果换了机器,服务端的交接和记忆仍然可以共享,但另一台机器读不到只存在原电脑上的会话记录。
还有一个容易漏的条件:项目支持矩阵写明,Codex CLI 从 0.145.0 起接入了 SessionEnd 事件,才能在会话结束时自动做这份交接。更早版本的替代命令是 ai-memory finalize-session --agent codex。
读到这里,我对它的期待更具体了:先让新助手知道进度,漏了什么再查。至于账号已经被封、之前又没接入 ai-memory 的旧会话,能补回多少,要看本机留存的记录和具体接入方式,这部分我还没有验证。
先看看你究竟丢了哪段信息
| 你遇到的情况 |
先用哪种材料 |
接手时怎么核对 |
| 新会话要遵守项目规则 |
CLAUDE.md / AGENTS.md |
打开当前文件,确认命令和约定还有效 |
| Claude Code 做到一半,改由 Codex 继续 |
ai-memory 会话交接 |
让接手助手说出未完成事项,再对照当前代码和任务清单 |
| 想找几周前为何放弃某个方案 |
ai-memory 的 Markdown 记忆与检索 |
找到对应记录,确认它适用于当前分支和版本 |
| 交接摘要漏了上一轮的一句关键原话 |
同机、通过 ai-memory run 切换时提供的临时会话文件 |
查原话和相关工具输出,不凭摘要补全 |
| 仓库包含敏感材料 |
先评估记录范围和存放位置 |
查看捕获排除规则、服务端配置和谁能读到记忆 |
如果你只缺项目的构建命令,把 AGENTS.md 写清楚就能解决不少问题。经常换会话、换工具,反复交代做到了哪一步,才更值得试试 ai-memory。
装好以后,要真的换一次工具试试
准备试用的话,先按官方安装文档装好程序,再运行下面这条命令,看看它打算接入哪些助手:
ai-memory setup --plan
这一步只打印计划,不改配置。输出会列出检测到的助手和准备写入的钩子、MCP 配置。MCP 是助手调用外部工具的接口,这里用来读写 ai-memory。
确认计划后,再运行交互式 ai-memory setup。接入 Codex 时,还要到 Codex 的 /hooks 中检查并信任对应钩子,然后重启助手。安装程序也会提示有没有漏掉这一步。
接下来挑一个普通测试项目,让一个还能使用的助手留下一件明确没做完的事,结束会话,再换另一个助手接手。比如还有某个测试没通过,让接手的助手说清楚卡在哪、相关文件在哪里。
这样比问一句“你记得什么”更容易看出问题。它究竟读到了交接,还是重新扫了一遍代码猜出来的,要看它引用的记录。
如果没接到交接,先查钩子是否启用、上一段会话有没有结束,再核对工具版本。想通过 ai-memory run 查原生会话细节,还得确认记录在同一台机器上。
存下来的旧结论,也得回头核对
我也看了它的数据处理说明。默认配置把记忆留在本机,不带遥测。云端嵌入、捕获助手最终回复等功能,需要额外开启。安全文档把静态数据加密列为未覆盖项,也明确说凭据清理无法保证抓住所有秘密。
如果团队共用服务端,或者准备接云端嵌入,先看清楚哪些内容会被传出去。云端嵌入会把文字发给模型服务商处理,已有的记忆页面也可能被处理。
还有一件事要自己盯着:旧记录里的结论,今天还成立吗?当时放弃的方案,可能是因为那时的依赖版本有问题;当时通过的测试,换个分支未必还能过。涉及权限、数据和安全的修改,仍要对照当前代码检查。
账号被封之后,我更在意项目进度能不能掌握在自己手里。ai-memory 还得实际跑一次,尤其是那张表里的“当前进度”,我想看看 Codex 接过来时,到底能说清多少。
参考来源
 发表于 前天 08:01
|
查看: 6|
回复: 0


