对于整天和 Agent 打交道的开发者来说,“遗忘”一直是个绕不开的痛点。你上午花了两个小时和 AI 讨论方案,下午回来想接着改,结果它又从头开始计费、重新理解上下文,Token 烧得肉疼。OpenAI 这次把这个问题解决了一半。
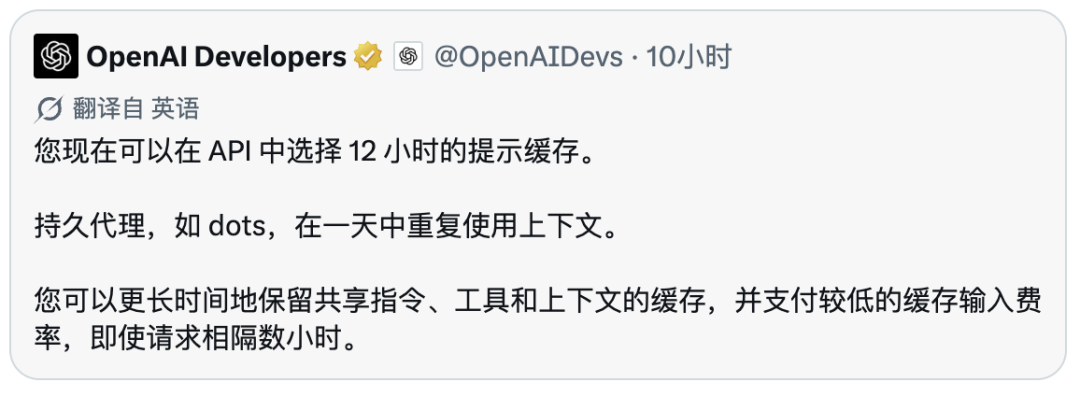
根据 OpenAI 官方说明,本次 Prompt Caching 机制迎来了一次不小的升级,一句话概括:
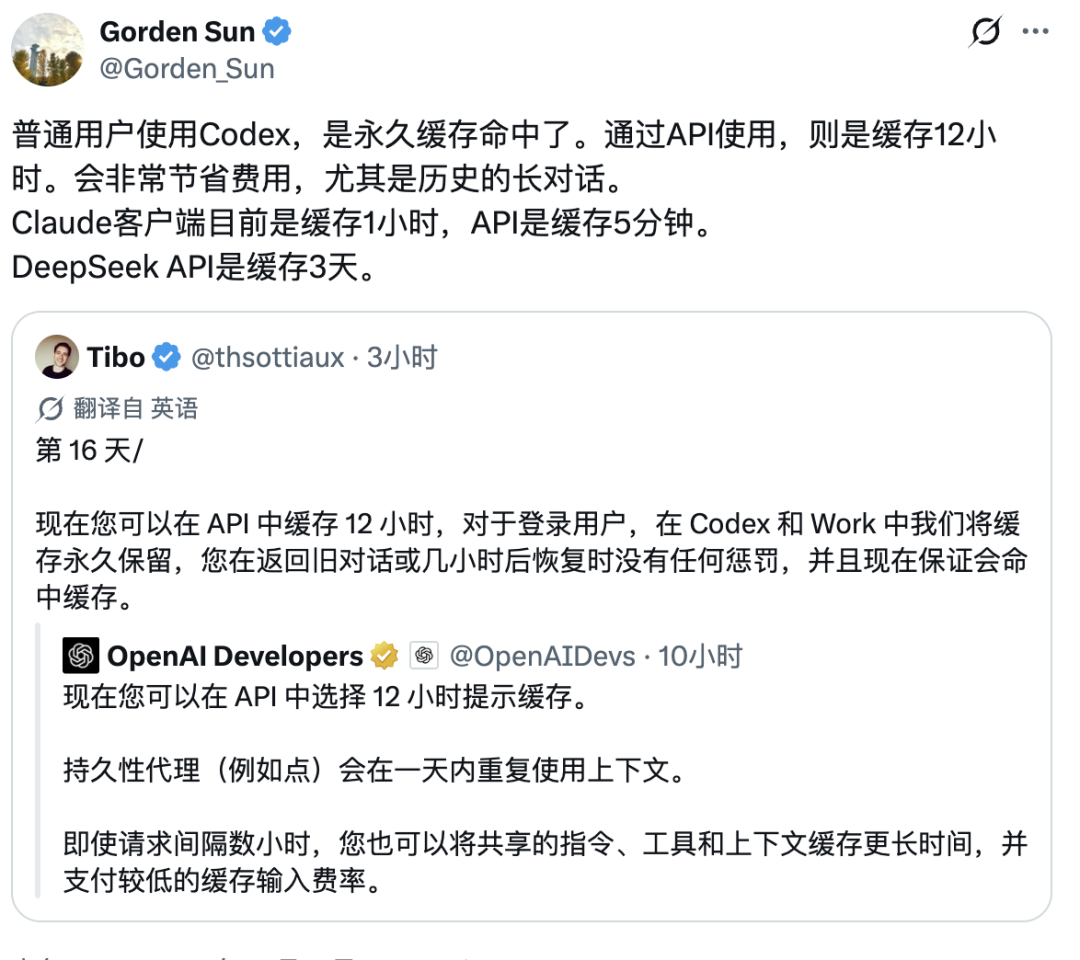
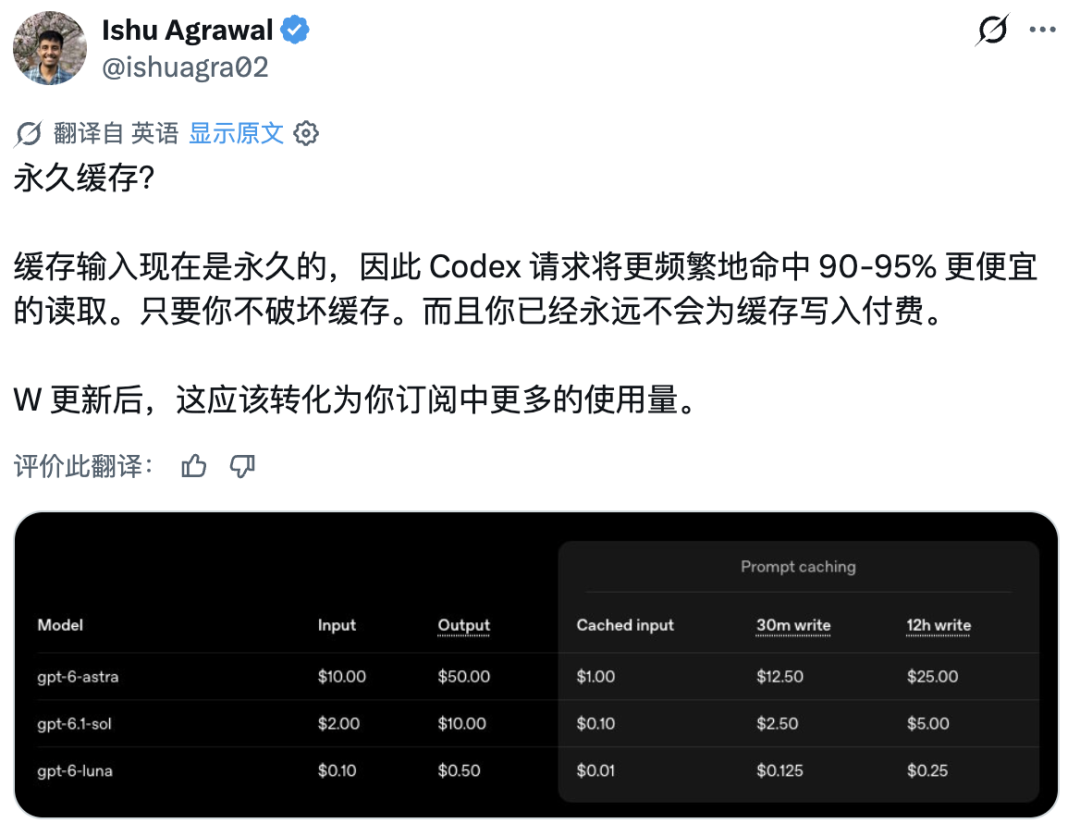
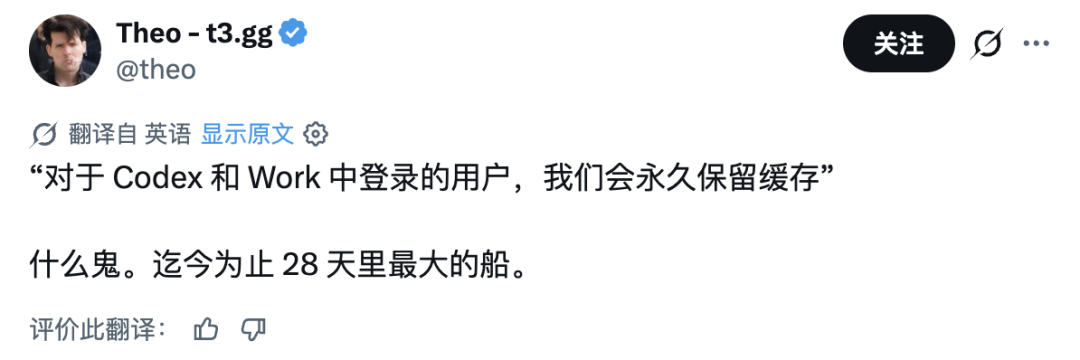
API 里缓存时间从默认的 30 分钟,延长到了可选的 12 小时;而对 Codex 和 Work 的登录用户,直接永久缓存(keep cache forever)。
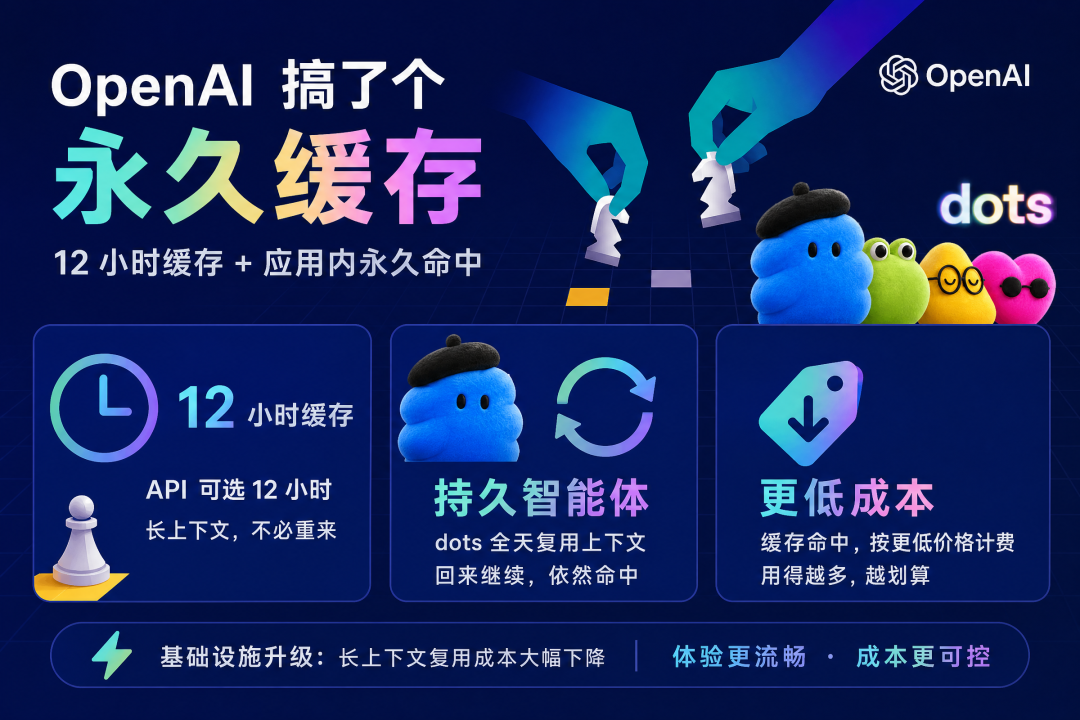
从30分钟到12小时:Agent的“长期记忆”有着落了
先简单解释下背景。Prompt Caching 已经是大模型 API 的标配优化:你把指令、工具定义、参考资料这类“上下文前缀”发给模型,短时间内(以前一般是 30 分钟)再次发送相同前缀,模型就会按更低的缓存输入费率计费,响应也更快。
但问题是,对“持久 Agent”来说,30 分钟实在太短了。
所谓持久Agent,指的是像 dots 这类一整天持续运转、反复复用同一份上下文的 Agent 产品。它们的典型场景是:指令、工具、系统设定都是固定的,变的只是每次的具体任务。但 30 分钟的缓存窗口意味着——出去吃个午饭,缓存就过期了,回来就得全价重算。
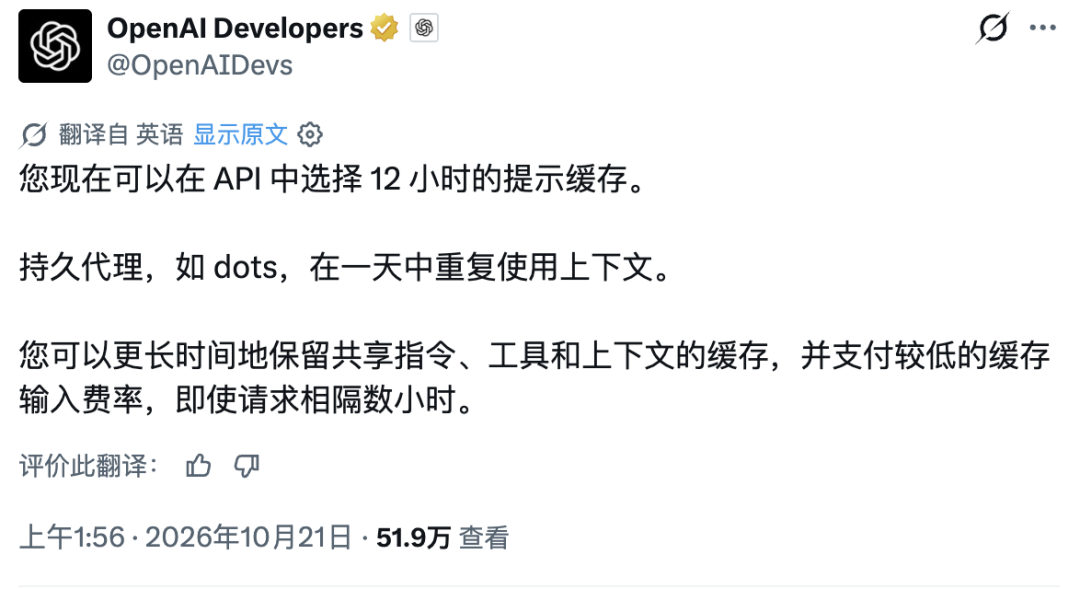
现在,开发者可以直接选择 12 小时 TTL(缓存生存时间)。
官方举的例子也很直观:像 dots 这样的持久 Agent,整天都在复用上下文。现在你可以让共享指令、工具和上下文缓存得更久,哪怕请求之间隔了好几个小时,依然能享受缓存输入的低价。
Agent 可以“睡一觉再回来接着干”,上下文不用从头喂。
Codex 和 Work 更狠:登录用户直接永久缓存
如果说 12 小时算是“放宽”,那 Codex 和 Work 这边就属于“放飞”了。
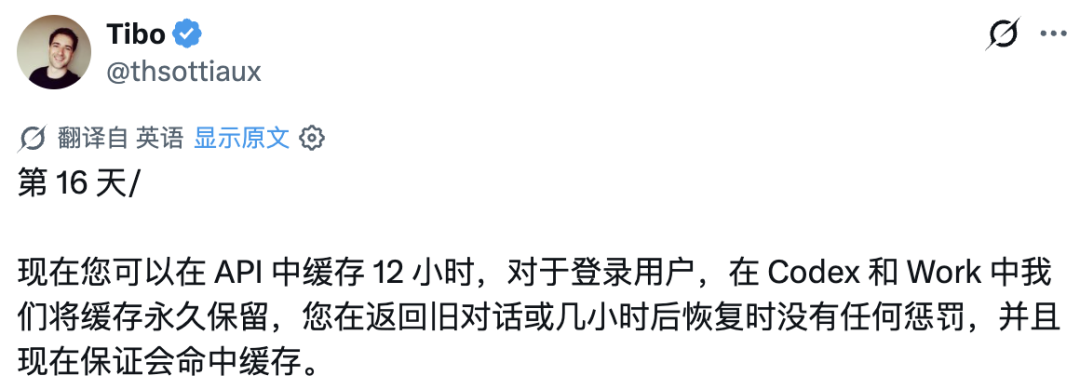
相关负责人 Tibo 的原话是:
“对于登录用户,我们在 Codex 和 Work 上永久保留缓存(keep cache forever)。你回到一条几小时前的旧对话、或者中断几小时后恢复,不会有任何惩罚,并且保证命中缓存。”
注意这几个关键词:
- 永久缓存:没有 12 小时的限制,老对话什么时候回来都行;
- 零惩罚:恢复旧会话不再有任何成本上的“惩罚性”计费;
- 保证命中:只要是对话中已处理过的上下文,缓存命中率直接拉满。
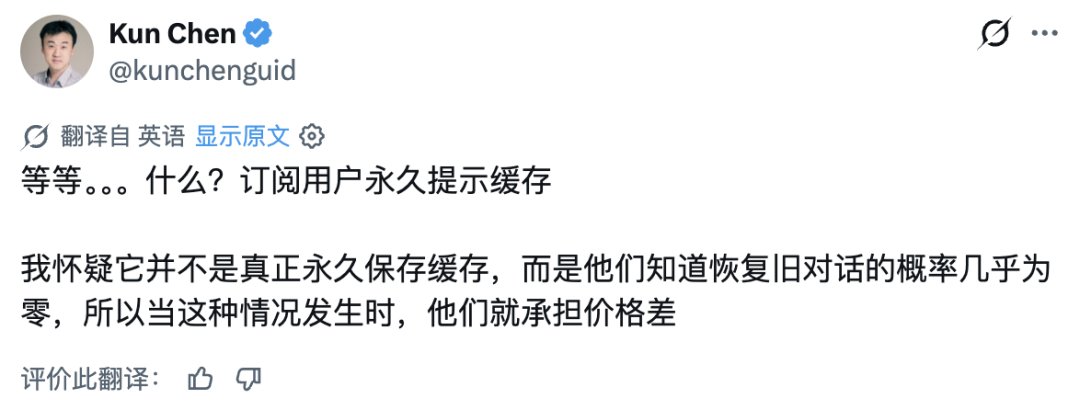
对重度 Codex 用户来说,这基本就是把长会话当成一个“可中断、可续接的工作区”——早上没写完的代码,晚上接着写,上下文还是缓存价。
成本账:贵一点,但更省
可能有人会问:12 小时缓存是不是更贵?
答案是:缓存写入的单价更高,但只要你反复复用同一份上下文,整体成本反而更低。
逻辑很简单:长上下文处理一次成本不低,但如果只处理一次、之后一整天都按缓存低价复用,多次调用的边际成本就会被大幅摊薄。只有那种“高频短会话、前缀又经常变”的场景,12 小时才不一定划算——这时候 30 分钟反而是更稳的选择。
实操指南:怎么把这份红利吃满
如果你是 Codex / Work 用户:
几乎是无脑受益。直接把长会话当“可中断继续”的工作区用,隔几小时甚至隔天回来,尽量命中缓存,额度消耗会明显友好。建议去账单里看一眼 cached_tokens(缓存 token 数)是否真的够高,验证一下命中率。
如果你是 API 开发者:
- 把一天内不变的内容放最前面:指令、工具定义、参考材料,统统塞进上下文前缀,并设置 12 小时 TTL;
- 会话级动态内容用 30 分钟或更短:支持一个请求里混合 TTL,静态前缀长缓存、动态内容短缓存;
- 盯紧官方 Prompt Caching Dashboard:监控缓存命中率,算清楚“写入溢价 vs 多次读取节省”这笔账;
- 工具定义尽量稳定:通过
allowed_tools 等方式控制工具变化,避免前缀频繁变动导致缓存失效(cache miss)。
判断标准就一条:你的 Agent 或会话是不是“全天断续复用同一套上下文”?是——直接上 12 小时;如果属于高频短会话、前缀也经常变——那还是老老实实 30 分钟。
表面上看,这只是一次缓存策略的调整。但往深了看,这是基础设施层在系统性地降低长上下文复用的成本。
Agent 产品能不能持久运行,很大程度上取决于“记忆”的经济性——如果每一次“想起”都要全价付费,再聪明的 Agent 也跑不起长任务。12 小时缓存、乃至产品端的永久缓存,等于把这块最贵的基础设施成本打了下来。
对重度 Codex 用户和做持久 Agent 的团队来说,这不是一个“可选优化”,而是实打实的体验 + 成本双重改善。
Agent 的“长期记忆”,从这一刻起,开始便宜起来了。更多 Prompt Caching 与 Agent 开发的实战经验,欢迎到云栈社区交流。
 发表于 2 小时前
|
查看: 9|
回复: 0


