让 Codex 真正读懂动态网页,Firecrawl 值得拆开看。
我每天都会让 AI 帮我联网找资料,盯 GitHub 热榜、翻项目文档、看热门信息,基本都靠它。
但 Codex 自带的联网能力确实比较弱。读静态 HTML 没问题,一遇到 JS 渲染的页面就直接抓瞎:经常抓回一个空壳,它还会一本正经地告诉你这页面没内容。后来我把 Firecrawl 接上,同一个页面就能正常读了。
01 先说它解决了什么问题
Firecrawl 是一个开源的网页数据 API,2024 年 4 月发布。用法很简单:丢给它一个网址,它还给你干净的 Markdown、结构化 JSON 或者截图。
它的价值在于,网页本来是给人看的,不是给 AI 看的。导航栏、广告、页脚、弹窗全部混在 HTML 里,直接喂给模型,一个普通页面能吃掉几万 token,其中大半是垃圾。Firecrawl 只把正文抠出来。
这个项目现在已经有十八万多 Star,进了 GitHub 全站前 100,用户规模很大。
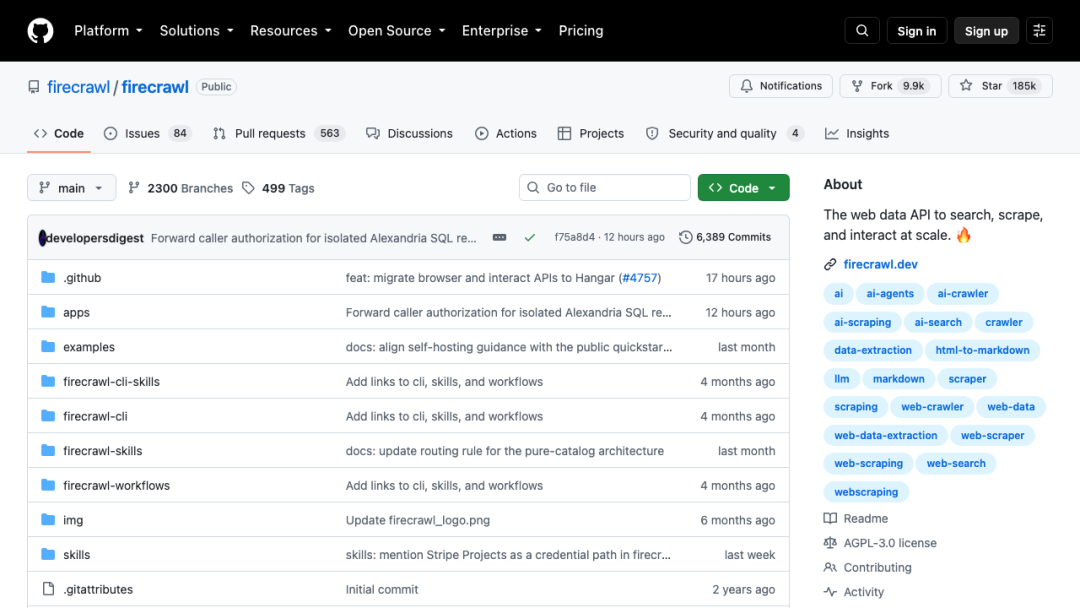
firecrawl/firecrawl 仓库首页,Star 185k
官方给的数据是 125 万开发者、15 万家公司接入,SDK 在 npm 和 PyPI 加起来每周下载 250 万次。
项目 README 的标识与徽章区
02 六个能力,拼在一起是一条流程
它提供的能力不算多,六个端点,但排在一起正好是一条从发现到交互的链路。
找源头用 Search,看全貌用 Map,拿正文用 Scrape,铺整站用 Crawl,想让它自己找就用 Agent,数据藏在点击后面就上 Interact。
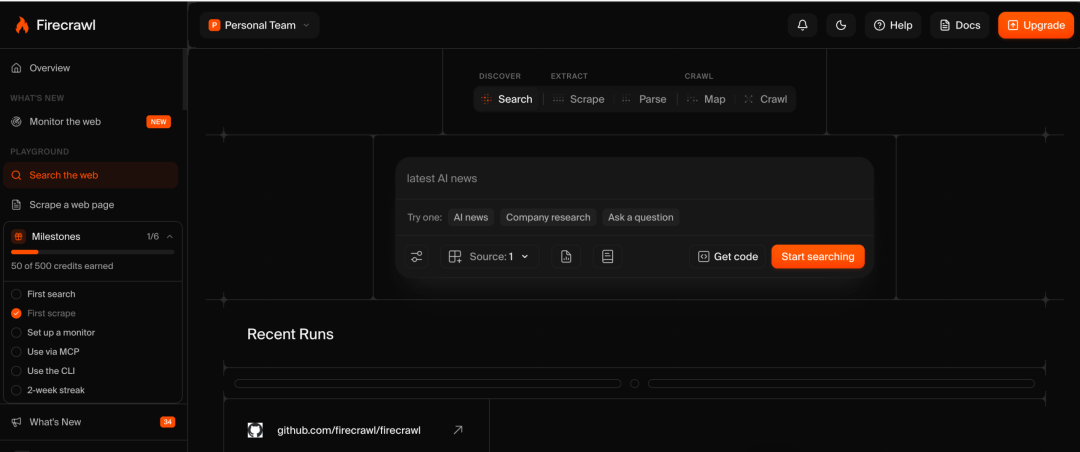
Firecrawl 控制台的实际界面
03 抓和爬,把网页变成干净的 Markdown
Scrape 是最基础、调用频率也最高的一个端点。给一个 URL,返回正文 Markdown。JS 渲染的页面,它会自己先渲染再抠内容,代理、反爬、等待加载这些都不用你操心。
除了 Markdown,还可以要原始 HTML、页面截图、页面元数据。挂一个 schema,它还能按字段直接返回 JSON,比如只取标题和价格。页面里挂着的 PDF 和 DOCX 也能直接解析,处理白皮书和财报时不用先下载再转换。
Scrape 管一页,Crawl 管一站。给一个起始 URL,它顺着链接把整个站点的页面抓回来。深度、页面数上限、路径过滤这些参数都能配。SDK 会自己轮询任务状态,抓完一次性返回,不用自己写循环等结果。官方给的 P95 延迟是 3.4 秒,做实时 Agent 场景也够用。
04 Map 和 Search,先看清楚再动手
抓之前想知道一个站有多大,可以先跑 Map。它不抓内容,只把域名下所有已索引的 URL 列出来,响应很快。
Map 还支持带搜索词。只要一个站点里跟定价相关的页面,加个 search 参数就够了,结果按相关度排好返回。写竞品监控脚本时很方便。
Search 则不需要 URL,直接给关键词。它搜完网页后,会把每条结果的完整页面内容一起带回来。以前的做法是先搜一遍再抓一遍,中间还要自己处理去重;现在一步出结果。
05 Agent 和 Interact,让它自己去点
Agent 连 URL 都不用给。说一句「找一下 Notion 的定价方案」,它就会自己搜索、阅读,返回结果和来源链接。挂 schema 可以拿结构化输出。模型有两档:spark-1-mini 便宜 60%,日常够用;spark-1-pro 贵一些,适合跨站点对比、需要钻复杂导航的活。
Interact 对付的是藏在点击后面的数据,比如电商搜索结果、需要翻页的列表,普通抓取够不着。它会先抓页面,然后你用大白话指挥它,例如「搜一下机械键盘,点第一个结果」。可执行的动作包括点击、滚动、输入、等待和按键。它会真的操作页面再返回结果,输出里还带一个实时浏览器画面的链接。
06 接进 Claude Code 和 Codex,是这篇的重点
这部分才是我写这篇文章的原因。它有官方 MCP 服务器,Cursor、Claude Code、Windsurf 这些 MCP 客户端填几行配置就能用。Claude Code 和 Codex 还有现成的 Skill,一条命令装好。
npx -y firecrawl-cli@latest init --all --browser
装完要重启一下你的 agent 才会生效。官方另外还提供 npx skills add firecrawl/skills 这个技能目录入口。走 MCP 的话,则是把下面这段塞进客户端配置里,填上自己的 FIRECRAWL_API_KEY 就能用。
{
  "mcpServers": {
    "firecrawl-mcp": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": { "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY" }
    }
  }
}
顺带一提,那个 MCP 服务器是独立仓库维护的,MIT 协议,和主项目分开。
07 我拿它试了两个活
我用的是 Codex,装完直接试了两条指令。
第一条:
搜一下最新的 Next.js App Router 更新日志,给我总结一下
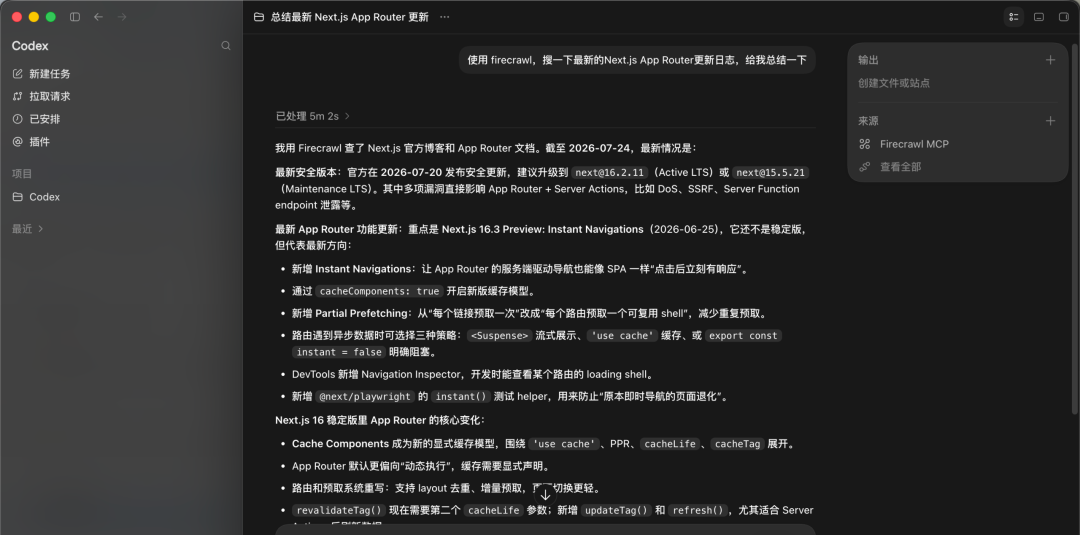
Codex 执行搜索指令后的返回
第二条:
抓取 https://docs.firecrawl.dev 这个页面,列出顶级章节
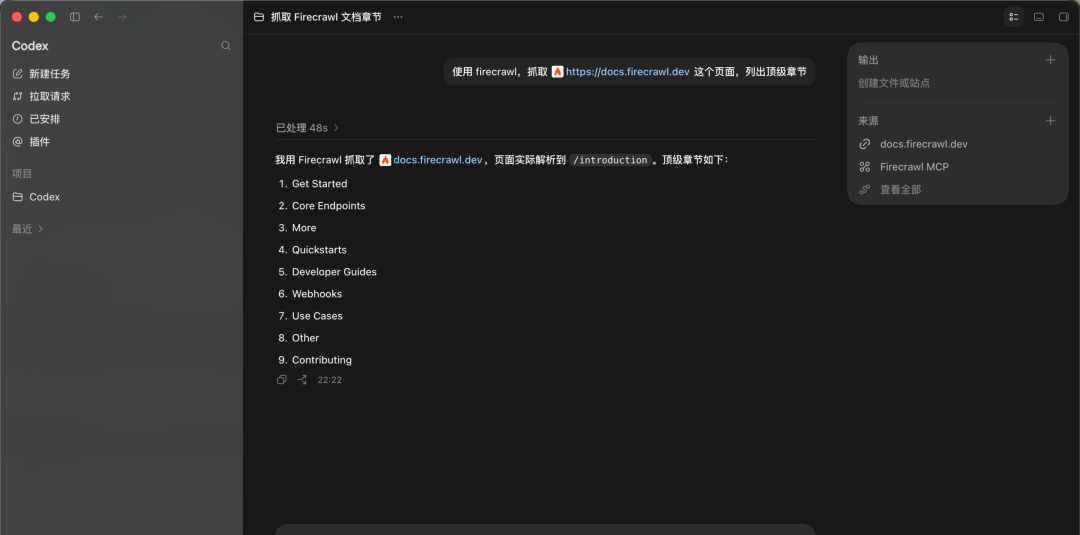
Codex 执行抓取指令后的返回
两个可能踩的坑提前说:如果报 spawn npx ENOENT,说明本地没装 Node,装上就行。目前 npm 上这两个包都要求 Node 22 以上。实在不想装 Node,也可以把配置里的本地命令换成远程地址,一样能用。
08 谁会真正用得上它
做 RAG 的,可以用它把文档站和资料站灌进知识库,比手写爬虫省心太多。
做竞品监控的,可以定时 Crawl 对手的官网和定价页,字段级 JSON 直接进库。
玩 AI 编程的,给 Claude Code 或者 Codex 接上,AI 就有了靠谱的眼睛,不再依靠训练数据里的旧信息瞎猜。我属于这一类。另外 n8n、Zapier、Lovable 这些平台也有现成集成,不写代码也能接。
09 三件事得说清楚
第一是覆盖率。官方口径是 96%,基准是一千条 URL 的测试集。剩下那部分大多是防护最严的站,抓不动就是抓不动,别指望它万能。
第二是协议。核心是 AGPL-3.0,不过 SDK 和部分 UI 组件是 MIT。云版另有额外功能,想自己搭的话,官方有独立的自建指南。商用场景先把这几条读明白。
第三是合规。它默认遵守 robots.txt,但守规矩的责任在使用者。拿它抓什么、怎么用,自己掂量。
我的判断是:这个项目火得有道理。抓取是脏活,反爬、代理、JS 渲染,自己搞一套要脱层皮,搞完还得天天维护。它把这些打包成一个 API,输出还直接贴合了 AI 的需求。网页数据这层基础设施,做 AI 应用绕不开,它目前是这个位置里最值得关注的开源选手。
仓库地址: https://github.com/firecrawl/firecrawl
这类网页抓取与 AI 接入的实践,云栈社区里也有不少开发者在交流。
 发表于 昨天 22:25
|
查看: 10|
回复: 0


