SanDisk 在 IEEE International Memory Workshop 2026 上公开的这份 HBF(High Bandwidth Flash)教程,围绕重新设计 NAND 的理念、CBA 键合与 16 层堆叠的硬件实现、三种系统架构以及仿真验证数据展开。对于想理解 AI 存储层级演进、内存墙问题以及新型闪存技术落地路径的学习者来说,这是一份相当系统的学习材料。
1. AI 推理时代的内存墙
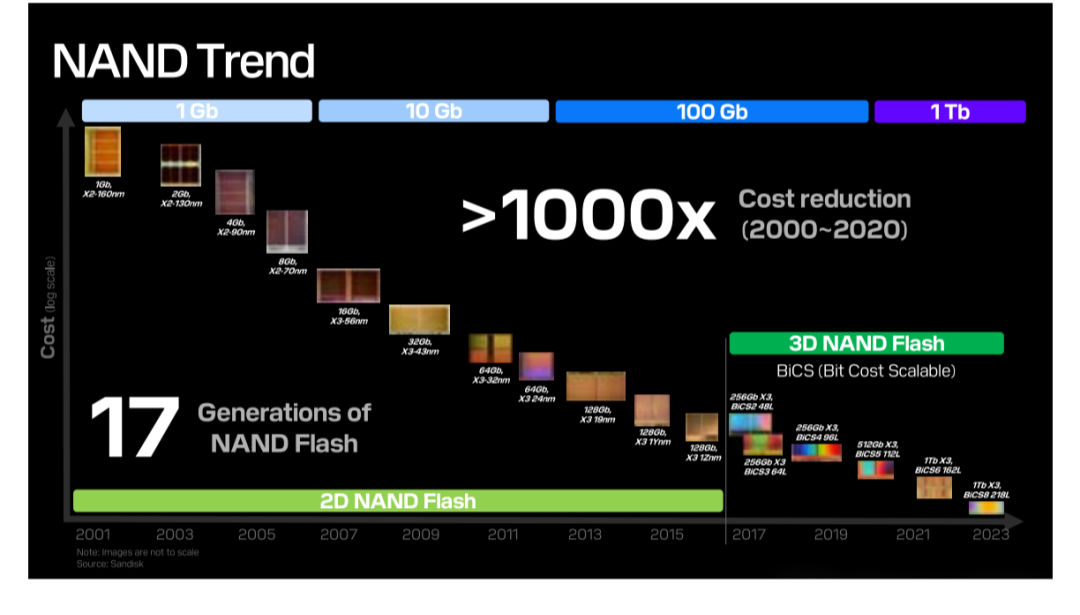
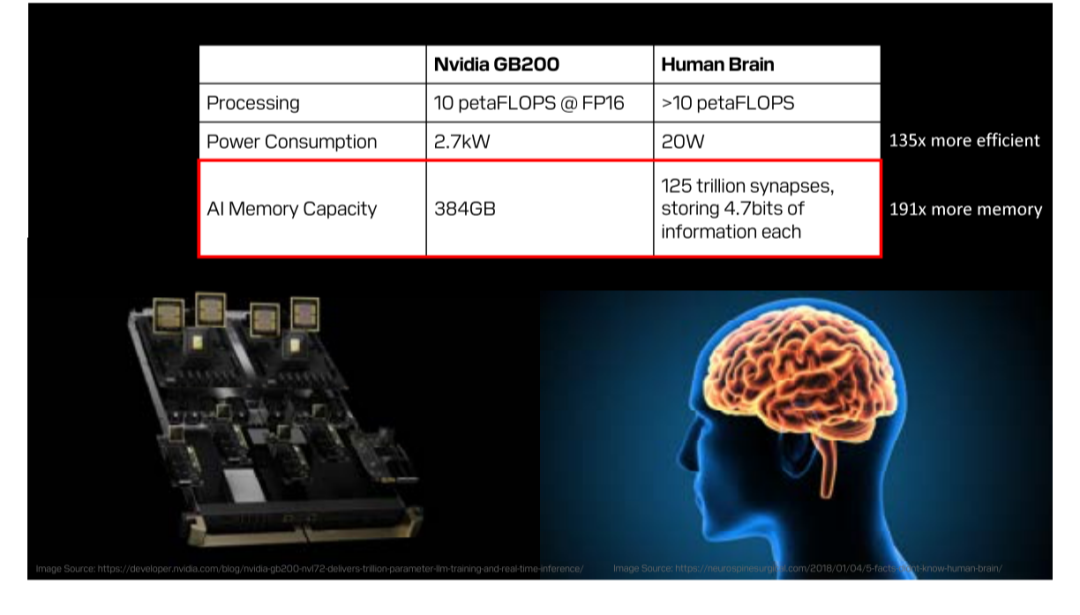
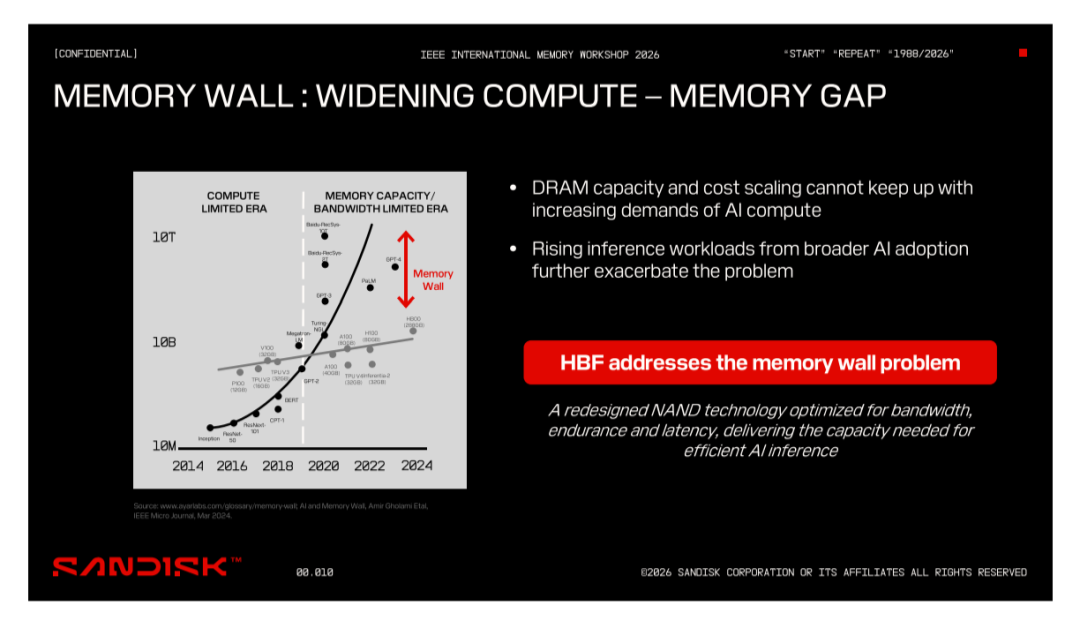
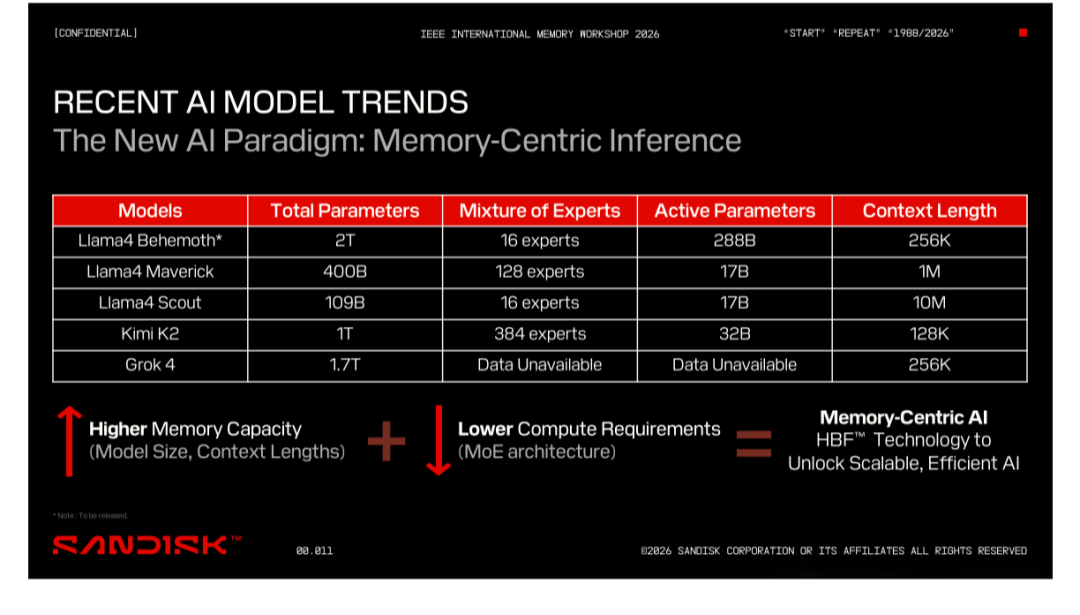
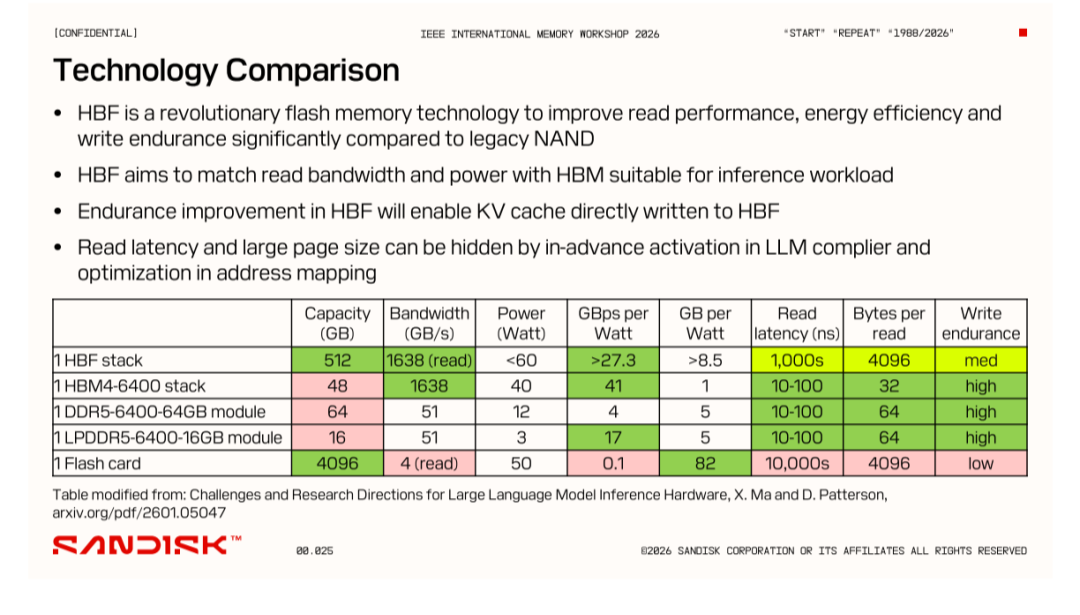
AI 模型正在变得越来越大,Llama 4 Behemoth 已经达到 2 万亿参数。但模型越大,内存容量和带宽越跟不上算力。NAND Flash 在过去二十余年实现了超过 1000 倍的成本下降,3D NAND 借助 BiCS 技术持续扩展比特成本的可扩展性。然而传统 NAND 的带宽、延迟与耐久性,并不适合作为 AI 推理 的主内存。HBF 就是为了填补这道墙而生的。
2. HBF 是什么
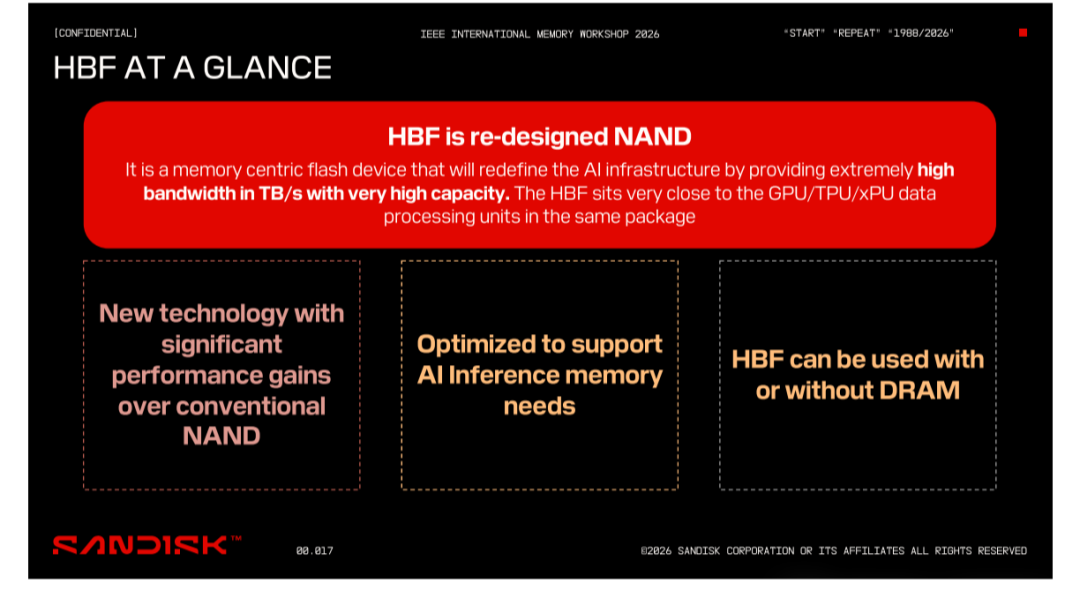
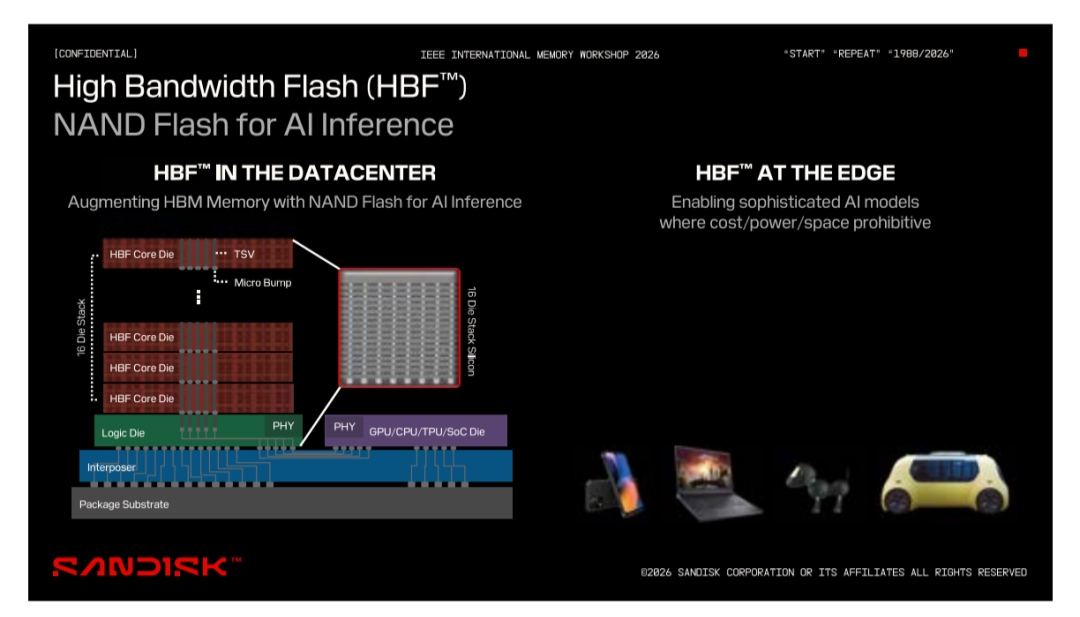
HBF(High Bandwidth Flash)是一种以内存为中心重新设计的 NAND 闪存器件,通过与 GPU/TPU/xPU 同封装紧邻部署,提供高带宽与极高容量。
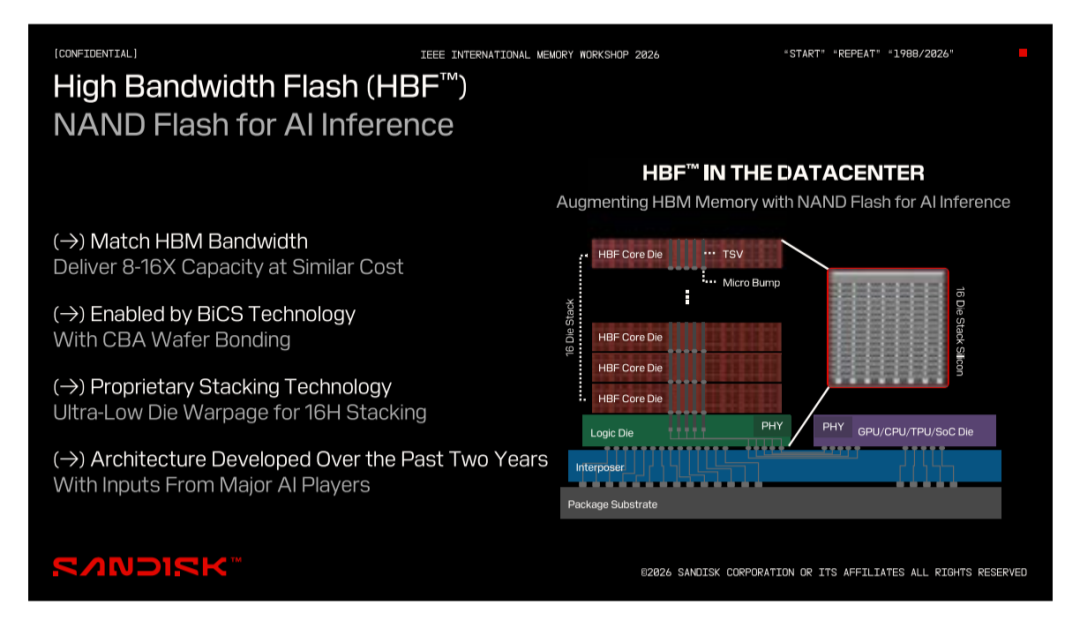
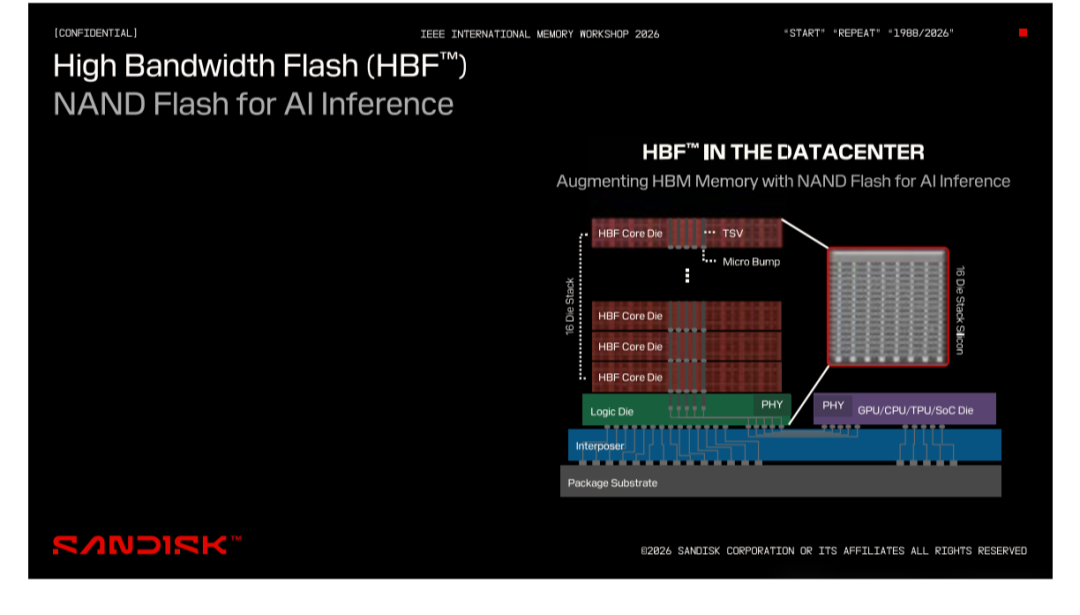
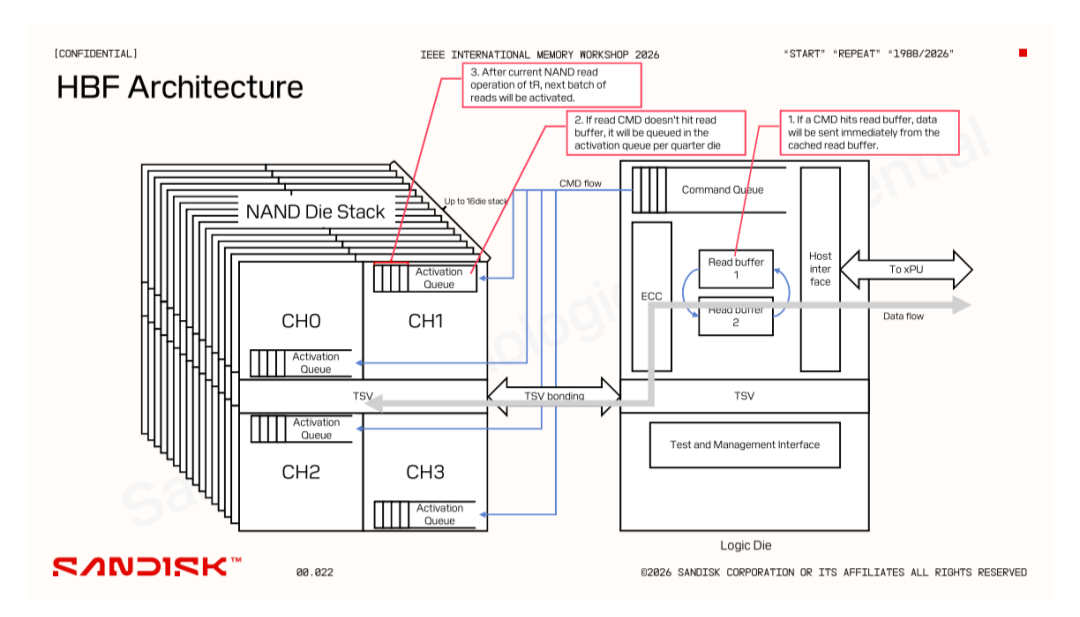
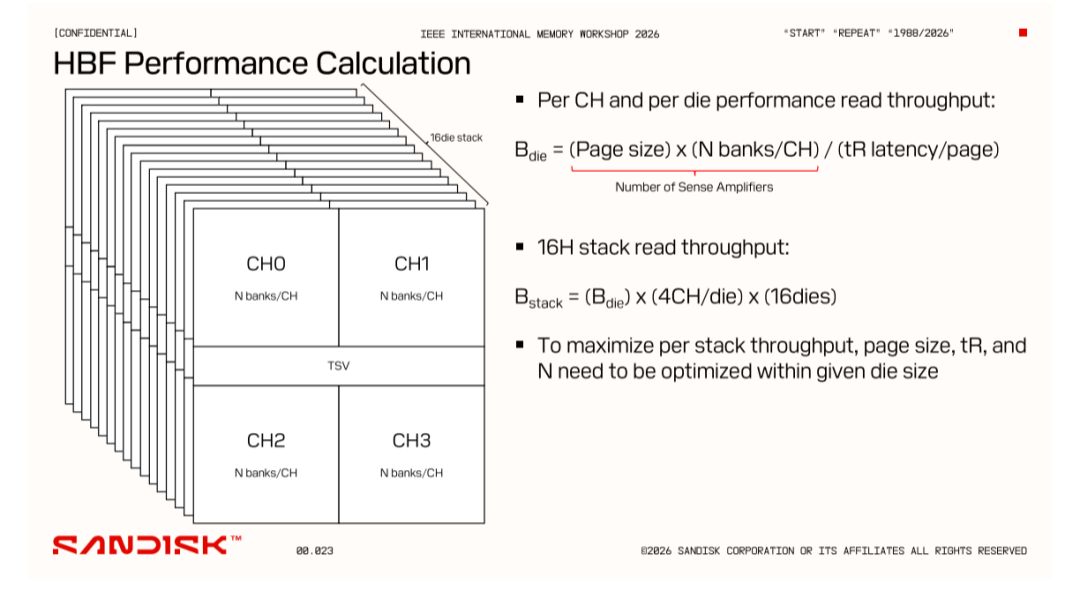
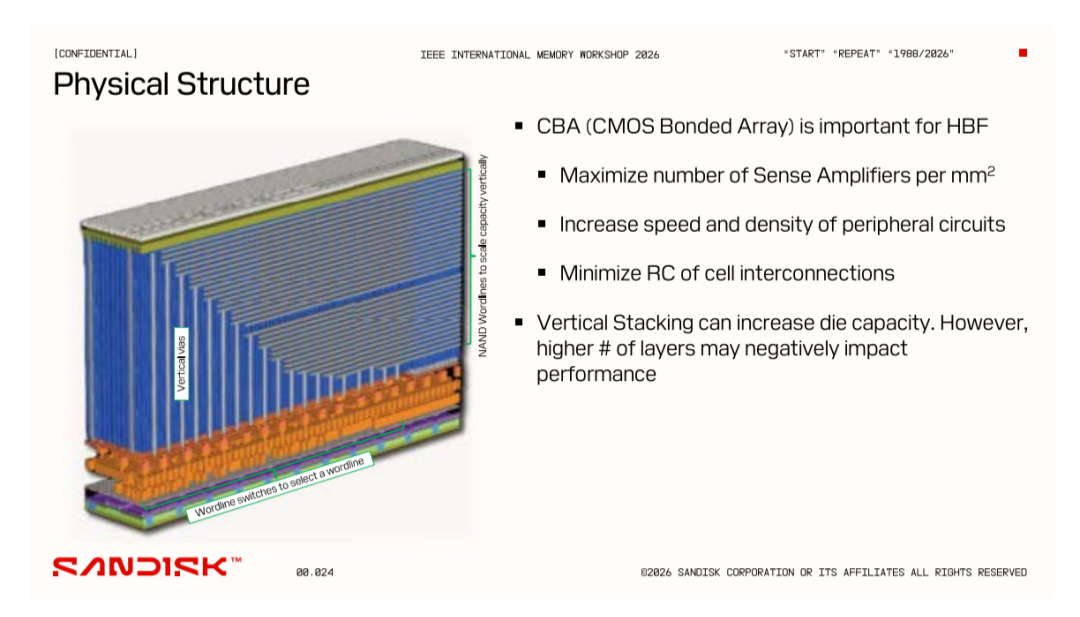
技术实现上,HBF 依托 BiCS 技术与 CBA(CMOS Bonded Array)晶圆键合:将 CMOS 外围电路与存储阵列分开制造再键合,从而在每平方毫米内最大化 sense amplifier 数量、提升外围电路速度与密度、降低单元互连 RC。配合专有堆叠技术实现 16 层 die 堆叠的超低翘曲,通过 TSV 与微凸点连接逻辑 die,再经 interposer 与 xPU 相连。
3. 三种系统架构
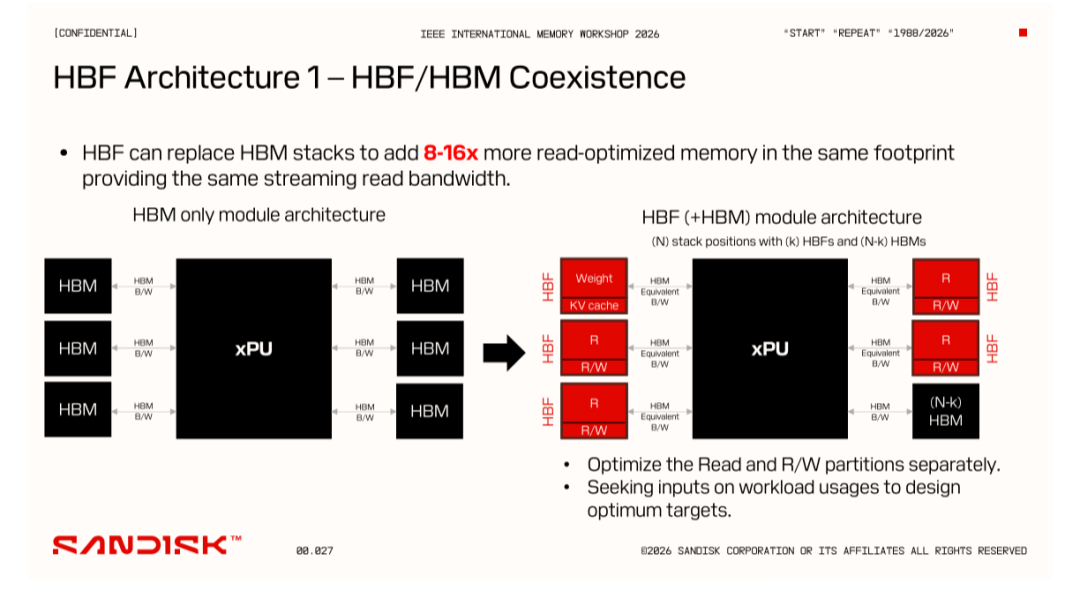
架构一:HBF/HBM 共存(或纯 HBF)。在同一封装内以相同占位替换部分 HBM 堆栈,获得 8 至 16 倍读优化内存且保持等效流式读带宽。可将只读分区(权重)与读写分区(KV cache)分别优化。
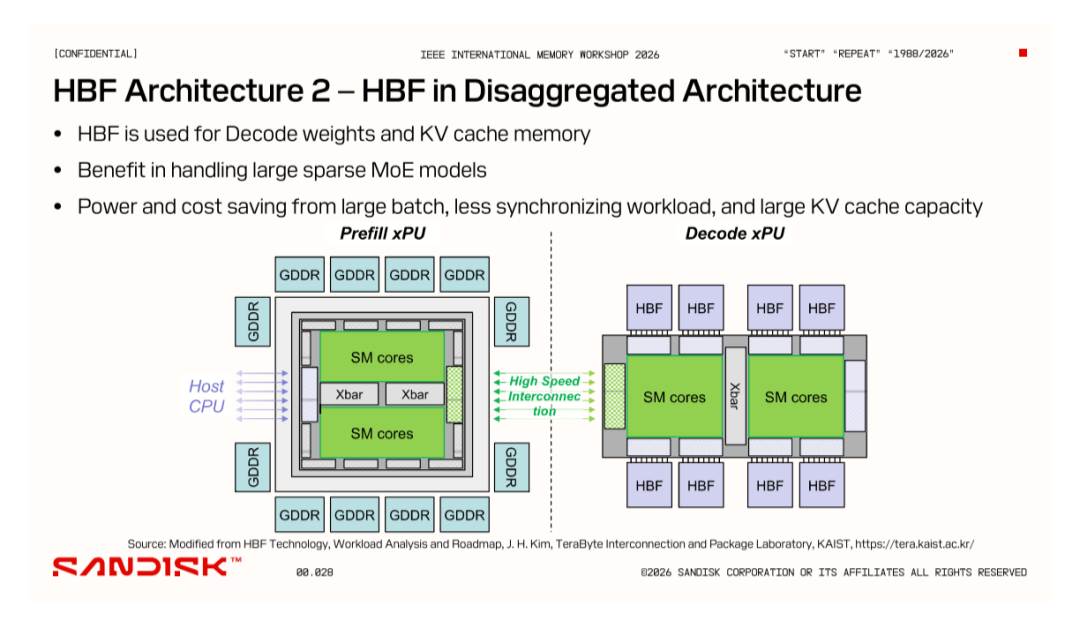
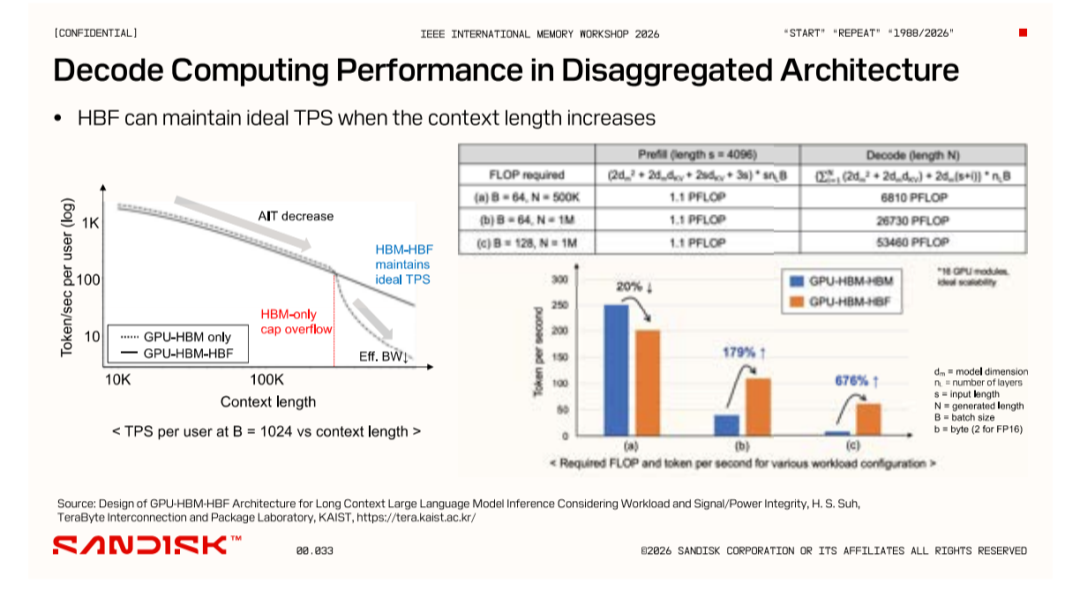
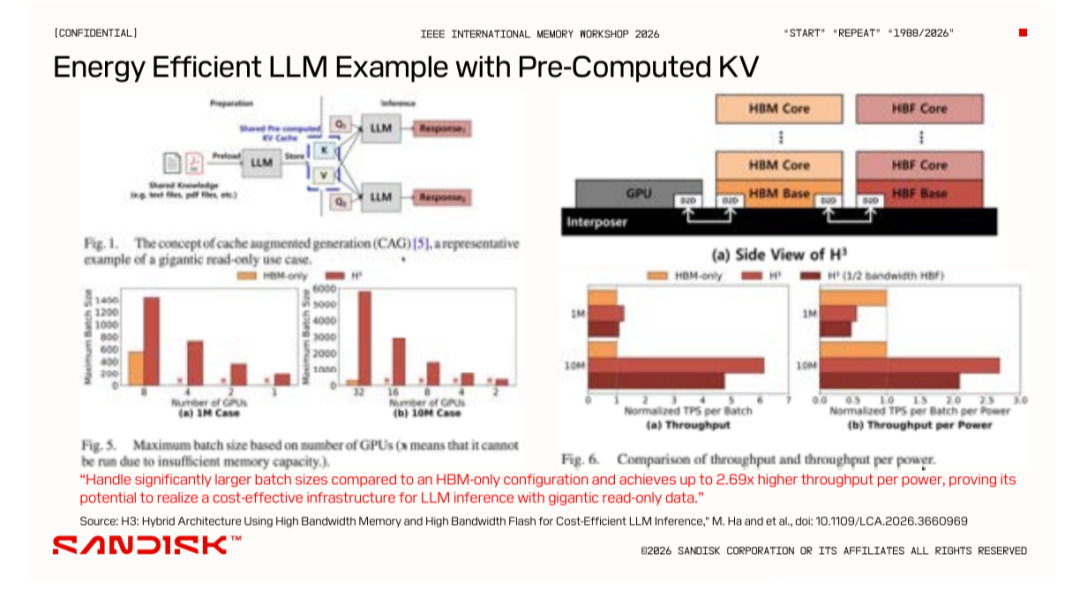
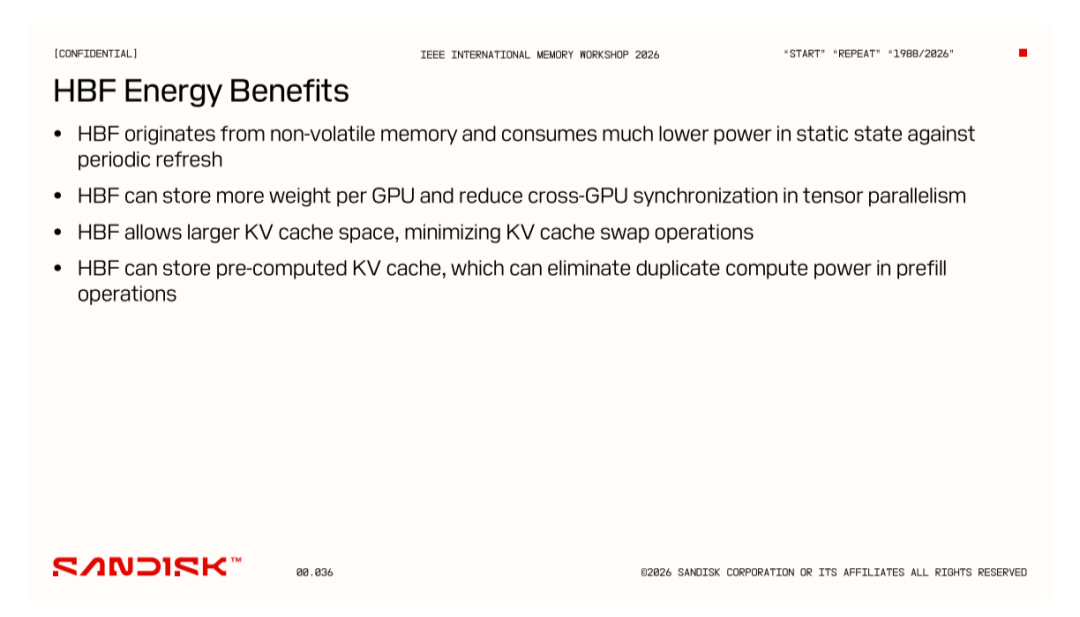
架构二:解耦架构(Disaggregated)。Prefill xPU 侧配 GDDR,Decode xPU 侧配 HBF 存储权重与 KV cache,经高速互连协同。优势在于处理大规模稀疏 MoE 模型时的大 batch、低同步开销与大 KV cache 容量,带来功耗与成本节省。
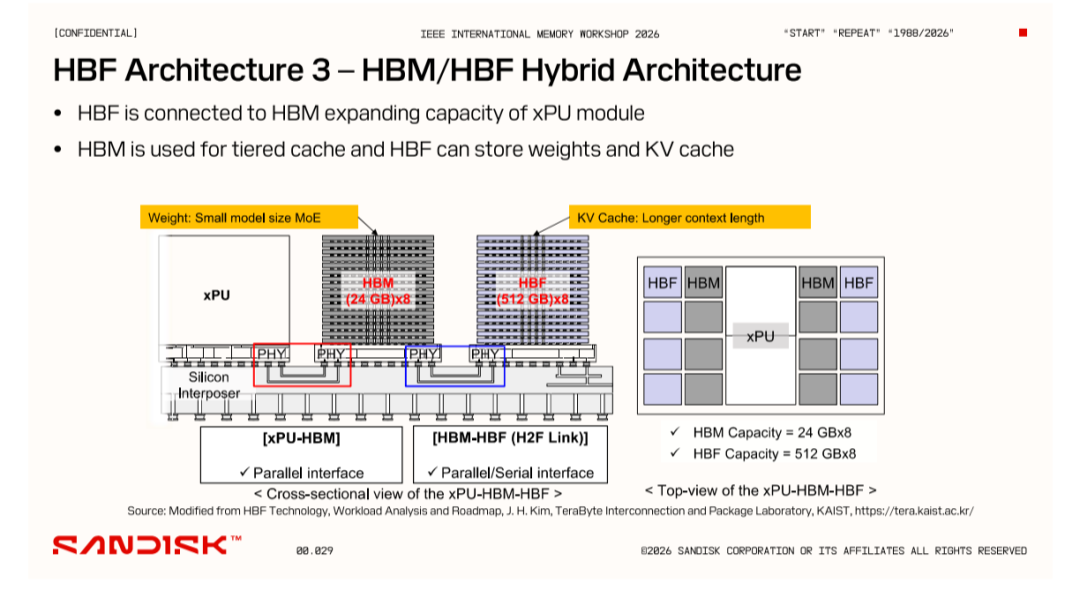
架构三:HBM/HBF 混合(H²F Link)。HBF 经 HBM 连接扩展 xPU 模块容量:HBM 作分层缓存(如 24GB×8),HBF 存权重与 KV cache(如 512GB×8),兼顾现有 xPU 架构的兼容性。
4. HBF 的收益与性能验证
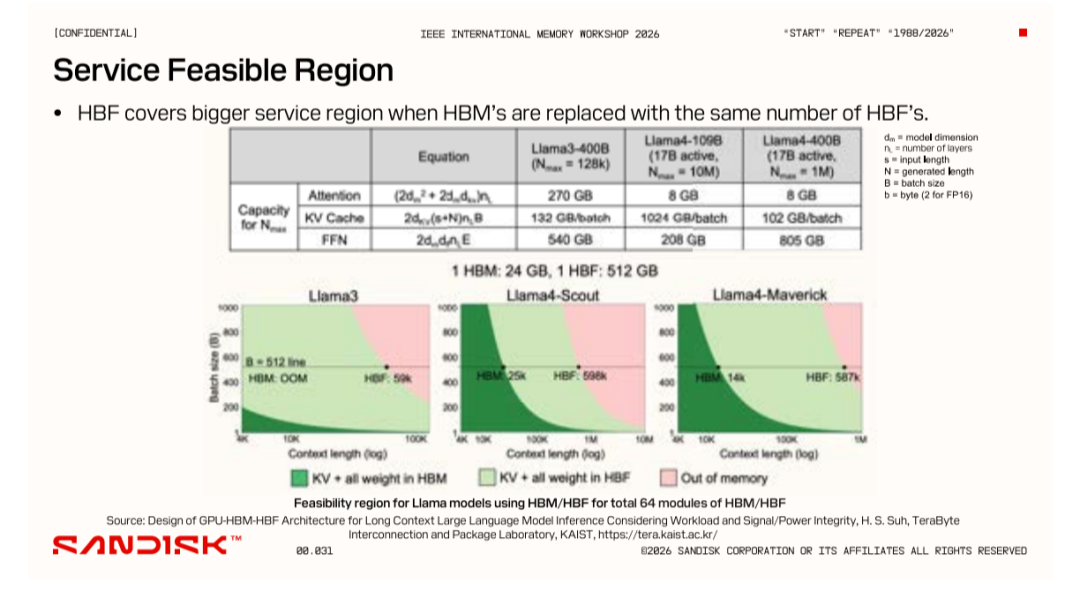
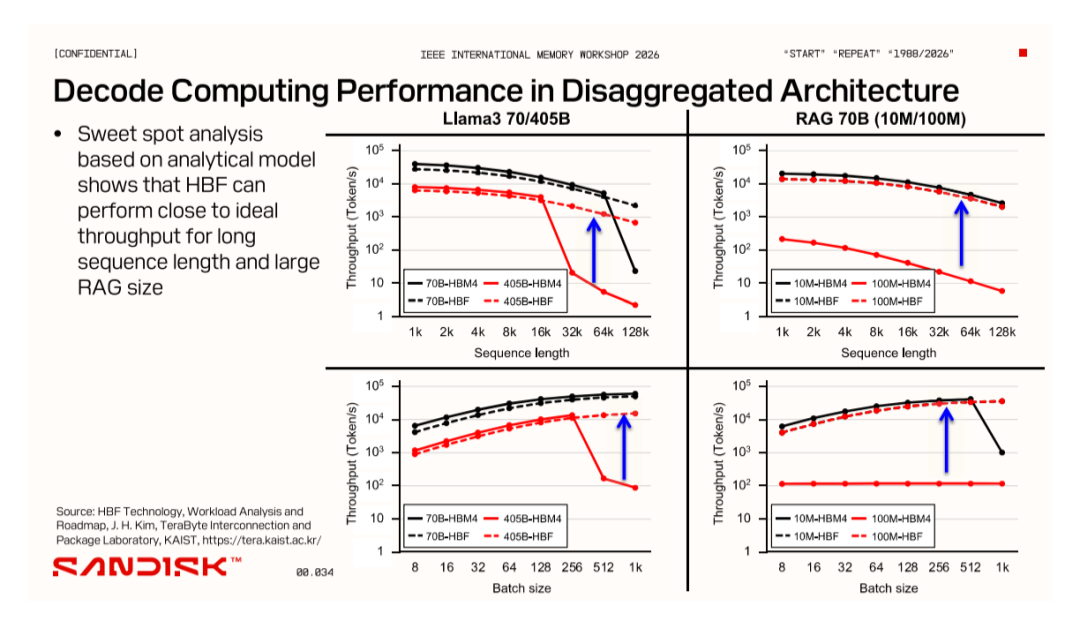
从 SanDisk 给出的数据来看,HBF 在服务可行区域上明显占优:用同等数量的 HBF 替换 HBM 后,可以覆盖更大的上下文长度与批次规模组合。对于 Llama 系列等长上下文模型,HBM-only 配置在上下文变长后很快出现 OOM,而 HBF 配置还能继续维持服务。
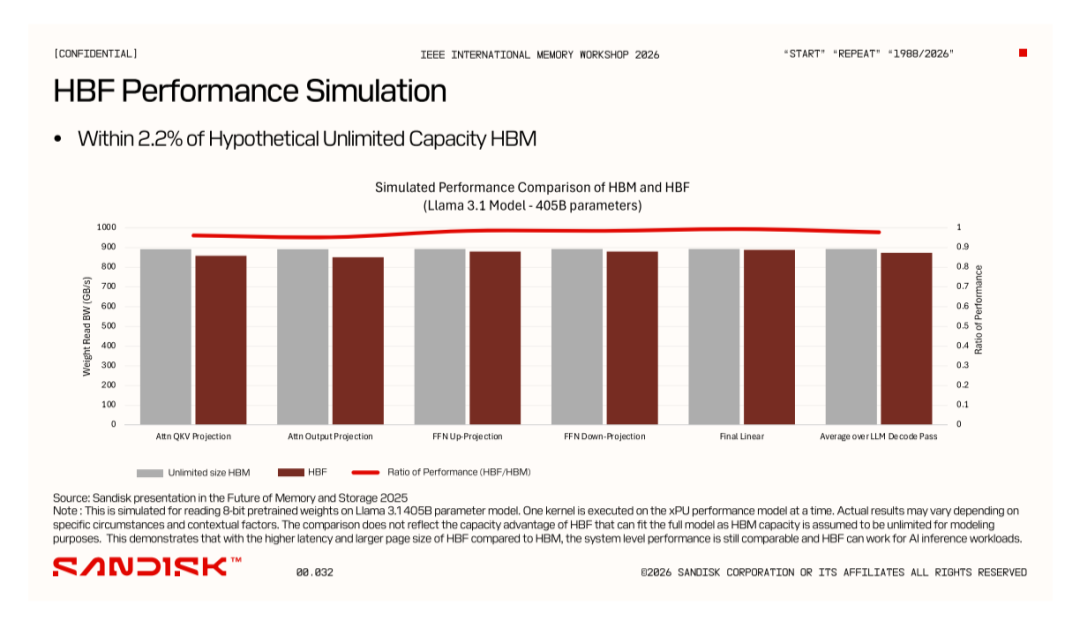
在仿真对比中,HBF 的性能大约只比“无限容量 HBM”的理论上界低 2.2%,说明尽管单次读延迟更高、页也更大,但通过 LLM 编译器的预激活和地址映射优化,系统级表现依然接近。
5. 技术里程碑与总结
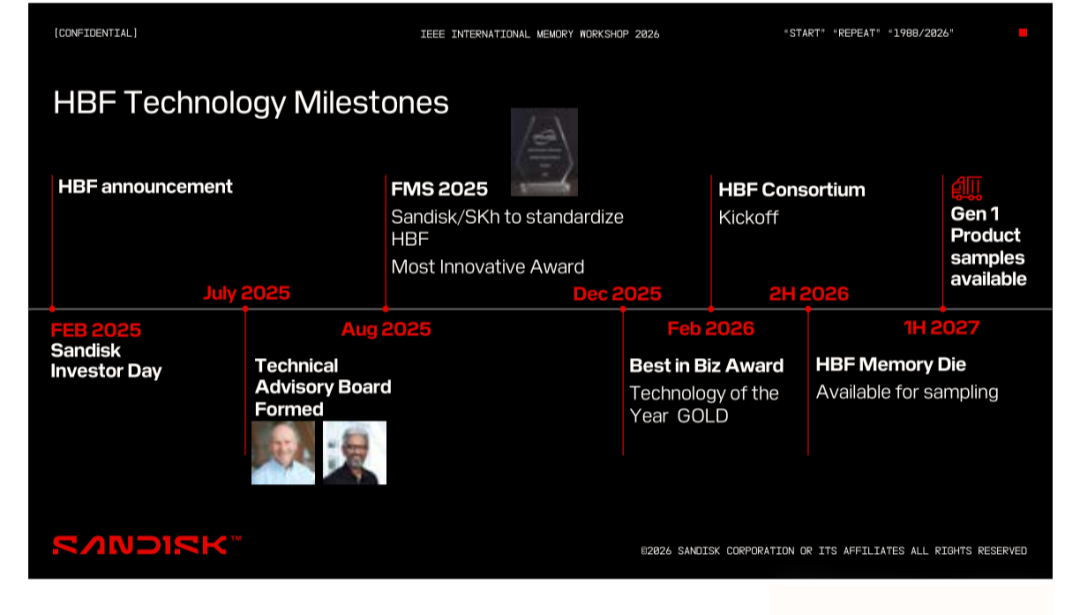
HBF 的关键里程碑已从 2025 年初的公开宣布,推进到 2026 年 HBF Consortium 正式启动,预计 2H 2026 提供 HBF Memory Die 采样,1H 2027 发布 Gen 1 产品样品。
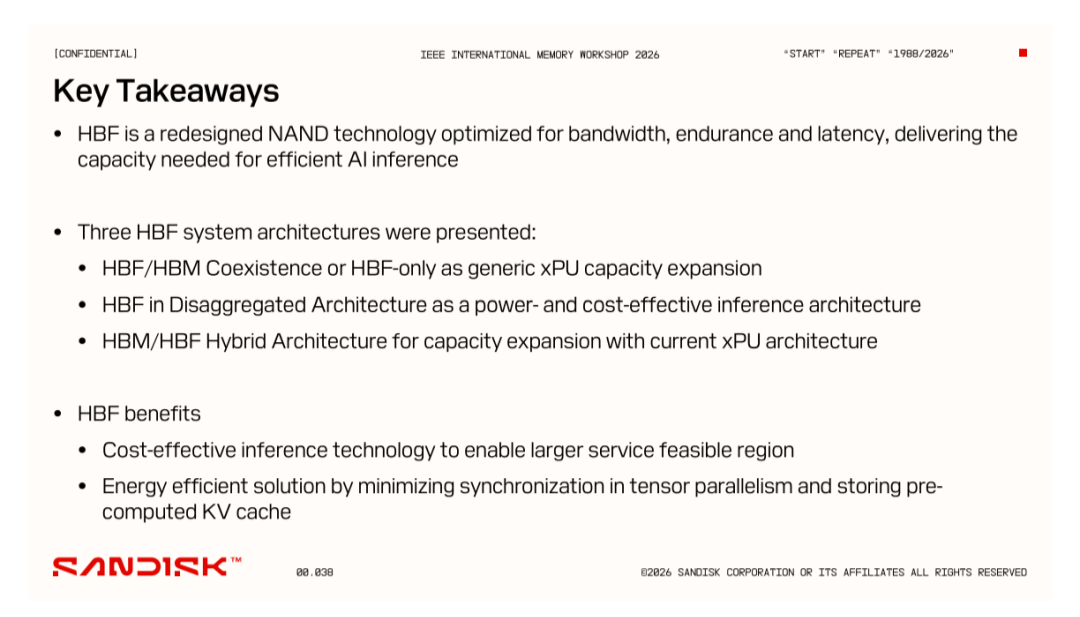
整体来看,HBF 是一条与传统 NAND 明显不同的路线:它不靠堆叠更多层数去拼容量,而是把带宽、耐久性和延迟放到第一优先级,用重新设计的存储器件去补齐 AI 推理中的内存短板。对于关注大模型推理成本、长上下文服务以及边缘侧部署的读者来说,这份讲义提供了一套相对完整的参考坐标。 |  发表于 昨天 23:20
|
查看: 8|
回复: 0


