国庆假期,你在干嘛?
我在家折腾 AI 工作流。
用 Claude Code 搭了个自动化 pipeline,让 Agent 帮我写周报、整理会议纪要,甚至帮我 review 代码。以前要花半天干的事,现在两小时搞定。效率提升了大概 3 倍。
但我没觉得轻松,反而有点慌。
因为我发现,我搭的这个 workflow,可能明年就没人需要了。不是因为它不好用,而是因为 AI 自己就能搭了。这不是危言耸听,这是一个每天跟 AI 打交道的开发工程师,在假期里的真实感受。
我今天想聊的,不是哪个模型又刷新了 benchmark,也不是哪个公司又融了几个亿。我想聊的是,AI 走到哪了,接下来会怎样,我们普通人该怎么办。
这不是新闻综述,是一个工程师的深度思考。
你看完这篇文章,应该能回答三个问题:AI 现在走到哪了?接下来会发生什么?你该怎么做?
我们先说个反直觉的事。
过去五年,AI 的进步是指数级的。2018 年到 2023 年,模型参数从几亿涨到几千亿,能力跟着飙升。大家都觉得,只要参数够大,AI 就能解决一切问题。
但 2026 年了,这个逻辑开始松动了。
SK hynix 和 KAIST 在 9 月初发了一份研究报告,标题很直接:2018 到 2023 年的指数级进步正在 plateauing。不是变慢了,是触顶了。
为什么会这样?
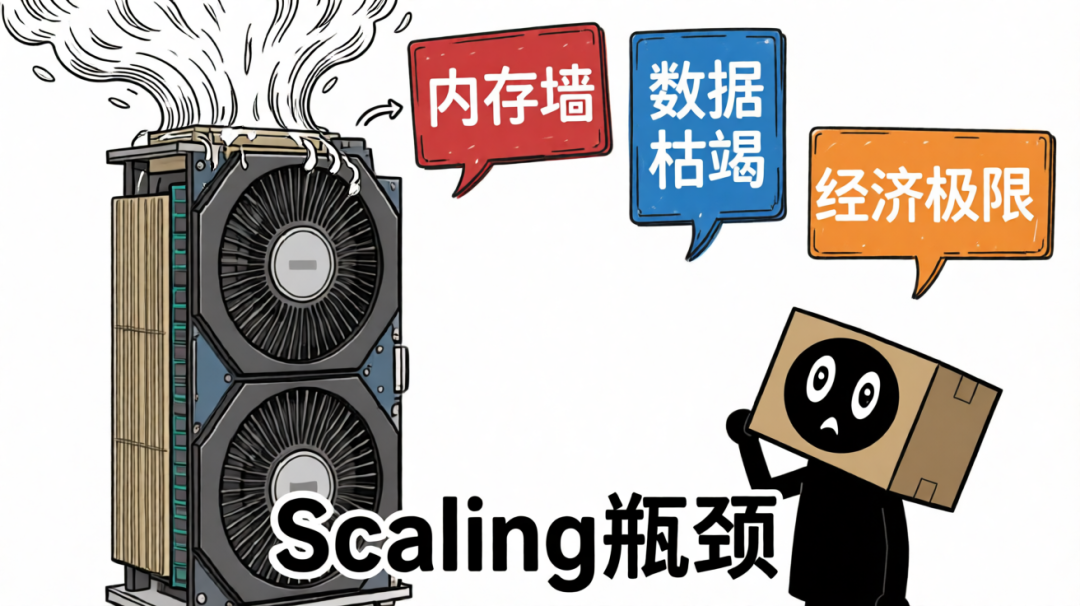
因为 AI 性能不再受限于 GPU 算力,而是受限于数据搬运速度。这叫做“内存墙”(Memory Wall)。
我给你算笔账。一个 70B 参数的模型,在长上下文推理中,它的 KV cache 可以超过 140GB。140GB 是什么概念?比模型权重本身还大。你 GPU 算力再强,数据搬不过来,就只能干等。
这就像你买了辆跑车,但高速公路上堵得水泄不通。引擎再猛也跑不起来。
除了内存墙,还有数据枯竭。
高质量训练数据是有限商品。这个互联网上的文字、图片、视频,总量是有上限的。你可以用 AI 生成数据来训练 AI,但这条路走不远。研究表明,用合成数据训练会导致“模型崩溃”(model collapse),一代不如一代,最后变成一坨屎。
最后还有经济账。
训练一个 frontier model 的基础设施投资,只有少数几个玩家能负担。每提升一个点的性能,边际成本在急剧上升。这不是单纯的技术问题,而是物理问题和经济问题的叠加。
参数不是越大越好,就像人不是越胖越壮。
你想想,一个人从 100 斤涨到 200 斤,可能是变壮了。但从 200 斤涨到 300 斤,大概率是变胖了。AI 模型也是一样的道理。
那接下来怎么办?方向有两个:
- 硬件层面的突破:让数据搬得更快
- 软件层面的优化:让模型变得更小、更聪明
这两个方向,现在都在跑。
硬件什么时候降价?
先说结论,短期不会。
TSMC 的 CEO 最近说了句话,原话我记不清了,大意是“supply can meet demand”要等到 2027 年。CNAS 今年的报告也印证了这一点。产能卖到 2027 年,这意味着什么?意味着接下来一年半,GPU 和高端内存的价格都不会降。
不只是 GPU。
DRAM 价格今年翻了 2 到 3 倍。为什么?因为 HBM(高带宽内存)的需求把常规 DRAM 的供应挤压了。大家都去抢 HBM 做 AI 芯片,普通内存反而不够用了。
具体到消费级显卡,现在的价格是这样的:
| 显卡型号 |
官方指导价(美元) |
| RTX 4090 |
$1,599 ~$1,999 |
| RTX 5090 |
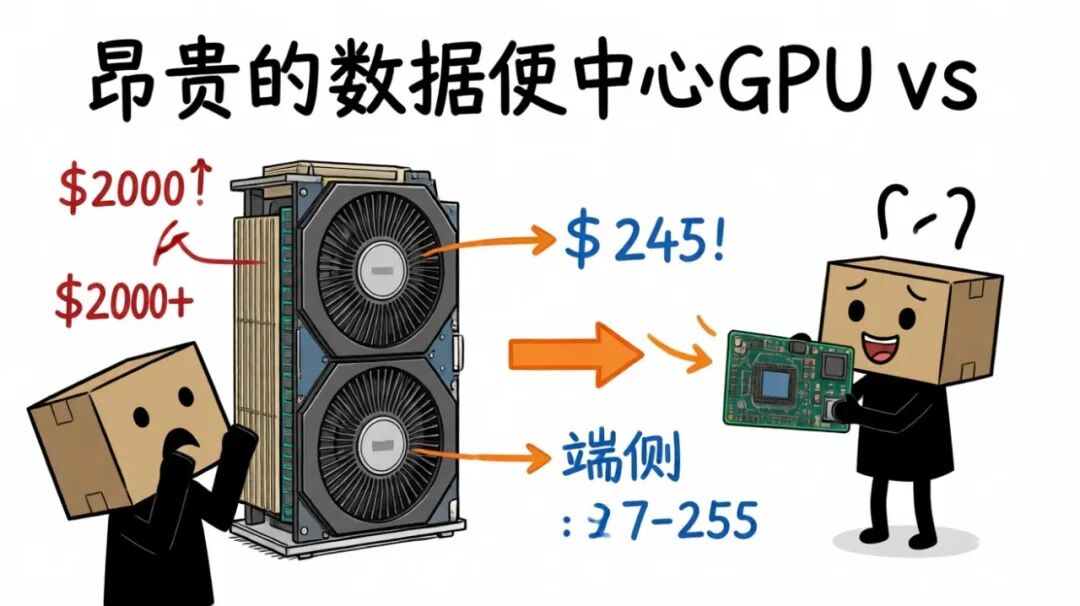
$1,999 ~$2,199 |
这还只是官方指导价,实际到手价可能更高。
听起来很绝望对吧?
但反转来了。
端侧推理成本在快速下降
9 月 17 号,PrismML 发布了 Ternary Bonsai 2。他们把一个 27B 模型从 54GB 压缩到了 5.9GB,9.1 倍的压缩率,性能保留了 98.2%。5.9GB 是什么概念?一台 16GB 内存的普通笔记本就能跑。
不是服务器,不是云 GPU,是你的笔记本。
还有英伟达的 Jetson Orin Nano Super。$249,67 TOPS 算力,功耗 7 到 25 瓦,信用卡大小的 AI 电脑。这玩意能做的事情,比你想象的多。
再看手机。Apple 的 NPU,Qualcomm 的 NPU,都在往端侧 AI 发力。
| 对比维度 |
手机端侧 |
数据中心 GPU |
| 内存带宽 |
50 ~ 90 GB/s |
2 ~ 3 TB/s |
| 差距 |
— |
30 ~ 50 倍 |
但压缩技术正在弥补这个差距。
你可以把模型压小,把精度降低,把不重要的参数砍掉。Train in 16-bit, deploy at 4-bit。GPTQ、AWQ 这些量化技术,能保留大部分质量,同时把内存占用砍掉 4 倍。
数据中心在抢显卡,但你的笔记本已经够用了。至少够用了 80% 的场景。
那剩下的 20% 呢?
那就是下一部分要聊的事了。
端侧 AI 会怎样?
先说个数据。
Deloitte 2026 年的预测,推理算力占所有 AI 算力的 2/3。2023 年这个数字是 1/3。推理需求在爆炸式增长,而且这个增长主要发生在端侧。
为什么?四个驱动力:
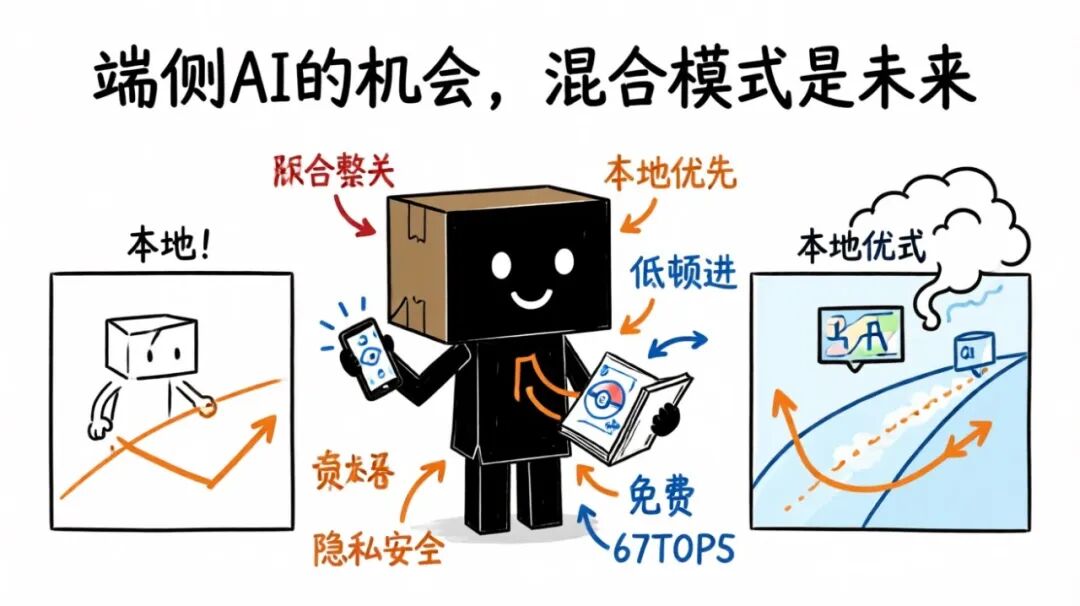
- 延迟:你在手机上问 AI 一个问题,不想等 3 秒才收到回答
- 隐私:你的医疗数据、财务数据,不想传到云端
- 成本:云端推理有 API 费用,日积月累是笔不小的开支
- 可用性:你在飞机上、地铁里、地下室里,没有网络,AI 就该罢工吗?
这些问题,端侧 AI 都能解决。
混合模式是未来
端侧 AI 不是要取代云端。未来的模式是混合的。简单的任务在本地跑,复杂的任务去云端。
| 场景 |
端侧(本地) |
云端 |
| 整理文件、总结会议 |
✅ 快、安全、免费 |
— |
| 回答常见问题 |
✅ 低延迟 |
— |
| 大型项目、代码重构 |
— |
✅ 需要大算力 |
| 高质量视频生成 |
— |
✅ 需要大内存 |
这种混合模式,对普通开发者意味着什么?
意味着你的机会来了。
你可以用端侧设备做原型、做测试、做轻量级应用。$249 的 Jetson Orin Nano Super 就能开始。你不需要抢 GPU,不需要等云端 API 的配额,不需要担心数据安全。
软件栈也在成熟
- ExecuTorch:PyTorch 官方出的端侧推理框架,footprint 只有 50KB
- llama.cpp:社区驱动的推理引擎,支持各种量化格式
- MLX:Apple Silicon 专属的机器学习框架,性能优化得相当不错
这些工具在降低门槛。
以前你想在端侧跑 AI,需要懂硬件、懂底层优化、懂内存管理。现在你只需要懂 Python,懂模型格式转换,懂怎么把量化做到极致。
Test-time compute 让小模型也能很强
还有一个有意思的现象。Llama 3.2 1B 配合合适的搜索策略,可以击败 8B 模型。这不是玩笑,是真实发生的事。
为什么?
因为小模型虽然参数少,但如果你给它足够的时间去思考、去验证、去纠错,它就能做到大模型一次就能做到的事。这是用时间换空间的思路。
大模型是天才学生,看一眼就会了。小模型是普通学生,但给他更多时间复习、做题、验证答案,他也能考出好成绩。
在实际应用中,这意味着什么?
至少有一半住在口袋里。
失业者应该关注什么?
这部分可能有点扎心。
先看数据:
| 公司/指标 |
数据 |
来源 |
| 甲骨文裁员 |
2.1 万人 |
官方承认“AI 导致员工减少” |
| Meta 裁员 |
8,000 人 |
同时 7,000 人转岗 AI 项目 |
| 谷歌新代码 |
75% 由 AI 生成 |
— |
| 2026 Q1 全球科技裁员 |
超 4 万人 |
其中 65% 是软件工程师 |
这些数字看起来挺吓人的。
但反转来了。
SignalFire 在 6 月底发了一份报告,标题很反直觉:2025 年工程岗位是抗风险最强的职能岗位。
- 12 家科技巨头的新员工中,工程师占比从 2019 年的 46% 上升到 2025 年的 55%
- 初创企业招聘工程师总人数较 2019 年增长了 7%
这是怎么回事?
这就是经济学里的“杰文斯悖论”:效率提升不降低需求,反而扩大需求。
我给你举个例子。
以前写一个中等复杂度的功能,需要一个工程师花一周。现在有了 AI 辅助,一个工程师两天就能搞定。看起来效率提升了,需求应该减少对吧?
但实际上,公司发现 AI 降低了开发成本,于是开始做以前不敢做的项目。需求变多了,反而需要更多工程师来驾驭 AI、做架构决策、判断 AI 的输出是否靠谱。
AI 替代的不是“程序员”,是“不思考的编程行为”。
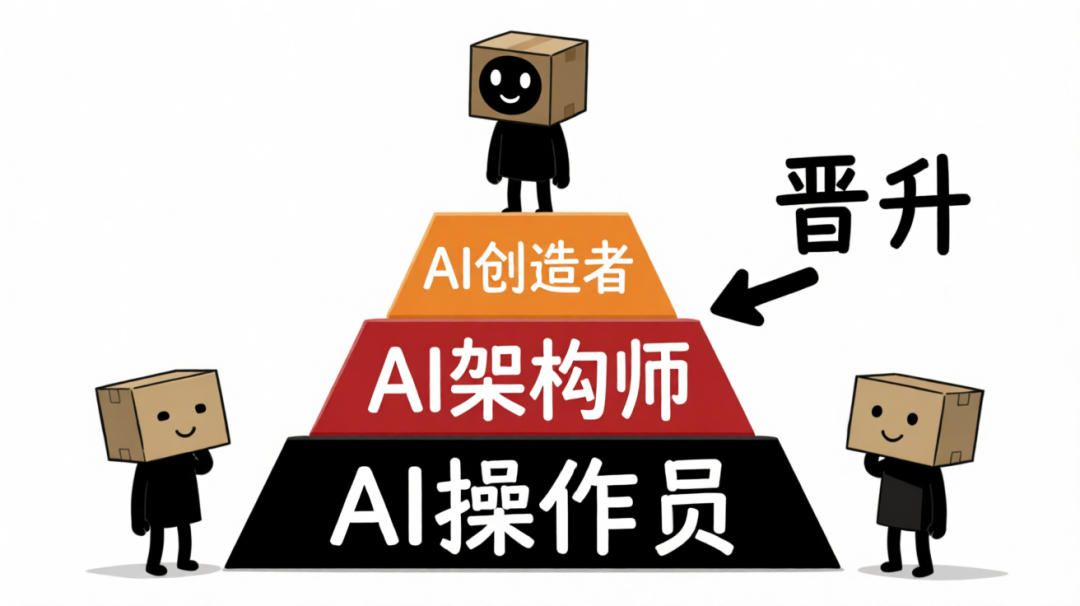
三层分化
这里有个三层分化的概念,我觉得很准确:
- AI 操作员:会用 AI 写代码,但只是把需求丢给 AI,然后复制粘贴结果。竞争激烈,可替代性强
- AI 架构师:懂业务、能做技术决策、指导 AI 工作。知道什么问题该交给 AI,什么问题必须自己解决。很抢手
- AI 创造者:创造新工具、新范式,定义 AI 应该怎么用。不可替代,因为他们就是规则的制定者
虎嗅在 6 月 15 号发了篇文章,里面有句话很到位:
AI 时代的门槛从“会不会写代码”变成了“会不会定义问题、组织上下文、判断结果”。
这才是核心。
我的个人视角
我每天用 Claude Code 写代码,但我不是在“写代码”。我在定义问题、组织上下文、判断 AI 的输出是否靠谱。
比如我要搭一个自动化 workflow,我不是告诉 AI“帮我写个脚本”。我是先想清楚,这个 workflow 要解决什么问题,输入是什么,输出是什么,边界条件是什么,异常情况怎么处理。然后我才去组织上下文,让 AI 理解我的意图。最后我要判断 AI 生成的代码是否符合我的预期,有没有潜在的问题。
这个过程,AI 做了 80% 的执行工作。但剩下 20% 的思考工作,才是我的价值。
四个行动方向
所以失业者应该关注什么?
- 学会用 AI 工具:不是学会写代码,是学会定义问题。你要知道怎么把模糊的需求翻译成清晰的指令
- 理解业务:AI 不懂业务,你懂。你要知道公司的痛点在哪,客户的需求在哪,产品的机会在哪
- 成为 AI 架构师,不是 AI 操作员:你要能判断 AI 的输出是否靠谱,能做技术决策,能指导 AI 工作
- 关注端侧 AI 的机会:$249 的 Jetson Orin Nano Super 就能开始。你不需要昂贵的 GPU,不需要云端的 API 费用,你只需要一台笔记本和一块小开发板
端侧 AI 是下一个蓝海
因为云端 AI 的玩法已经固化了,大厂在卷模型、卷算力、卷数据。但端侧 AI 还在早期,工具在成熟,场景在涌现,机会在扩散。
你不需要跟大厂竞争。你只需要找到一个具体的场景,用端侧 AI 解决一个具体的问题。比如:
这些场景不需要千亿参数的模型,只需要一个足够聪明、足够快、足够便宜的小模型。
这就是你的机会。
写在最后
国庆假期已经过去两天了。
我搭的 workflow 还在跑。它在帮我整理这几天的笔记,帮我写这篇文章的初稿,帮我检查数据的准确性,帮我润色我的一些表达。
明年它可能就不需要了。不是因为 workflow 出了问题,而是因为 AI 自己就能搭新的 workflow 了。
但我不会慌。
workflow 会变,但我会变通。
AI 不是来取代我的,是来重新定义我的工作内容的。
- 从“写代码”变成“定义问题”
- 从“执行任务”变成“判断结果”
- 从“操作员”变成“架构师”
这个转变,不是 AI 逼我做的,是我自己选择的。
我选择了主动拥抱变化,而不是被动等待被淘汰。我选择了思考,而不是只是执行。我选择了成为架构师,而不是操作员。
你呢?
问题是,你准备好了吗?
参考资料
- SK hynix/KAIST 研究,2026-09-03
- CNAS 2026 年 AI 芯片供应链报告
- PrismML Ternary Bonsai 2 发布,2026-09-17
- Deloitte 2026 年 AI 算力预测报告
- SignalFire 工程岗位报告,2026-06-25
- 虎嗅 AI 时代门槛分析,2026-06-15
 发表于 14 小时前
|
查看: 5|
回复: 0


