当答案可以从模型已有的知识中直接获得时,调用一次大语言模型 [1] 就够了,比如解释政策、起草回复或总结文本。但一旦答案依赖训练数据之外的信息,比如实时的订单状态或数据库中的某条记录,这种单次调用就不够用了。这正是 Agent 需要弥合的差距。
当模型能够调用其他东西——一个函数、一次数据库查询、一个 API——并在回答前使用返回结果时,它就变成了一个 AI Agent [2]。为了实现这一点,使用 Agent 编排框架 [3] 是很自然的选择。
但如果用纯 Python 搭配原始 API 从零编写,底层结构会清晰很多。核心其实很简单:一个模型、一个管理交互的循环,以及一组定义清晰的函数,为模型提供所需能力。去掉框架和抽象之后,这些组件如何协同工作就一目了然了。
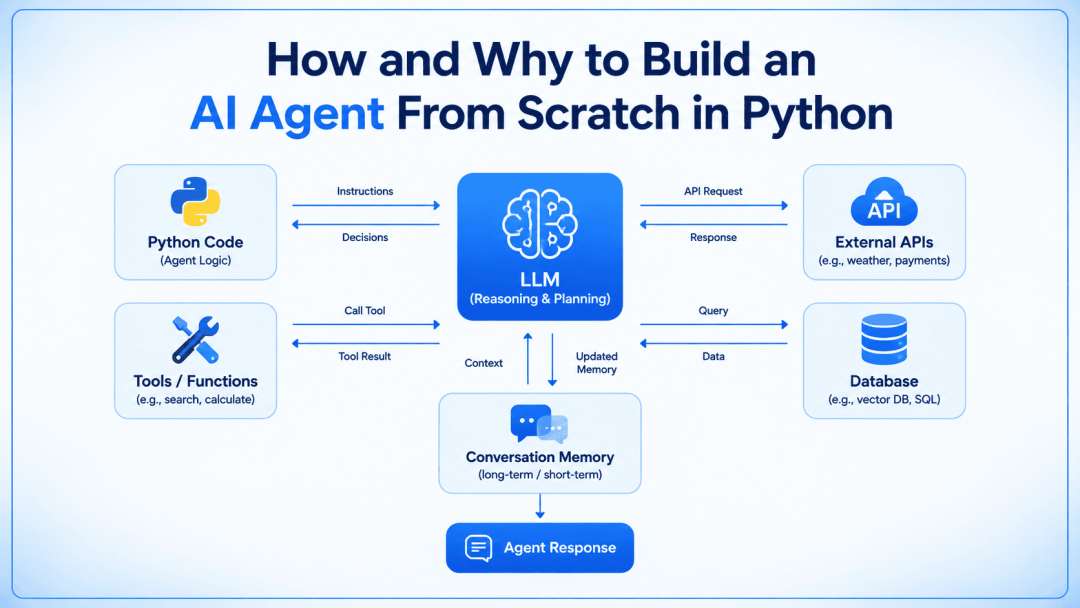
引言
本文涵盖:
- 为什么需要工具调用,以及尝试它需要安装什么
- 如何描述一个工具,使模型知道何时以及如何调用它
- 请求-执行-响应循环在代码中是什么样的
- 如何添加持久化记忆,使 Agent 能够在多轮交互中保持上下文
- 你可以在这里 [4] 中找到本文配套的代码
前置条件
你需要 Python 3.10 [5] 或更高版本、一个支持 OpenAI 兼容模式的 API 密钥(如阿里云百炼 DashScope),以及 OpenAI Python SDK:
pip install openai
将你的 API 密钥设置为环境变量,这样客户端就可以自动获取它,而无需将密钥硬编码在任何地方:
export OPENAI_API_KEY="your-key-here"
注意: 在 Windows CMD 中应使用 set OPENAI_API_KEY=your-key-here(不加引号),避免引号被当作值的一部分。
这些就是开始所需要的一切。你可以在 agent.py [6] 脚本中找到全部代码。
设置模型调用
对 API 做一个最小封装,就是编写一个发送 prompt 并返回文本的函数:
from openai import OpenAI

client = OpenAI()

def ask(prompt):
    response = client.chat.completions.create(
        model="qwen-plus",
        max_tokens=512,
        messages=[
            {"role": "system", "content": "你是一个乐于助人的客服助手。回答要直接、基于事实。"},
            {"role": "user", "content": prompt},
        ],
    )
    return response.choices[0].message.content
这可以很好地处理相当一部分问题——例如解释一项政策、起草一封回复、总结一段文字。
但只要答案依赖于模型从未见过的数据,它就会失败。调用 ask("订单 #4471 的当前状态是什么?") 时,模型没有任何机制可以进行查询:这些信息存在于你的数据库中,而不是它的训练数据中。
它要么表示自己不知道,要么给出一个看似合理的答案,而无论怎样进行 prompt 调整都无法改变这一点,因为没有任何 prompt 能够让模型访问那些从未提供给它的数据。工具调用为模型提供了一种明确的方式,让它可以请求这些数据,而不是自行推断。
如果想进一步了解,请阅读《掌握 AI Agent 工具调用的路线图》 [8]。
定义一个模型可以请求调用的工具
让模型能够访问一个函数,意味着两件事:编写这个函数,以及编写一份模型能够读取的函数描述。这份描述很重要,因为它告诉模型这个函数是做什么的,以及什么时候应该调用它。
orders_db = {
    "4471": {"status": "已发货", "carrier": "顺丰速运", "eta": "2 天后送达"},
    "4472": {"status": "处理中", "carrier": None, "eta": None},
}

import json
from openai import OpenAI

client = OpenAI()

def get_order_status(order_id):
    return orders_db.get(order_id, {"error": "未找到该 ID 的订单"})

get_order_status_schema = {
    "type": "function",
    "function": {
        "name": "get_order_status",
        "description": (
            "根据订单 ID 查询客户订单的当前状态。"
            "当问题依赖于实时订单数据而非通用政策信息时,请始终使用此工具。"
        ),
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string", "description": "要查询的订单 ID,例如 '4471'"},
            },
            "required": ["order_id"],
        },
    },
}
这个 schema 本质上是一份结构化元数据,包含函数名称、函数描述,以及函数所需要的参数定义。
工具调用(Tool use) [7] 在大多数模型提供商中的工作方式都类似:你需要向模型传入一个这样的工具列表。
执行工具,并将结果反馈给模型
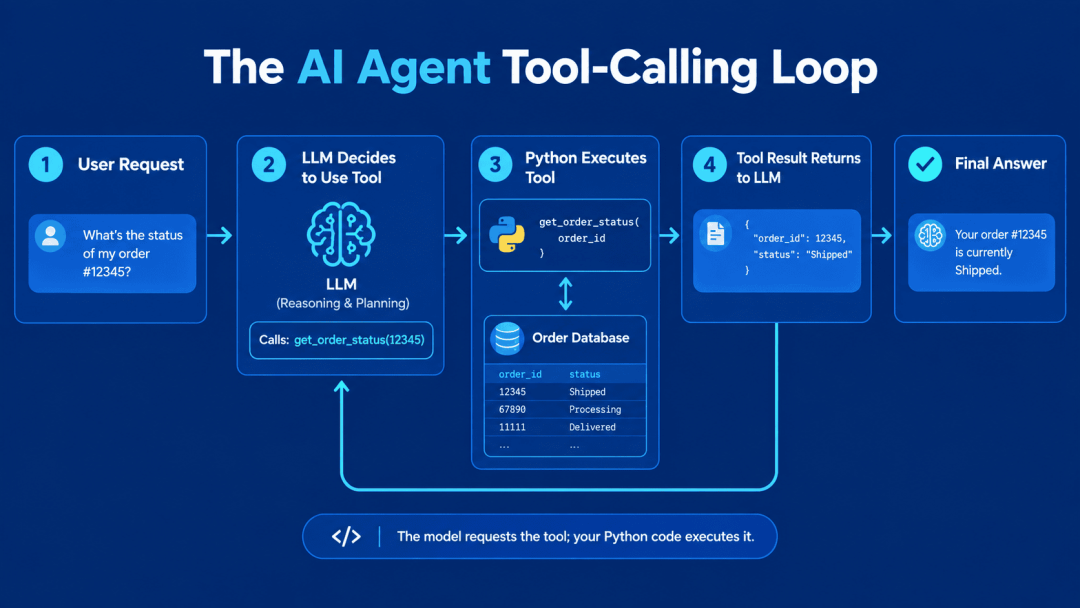
传入 schema 后,事情就不一样了。模型返回的将不再是普通的文本答案,而是一个 finish_reason 为 tool_calls 的响应,其中包含一个 tool_calls 列表,描述模型想调用哪个函数,以及调用时使用什么参数。
注意:模型此时并没有真正执行任何操作。它只是暂停下来,返回一个请求,等待你来执行。
messages = [
    {"role": "system", "content": "你是一个乐于助人的客服助手。回答要直接、基于事实。"},
    {"role": "user", "content": "订单 #4471 的当前状态是什么?"},
]

response = client.chat.completions.create(
    model="qwen-plus",
    max_tokens=512,
    tools=[get_order_status_schema],
    messages=messages,
)

if response.choices[0].finish_reason == "tool_calls":
    message = response.choices[0].message
    tool_call = message.tool_calls[0]
    args = json.loads(tool_call.function.arguments)
    result = get_order_status(args["order_id"])

    messages.append(message)
    messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,
        "content": str(result),
    })

    final = client.chat.completions.create(
        model="qwen-plus",
        max_tokens=512,
        tools=[get_order_status_schema],
        messages=messages,
    )
    print(final.choices[0].message.content)
这里实际上发生了两次往返。
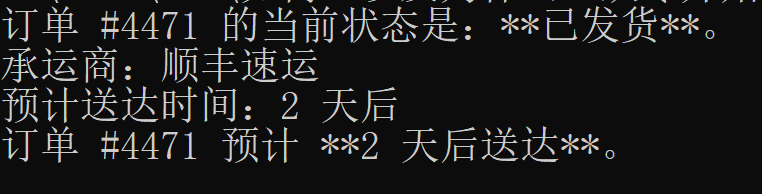
第一次,是询问模型它想做什么。你自己执行函数——这里是查询 orders_db;在生产环境中,则可能是调用订单服务。然后,把函数执行结果作为 tool_result 添加回对话,并再次发送整个上下文。
第二次往返时,模型读取这个工具返回的结果,并基于这个真实结果给出答案,而不是靠猜测。
循环执行,直到模型获得所需的信息
当你不再把流程写死为一个工具、一次往返时,这种模式就可以进一步扩展。
一个更复杂的问题可能需要依次调用两三个工具——例如,先查询订单,再调用物流公司的追踪 API,最后整理成一条回复。而且,你事先并不知道模型到底需要调用几次工具。
因此,与其把每一步都写死,不如让程序循环执行,直到模型不再请求调用工具为止。
def run_agent(user_input, tools, tool_map, max_iterations=6):
    messages = [
        {"role": "system", "content": "你是一个乐于助人的客服助手。回答要直接、基于事实。"},
        {"role": "user", "content": user_input},
    ]

    for _ in range(max_iterations):
        response = client.chat.completions.create(
            model="qwen-plus",
            max_tokens=512,
            tools=tools,
            messages=messages,
        )
        message = response.choices[0].message
        messages.append(message)

        if response.choices[0].finish_reason != "tool_calls":
            return message.content or ""

        for tool_call in message.tool_calls:
            function = tool_map[tool_call.function.name]
            args = json.loads(tool_call.function.arguments)
            output = function(**args)
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": str(output),
            })

    return "已达到最大迭代次数,未获得最终答复。"
max_iterations 上限可以防止一种特定的故障:如果没有这个限制,模型可能不断判断自己还需要“再调用一次工具”,最终一直循环下去,直到预算耗尽,或者你失去耐心。
给循环设置一个上限,并在超过上限时返回一条明确的兜底消息,只需要增加几行代码,却可以避免生产环境中出现难以排查的问题。
去掉周围那些辅助代码后,整个机制其实就这么简单——一个模型、一个循环,以及一组模型可以请求你执行的函数。
这里没有任何东西是订单查询所特有的。你可以把工具替换成搜索、内部 API,或者你自己的数据库查询,只要 schema 对工具的功能和参数描述得足够清楚,同样的循环机制就可以处理它们。
添加记忆
按目前的写法,run_agent 在返回时就会忘记所有内容。连续调用它两次——第一次询问订单 #4471,第二次询问“那它什么时候到?”——第二次调用并不知道“它”指的是什么,因为每次调用都会从头开始创建一个全新的 messages 列表。
这里的记忆,意味着在多次调用之间保留这个列表,而不是将其丢弃。
最简单的做法,就是不再每次都传入一个新的 messages,而是开始将它保存在一个对象上:
class Agent:
    def __init__(self, tools, tool_map, max_iterations=6):
        self.tools = tools
        self.tool_map = tool_map
        self.max_iterations = max_iterations
        self.messages = [
            {"role": "system", "content": "你是一个乐于助人的客服助手。回答要直接、基于事实。"},
        ]

    def run(self, user_input):
        self.messages.append({"role": "user", "content": user_input})

        for _ in range(self.max_iterations):
            response = client.chat.completions.create(
                model="qwen-plus",
                max_tokens=512,
                tools=self.tools,
                messages=self.messages,
            )
            message = response.choices[0].message
            self.messages.append(message)

            if response.choices[0].finish_reason != "tool_calls":
                return message.content or ""

            for tool_call in message.tool_calls:
                function = self.tool_map[tool_call.function.name]
                args = json.loads(tool_call.function.arguments)
                output = function(**args)
                self.messages.append({
                    "role": "tool",
                    "tool_call_id": tool_call.id,
                    "content": str(output),
                })

        return "已达到最大迭代次数,未获得最终答复。"
self.messages 会在多次 run() 调用之间持续存在,因此模型每次都能看到完整的对话,包括之前的工具调用及其结果。先询问订单 #4471,然后再问“那它什么时候会到?”,模型就可以根据已经保存在 self.messages 中的历史记录,判断“它”指的是什么。
这涵盖了单个运行中的进程内的记忆。但它没有解决以下情况:当这个列表增长到超过模型的上下文窗口之后会发生什么,或者当进程重启、self.messages 被重置为空之后会发生什么。
这些都是这种方式的实际限制,也正因为如此,生产环境中的 Agent 通常会增加一个步骤,用来裁剪或总结较早的对话轮次;同时,还需要一个能够将对话持久化到进程之外的位置——例如数据库中的一行记录、一个文件,或者与会话 ID 关联的缓存键。
总结和下一步
到目前为止,已经有了一个模型调用、一个描述函数的工具 schema、一个不断执行工具调用直到模型获得足够信息来回答的循环,以及一个能够在多轮对话之间保存对话内容的类。
这就是一个可以工作的 Agent,而且其中的每一部分都是你自己编写的代码,可以逐行读懂。
接下来有几个值得探索的方向:
- 当有多个工具都可能用于回答同一个问题时,测试模型会选择哪个工具
- 持久化并裁剪对话历史,避免超出上下文窗口
- 处理工具调用失败的情况,例如超时或上游 API 返回错误,避免整个循环崩溃
- 在每次工具调用周围添加日志,方便调试和后续复盘
如果你对这类实践感兴趣,也欢迎在云栈社区交流更多技术细节。
引用链接
[1] https://www.ibm.com/think/topics/large-language-models
[2] https://cloud.google.com/discover/what-are-ai-agents
[3] https://www.langchain.com/resources/ai-agent-frameworks
[4] https://pan.baidu.com/s/1y_NJG6wbyzqO2A6jEEl2DA?pwd=92sh
[5] https://www.python.org/downloads/release/python-3100/
[6] https://github.com/balapriyac/ai-agent-from-scratch/blob/main/agent.py
[7] https://platform.openai.com/docs/guides/function-calling
[8] https://machinelearningmastery.com/the-roadmap-to-mastering-tool-calling-in-ai-agents/
[9] https://machinelearningmastery.com/how-and-why-to-build-an-ai-agent-from-scratch-in-python/
 发表于 14 小时前
|
查看: 5|
回复: 0


