做爬虫的人都知道,签名是最难缠的一道关。
写代码本身不费劲,费劲的是接口参数被加密了。想直接调,得把平台前端逆向一遍,搞清楚签名算法。等好不容易搞明白了,平台一改算法,脚本全废。
小红书 2023 年那次风控收紧,接口成片返回 461,多少脚本一夜之间停摆。
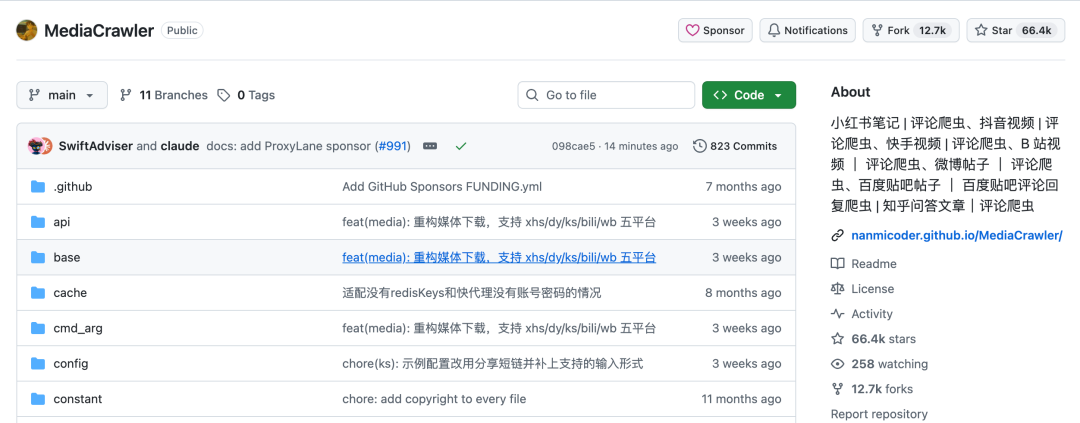
MediaCrawler 走的是一条完全不同的路——它不去碰加密算法,而是让浏览器自己来算。
支持小红书、抖音、快手、B站、微博、贴吧、知乎,七个平台全覆盖。作者是独立开发者,2023 年 6 月开源后持续更新,目前 66k+ Star、1 万多 Fork。
01 它怎么绕过签名这道关
核心思路很简单:底层用Playwright,扫码登录后把登录态保存下来,所有需要签名的请求全部交给浏览器在登录状态下自己算。
签名是浏览器自己生成的,算法怎么改都拦不住——因为计算过程本来就发生在浏览器里,不是在模拟。
作者说这个思路不算他首创,但能做到装上就能用、还覆盖七个平台的,确实没几个。
中间还有段插曲:作者曾经把仓库删掉过,因为有人拿代码去卖钱。后来补了免责声明,重新开源。
02 它接管你正在用的那个 Chrome
默认行为不是自己开浏览器,而是直接接管你平时在用的那个 Chrome。
账号、Cookie、扩展、历史记录全是现成的。平台那边看到的,就是一个正常人在刷网页。
Chrome 136 开始,远程调试不再提供 HTTP 接口了。程序改走 WebSocket 直连 ws://localhost:9222,还需要在浏览器上手动点一下确认。
开跑之前,先进 chrome://inspect/#remote-debugging 勾上远程调试。
几个关键配置项:
CDP_CONNECT_EXISTING:控制是接管现有浏览器还是另起一个实例CDP_DEBUG_PORT:指定调试端口ENABLE_CDP_MODE 设成 False 就回到标准 Playwright 模式,代价是需要额外执行 uv run playwright install 安装驱动
03 七个平台能采什么
七个平台的能力完全一致,README 那张表每行都打满了勾,选哪个只看你的目标在哪里。
采集类型由 --type 参数决定:
search:输入关键词,批量抓取搜索结果的笔记和视频detail:针对已有目标,把帖子或视频的 ID 或完整 URL 填进列表,只取这几条creator:盯住某个作者,填主页地址,把他发过的内容和数据一起打包拿走
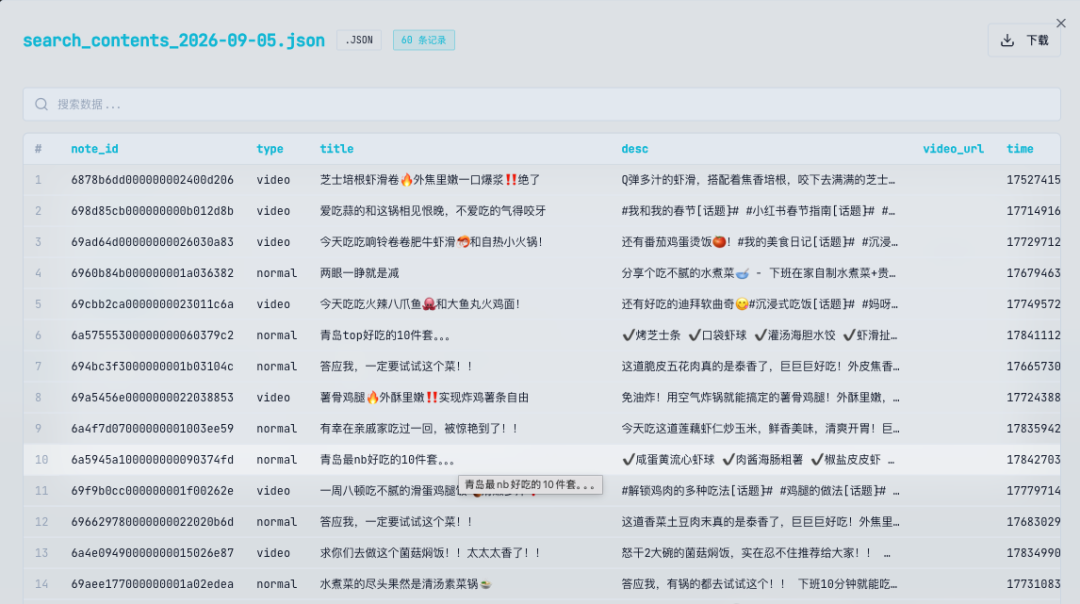
每条记录能拿到标题、正文、点赞数、收藏数、评论。
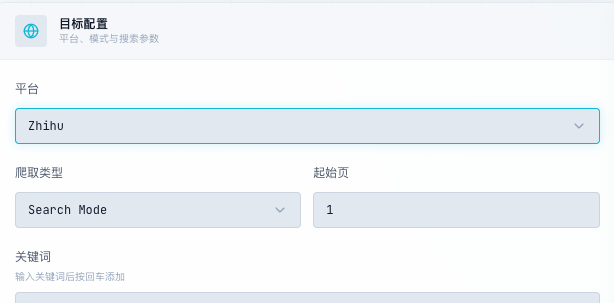
登录方式有三种:
- 默认
qrcode:用对应 App 扫码,登录态存本地,下次不用重扫
cookie:把 Cookie 直接填进配置phone:门槛相当离谱,需要安卓机装短信转发软件、内网穿透域名、还得一个带密码的 Redis。官方文档自己都写了不建议用
采集量大可以挂代理,内置快代理、豌豆 HTTP 和静态代理三种来源。
数据落地有八种选择:文件侧是 CSV、Excel、JSON、JSONL;数据库侧除 SQLite 和 MySQL 外,还有 PostgreSQL 和 MongoDB。默认落 JSONL。
04 评论比正文更有价值,还能顺手出词云
很多时候评论区比正文信息量更大。
一级评论默认就采,单条上限默认 10 条。评论下面的回复(楼中楼)需要手动打开 ENABLE_GET_SUB_COMMENTS,默认是关闭的。
采完的评论能直接生成词云,但有个前置条件容易踩坑:只有存成 JSON 或 JSONL 格式才会生成,落进数据库出不来图。ENABLE_GET_WORDCLOUD 也得记得打开。
想更精准可以往 CUSTOM_WORDS 里塞词组,停用词表和字体也能替换。
05 封面和视频也能一起下载
数据之外,媒体文件也能一并拉下来,默认关闭。
命令行加 --get_media true,或者打开 ENABLE_GET_MEDIA。
落盘按内容聚合,路径格式是 data/xhs/media/{帖子ID}/,封面是 cover.jpg,视频是 video.mp4,图文帖的多张图按 001.jpg 往下排。
小红书、抖音、快手、B站、微博五个平台支持,贴吧和知乎没有媒体字段。
B站那条线做得最细:装了 ffmpeg 就走 DASH 路径,音视频分轨下载再无损合流,能拿到最高画质;没装就降级成 mp4 直链。清晰度由 BILI_QN 控制,默认 80 对应 1080p。
06 跑起来需要准备三样东西
第一样是 uv:进项目目录跑一句,Python 依赖就装完,作者用的是 3.11 版本。
第二样是 Node.js:官方要求不低于 16.0.0,爬抖音和知乎需要用到。
第三样是 Chrome:要求 144 以上,装好后勾上远程调试。
启动命令:
uv run main.py --platform xhs --lt qrcode --type search
终端会出二维码,用对应 App 扫掉,登录态就留在本地了。
要改的东西都在 config/base_config.py。
命令还有几种变体:--type detail 按详情采,--specified_id 只取指定条目,--get_media true 连媒体一起拉。
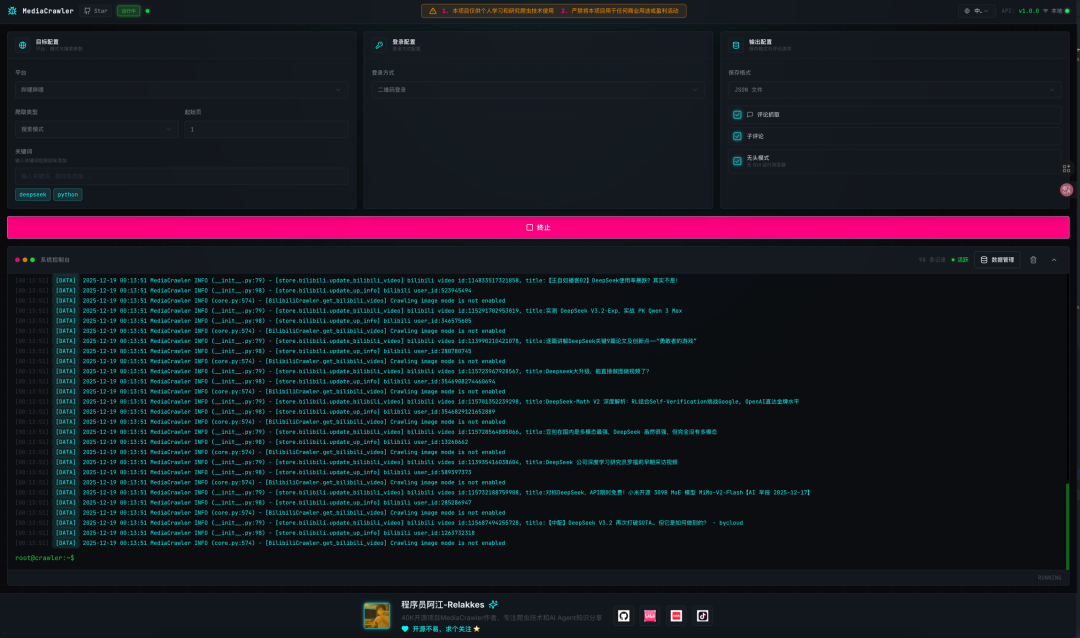
命令行不是唯一入口。它还带了一个网页版:后端 uvicorn 起在 8080,前端进 webui 装完依赖跑 npm run dev 起在 5173,在浏览器里挑平台、填关键词、翻日志。要挂到后端上先执行 npm run build。
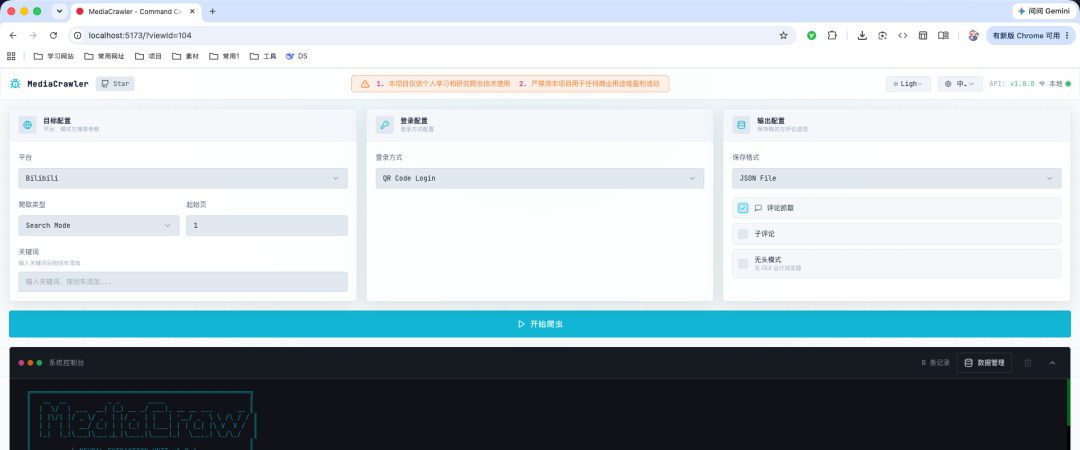
懒得装的话,把仓库地址丢给 AI 编程助手代劳也行。
07 所有开关集中在一个文件
真正需要改的东西都在一个文件里,每一项都有中文注释。
命令行能覆盖的比想象中多,整个脚本二十来个参数,配置里几乎每一项都有对应的写法。
布尔值接受 yes、true、t、y、1,也认 no、false、f、n、0。
几个默认值值得先记住:
- 单次最多采 15 条内容
- 并发数为 1
- 两次请求之间停 2 秒
最后那个数字,就是“频率放低”的官方实现方式。
另外两个不常提到的:
XHS_INTERNATIONAL 打开后走海外版小红书,接口域名和 Cookie 域一起切换--init_db 一次性建好 PostgreSQL 或 MySQL 的表
08 目录结构透露了它的抗改版能力
爬虫项目最怕的是平台一改版就整个塌掉。这个仓库的分层设计就是冲着这件事去的。
七个平台各占一个目录,文件形状几乎一样,各管自己那一摊。
再往外:
store 管存储proxy 管代理cache 分本地与 Redis 两套tools 放浏览器控制和滑块处理
libs 里躺着三个 JS 文件:抖音和知乎各一个签名函数,还有一个 stealth.min.js 用来抹掉浏览器的自动化特征。
它说不碰加密,意思是把逆向结果收进这一层复用。
网页版不是套在命令行外面的壳子。webui 是独立的 React 加 TypeScript 工程,环境检测、配置面板、运行终端、数据浏览各是一块。
09 开源版到此为止,Pro 版另有东西
开源版缺什么作者没藏着:断点续爬和多账号写在付费版里。
Pro 版不开源,走订阅制,多出来的是自媒体内容拆解 Agent、多账号与 IP 代理池、完整 Linux 支持、一个视频下载器桌面端、多平台信息流推荐,还有给 AI Agent 用的 Skill。架构上把 Playwright 依赖整个去掉,签名逻辑拆成独立服务。
10 有边界,也有风险
第一,账号有风控风险。动手的是程序,频率一高,被盯上的是你登录的那个号。作者的做法是放慢节奏,只看公开内容,够了就收手,主力号别跑。
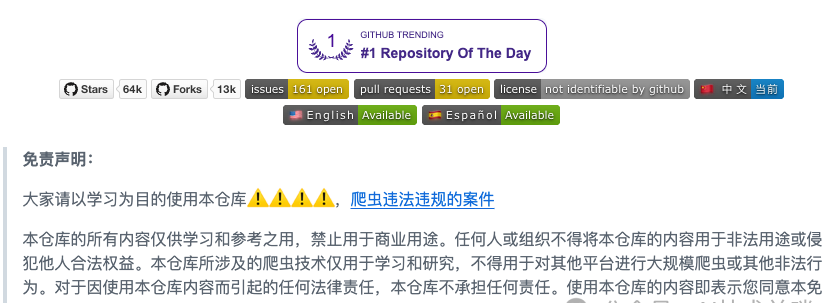
第二,协议有边界。许可证叫 NON-COMMERCIAL LEARNING LICENSE 1.1,中文名非商业学习使用许可证,只限非商业的学习与研究,禁止大规模爬取和干扰平台运营,商用需要先拿到版权人的书面同意。
第三,平台一直在变。今天跑得通不代表三个月后还跑得通,登录态过期、接口改版都是日常。好在项目从 2023 年建库起一直有人维护,这个月还有推送。
11 对我来说它的价值有两块
一块是省时间:想看某个话题下大家在讨论什么,手动逐条摘录的活可以省掉。
另一块是当学习样本:想练浏览器自动化,这个项目挺合适。
采的都是公开内容,频率压住,不碰隐私,不商用。
开源地址:https://github.com/NanmiCoder/MediaCrawler
 发表于 15 小时前
|
查看: 10|
回复: 0


